

Du 30 novembre au 1er décembre, un hackathon OpenVINO s'est tenu à Nizhny Novgorod.. Les participants étaient invités à créer un prototype de solution produit en utilisant le toolkit Intel OpenVINO. Les organisateurs ont proposé une liste de thèmes suggérés pour orienter le choix des tâches, mais la décision finale revenait aux équipes. De plus, l'utilisation de modèles non inclus dans le produit était encouragée.
Cet article raconte comment nous avons créé notre prototype de produit, avec lequel nous avons finalement remporté la première place.
Plus de 10 équipes ont participé au hackathon. Il est agréable de noter que certaines d'entre elles venaient d'autres régions. Le hackathon a eu lieu dans le complexe « Kremlin sur la Pochaina », où de vieilles photos de Nizhny Novgorod étaient accrochées, ce qui créait une ambiance ! (je rappelle qu'à l'heure actuelle, le bureau central de la société Intel est situé à Nizhny Novgorod). Les participants avaient 26 heures pour écrire du code, à la fin, ils devaient présenter leur solution. Un des avantages était la présence d'une session de démonstration pour s'assurer que tout ce qui avait été prévu était réellement réalisé et non resté seulement des idées dans la présentation. Du merchandising, des collations, de la nourriture, tout était également présent !
De plus, la société Intel fournissait, sur demande, des caméras, des Raspberry PI et des Neural Compute Stick 2.
Choix de la tâche
L'une des parties les plus difficiles de la préparation du hackathon à thème libre est le choix de la tâche. Nous avons immédiatement décidé d'inventer quelque chose qui n'existe pas encore dans le produit, car il avait été annoncé que cela était vivement encouragé.
En analysant , qui sont inclus dans le produit dans la version actuelle, nous arrivons à la conclusion que la plupart d'entre eux résolvent différentes tâches de vision par ordinateur. Il est en effet très difficile d'imaginer une tâche dans le domaine de la vision par ordinateur qui ne peut pas être résolue en utilisant OpenVINO, et même si une telle tâche peut être conçue, il est difficile de trouver des modèles pré-entraînés accessibles. Nous avons donc décidé d'explorer une autre direction — celle du traitement et de l'analyse de la parole. Nous examinons une tâche intéressante de reconnaissance des émotions par la parole. Il convient de noter qu'OpenVINO dispose déjà d'un modèle qui détermine les émotions humaines par le visage, mais :
- En théorie, il serait possible de réaliser un algorithme combiné qui fonctionnerait à la fois par le son et par l'image, ce qui devrait augmenter la précision.
- Les caméras ont généralement un angle de vue étroit, pour couvrir une grande zone, il faut plusieurs caméras, l'audio n'a pas cette limitation.
Développons l'idée : prenons comme base une idée pour le segment retail. On peut évaluer la satisfaction des clients aux caisses des magasins. Si un client est mécontent du service et commence à élever la voix, on peut immédiatement appeler un administrateur à l'aide.
Dans ce cas, il est nécessaire d'ajouter la reconnaissance vocal, cela nous permettra de distinguer les employés du magasin des clients, et de fournir une analyse pour chaque individu. De plus, nous pourrons analyser le comportement même des employés, évaluer l'ambiance dans l'équipe, cela semble intéressant !
Définissons les exigences pour notre solution :
- Taille réduite de l'appareil cible
- Fonctionnement en temps réel
- Cout bas
- Facilité de mise à l'échelle
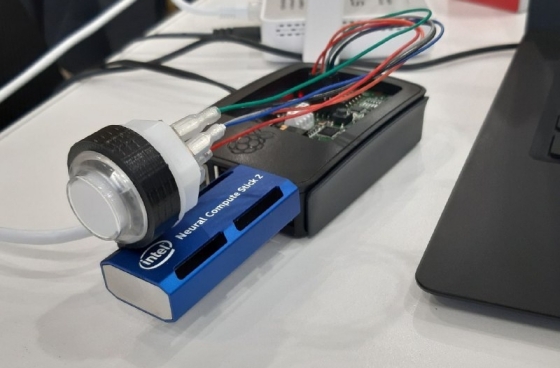
En fin de compte, nous choisissons comme appareil cible un Raspberry Pi 3 avec .
Il est important de noter une caractéristique importante de NCS - il fonctionne mieux avec des architectures CNN standard, si vous devez lancer un modèle avec des couches personnalisées, attendez-vous à une optimisation de bas niveau.
Il ne reste plus qu'à se procurer un microphone. Un microphone USB standard fera l'affaire, bien qu'il ne s'harmonise pas bien avec le RPI. Mais là encore, la solution est littéralement à portée de main. Pour enregistrer la voix, nous décidons d'utiliser la carte Voice Bonnet du kit , qui est équipée d'un microphone stéréo préinstallé.
Téléchargeons Raspbian depuis et transferons-le sur une clé USB, testons le bon fonctionnement du microphone avec la commande suivante (qui enregistrera un audio de 5 secondes et l'enregistrera dans un fichier) :
arecord -d 5 -r 16000 test.wavJe tiens à préciser que le microphone est très sensible et capte bien les bruits. Pour corriger cela, accédons à alsamixer, sélectionnons les appareils de capture et réduisons le niveau du signal d'entrée à 50-60%.
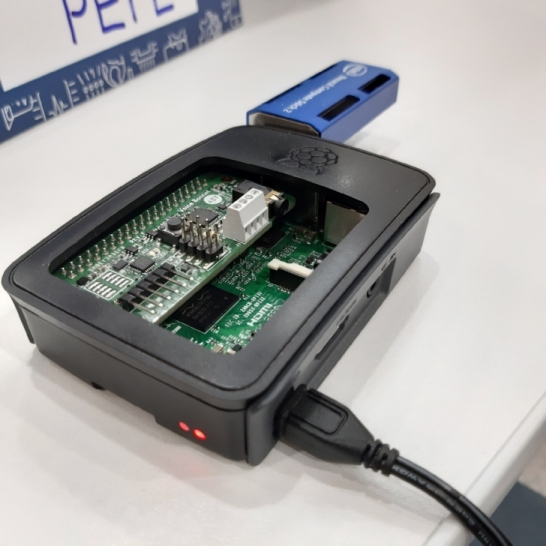
Nous ajustons le boîtier avec une lime et tout s'adapte, on peut même fermer le couvercle.
Ajoutons un bouton indicateur.
Lors du démontage du AIY Voice Kit, je me rappelle qu'il y a un bouton RGB dont on peut contrôler l'éclairage via programme. Nous recherchons “Google AIY Led” et trouvons la documentation :
Pourquoi ne pas utiliser ce bouton pour afficher l'émotion reconnue, nous avons seulement 7 classes, et le bouton a 8 couleurs, c'est juste ce qu'il faut !
Connect the button to the GPIO of the Voice Bonnet, load the necessary libraries (they are already installed in the distribution from AIY projects)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Let's create a dict where each emotion corresponds to a color in the form of an RGB Tuple and an object of the class aiy.leds.Leds, through which we will update the color:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
And finally, after each new emotion prediction, we will update the button color accordingly (by key).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))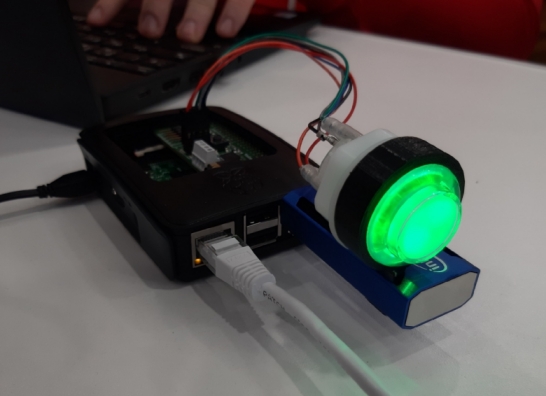
Button, light up!
Working with voice
We will use pyaudio to capture the stream from the microphone and webrtcvad to filter noise and detect voice. Additionally, we will create a queue to asynchronously add and retrieve voice snippets.
Since webrtcvad has a limit on the size of the fragment — it must be equal to 10/20/30 ms, and the model for emotion recognition was trained on a 48 kHz dataset, we will capture chunks of size 48000×20ms/1000×1 (mono) = 960 bytes. Webrtcvad will return True/False for each of these chunks, corresponding to the presence or absence of voice in the chunk.
We will implement the following logic:
- We will add chunks where there is voice to the list; if there is no voice, we will increment the counter of empty chunks.
- If the counter of empty chunks >= 30 (600 ms), then we look at the size of the accumulated chunks list, if it > 250, we add it to the queue; if not, we consider that the recording length is insufficient to submit it to the model for speaker identification.
- If the counter of empty chunks is still < 30, and the size of the accumulated chunks list exceeds 300, we will add the snippet to the queue for a more accurate prediction. (since emotions tend to change over time)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
Il est temps de rechercher des modèles préentraînés disponibles publiquement, nous allons sur github, faisons des recherches, mais n'oublions pas que nous avons des limitations sur l'architecture utilisée. C'est une partie assez complexe, car nous devons tester les modèles sur nos propres données d'entrée et, en plus, les convertir au format interne OpenVINO - IR (Représentation Intermédiaire). Nous avons essayé environ 5 à 7 solutions différentes sur github, et si le modèle de reconnaissance des émotions a fonctionné immédiatement, il a fallu plus de temps pour la reconnaissance vocale - des architectures plus complexes sont utilisées.
Nous nous arrêtons sur les suivants :
- Émotions de la voix -
Elle fonctionne selon le principe suivant : l'audio est découpé en morceaux de taille définie, pour chacun de ces morceaux, nous extrayons et ensuite nous les fournissons en entrée dans le CNN - Reconnaissance vocale -
Ici, au lieu de MFCC, nous travaillons avec un spectrogramme, après le FFT, nous envoyons le signal dans le CNN, où nous obtenons en sortie une représentation vectorielle de la voix.
Nous allons maintenant parler de la conversion des modèles, commençons par la théorie. OpenVINO comprend plusieurs modules :
- Open Model Zoo, des modèles que l'on pouvait utiliser et intégrer dans son produit
- Model Optimizer, grâce auquel il est possible de reconvertir un modèle de différents formats de frameworks (Tensorflow, ONNX, etc.) au format Représentation Intermédiaire, avec lequel nous allons ensuite travailler
- Inference Engine permet de déployer des modèles au format IR sur les processeurs Intel, les puces Myriad et les accélérateurs Neural Compute Stick
- La version OpenCV la plus efficace (avec prise en charge de l'Inference Engine)
Chaque modèle au format IR est décrit par deux fichiers : .xml et .bin.
Les modèles sont convertis au format IR via le Model Optimizer comme suit :python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typepermet de sélectionner le format de données avec lequel le modèle va fonctionner. Les formats pris en charge sont FP32, FP16, INT8. Choisir le type de données optimal peut donner un bon gain de performance.
--input_shapeindique la dimensionnalité des données d'entrée. Il semble possible de la modifier dynamiquement dans l'API C++, mais nous ne sommes pas allés aussi loin et pour l'un des modèles, nous l'avons simplement fixée.
Ensuite, nous allons essayer de charger le modèle déjà converti au format IR via le module DNN dans OpenCV et d'effectuer un forward dessus.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)La dernière ligne dans ce cas permet de rediriger les calculs vers le Neural Compute Stick, à la base les calculs sont effectués sur le processeur, mais dans le cas du Raspberry Pi, cela ne fonctionnera pas, un stick sera nécessaire.
Ensuite, la logique est la suivante : nous allons diviser notre audio en fenêtres de taille déterminée (dans notre cas, 0.4s), chacune de ces fenêtres sera transformée en MFCC, que nous allons ensuite passer au réseau :
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Ensuite, nous prendrons la classe la plus fréquemment rencontrée pour toutes les fenêtres. Une solution simple, mais pour un hackathon, il n'est pas nécessaire d'inventer quelque chose de trop élaboré, sauf si le temps le permet. Nous avons encore beaucoup de travail, donc continuons — nous enquêtons sur la reconnaissance vocale. Nous devons créer une base de données où seraient stockées les spectrogrammes des voix préenregistrées. Étant donné qu'il nous reste peu de temps, nous abordons cette question comme nous le pouvons.
Plus précisément, nous créons un script pour enregistrer un extrait de voix (il fonctionne de la même manière que décrit ci-dessus, sauf qu'en cas d'interruption par le clavier, il sauvegardera la voix dans un fichier).
Essayons :
python3 voice_db/record_voice.py test.wavEnregistrons les voix de plusieurs personnes (dans notre cas, trois membres de l'équipe)
Ensuite, pour chaque voix enregistrée, nous effectuons une transformation de Fourier rapide, obtenons le spectrogramme et le sauvegardons sous forme de tableau numpy (.npy) :for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Voir le fichier
create_base.py
En fin de compte, en lançant le script principal, nous obtiendrons au tout début des embeddings issus de ces spectrogrammes :for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Après avoir obtenu l'embedding du segment sonore, nous pouvons déterminer à qui il appartient en prenant la distance cosinus du segment par rapport à toutes les voix dans la base (plus la valeur est faible, plus c'est probable) — pour la démo, nous avons fixé le seuil à 0,3 :
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
En conclusion, je note que la vitesse d'inférence était rapide et permettait d'ajouter encore 1 à 2 modèles (pour un échantillon de 7 secondes, l'inférence prenait 2,5 sec). Nous n'avons pas eu le temps d'ajouter de nouveaux modèles et nous nous sommes concentrés sur la rédaction d'un prototype d'application web.
Application web
Point important : nous emportons un routeur de la maison et configurons notre réseau local, ce qui aide à connecter les appareils et les ordinateurs portables par le réseau.
Le backend est un canal de messages entre le frontend et Raspberry Pi, basé sur la technologie websocket (http sur un protocole tcp).
La première étape consiste à obtenir les informations traitées de la Raspberry, c'est-à-dire les prédictions empaquetées en json, qui sont enregistrées dans une base de données au milieu de leur chemin, afin de pouvoir établir des statistiques sur l'état émotionnel de l'utilisateur sur une période. Ensuite, ce paquet est envoyé au frontend, qui utilise l'abonnement et la réception des paquets à partir de l'endpoint du websocket. L'ensemble du mécanisme backend est construit dans le langage golang, le choix s'est porté sur lui car il convient bien aux tâches asynchrones, que les goroutines gèrent bien.
Lors de l'accès à l'endpoint, l'utilisateur s'enregistre et est inscrit dans une structure, puis son message est reçu. L'utilisateur et le message sont ajoutés à un hub commun, d'où les messages sont ensuite envoyés vers le frontend abonné. Si l'utilisateur ferme la connexion (Raspberry ou frontend), son abonnement est annulé et il est supprimé du hub.
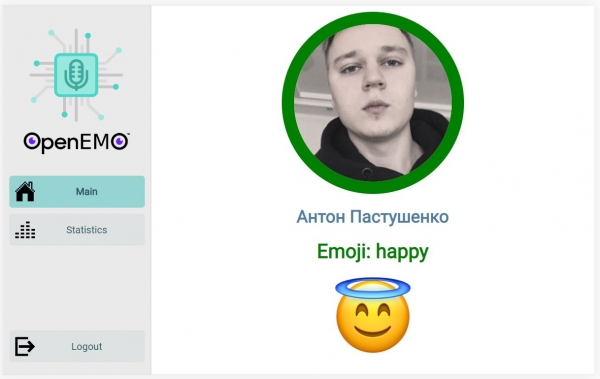
Nous attendons une connexion depuis le backendLe front-end est une application web écrite en JavaScript, utilisant la bibliothèque React pour accélérer et simplifier le processus de développement. L'objectif de cette application est de visualiser les données obtenues par des algorithmes exécutés côté back-end et directement sur Raspberry Pi. La page intègre le routage par sections, réalisé grâce à react-router, mais l'intérêt principal réside dans la page d'accueil, où un flux continu de données est transmis en temps réel depuis le serveur via la technologie WebSocket. Raspberry Pi détecte la voix, identifie l'appartenance à une personne spécifique dans la base de données enregistrée et envoie une liste de probabilités au client. Le client affiche les dernières données pertinentes, présente l'avatar de la personne qui a le plus de chances d'avoir parlé dans le microphone, ainsi que l'émotion avec laquelle elle prononce les mots.

Page d'accueil avec des prédictions mises à jourConclusion
Nous n'avons pas pu finir tout ce que nous avions prévu, nous manquions simplement de temps, donc notre plus grand espoir était la démo, celle que tout fonctionnerait. Lors de la présentation, nous avons expliqué comment tout était organisé, quels modèles avaient été utilisés et les problèmes rencontrés. Ensuit, il y a eu une partie de démo : les experts circulaient dans la salle de manière aléatoire et venaient voir chaque équipe pour découvrir le prototype fonctionnel. Ils posaient des questions, et chacun répondait selon sa spécialité, nous avons laissé le site web ouvert sur un ordinateur portable, et tout fonctionnait effectivement comme prévu.
Je tiens à souligner que le coût total de notre solution s'est élevé à 150 € :
- Raspberry Pi 3 ~ 35 €
- Google AIY Voice Bonnet (vous pouvez opter pour la carte respeaker) ~ 15 €
- Intel NCS 2 ~ 100 €
Comment améliorer :
- Utiliser l'enregistrement depuis le client — demander de lire le texte que nous générons aléatoirement
- Ajouter quelques modèles supplémentaires : on peut déterminer le sexe et l'âge par la voix
- Séparer les voix qui sonnent en même temps (diarisation)
Dépôt :

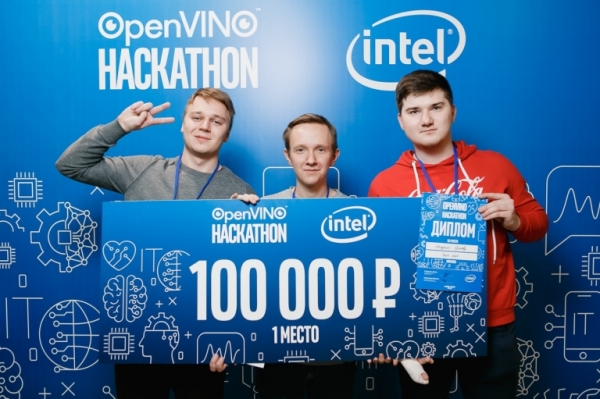
Fatigués mais heureux, nousEn conclusion, je tiens à remercier les organisateurs et les participants. Parmi les projets des autres équipes, nous avons particulièrement apprécié la solution pour le suivi des places de parking libres. Pour nous, cela a été une expérience incroyablement enrichissante d'immersion dans le produit et le développement. J'espère que de plus en plus d'événements intéressants se tiendront dans les régions, y compris sur le thème de l'IA.
Source : habr.com
