

Cet article est consacré à Python Gateway, un projet communautaire open source pour la plateforme de données InterSystems IRIS. Ce projet permet d'orchestrer n'importe quel algorithme d'apprentissage automatique développé en Python (la principale plateforme pour de nombreux Data Scientists), d'utiliser de nombreuses bibliothèques prêtes à l'emploi pour créer rapidement des solutions analytiques AI/ML adaptatives et robotisées sur la plateforme InterSystems IRIS. Dans cet article, je vais montrer comment InterSystems IRIS peut orchestrer des processus en Python, effectuer une transmission bidirectionnelle des données et créer des processus commerciaux intelligents.
Plan
- Introduction.
- Outils.
- Installation.
- API.
- Interopérabilité.
- Jupyter Notebook.
- Conclusions.
- Liens.
- MLToolkit.
Introduction
Python est un langage de programmation de haut niveau et généraliste, axé sur l'amélioration de la productivité du développeur et la lisibilité du code. Dans cette série d'articles, je vais parler des possibilités d'application du langage Python sur la plateforme InterSystems IRIS, l'accent de cet article étant mis sur l'utilisation de Python comme langue de création et d'application de modèles d'apprentissage automatique.
L'apprentissage automatique (ML) est une classe de méthodes d'intelligence artificielle, dont la caractéristique est de ne pas résoudre directement un problème, mais d'apprendre au cours de la résolution de plusieurs problèmes similaires.
Les algorithmes et modèles d'apprentissage automatique deviennent de plus en plus répandus. Il y a de nombreuses raisons à cela, mais tout se résume à l'accessibilité, à la simplicité et à l'obtention de résultats pratiques. La classification ou même la modélisation par réseaux de neurones est-elle une nouvelle technologie?
Bien sûr que non, mais à l'heure actuelle, il n'est plus nécessaire d'écrire des centaines de milliers de lignes de code pour exécuter un modèle, et les coûts de création et d'application de modèles diminuent de plus en plus.
Les outils évoluent — alors que nous n'avons pas d'outils AI/ML entièrement orientés GUI, le progrès que nous avons observé avec de nombreuses autres classes de systèmes d'information, par exemple, BI (de l'écriture de code à l'utilisation de cadres et de solutions configurables orientées GUI), est également observé dans les outils de création AI/ML. Nous avons déjà dépassé le stade de l'écriture de code et utilisons aujourd'hui des cadres pour construire et entraîner des modèles.
D'autres améliorations, telles que la possibilité de déployer un modèle pré-entraîné, où l'utilisateur final doit simplement terminer l'entraînement du modèle sur ses données spécifiques, facilitent également le démarrage de l'application de l'apprentissage automatique. Ces avancées rendent l'apprentissage du machine learning beaucoup plus acessible tant pour les spécialistes que pour les entreprises dans leur ensemble.
D'un autre côté, nous recueillons de plus en plus de données. Grâce à une plateforme de données unifiée comme InterSystems IRIS, toutes ces informations peuvent être immédiatement préparées et utilisées comme données d'entrée pour les modèles d'apprentissage automatique.
Avec le passage au cloud, le lancement de projets AI/ML devient plus facile que jamais. Nous pouvons consommer uniquement les ressources dont nous avons besoin. De plus, grâce à la parallélisation offerte par les plateformes cloud, nous pouvons économiser du temps.
Mais qu'en est-il des résultats ? Ici, les choses deviennent plus complexes. Il existe de nombreux outils pour construire des modèles, dont je parlerai plus loin. Construire un bon modèle n'est pas facile, mais qu'en est-il ensuite ? Tirer profit de l'utilisation du modèle par l'entreprise est également un défi non négligeable. Le cœur du problème réside dans la séparation des charges analytiques et transactionnelles, ainsi que des modèles de données. Lorsque nous entraînons un modèle, nous le faisons généralement sur des données historiques. Mais l'endroit où le modèle doit opérer est dans le traitement transactionnel des données. Quelle utilité a le meilleur modèle de détection des transactions frauduleuses si nous ne l'exécutons qu'une fois par jour ? Les fraudeurs sont déjà partis avec l'argent. Nous devons entraîner le modèle sur des données historiques, mais nous devons aussi l'appliquer en temps réel sur les nouvelles données entrantes afin que nos processus d'affaires puissent agir en fonction des prévisions faites par le modèle.
Le ML Toolkit est un ensemble d'outils dont l'objectif est précisément cela : réunir les modèles et l'environnement transactionnel, afin que les modèles construits puissent être facilement utilisés directement dans vos processus d'affaires. Le Python Gateway fait partie du ML Toolkit et assure l'intégration avec le langage Python (similairement, le R Gateway, qui fait également partie du ML Toolkit, assure l'intégration avec le langage R).
Outils
Avant de continuer, je voudrais décrire quelques outils et bibliothèques Python que nous utiliserons plus tard.
Technologies
- Python est un langage de programmation interprété de haut niveau à usage général. L'un des principaux avantages de ce langage est sa vaste bibliothèque de bibliothèques mathématiques, ML et AI. À l'instar d'ObjectScript, c'est un langage orienté objet, mais tout est défini dynamiquement, et non statiquement. Tout est également un objet. Les articles ultérieurs supposeront une familiarité superficielle avec le langage. Si vous souhaitez commencer à apprendre, je vous recommande de commencer par .
- Pour nos exercices suivants, installez .
- IDE : J'utilise , mais en général, il y en a . Si vous utilisez Atelier, il existe un plugin Eclipse pour les développeurs Python. Si vous utilisez VS Code, il existe une extension pour Python.
- Notebook : au lieu d'un IDE, vous pouvez écrire et partager vos scripts dans des notebooks en ligne. Le plus populaire d'entre eux est .
Bibliothèques
Voici une liste (non exhaustive) de bibliothèques pour l'apprentissage automatique :
- — un paquet fondamental pour les calculs numériques.
- — des structures de données à haute performance et des outils d'analyse de données.
- — création de graphiques.
- — visualisation de données basée sur matplotlib.
- — méthodes d'apprentissage automatique.
- — algorithmes d'apprentissage automatique basés sur la méthodologie du gradient boosting.
- — NLP.
- — réseaux de neurones.
- — plateforme pour créer des modèles d'apprentissage automatique.
- — plateforme pour créer des modèles d'apprentissage automatique orientée vers Python.
- — PMML à partir de différents modèles.
Les technologies AI/ML permettent de rendre les entreprises plus efficaces et adaptables. De plus, aujourd'hui, ces technologies deviennent plus faciles à développer et à mettre en œuvre. Commencez à étudier les technologies AI/ML et comment elles peuvent aider votre organisation à croître.
Installation
Il existe plusieurs façons d'installer et d'utiliser Python Gateway :
- OS
- Windows
- Linux
- Mac
- Docker
- Utilisez l'image de DockerHub
- Créez votre propre image
Peu importe la méthode d'installation, vous aurez besoin du code source. Le seul endroit pour télécharger le code est . Elle contient des versions stables testées, il suffit de prendre la plus récente. Actuellement, c'est 0.8, mais de nouvelles versions viendront avec le temps. Ne clonez pas/téléchargez pas le dépôt, téléchargez la dernière version.
OS
Si vous installez le Python Gateway sur un système d'exploitation, il est d'abord nécessaire d'installer Python, quel que soit le système d'exploitation.
- . Il est recommandé d'installer Python dans le répertoire par défaut.
- Installez le module
dill:pip install dill. - Téléchargez le code ObjectScript (c'est-à-dire
do $system.OBJ.ImportDir("C:InterSystemsReposPythoniscpy", "*.cls", "c",,1)) dans n'importe quelle zone avec des produits. Si vous souhaitez qu'une zone existante prenne en charge les produits, exécutez :write ##class(%EnsembleMgr).EnableNamespace($Namespace, 1). - Placez dans le dossier
binde votre instance InterSystems IRIS. Le fichier de bibliothèque doit être accessible au chemin retourné parwrite ##class(isc.py.Callout).GetLib().
Windows
- Assurez-vous que la variable d'environnement
PYTHONHOMEpointe vers Python 3.6.7. - Assurez-vous que la variable d'environnement système
PATHcontient la variablePYTHONHOME(ou le répertoire auquel elle pointe).
Linux (Debian/Ubuntu)
- Vérifiez que la variable d'environnement
PATHcontient/usr/libet/usr/lib/x86_64-linux-gnu. Utilisez le fichier/etc/environmentpour configurer les variables d'environnement. - En cas d'erreurs
undefined symbol: _Py_TrueStructdéfinissez la configurationPythonLib. De plus, dans il y a une section Dépannage.
Mac
- Actuellement, seule la version Python 3.6.7 est prise en charge à partir de . Vérifiez la variable
PATH.
Si vous avez modifié les variables d'environnement, redémarrez votre produit InterSystems.
Docker
L'utilisation de conteneurs présente plusieurs avantages :
- Portabilité
- Efficacité
- Isolation
- Légèreté
- Immutabilité
Consultez cette pour des informations plus détaillées sur l'utilisation de Docker avec les produits InterSystems.
Tous les builds du Python Gateway sont actuellement basés sur des conteneurs 2019.4.
Image prête
Exécutez : docker run -d -p 52773:52773 --name irispy intersystemscommunity/irispy-community:latest, pour télécharger et exécuter le Python Gateway avec l'édition communautaire d'InterSystems IRIS. C'est tout.
Créez votre propre image
Pour construire l'image Docker, exécutez à la racine du dépôt : docker build --force-rm --tag intersystemscommunity/irispy:latest ..
Par défaut, l'image est construite à partir de l'image store/intersystems/iris-community:2019.4.0.383.0, mais vous pouvez modifier cela en définissant la variable IMAGE.
Pour construire à partir d'InterSystems IRIS, exécutez : `docker build —build-arg IMAGE=store/intersystems/iris:2019.4.0.383.0 —force-rm —tag intersystemscommunity/irispy:latest.`
Après cela, vous pouvez exécuter l'image Docker :
docker run -d
  -p 52773:52773
  -v //:/mount
  --name irispy
  intersystemscommunity/irispy:latest
  --key /mount/iris.key
Si vous utilisez une image basée sur l'édition communautaire d'InterSystems IRIS, vous n'avez pas besoin de spécifier de clé.
Commentaires
- Processus de test
isc.py.test.Processsauvegarde une série d'images dans un répertoire temporaire. Vous voudrez peut-être modifier ce chemin vers un répertoire monté. Pour ce faire, éditez le paramètreWorkingDiren spécifiant le répertoire monté. - Pour accéder au terminal, exécutez :
docker exec -it irispy sh. - Accès au Portail de Gestion du Système avec le login
SuperUser/SYS. - Pour arrêter le conteneur, exécutez :
docker stop irispy && docker rm --force irispy.
Vérification de l'installation
Après avoir installé le Python Gateway, vérifiez qu'il fonctionne. Exécutez ce code dans le terminal InterSystems IRIS :
set sc = ##class(isc.py.Callout).Setup()
set sc = ##class(isc.py.Main).SimpleString("x='HELLO'", "x", , .var).
write var
Cela devrait afficher HELLO — la valeur de la variable Python x. Si le statut retourné sc est une erreur ou var vide, vérifiez .
API
Python Gateway est installé, et vous avez vérifié qu'il fonctionne. Il est temps de commencer à l'utiliser !
L'interface principale de Python est isc.py.Main. Il propose les groupes de méthodes suivants (toutes retournent %Status):
- Exécution du code
- Transmission de données
- Méthodes auxiliaires
Exécution du code
Ces méthodes permettent d'exécuter du code Python arbitraire.
SimpleString
SimpleString — c'est la méthode principale. Elle accepte 4 arguments optionnels :
code— une chaîne de code à exécuter. Le caractère de nouvelle ligne :$c(10).returnVariable— le nom de la variable à retourner.serialization— comment sérialiser.returnVariable. 0 — chaîne (par défaut), 1 — repr.result— ByRef référence à la variable dans laquelle la valeur est écritereturnVariable.
Nous avons précédemment exécuté :
set sc = ##class(isc.py.Main).SimpleString("x='HELLO'", "x", , .var).Dans cet exemple, nous attribuons à la variable Python x la valeur Bonjour et voulons retourner la valeur de la variable Python x dans une variable ObjectScript var.
ExecuteCode
ExecuteCode est une alternative plus sûre et moins restrictive SimpleString.
Les chaînes dans la plateforme InterSystems IRIS sont limitées à 3 641 144 caractères, et si vous souhaitez exécuter un morceau de code plus long, vous devez utiliser des workflows.
Deux arguments sont acceptés :
code— une chaîne ou un flux de code Python à exécuter.variable— (optionnel) attribue le résultat de l'exécutioncodeà cette variable Python.
Exemple d'utilisation :
set sc = ##class(isc.py.Main).ExecuteCode("2*3", "y").Dans cet exemple, nous multiplions 2 par 3 et enregistrons le résultat dans la variable Python y.
Transmission de données
Transférez des données entre Python et InterSystems IRIS.
Python -> InterSystems IRIS
Il existe 4 façons d'obtenir la valeur d'une variable Python dans InterSystems IRIS, selon la sérialisation dont vous avez besoin :
Chaînepour les types de données simples et le débogage.Reprpour le stockage d'objets simples et le débogage.JSONpour manipuler facilement les données côté InterSystems IRIS.Picklepour la sauvegarde d'objets.
Ces méthodes permettent d'obtenir des variables Python sous forme de chaînes ou de flux.
GetVariable(variable, serialization, .stream, useString)— obtenirserializationvariablevariabledansstream. SiuseStringégal à 1 et la sérialisation est placée dans une chaîne, donc renvoie une chaîne et non un flux.GetVariableJson(variable, .stream, useString)— obtenir la sérialisation JSON de la variable.GetVariablePickle(variable, .stream, useString, useDill)— obtenir la sérialisation Pickle (ou Dill) de la variable.
Essayons d'obtenir notre variable y.
set sc = ##class(isc.py.Main).GetVariable("y", , .val, 1)
write val
>6
InterSystems IRIS -> Python
Nous chargeons des données d'InterSystems IRIS dans Python.
ExecuteQuery(query, variable, type, namespace)— crée un ensemble de données (pandasdataframeoulist) d'une requête SQL et l'assigne à une variable Python.variable. Le packageisc.pydoit être disponible dans la zonenamespace— où la requête sera exécutée.ExecuteGlobal(global, variable, type, start, end, mask, labels, namespace)— charge les données d'un globalglobald'un sous-scriptstartàenddans Python comme une variable de typetype:list, ou pandas.dataframe. La description des arguments optionnelsmasquerandlabelsest disponible dans la documentation de la classe et le dépôt .ExecuteClass(class, variable, type, start, end, properties, namespace)— charge les données d'une classeclassd'un idstartàenddans Python comme une variable de typetype:list, ou pandas.dataframe.properties— liste (séparateur : virgule) des propriétés de classe à charger dans l'ensemble de données. Les masques sont supportés.*et?. Par défaut —*(toutes les propriétés). La propriété%%CLASSNAMEest ignorée.ExecuteTable(table, variable, type, start, end, properties, namespace)— charge les données d'une tabletabled'un idstartàenddans Python.
ExecuteQuery — est universel (toute requête SQL valide sera transmise à Python). Cependant, ExecuteGlobal et ses enveloppes ExecuteClass et ExecuteTable ont des limitations. Ils sont beaucoup plus rapides (3 à 5 fois plus rapides que le pilote ODBC et 20 fois plus rapides ExecuteQuery). Plus d'informations dans .
Toutes ces méthodes supportent le transfert de données depuis n'importe quelle zone. Le package isc.py doit être accessible dans la zone cible.
ExecuteQuery
ExecuteQuery(request, variable, type, namespace) — transmission des résultats de toute requête SQL valide vers Python. C'est la méthode la plus lente pour transférer des données. Utilisez-la si ExecuteGlobal et ses enveloppes ne sont pas disponibles.
Arguments :
query— requête SQL.variable— nom de la variable Python dans laquelle les données sont écrites.type—listou Pandasdataframe.namespace— zone dans laquelle la requête sera exécutée.
ExecuteGlobal
ExecuteGlobal(global, variable, type, start, end, mask, labels, namespace) — transmission d'un global vers Python.
Arguments :
global— nom du global sans^variable— nom de la variable Python dans laquelle les données sont écrites.type—listou Pandasdataframe.start— premier sous-script du global. Obligatoire%Integer.end— dernier sous-script du global. Obligatoire.%Integer.masquer— masque de valeurs de la variable globale. La masque peut être plus courte que le nombre de champs dans la variable globale (dans ce cas, les champs à la fin seront ignorés). Comment formater le masque :+transférer la valeur telle quelle.-ignorer la valeur.b— Type logique (0—False, tout le reste —Vrai).d— Date (à partir de $horolog, sous Windows depuis 1970, sous Linux depuis 1900).t— Heure ($horolog, secondes après minuit).m— Horodatage (chaîne au format ANNÉE-MOIS-JOUR HEURE:MINUTE:SECONDE).
labels— %Liste des noms de colonnes. Le premier élément — le nom du sous-script.namespace— zone dans laquelle la requête sera exécutée.
ExecuteClass
Enveloppe sur ExecuteGlobal. Prépare l'appel basé sur la définition de la classe ExecuteGlobal et l'appelle.
ExecuteClass(class, variable, type, start, end, properties, namespace) — passage de données de classe en Python.
Arguments :
class— nom de la classevariable— nom de la variable Python dans laquelle les données sont écrites.type—listou Pandasdataframe.start— Id de départ.end— Id de finproperties— liste (séparateur : virgule) des propriétés de classe à charger dans l'ensemble de données. Les masques sont supportés.*et?. Par défaut —*(toutes les propriétés). La propriété%%CLASSNAMEest ignorée.namespace— zone dans laquelle la requête sera exécutée.
Toutes les propriétés sont transférées telles quelles, sauf les propriétés des types te, %Heure, %Booléen et %Horodatage — elles sont converties en classes Python correspondantes.
ExecuteTable
Enveloppe sur ExecuteClass. Transmet le nom de la table au nom de la classe et l'appelle ExecuteClass. Signature :
ExecuteTable(table, variable, type, start, end, properties, namespace) — passage de données de table en Python.
Arguments :
table— nom de la table.
Tous les autres arguments sont passés tels quels dansExecuteClass.
Remarques
ExecuteGlobal,ExecuteClassetExecuteTablefonctionnent aussi vite.ExecuteGlobal20 fois plus vite queExecuteQuerysur de grands ensembles de données (temps de transfert supérieur à >0.01 seconde).ExecuteGlobal,ExecuteClassetExecuteTablefonctionnent sur des variables globales avec cette structure :^global(clef) = $lb(prop1, prop2, ..., propN)oùkey— entier.- Pour
ExecuteGlobal,ExecuteClassetExecuteTableplage de valeurs acceptéestecorrespond à la plagemktimeet dépend du système d'exploitation (: 1970-01-01, 1900-01-01, ). Utilisez%Horodatagepour transférer des données en dehors de cette plage ou utilisez un dataframe pandas car cette limitation ne s'applique qu'à la liste. - Pour
ExecuteGlobal,ExecuteClassetExecuteTabletous les arguments à l'exception de la source de données (variable globale, classe ou table) et la variable sont optionnels.
Exemples
Classe de test contient une méthode démontrant toutes les variantes de passage de données :
set global = "isc.py.test.PersonD"
set class = "isc.py.test.Person"
set table = "isc_py_test.Person"
set query = "SELECT * FROM isc_py_test.Person"

// Arguments généraux
set variable = "df"
set type = "dataframe"
set start = 1
set end = $g(^isc.py.test.PersonD, start)

// Méthode 0 : ExecuteGlobal sans arguments
set sc = ##class(isc.py.Main).ExecuteGlobal(global, variable _ 0, type)

// Méthode 1 : ExecuteGlobal avec arguments
// Lors de la transmission du global, les noms des champs sont définis manuellement
// globalKey - le nom du sous-script
set labels = $lb("globalKey", "Nom", "DOB", "TS", "RandomTime", "AgeYears", "AgeDecimal", "AgeDouble", "Bool")

// mask a un élément de moins que labels car "globalKey" - le nom du sous-script
// Nous omettons %%CLASSNAME
set mask = "-+dmt+++b"

set sc = ##class(isc.py.Main).ExecuteGlobal(global, variable _ 1, type, start, end, mask, labels)

// Méthode 2 : ExecuteClass
set sc = ##class(isc.py.Main).ExecuteClass(class, variable _ 2, type, start, end)

// Méthode 3 : ExecuteTable
set sc = ##class(isc.py.Main).ExecuteTable(table, variable _ 3, type, start, end)

// Méthode 4 : ExecuteTable
set sc = ##class(isc.py.Main).ExecuteQuery(query, variable _ 4, type)
Appelez la méthode do ##class(isc.py.test.Person).Test() pour voir comment fonctionnent toutes les méthodes de transmission de données.
Méthodes d'assistance
GetVariableInfo(variable, serialization, .defined, .type, .length)— obtenir des informations sur la variable : si elle est définie, la classe et la longueur de la sérialisation.GetVariableDefined(variable, .defined)— la variable est-elle définie.GetVariableType(variable, .type)— obtenir la classe de la variable.GetStatus()— obtenir et supprimer la dernière exception côté Python.GetModuleInfo(module, .imported, .alias)— obtenir la variable du module et le statut d'importation.GetFunctionInfo(function, .defined, .type, .docs, .signature, .arguments)— obtenir des informations sur la fonction.
Interopérabilité
Vous avez appris à appeler Python Gateway depuis le terminal, maintenant commençons à l'utiliser en production. La base de l'interaction avec Python dans ce mode est — isc.py.ens.Operation. Il nous permet de :
- Exécuter du code Python
- Sauvegarder/Récupérer le contexte Python
- Charger et obtenir des données de Python
En principe, l'opération Pyhton est un wrapper autour de isc.py.Main. L'opération isc.py.ens.Operation permet d'interagir avec le processus Python depuis les productions InterSystems IRIS. Cinq types de requêtes sont supportés :
isc.py.msg.ExecutionRequestpour exécuter le code Python. Renvoieisc.py.msg.ExecutionResponseavec le résultat de l'exécution et les valeurs des variables demandées.isc.py.msg.StreamExecutionRequestpour exécuter le code Python. Renvoieisc.py.msg.StreamExecutionResponseavec le résultat de l'exécution et les valeurs des variables demandées. Semblable àisc.py.msg.ExecutionRequest, mais accepte et renvoie des flux au lieu de chaînes.isc.py.msg.QueryRequestpour transmettre le résultat de l'exécution de la requête SQL. RenvoieEns.Response.isc.py.msg.GlobalRequest/isc.py.msg.ClassRequest/isc.py.msg.TableRequestpour transmettre des données de global/classe/table. RenvoieEns.Response.isc.py.msg.SaveRequestpour sauvegarder le contexte Python. RenvoieEns.StringResponseavec l'identifiant de contexte.isc.py.msg.RestoreRequestpour restaurer le contexte Python.De plus,
isc.py.ens.Operationa deux paramètres :Initializer— choix de la classe implémentant l'interfaceisc.py.init.Abstract. Il peut être utilisé pour charger des fonctions, des modules, des classes, etc. Il s'exécute une seule fois au démarrage du processus.PythonLib— (uniquement pour Linux) si vous voyez des erreurs lors du chargement, définissez sa valeur àlibpython3.6m.soou même au chemin complet de la bibliothèque Python.
Création de processus métier
Deux classes sont disponibles pour faciliter le développement des processus métier :
isc.py.ens.ProcessUtilspermet d'extraire des annotations des activités avec substitution de variables.isc.py.util.BPEmulatorfacilite le test des processus métier avec Python. Il peut exécuter un processus métier (parties en langage Python) dans le processus actuel.
Substitution de variables
Tous les processus métier hérités de isc.py.ens.ProcessUtils, peuvent utiliser la méthode GetAnnotation(name) pour obtenir la valeur de l'annotation d'une activité par son nom. L'annotation d'activité peut contenir des variables, qui seront calculées côté InterSystems IRIS avant d'être transmises à Python. Voici la syntaxe de substitution de variables :
${class:method:arg1:...:argN}— appel de méthode#{expr}— exécuter du code en ObjectScript.
Un exemple est disponible dans le processus métier de test isc.py.test.Process, par exemple, dans l'activité Matrice de Corrélation : Graphique: f.savefig(r'#{process.WorkDirectory}SHOWCASE${%PopulateUtils:Integer:1:100}.png'). Dans cet exemple :
#{process.WorkDirectory}renvoie la propriété WorkDirectory de l'objetprocess, qui est une instance de la classeisc.py.test.Processc'est-à-dire le processus métier actuel.${%PopulateUtils:Integer:1:100}est cliqué, cela appelle la méthodeEntierclasse%PopulateUtils, en passant les arguments1et100, renvoyant un entier aléatoire dans la plage1...100.
Processus métier de test
Le produit de test et le processus métier de test sont disponibles par défaut dans le cadre du Python Gateway. Pour les utiliser :
- Exécutez dans le terminal de l'OS :
pip install pandas matplotlib seaborn. - Dans le terminal InterSystems IRIS, exécutez :
do ##class(isc.py.test.CannibalizationData).Import()pour remplir les données de test. - Lancez le produit
isc.py.test.Production. - Envoyer une requête de type
Ens.Requestdansisc.py.test.Process.
Voyons comment tout cela fonctionne ensemble. Ouvrez isc.py.test.Process dans l'éditeur BPL :
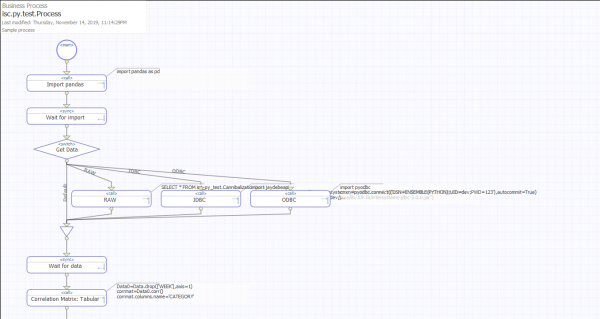
Exécution du code
L'appel le plus important — exécution du code Python :
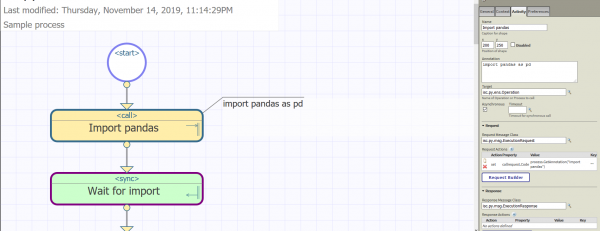
Utilisé une requête isc.py.msg.ExecutionRequest, voici ses propriétés :
Code— le code Python.SeparateLines— séparer le code en lignes pour exécution.$c(10)(n) est utilisé pour séparer les lignes. Notez qu'il n'est PAS recommandé de traiter le message dans son ensemble, cette fonction est uniquement destinée à traiterdefet autres expressions multi-lignes. Par défaut,0.Variables— une liste de variables séparées par des virgules qui seront ajoutées à la réponse.Sérialisation— Comment sérialiser les variables que nous souhaitons retourner. Options :Str,Repr,JSON,PickleetDill, par défautStr.
Dans notre cas, nous définissons simplement la propriété Code, donc toutes les autres propriétés utilisent les valeurs par défaut. Nous le définissons en appelant process.GetAnnotation("Import pandas"), qui, à l'exécution, renvoie l'annotation après avoir effectué le remplacement des variables. Au final, le code import pandas as pd sera transmis à Python. GetAnnotation peut être utile pour obtenir des scripts Python multi-lignes, mais il n'y a aucune restriction sur ce moyen d'obtenir le code. Vous pouvez définir la propriété Code de n'importe quelle manière qui vous convient.
Obtention des variables
Un autre appel intéressant utilisant isc.py.msg.ExecutionRequest — Matrice de Corrélation : Tabulaire:
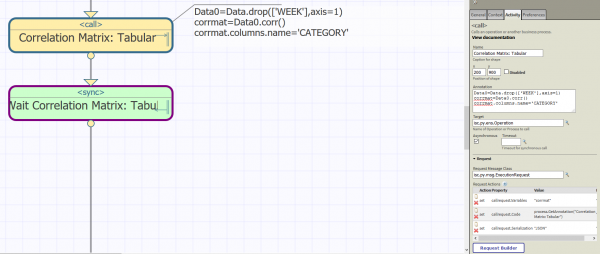
Il calcule la Matrice de Corrélation côté Python et extrait la variable corrmat en retour dans InterSystems IRIS au format JSON, en définissant les propriétés de la requête :
Variables:"corrmat"Sérialisation:"JSON"
Nous pouvons voir les résultats dans Visual Trace :
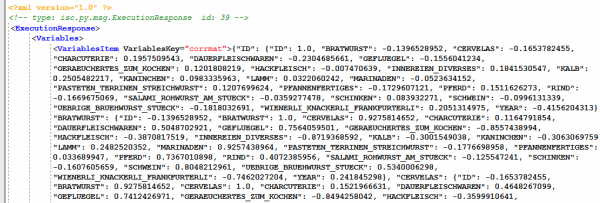
Et si nous avons besoin de cette valeur dans le BP, nous pouvons l'obtenir ainsi : callresponse.Variables.GetAt("corrmat").
Transmission de données
Parlons maintenant du passage des données d'InterSystems IRIS à Python, toutes les requêtes de passage de données implémentent l'interface isc.py.msg.DataRequest, qui fournit les propriétés suivantes :
Variable— la variable Python dans laquelle les données sont écrites.Type— type de variable :dataframe(dataframe pandas) oulist.Namespace— l'espace à partir duquel nous obtenons les données. Le packageisc.pydoit être accessible dans cet espace. Cela peut être un espace sans prise en charge des produits.
Basé sur cette interface, 4 classes de requêtes ont été implémentées :
isc.py.msg.QueryRequest— définissez la propriétéQuerypour passer la requête SQL.isc.py.msg.ClassRequest— définissez la propriétéClassepour passer les données de la classe.isc.py.msg.TableRequest— définir la propriétéTablepour passer les données de la table.isc.py.msg.GlobalRequest— définir la propriétéGlobalpour passer les données globales.
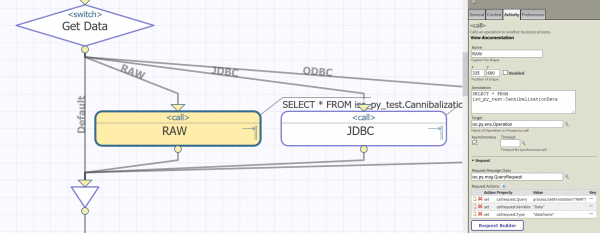
Dans le processus de test, regardez l'activité RAW, où isc.py.msg.QueryRequest illustré en action.
Sauvegarde/recuperation du contexte Python
Enfin, nous pouvons sauvegarder le contexte Python dans InterSystems IRIS, pour cela, nous enverrons isc.py.msg.SaveRequest avec les arguments :
Masque— Seules les variables correspondant au masque sont sauvegardées. Sont prises en charge*et?. Exemple :"Data*, Figure?". Par défaut*.MaxLength— Longueur maximale de la variable conservée. Si la sérialisation de la variable est plus longue, elle sera ignorée. Définissez 0 pour accepter des variables de n'importe quelle longueur. Par défaut$$$MaxStringLength.Nom— Nom du contexte (optionnel).Description— Description du contexte (optionnel).
Retourne Ens.StringResponse avec Id du contexte enregistré. Dans le processus de test, consultez l'activité Save Context.
La requête correspondante isc.py.msg.RestoreRequest charge le contexte depuis InterSystems IRIS en Python :
ContextId— identifiant du contexte.Effacer— effacer le contexte avant la restauration.
Jupyter Notebook
— il s'agit d'une application web open source qui permet de créer des notebooks contenant du code, des visualisations et du texte, et de les publier. Python Gateway permet de visualiser et d'éditer les processus BPL sous forme de Jupyter Notebook. Notez qu'actuellement, l'exécuteur Python 3 standard est utilisé.
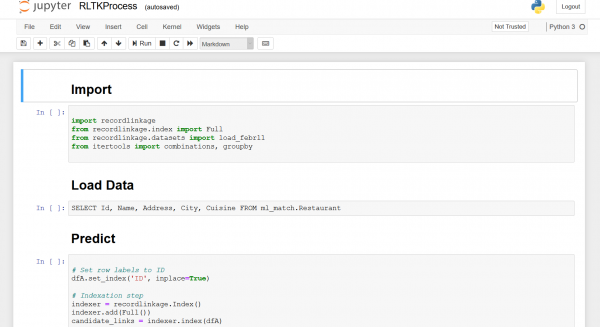
Cette extension suppose que les annotations contiennent du code Python et utilisent les noms des activités comme les titres précédents. Il est désormais possible de développer des processus métiers PythonGateway dans Jupyter Notebook. Voici ce qui est possible :
- Créer de nouveaux processus métiers
- Supprimer des processus métiers
- Créer de nouvelles activités
- Modifier des activités
- Supprimer des activités
Voici . Et quelques captures d'écran :
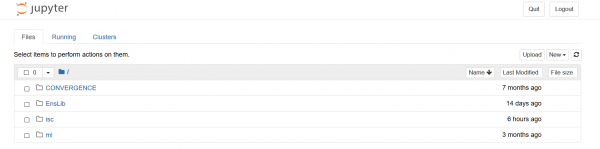
Explorateur de processus
Éditeur de processus
Installation
- Vous aurez besoin d'InterSystems IRIS 2019.2+.
- Installez PythonGateway v0.8+ (nécessaire uniquement
isc.py.util.Jupyter,isc.py.util.JupyterCheckpointsetisc.py.ens.ProcessUtils). - Mettez à jour le code ObjectScript depuis le dépôt.
- Exécutez
do ##class(isc.py.util.Jupyter).Install()et suivez les instructions.
.
Conclusions
MLToolkit est un ensemble d'outils dont l'objectif est d'intégrer les modèles et l'environnement transactionnel, afin que les modèles construits puissent être facilement utilisés directement dans vos processus métiers. Python Gateway fait partie de MLToolkit et facilite l'intégration avec le langage Python, permettant d'orchestrer n'importe quel algorithme d'apprentissage automatique créé en Python (l'environnement principal pour de nombreux data scientists), utilisant de nombreuses bibliothèques prêtes à l'emploi pour créer rapidement des solutions analytiques adaptatives et robotisées AI/ML sur la plateforme InterSystems IRIS.
Liens
MLToolkit
Le groupe d'utilisateurs de MLToolkit est un dépôt GitHub privé, créé dans le cadre de l'organisation GitHub d'InterSystems. Il s'adresse aux utilisateurs externes qui installent, étudient ou utilisent déjà des composants de MLToolkit, y compris le Python Gateway. Un certain nombre de cas d'utilisation (avec code source et données de test) dans les domaines du marketing, de la production, de la médecine et d'autres secteurs sont disponibles dans le groupe. Pour rejoindre le groupe d'utilisateurs de ML Toolkit, veuillez envoyer un court message par e-mail à l'adresse suivante : et veuillez indiquer dans votre message les informations suivantes :
- Nom d'utilisateur GitHub
- Organisation (où vous travaillez ou étudiez)
- Poste (votre poste réel dans votre organisation, ou "Étudiant", ou "Indépendant").
- Pays
À ceux qui ont lu l'article et qui sont intéressés par les possibilités d'InterSystems IRIS en tant que plateforme pour le développement ou le déploiement de systèmes d'intelligence artificielle et d'apprentissage automatique, nous proposons de discuter des scénarios pouvant intéresser votre entreprise. Nous serons heureux d'analyser les besoins de votre entreprise et de définir ensemble un plan d'action ; l'adresse e-mail de notre équipe d'experts AI/ML est - .
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish