

Le code des produits logiciels pour l'apprentissage automatique est souvent complexe et difficile à comprendre. La détection et la résolution des bugs représentent une tâche gourmande en ressources. Même les plus simples exigent une approche sérieuse en matière d'architecture réseau, d'initialisation des poids et d'optimisation du réseau. La moindre erreur peut entraîner des problèmes désagréables.
Cet article est dédié à l'algorithme de débogage de vos réseaux neuronaux.
Skillbox recommande : Cours pratique .
Rappelons-le : pour tous les lecteurs de « Habr » — une réduction de 10 000 roubles lors de l'inscription à tout cours Skillbox avec le code promo « Habr ».
L'algorithme se compose de cinq étapes :
- démarrage simple ;
- confirmation des pertes ;
- vérification des résultats intermédiaires et des connexions ;
- diagnostic des paramètres ;
- contrôle du fonctionnement.
Si quelque chose vous semble plus intéressant qu'autre chose, vous pouvez passer directement à ces sections.
Démarrage simple
Il est plus difficile de déboguer un réseau de neurones avec une architecture complexe, une régularisation et un planificateur de taux d'apprentissage que de déboguer un réseau classique. Nous agissons ici un peu de manière détournée, car ce point de débogage a une relation indirecte, mais c'est néanmoins une recommandation importante.
Le démarrage simple consiste à créer un modèle simplifié et à l'entraîner sur un ensemble (point) de données.
Tout d'abord, créons un modèle simplifié
Pour un démarrage rapide, créons un petit réseau avec une seule couche cachée et vérifions que tout fonctionne correctement. Ensuite, complexifions progressivement le modèle en vérifiant chaque nouvel aspect de sa structure (couche supplémentaire, paramètre, etc.) et avançons.
Entraînons le modèle sur un seul ensemble (point) de données
Comme validation rapide du bon fonctionnement de votre projet, vous pouvez utiliser un ou deux points de données pour vous assurer que le système fonctionne correctement. Le réseau de neurones doit afficher une précision de 100 % en formation et en validation. Si ce n'est pas le cas, soit le modèle est trop petit, soit il y a un bug.
Même si tout va bien, préparez le modèle à passer une ou plusieurs époques avant d'aller plus loin.
Évaluation des pertes
L'évaluation des pertes est le principal moyen d'affiner les performances du modèle. Vous devez vous assurer que la perte correspond à la tâche et que les fonctions de perte sont évaluées selon l'échelle correcte. Si vous utilisez plus d'un type de perte, assurez-vous qu'ils sont de même ordre et correctement mis à l'échelle.
Il est important de prêter attention aux pertes initiales. Vérifiez à quel point le résultat réel est proche de l'attendu, si le modèle a commencé avec une supposition aléatoire. Dans : «Assurez-vous que vous obtenez le résultat attendu lorsqu'on commence à travailler avec un nombre réduit de paramètres. Il est préférable de vérifier immédiatement la perte de données (en réglant le degré de régularisation à zéro). Par exemple, pour CIFAR-10 avec le classificateur Softmax, nous nous attendons à ce que les pertes initiales soient de 2,302, car la probabilité diffusée attendue est de 0,1 pour chaque classe (puisqu'il y a 10 classes), et la perte Softmax est le logarithme négatif de la probabilité de la classe correcte, soit –ln (0,1) = 2,302.»
Pour un exemple binaire, on effectue simplement un calcul similaire pour chacune des classes. Voici, par exemple, les données : 20 % de 0 et 80 % de 1. La perte initiale attendue sera jusqu'à –0,2ln (0,5) –0,8ln (0,5) = 0,693147. Si le résultat est supérieur à 1, cela peut indiquer que les poids du réseau de neurones ne sont pas correctement équilibrés ou que les données ne sont pas normalisées.
Vérifions les résultats intermédiaires et les connexions
Pour déboguer un réseau de neurones, il est nécessaire de comprendre la dynamique des processus à l'intérieur du réseau et le rôle des couches intermédiaires, car elles sont interconnectées. Voici des erreurs typiques auxquelles vous pourriez être confronté :
- expressions incorrectes pour les mises à jour de gradient ;
- les mises à jour de poids ne sont pas appliquées ;
- des gradients évanouissants ou explosifs (exploding gradients).
Si les valeurs du gradient sont nulles, cela signifie que le taux d'apprentissage de l'optimiseur est trop faible, ou que vous êtes confronté à une expression incorrecte pour la mise à jour du gradient.
De plus, il est nécessaire de surveiller les valeurs des fonctions d'activation, des poids et des mises à jour de chacune des couches. Par exemple, l’ampleur des mises à jour des paramètres (poids et biais) .
Il existe un phénomène connu sous le nom de “Dying ReLU” ou , où les neurones ReLU produiront zéro après avoir appris une grande valeur négative (biais) pour leurs poids. Ces neurones ne s'activeront plus jamais dans aucune des données.
Vous pouvez utiliser la vérification du gradient pour identifier ces erreurs en approximant le gradient à l'aide d'une approche numérique. S'il est proche des gradients calculés, cela signifie que la rétropropagation a été correctement mise en œuvre. Pour créer une vérification du gradient, consultez ces ressources remarquables de CS231. et , ainsi que d'Andrew Ng sur ce sujet.
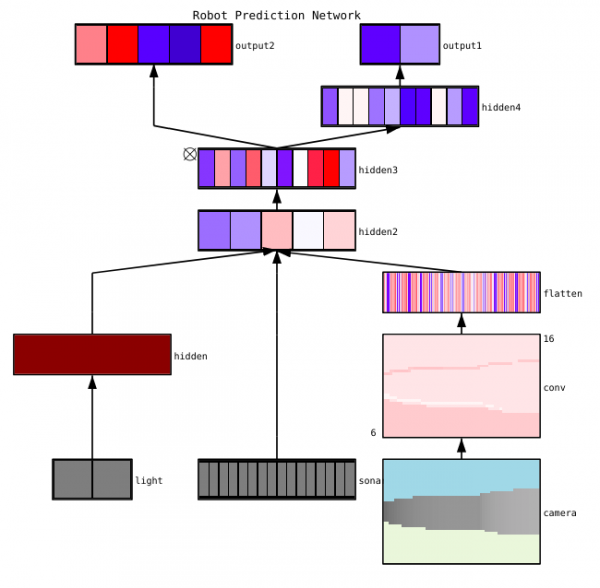
énonce trois méthodes principales pour visualiser les réseaux de neurones :
- Préliminaires — des méthodes simples qui nous montrent la structure générale du modèle entraîné. Elles incluent la sortie des formes ou des filtres des couches individuelles du réseau de neurones et des paramètres de chaque couche.
- Basées sur l'activation. Ici, nous déchiffrons les activations des neurones individuels ou des groupes de neurones pour comprendre leurs fonctions.
- Basées sur les gradients. Ces méthodes ont tendance à manipuler les gradients formés lors de la propagation avant et arrière lors de l'entraînement du modèle (y compris les cartes d'importance et les cartes d'activation de classe).
Il existe plusieurs outils utiles pour visualiser les activations et les connexions des couches individuelles, tels que et .
Diagnostic des paramètres
Les réseaux de neurones ont de nombreux paramètres qui interagissent entre eux, ce qui complique l'optimisation. En réalité, cette section fait l'objet de recherches actives de spécialistes, donc les suggestions ci-dessous doivent être considérées comme des conseils, des points de départ à partir desquels s'appuyer.
Taille du lot (batch size) — il est nécessaire que la taille du lot soit suffisamment grande pour obtenir des évaluations précises du gradient d'erreur, mais suffisamment petite pour que la descente de gradient stochastique (SGD) puisse ordonner votre réseau. De petites tailles de lots conduiront à une convergence rapide grâce au bruit dans le processus d'apprentissage, ce qui rendra l'optimisation difficile par la suite. Cela est décrit plus en détail .
Taux d'apprentissage — trop bas mènera à une convergence lente ou au risque de rester coincé dans des minima locaux. En même temps, un taux d'apprentissage élevé provoquera une divergence de l'optimisation car vous risquez de "sauter" à travers une partie profonde mais étroite de la fonction de perte. Essayez d'utiliser la planification du taux pour le diminuer lors de l'apprentissage du réseau de neurones. Dans le cours CS231n. .
Coupe de gradient— coupe des gradients des paramètres lors de la rétropropagation selon la valeur maximale ou la norme limite. Utile pour résoudre les problèmes d'explosions de gradients auxquels vous pourriez être confronté au troisième point.
Normalisation par lot — utilisée pour normaliser les données d'entrée de chaque couche, ce qui permet de résoudre le problème du décalage de covariation interne. Si vous utilisez Dropout et Batch Normalization ensemble, .
Descente de gradient stochastique (SGD) — il existe plusieurs variantes de SGD qui utilisent l'élan, des taux d'apprentissage adaptatifs et la méthode de Nesterov. Aucune d'entre elles n'a un avantage évident en termes d'efficacité d'apprentissage ou de généralisation ().
Régularisation — est cruciale pour construire un modèle généralisable, car elle ajoute une pénalité pour la complexité du modèle ou les valeurs extrêmes des paramètres. C'est un moyen de réduire la variance du modèle sans augmenter de manière significative son biais. Plus .
Pour évaluer cela par vous-même, vous devez désactiver la régularisation et vérifier le gradient de perte des données par vous-même.
Dropout — est une autre méthode pour régulariser votre réseau afin de prévenir le surapprentissage. Pendant l'apprentissage, le dropout consiste uniquement à maintenir l'activité d'un neurone avec une certaine probabilité p (hyperparamètre) ou à le mettre à zéro sinon. En conséquence, le réseau doit utiliser un autre sous-ensemble de paramètres pour chaque lot d'apprentissage, ce qui réduit les variations des paramètres spécifiques qui deviennent dominants.
Important : si vous utilisez à la fois le dropout et la normalisation par lot, faites attention à l'ordre de ces opérations ou même à leur utilisation ensemble. Tout cela est encore activement discuté et complété. Voici deux discussions importantes sur ce sujet et .
Contrôle du travail
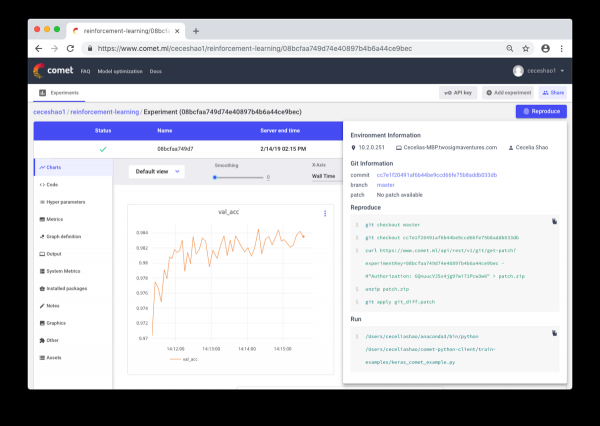
Il s'agit de documenter les workflows et les expériences. Si rien n'est documenté, il est possible d'oublier, par exemple, quelle vitesse d'apprentissage ou quel poids des classes est utilisé. Grâce au suivi, il est facile de consulter et de reproduire les expériences passées. Cela permet de réduire le nombre d'expériences redondantes.
Cependant, la documentation manuelle peut devenir une tâche difficile en cas de volume de travail important. C'est ici que des outils comme Comet.ml entrent en jeu, aidant à loguer automatiquement les ensembles de données, les modifications de code, l'historique des expériences et les modèles de production, y compris les informations clés sur votre modèle (hyperparamètres, mesures de performance du modèle et informations sur l'environnement).
Un réseau de neurones peut être très sensible à de petits changements, ce qui entraînera une baisse des performances du modèle. Le suivi et la documentation du travail sont la première étape à envisager pour standardiser l'environnement et le modélisation.
J'espère que ce post pourra servir de point de départ pour que vous commenciez à débugger votre réseau de neurones.
Skillbox recommande :
- Cours pratique de deux ans .
- Cours en ligne .
- Cours pratique d'un an .
Source : habr.com
