

Pour commencer, un peu de théorie. Qu'est-ce que ?
En termes simples, c'est un document destiné à simplifier le développement d'applications SaaS, en informant les développeurs et les ingénieurs DevOps des problèmes et pratiques que l'on retrouve le plus souvent dans le développement d'applications modernes.
Le document a été élaboré par les développeurs de la plateforme Heroku.
La méthodologie des douze facteurs (The Twelve-Factor App) peut être appliquée aux applications écrites dans n'importe quel langage de programmation et utilisant n'importe quelle combinaison de services tiers (backing services) (bases de données, files d'attente, cache, etc.).
Un bref aperçu des facteurs qui constituent cette méthodologie :
- Base de code – Une base de code unique, suivie dans un système de contrôle de version, – de nombreux déploiements
- Dépendances – Déclarez clairement et isolez les dépendances
- Configuration – Conservez la configuration dans l'environnement d'exécution
- Services externes (Backing Services) – Considérez les services externes (backing services) comme des ressources connectées
- Build, release, run – Séparez strictement les étapes de construction et d'exécution
- Processus – Exécutez l'application comme un ou plusieurs processus sans état (stateless)
- Liaison de ports (Port binding) – Exportez des services via la liaison de ports
- Parallélisme – Évoluez l'application à l'aide de processus
- Disposabilité (Disposability) – Maximisez la fiabilité grâce à un démarrage rapide et à une consommation correcte
- Parité entre le développement et l'exploitation de l'application – Maintenez les environnements de développement, de préproduction (staging) et de production aussi similaires que possible
- Journalisation (Logs) – Considérez le journal comme un flux d'événements
- Tâches d'administration – Exécutez les tâches d'administration/gestion à l'aide de processus ponctuels
Pour plus d'informations sur les 12 facteurs, vous pouvez consulter les ressources suivantes :
- — lecture incontournable
- — traduction officielle
- — un nouveau regard sur les 12 facteurs dans le but de les améliorer.
Qu'est-ce que le déploiement Blue-Green ?
Le déploiement Blue-Green est une méthode de livraison d'application production Ainsi, le client final ne voit aucun changement de son côté. En d'autres termes, le déploiement de l'application est sans temps d'arrêt.
Le schéma classique de BG Deploy ressemble à ce qui est indiqué dans l'image ci-dessous.

- Au départ, il y a 2 serveurs physiques avec exactement le même code, application, projet, et un routeur (équilibreur de charge).
- Le routeur dirige initialement toutes les requêtes vers l'un des serveurs (bleu).
- Au moment où il est nécessaire de relancer une version, l'ensemble du projet est mis à jour sur l'autre serveur (alpha), qui à ce moment-là ne traite aucune requête.
- Après que le code sur le serveur bleu soit complètement mis à jour, le routeur reçoit l'instruction de passer de vert sur alpha un serveur.
- Maintenant, tous les clients voient le résultat du code de bleu serveur.
- Pendant un certain temps, bleu le serveur sert de sauvegarde en cas de déploiement raté sur alpha le serveur et en cas d'échec et de bogues, le routeur redirige le flux d’utilisateurs vers bleu le serveur avec l'ancienne version stable, tandis que le nouveau code est envoyé pour révisions et tests.
- Et à la fin du processus, le bleu serveur est également mis à jour. Et après sa mise à jour, le routeur redirige de nouveau le flux de requêtes vers bleu un serveur.
Cela semble très bien et à première vue, il ne devrait y avoir aucun problème avec cela.
Mais comme nous vivons dans un monde moderne, l'option de basculement physique comme indiquée dans le schéma classique ne nous convient pas. Gardez cette information à l'esprit, nous y reviendrons plus tard.
Conseils bons et mauvais
Avertissement: Dans les exemples ci-dessous, des utilitaires / méthodologies que j'utilise sont mentionnés, vous pouvez utiliser absolument toutes les alternatives avec des fonctions similaires.
La plupart des exemples se croiseront d'une manière ou d'une autre avec le développement web (surprise !), avec PHP et Docker.
Les points suivants contiennent une description pratique simple de l'utilisation des facteurs dans des exemples spécifiques, si vous souhaitez obtenir plus de théories sur ce sujet, référez-vous aux liens ci-dessus vers la source d'origine.
1. Base de code
Utilisez FTP et FileZilla pour télécharger des fichiers sur les serveurs un à un, ne stockez le code nulle part sauf sur le serveur de production.
Le projet doit toujours avoir une base de code unique, c'est-à-dire que tout le code provient d'une seule source. Git d'un référentiel. Les serveurs (production, staging, test1, test2, etc.) utilisent le code des branches d'un référentiel commun. Ainsi, nous atteignons la cohérence du code.
2. Dépendances
Téléchargez toutes les bibliothèques dans des dossiers directement à la racine du projet. Mettez à jour simplement en transférant le nouveau code dans le dossier de la version actuelle de la bibliothèque. Installez tous les utilitaires directement sur le serveur hôte où fonctionnent déjà 20 services.
Le projet doit toujours avoir une liste de dépendances clairement définie (par dépendances, j'entends aussi l'environnement). Toutes les dépendances doivent être clairement définies et isolées.
À titre d'exemple, prenons Composer et Docker.
Composer — un gestionnaire de paquets qui permet d'installer des bibliothèques PHP. Composer permet de spécifier les versions de manière stricte ou non, et de les définir clairement. Sur le serveur, il peut y avoir 20 projets différents, chacun ayant sa propre liste de paquets et de bibliothèques, indépendante des autres.
Docker — un utilitaire qui permet de définir et d'isoler l'environnement dans lequel l'application va fonctionner. De même que pour Composer, mais de manière plus approfondie, nous pouvons définir ce avec quoi l'application travaille. Choisir une version spécifique de PHP, installer uniquement les paquets nécessaires au fonctionnement du projet, sans ajouter de composants superflus. Et surtout, ne pas entrer en conflit avec les paquets et l'environnement de la machine hôte et d'autres projets. Ainsi, tous les projets sur le serveur fonctionnant via Docker peuvent utiliser n'importe quel ensemble de paquets et un environnement totalement différent.
3. Configuration
Conservez les configurations sous forme de constantes directement dans le code. Des constantes distinctes pour le serveur de test, et d'autres pour la production. Liez le fonctionnement de l'application en fonction de l'environnement directement dans la logique métier du projet en utilisant des constructions if else.
Configurations — c'est la seule chose qui doit varier entre les déploiements du projet. Idéalement, les configurations devraient être transmises via des variables d'environnement (env vars).
Ainsi, même si vous conservez plusieurs fichiers de configuration .config.prod .config.local et que vous les renommez au moment du déploiement en .config (la configuration principale à partir de laquelle l'application lit les données), cela ne serait pas une approche correcte, car dans ce cas, les informations des configurations seraient accessibles à tous les développeurs de l'application et les données du serveur de production seraient compromises. Toutes les configurations doivent être stockées directement dans le système de déploiement (CI/CD) et générées pour différents environnements avec différentes valeurs nécessaires pour un environnement spécifique au moment du déploiement.
4. Services externes (Backing Services)
Soyez rigidement lié à l'environnement, utilisez différentes connexions pour les mêmes services dans des environnements spécifiques.
En réalité, ce point chevauche fortement celui concernant les configurations, car sans ce point, il est impossible de créer des données de configuration normales et la possibilité de configuration disparaîtra complètement.
Toutes les connexions aux services externes, tels que les serveurs de files d'attente, bases de données, services de mise en cache, doivent être uniformes pour l'environnement local ainsi que pour l'environnement externe / de production. En d'autres termes, je peux à tout moment changer une chaîne de connexion pour remplacer les appels à la base #1 par ceux à la base #2 sans modifier le code de l'application. Ou, en anticipant un exemple, lors de la mise à l'échelle du service, vous n'aurez pas besoin d'indiquer une connexion d'une manière particulière pour un serveur de cache supplémentaire.
5. Construction, version, exécution
Ayez uniquement la version finale du code sur le serveur, sans possibilité de revenir en arrière sur la version précédente. Ne gaspillez pas d'espace disque. Qui pense qu'il peut déployer du code en production avec une erreur est un mauvais programmeur !
Toutes les étapes de déploiement doivent être séparées les unes des autres.
Ayez la possibilité de revenir en arrière. Réalisez des versions en conservant d'anciennes copies de l'application (déjà compilées et prêtes pour le combat) en accès rapide, afin qu'en cas d'erreurs, vous puissiez restaurer l'ancienne version. Donc, il y a conditionnellement un dossier releases et un dossier courant, et après un déploiement et une compilation réussis, le dossier courant est lié par un lien symbolique à la nouvelle version qui se trouve à l'intérieur releases d'un nom conditionnel de numéro de version.
C'est ici que nous rappelons le déploiement Blue-Green, qui permet non seulement de basculer entre les versions de code, mais aussi de changer tous les ressources et environnements avec la capacité de revenir en arrière.
6. Processus
Conservez les données d'état de l'application directement dans l'application elle-même. Utilisez des sessions dans la mémoire vive de l'application. Utilisez autant que possible les éléments partagés entre les services tiers. Engagez-vous sur le fait que l'application ne peut avoir qu'un seul processus et n'autorisez pas la possibilité de mise à l'échelle.
Concernant les sessions, conservez les données uniquement dans le cache contrôlé par des services tiers (memcached, redis), de sorte que même si vous avez 20 processus de l'application en cours d'exécution, chacun d'eux peut accéder au cache et continuer à travailler avec le client dans le même état que l'utilisateur l'était en utilisant l'application dans un autre processus. Avec cette approche, peu importe combien de copies des services tiers vous utilisez, tout fonctionnera normalement sans problème d'accès aux données.
7. Liaison des ports (Port binding)
Seul le serveur web doit savoir comment travailler avec les services tiers. Il est même préférable de lancer les services tiers directement à l'intérieur du serveur web. Par exemple, comme un module PHP dans Apache.
Tous vos services doivent être accessibles les uns aux autres via une adresse et un port quelconque (localgost:5432, localhost:3000, nginx:80, php-fpm:9000), c'est-à-dire qu'à partir de nginx, je peux accéder à php-fpm, ainsi qu'à postgres, et à partir de php-fpm, accéder à postgres et nginx, et en fait, chaque service peut accéder à un autre service. De cette manière, la viabilité d'un service n'est pas liée à celle d'un autre service.
8. Parallélisme
Travaillez avec un seul processus, car plusieurs processus pourraient ne pas s'entendre !
Laissez la possibilité de mise à l'échelle. Docker Swarm est parfait pour cela.
Docker Swarm est un outil pour créer et gérer des clusters de conteneurs, tant entre différentes machines qu'un grand nombre de conteneurs sur une seule machine.
En utilisant swarm, je peux déterminer combien de ressources je vais allouer à chaque processus et combien de processus d'un même service je vais lancer, tandis que le répartiteur interne, en recevant des données sur le port désigné, va automatiquement les proxy vers les processus. Ainsi, en voyant que la charge sur le serveur a augmenté, je peux ajouter plus de processus, réduisant ainsi la charge sur certains processus.
9. Éliminabilité (Disposability)
N'utilisez pas de files d'attente pour travailler avec des processus et des données. Tuer un processus doit influencer le fonctionnement de l'ensemble de l'application. Si un service s'arrête, tout s'arrête.
Chaque processus et service peut être arrêté à tout moment et cela ne doit pas perturber les autres services (il ne s'agit pas que le service sera indisponible pour un autre service, mais que l'autre service ne s'arrêtera pas en raison de celui-ci). Tous les processus doivent se terminer en douceur, de manière à ce que, lors de leur arrêt, les données ne soient pas endommagées et que, lors de la prochaine activation, le système fonctionne correctement. Même en cas d'arrêt d'urgence, les données ne doivent pas être compromises (un mécanisme de transactions convient ici, les requêtes à la base de données fonctionnent uniquement par groupes, et si une seule requête du groupe échoue ou s'exécute avec une erreur, aucune autre requête du groupe n'est exécutée en réalité).
10. Parité entre le développement et le fonctionnement de l'application
La version de production, la version de staging et la version locale de l'application doivent être différentes. En production, nous avons le framework Yii Lite, tandis qu'en local nous avons Yii, pour que cela fonctionne plus rapidement en production !
En réalité, tous les déploiements et le travail avec le code doivent se faire dans des environnements presque identiques (il ne s'agit pas de matériel physique). De plus, n'importe quel membre de l'équipe de développement doit pouvoir déployer le code en production si nécessaire, et non pas uniquement une équipe de devops spécialement formée, qui peut mettre en production l'application grâce à une force particulière.
Docker nous aide également dans cette tâche. Si toutes les précédentes exigences sont respectées, l'utilisation de Docker rendra le processus de déploiement de l'environnement aussi bien en production que sur la machine locale aussi simple que de taper une ou deux commandes.
11. Journalisation (Logs)
Nous écrivons les journaux dans des fichiers et des bases de données ! Nous ne nettoyons pas les fichiers et les bases de données des journaux. Nous allons simplement acheter un disque dur de 9000 pétaoctets et c'est bon.
Tous les logs doivent être considérés comme un flux d'événements. L'application elle-même ne doit pas traiter les logs. Les logs doivent être émis soit en stdout, soit envoyés via un protocole tel que udp, afin que la gestion des logs par l'application ne pose aucun problème. Graylog convient bien à cela. Graylog, en recevant tous les logs via udp (car avec ce protocole, il n'est pas nécessaire d'attendre une confirmation de réception réussie du paquet), ne dérange l'application d'aucune manière et se charge uniquement de la structuration et du traitement des logs. La logique de l'application ne change pas pour travailler avec de telles approches.
12. Tâches d'administration
Pour mettre à jour les données, la base de données, etc., utilisez un endpoint créé séparément dans l'API ; l'exécution de celui-ci deux fois de suite peut entraîner un doublement de tout. Mais vous n'êtes pas idiots, vous ne cliquerez pas deux fois, et les migrations ne nous sont pas nécessaires.
Toutes les tâches d'administration doivent être exécutées dans le même environnement que tout le code, au niveau des versions. Donc, si nous devons modifier la structure de la base de données, nous ne ferons pas cela manuellement en changeant les noms des colonnes et en ajoutant de nouvelles via des outils de gestion de base de données visuels. Pour ces choses, nous créons des scripts séparés - des migrations, qui sont exécutées partout et dans tous les environnements avec un résultat commun et compréhensible. Pour toutes les autres tâches, comme le remplissage d'un projet avec des données, des méthodologies similaires doivent être appliquées.
Exemple d'implémentation en PHP, Laravel, Laradock, Docker-Compose
P.S. Tous les exemples ont été réalisés sur MacOS. La majeure partie convient aussi pour Linux. Les utilisateurs de Windows, désolé, mais je n'ai pas travaillé avec Windows depuis longtemps.
Imaginons une situation où aucune version de PHP n'est installée sur notre PC et où il n'y a rien du tout.
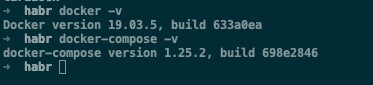
Nous installons les dernières versions de docker et docker-compose. (cela peut être trouvé sur Internet)
docker -v &&
docker-compose -v
1. Installons
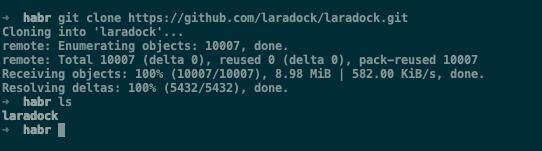
git clone https://github.com/Laradock/laradock.git &&
ls
À propos de Laradock, je dirais que c'est un outil fantastique, rassemblant de nombreux conteneurs et outils auxiliaires. Mais utiliser Laradock tel quel en production sans modifications - je ne le recommanderais pas en raison de son excès. Il vaut mieux créer ses propres conteneurs en se basant sur les exemples de Laradock, car cela permet d'optimiser, car personne n'a besoin de tout ce qui s'y trouve en même temps.
2. Configurons Laradock pour le fonctionnement de notre application.
cd laradock &&
cp env-example .env
2.1. Ouvrir le répertoire habr (dossier parent dans lequel laradock a été cloné) dans n'importe quel éditeur. (Dans mon cas, PHPStorm)
À ce stade, nous définissons uniquement le nom du projet.
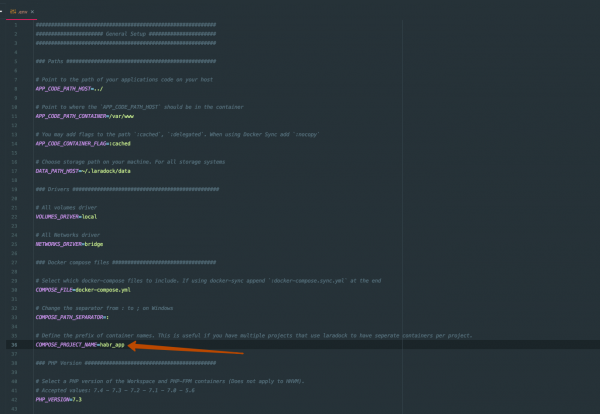
2.2. Démarrez l'image de workspace. (Dans votre cas, les images mettront un certain temps à se construire)
Workspace est une image spécialement préparée pour travailler avec le framework au nom du développeur.
Accédez au conteneur à l'aide de
docker-compose up -d workspace &&
docker-compose exec workspace bash
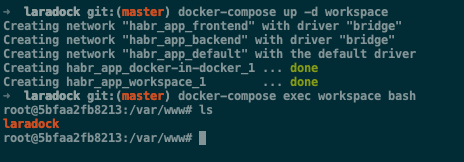
2.3. Installer Laravel
composer create-project --prefer-dist laravel/laravel application 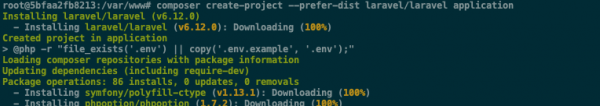
2.4. Après l'installation, vérifiez si le répertoire du projet a été créé, puis arrêtez compose.
ls
exit
docker-compose down
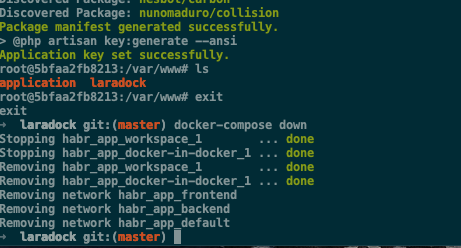
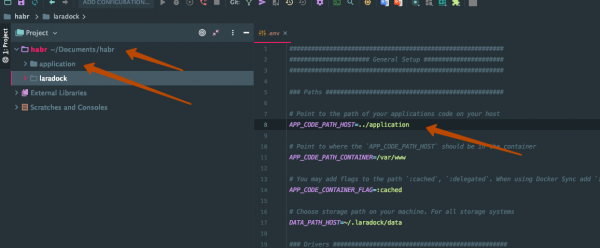
2.5. Retournez dans PHPStorm et mettez le chemin correct vers notre application Laravel dans le fichier .env.
3. Ajoutons tout le code dans Git.
Pour ce faire, créons un référentiel sur Github (ou ailleurs). Allons dans le terminal dans le répertoire habr et exécutons le code suivant.
echo "# habr-12factor" >> README.md
git init
git add README.md
git commit -m "premier commit"
git remote add origin git@github.com:nzulfigarov/habr-12factor.git # ici sera le lien vers votre repo
git push -u origin master
git status
Vérifions que tout va bien.
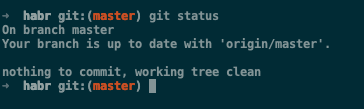
Pour plus de commodité, je recommande d'utiliser une interface graphique pour Git, dans mon cas c'est . (lien référentiel ici)
4. Démarrez !
Avant de démarrer, assurez-vous qu'il n'y a rien qui tourne sur les ports 80 et 443.
docker-compose up -d nginx php-fpm 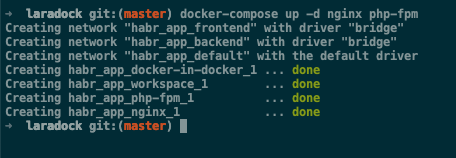
Ainsi, notre projet se compose de 3 services distincts :
- nginx — serveur web
- php-fpm — php pour recevoir des requêtes du serveur web
- workspace — php pour le développeur
Pour l'instant, nous sommes parvenus à créer une application conforme à 4 des 12 points, à savoir :
1. Base de code — tout le code est dans un seul référentiel (petite remarque : il peut être judicieux d'intégrer docker dans le projet Laravel, mais ce n'est pas fondamental).
2. Dépendances — Toutes nos dépendances sont clairement énoncées dans application/composer.json et dans chaque Dockerfile de chaque conteneur.
3. Services externes (Backing Services) — Chacune des services (php-fpm, nginx, workspace) vit sa propre vie et est connectée de l'extérieur, et en travaillant avec un service, les autres ne seront pas affectés.
4. Processus — chaque service est un processus unique. Chacune des services ne conserve pas d'état interne.
5. Liaison de ports (Port binding)
docker ps
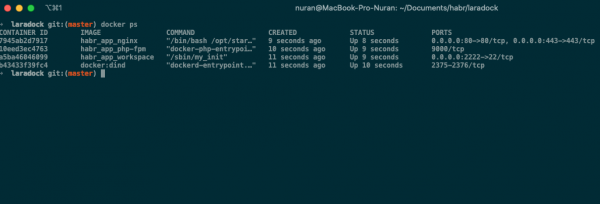
Comme nous le voyons, chaque service est lancé sur son propre port et est accessible à tous les autres services.
6. Parallélisme
Docker nous permet de lancer plusieurs processus des mêmes services avec un équilibrage de charge automatique entre eux.
Arrêtons les conteneurs et relançons-les avec le drapeau —scale
docker-compose down &&
docker-compose up -d --scale php-fpm=3 nginx php-fpm
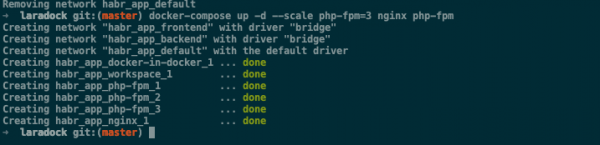
Comme nous le voyons, des copies du conteneur php-fpm ont été créées. Dans notre travail avec ce conteneur, nous n'avons rien à changer. Nous continuons également à y accéder via le port 9000, et Docker gère la charge entre les conteneurs pour nous.
7. Disposabilité (Disposability) — chaque conteneur peut être arrêté sans nuire aux autres. L'arrêt ou le redémarrage d'un conteneur n'affectera en rien le fonctionnement de l'application lors des lancements suivants. Chaque conteneur peut également être démarré à tout moment.
8. Parité entre le développement et l'exploitation de l'application — tous nos environnements sont identiques. En lançant le système sur un serveur en production, vous n'aurez rien à changer dans vos commandes. Tout sera exactement comme basé sur Docker.
9. Journalisation (Logs) — tous les logs de ces conteneurs sortent en flux et sont visibles dans la console Docker. (dans ce cas, en réalité, avec d'autres conteneurs faits maison, cela peut ne pas être le cas si vous ne vous en occupez pas)
docker-compose logs -f 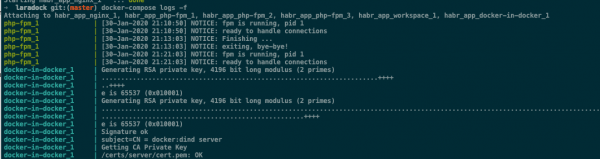
Mais il y a un hic, car les valeurs par défaut en PHP et Nginx enregistrent également les logs dans un fichier. Pour respecter les 12 facteurs, il est nécessaire de désactiver l'enregistrement des logs dans un fichier dans les configurations de chaque conteneur séparément.
Docker offre également la possibilité de diriger les logs non seulement vers stdout, mais aussi vers des outils comme graylog dont j'ai parlé ci-dessus. Et à l'intérieur de graylog, nous pouvons manipuler les logs comme nous le souhaitons, et notre application ne s'en apercevra en aucune manière.
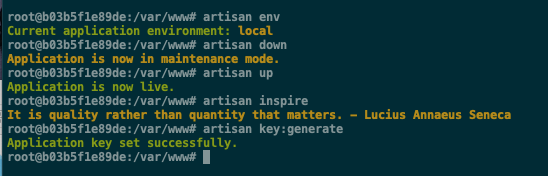
10. Tâches d'administration — toutes les tâches d'administration sont résolues par Laravel grâce à l'outil artisan exactement comme les créateurs de l'application à 12 facteurs l'auraient souhaité.
À titre d'exemple, je vais montrer comment certaines commandes sont exécutées.
Entrons dans le conteneur.
docker-compose exec workspace bash
php artisan list

Nous pouvons maintenant utiliser n'importe quelle commande. (notez que nous n'avons pas configuré la base de données et le cache, donc la moitié des commandes ne s'exécuteront pas correctement, car elles sont destinées à fonctionner avec le cache et la base de données).
11. Configurations et 12. Build, release, run
Je voulais consacrer cette partie au Blue-Green Deployment, mais cela s'est avéré trop développé pour cet article. J'écrirai un article séparé à ce sujet.
En deux mots, le concept repose sur des systèmes CI/CD comme Jenkins et Gitlab CI. Dans les deux cas, il est possible de définir des variables d'environnement liées à un environnement spécifique. Par conséquent, dans ce cas, le point concernant les configurations.
Et le point concernant Build, release, run est résolu par des fonctions intégrées dans les deux outils, appelées Pipeline.
Pipeline permet de diviser le processus de déploiement en plusieurs étapes, en mettant en avant les phases de construction, de mise en production et d'exécution. Dans le Pipeline, vous pourrez également créer des sauvegardes, et en fait, tout ce que vous voulez. Cet outil a un potentiel illimité.
Le code de l'application est sur .
N'oubliez pas d'initialiser le submodule lors du clonage de ce dépôt.
P.S. : Toutes ces approches peuvent être utilisées avec d'autres utilitaires et langages de programmation. L'essentiel est que le principe reste le même.
Source : habr.com
