

Razvijači OrioleDB analizirali su trenutno stanje niskonivojskog API-ja koji se koristi za pristup ekstenzijama tablicama i indeksima u PostgreSQL-u (Table/Index Access Method (AM) API) i predložili načine za njegovo poboljšanje. Od pojave ovog API-ja u PostgreSQL-u 12, programeri su dobili mogućnost stvaranja alternativnih mehanizama pohrane podataka. Međutim, unatoč postojanju ovog API-ja i poznatim ograničenjima ugrađenog mehanizma pohrane, još uvijek nisu razvijeni potpuno funkcionalni transakcijski mehanizmi pohrane implementirani isključivo kao ekstenzije.
Najtraženije funkcije za alternativne tablične motore PostgreSQL-a su:
- Alternativne implementacije MVCC, na primjer, pohrane temeljene na UNDO dnevniku.
- Indeksno-organizirane tablice, gdje indeks nije neobavezan dodatak tablici koji ubrzava upite, nego predstavlja glavnu strukturu podataka u kojoj su pohranjeni podaci tablice.
Promjene potrebne u API-ju Table/Index AM za podršku alternativnim implementacijama MVCC razmatraju se s obzirom na ekstenziju OrioleDB, razvijenu za rješavanje poznatih nedostataka ugrađenog mehanizma pohrane PostgreSQL-a. Problem je u tome što su za potpunu integraciju OrioleDB-a s PostgreSQL-om potrebne promjene u kodu PostgreSQL-a, što otežava integraciju projekta te naglašava potrebu za modernizacijom trenutnog API-ja Table AM.
API Table AM ne nameće izravno način implementacije MVCC-a. Međutim, API Table AM i API Index AM donose sljedeći pretpostavak: svaki TID (Tuple/row Identifier) ili je indeksiran svim indeksima ili uopće nije indeksiran. Čak i ako Index AM ima nekoliko referenci na jedan TID (na primjer, GIN), sve ove reference moraju odgovarati istom indeksiranom vrijednosti.
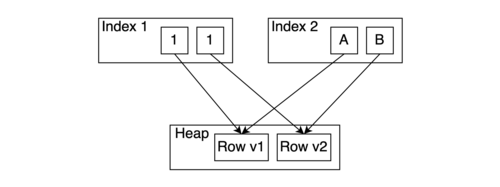
Ovaj princip je kritikovan zbog povećanja broja operacija pisanja („write amplification”) — ako se ažurira jedan indeksirani atribut, potrebno je ažurirati svaki indeks u tablici. Kada je potrebno u potpunosti iskoristiti prednosti UNDO dnevnika ili izgraditi drugi metod pohrane bez „jačanja pisanja” (na primjer, metod WARM), potrebno je prekršiti ovu pretpostavku.
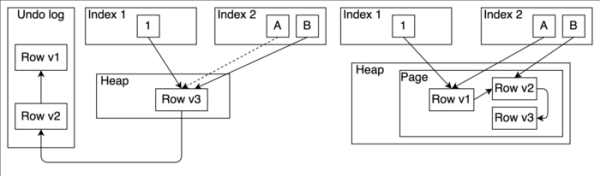
Tablica AM, temeljena na UNDO-u, koja neće prekršiti ovu pretpostavku, podsjeća na postojeću metodu HOT (Heap-Only Tuples), osim što se stare verzije redaka čuvaju u UNDO dnevniku i ne moraju stajati na istoj stranici. Međutim, prema autorima, ova prednost nije dovoljna da opravda postojanje odvojene Tablice AM.
Praktična ograničenja postojećeg API-ja:
- Tijekom ažuriranja reda tablice indeksi se ažuriraju po principu "sve ili ništa".
- Nedostatak API-ja Index AM za točno brisanje određenih tuplea. Trenutno, tuple se mogu masovno brisati iz indeksa putem metoda ambulkdelete i amvacuumcleanup. Pokušaj implementacije točnog brisanja putem ovog API-ja izazvao bi nisku učinkovitost, jer većina trenutnih implementacija mora skenirati cijeli indeks. Osim toga, API ne omogućuje navođenje koji od tuplea koji se odnose na isti TID treba izbrisati. Može izbrisati samo sve.
- Indeksi se trenutno odnose na retke tablice prema broju bloka (32 bita) i broju pomaka (16 bita). I samo 11 bita broja pomaka može se sigurno prenijeti iz TID-a tablice u sve metode pristupa indeksu. U tom smislu, alternativnim implementacijama MVCC može biti potrebno pohraniti dodatno korisno opterećenje (payload) zajedno s TID-om. Na primjer, u OrioleDB-u treba jedan ili više bitova za implementaciju indeksa "delete-marking" ili potpune informacija o vidljivosti.
Predložena su dva načina za prevladavanje ograničenja u praksi:
Pristup 1: API Index AM pruža mogućnosti za alternativnu implementaciju MVCC.
Dok Tablica AM i dalje odgovara za sve komponente MVCC-a, Index AM pruža potrebne mogućnosti za alternativnu implementaciju MVCC-a, naime: pohranu korisnog opterećenja (payload) zajedno s TID-om, metodu točnog brisanja i čak metodu točnog ažuriranja (ako se TID u indeksu ne može promijeniti, korisno opterećenje – može). Osim toga, budući da je potrebno omogućiti višestrukim tupleima indeksa da se odnose na isti TID, metode API-ja koje se koriste pri skeniranju indeksa također trebaju ažuriranje.
Pristup 2: Indeksi koji podržavaju MVCC.
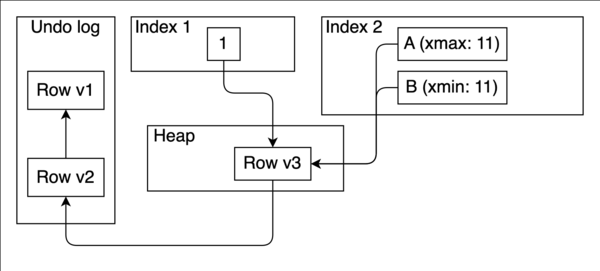
Alternativa bi bila omogućiti indekse koji podržavaju MVCC. To jest, „executor” (ili možda Table AM) jednostavno poziva metode insert() i delete() u Index AM-u, dok Index AM omogućuje skeniranje uzimajući u obzir MVCC. To bi značajno pojednostavilo skeniranje koristeći samo indekse (index-only). Čak bi cijeli Table AM u takvom slučaju mogao postati posrednički sloj koji pohranjuje podatke u indeksu.
Na dijagramu ispod prikazan je primjer. Vrijednost indeksa 2 ažurira transakcija 11 sa vrijednosti „A” na vrijednost „B”. Stoga je vrijednost „A” označena kao xmax == 11, a vrijednost „B” označena kao xmin == 11. Tako se može skenirati indeks 2 i dobiti samo vidljivi tuple prema MVCC bez provjera hrpe (heap). Prikupljanje smeća indeksa 2 također se može izvršiti bez korištenja hrpe.
Pri implementaciji svih navedenih noviteta u API indeksnih metoda pristupa, malo je vjerojatno da će se uspjeti istovremeno doraditi svi indeksi za podršku svim novim mogućnostima. Realističnije je omogućiti nekoliko implementacija za jednu indeksnu metodu pristupa. Na primjer, pored uobičajenog B-stabla, proširenje će moći implementirati alternativno B-stablo sa podrškom za MVCC unutar indeksa i podrškom za identifikatore zapisa proizvoljne duljine.
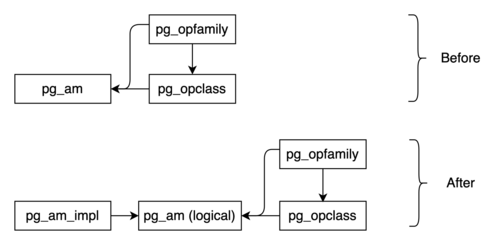
Tako se predlaže preispitivanje ne samo API Table AM, već i API Index AM, koji je sa uspjehom služio zajednici PostgreSQL dugi niz godina. Štoviše, predlaže se podjela Index AM-a na logički sloj i sloj implementacije. Ova preoblikovana arhitektura omogućit će PostgreSQL-u podršku za različite modele pohrane.
Izvor: opennet.ru
