

Nakon pet mjeseci razvoja objavljeno je izdanje projekta IncidentRelay 1.1, koji razvija otvoreni sustav za organizaciju dežurstava, usmjeravanje obavijesti i upravljanje incidentima, pokreće se na vlastitom poslužitelju (self-hosted). IncidentRelay 1.1 označen je kao prvo stabilno izdanje (grana 1.0 imala je status beta verzije). Projekt je usmjeren na SRE, DevOps i infrastrukturne timove kojima je potrebna lokalno instalirana alternativa SaaS uslugama za upravljanje dežurstvom (on-call management), primjenu politika eskalacije i reagiranje na incidente. Izvorni kod projekta napisan je na Python-u i licenciran je pod MIT licencom.
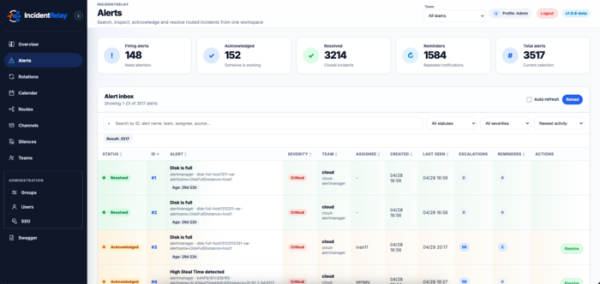
IncidentRelay prima događaje iz sustava za nadzor, usklađuje ih sa servisom, timom i rotacijom, nakon čega dostavlja obavijesti odgovornim dežurnim osobama ili timovima. U sustavu su implementirani rasporedi dežurstava, rotacije, preusmjeravanje smjena, potvrda prijema incidenta, stanja ACK/Resolve, podsjetnici, eskalacije, privremene zamjene dežurnih, određivanje vremena planiranih radova i suzbijanje glasnih alarma.
Glavna prednost projekta je potpuna kontrola nad infrastrukturom i logikom usmjeravanja. IncidentRelay se instalira u svom okruženju, radi sa svojom bazom podataka i omogućuje jasno razdvajanje dolaznih ruta, timova, rotacija i kanala isporuke. Dolazni tokeni pripadaju rutama, a ne kanalima, što olakšava razumijevanje koji vanjski izvor ima pravo slati događaje određenom timu.
U IncidentRelay podržava se prijem događaja iz Prometheus Alertmanager-a, Grafana Alertinga, Zabbixa, Sentry-a, LibreNMS-a, RMON-a, AWS SNS/CloudWatch i proizvoljnih webhook-ova. Za slanje obavijesti predviđeni su kanali Mattermost, Slack, Telegram, Discord, Microsoft Teams, email, webhook, browser/PWA push i davatelji glasovnih poziva. U Mattermost-u i Telegram-u obavijesti mogu sadržavati radnje za potvrdu i rješavanje problema, što omogućava obradu incidenta bez prelaska u poseban sučelje.
Projekt se može pokretati putem Docker Compose-a, RPM paketa za distribucije slične Red Hat-u, ručno preko systemd-a, kao i na Kubernetes-u pomoću Helm dijagrama. Za manje instalacije može se koristiti SQLite, dok se za radna okruženja i veću opterećenost preporučuje PostgreSQL.
U novoj verziji ponuđene su sljedeće izmjene:
- Dodane su višeslojne rotacije dežurstava s vremenskim ograničenjima, prioritetima slojeva i uzimanjem u obzir vremenskih zamjena;
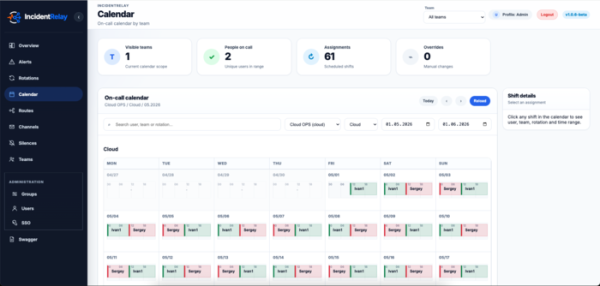
- Pojavilo se dežurstvo u kalendaru, CalDAV i ICS pretplate za vanjske kalendare;
- Provedene su politike eskalacije incidenata s višestepenim lancima podizanja razine;
- Dodane su grupe upozorenja, grupiranje događaja, odgođena obavještenja i ručno spajanje povezanih upozorenja;
- Pojavili su se prozori za izvođenje planiranih radova i 'tihi' upozorenja;
- Dodana je mogućnost dodavanja komentara upozorenjima;
- Dodani su prioriteti incidenata (P1-P5) i automatsko podizanje prioriteta prema razini važnosti;
- Provedeni su servisni katalog, zavisnosti servisa, SLI/SLO, povijest utjecaja na rad sustava (Service Impact History) i poslovne usluge (Business Services);
- Pojavio se Explain Trace za analizu usmjeravanja: zašto je upozorenje ušlo ili nije ušlo u tim, grupirano, potisnuto ili poslano u određeni kanal;
- Dodane su provjere (Heartbeats/dead-man-switch) za watchdog, backup, ETL i druge zadatke gdje je problem nedostatak očekivanog signala.
Izvor: opennet.ru
