

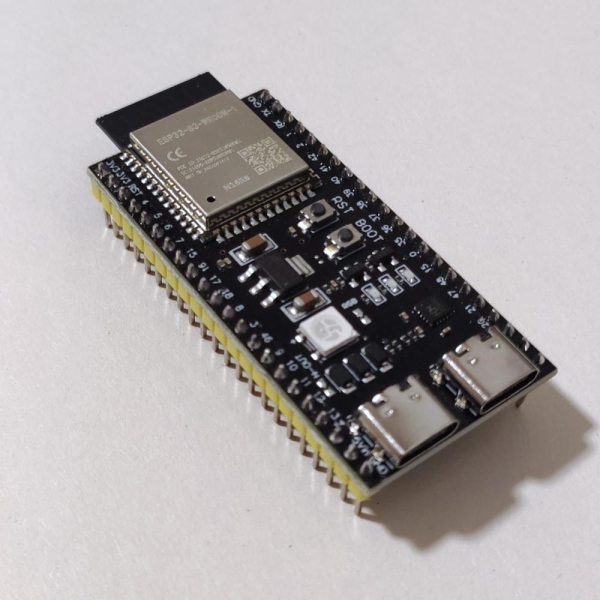
Razvijač Viačeslav Serbov, poznat pod pseudonimom slvDev, prikazao je potpuno lokalnu generaciju teksta na mikrocontrolleru ESP32-S3. Njegov je jezikovni model stvoren s 28,9 milijuna parametara i isporučuje oko 9,9 tokena u sekundi, bez pozivanja na poslužitelj ili druge vanjske računalne resurse. Generirane kratke priče prikazuju se na priključenom OLED zaslonu.
Projekt esp32-ai testiran je na modulu ESP32-S3 N16R8, koji ima 512 KB ugrađene SRAM, 8 MB PSRAM i 16 MB flash memorije. Kvantificirani model do četiri bita zauzima 14,9 MB. U repozitoriju su objavljeni izvorni kod izvršne okoline na C-u, sredstva za obuku i kvantizaciju modela, firmware, testovi i skripte za učitavanje na ploču.
Navedene 28,9 milijuna parametara ne treba izravno uspoređivati s brojem parametara običnih desktop LLM. Prema detaljnom izvještaju razvijača,model se sastoji od gusto procesorskog jezgra sa otprilike 559 tisuća parametara, izlaznog sloja sa 3,1 milijuna parametara i tablice složenih vektorskih prikaza od otprilike 25 milijuna parametara. Točno posljednje osigurava najveći dio formalne veličine modela, ali se ne obrađuje u cijelosti prilikom generacije svakog tokena.
Za smještaj modela koriste se tri razine memorije. Najčešće korišteni podaci nalaze se u unutarnjoj SRAM, izlazni sloj, KV-cache i privremeni baferi nalaze se u PSRAM-u, a tablica od 25 milijuna ostaje u flash memoriji i dostupna je putem mapiranja u adresnom prostoru. Za svaki token se čita samo oko šest redaka ukupne veličine otprilike 450 bajtova.
Ova naprava temelji se na tehnologiji Per-Layer Embeddings, koja je primijenjena od strane Googlea u Gemma 3n. Prema dokumentaciji Googlea,PLE-parametri se mogu pohraniti izvan radne memorije modela i dodati u proces izlaza dok se obrađuju pojedini slojevi. U esp32-ai ovaj pristup je prenesen na hijerarhiju memorije mikrocontrollera, gdje je brza SRAM posebno ograničena.
Prva ispravna verzija izvršnog okruženja napisanog u C-u isporučivala je samo 0,57 tokena u sekundi. Nakon premještanja izlaznog sloja u PSRAM, prelaska na osmobitne aktivacije, raspodjele izračuna između dva jezgre Xtensa LX7 i drugih optimizacija, kašnjenje je smanjeno na 94,9 ms po koraku modela. Mjerena brzina na kraju je dostigla 9,88 tokena u sekundi uzimajući u obzir cijeli proces generacije. Glavno ograničenje sada je propusnost PSRAM-a pri čitanju izlaznog sloja.
Model je treniran na sintetičkom skupu podataka TinyStories, koji se sastoji od jednostavnih engleskih priča s ograničenim rječnikom. Stoga može nastaviti fraze i skladati kratke koherentne priče, ali nije namijenjena za odgovaranje na pitanja, izvršavanje instrukcija, programiranje ili reprodukciju stvarnog znanja. Razvijač ovaj rad prvenstveno smatra demonstracijom učinkovite implementacije modela u memoriji mikrokontrolera, a ne kao spremnog autonomnog chat-bota.
U ažuriranoj dokumentaciji autor posebno naglašava da je esp32-ai samostalni razvoj. Projekti llama2.c Andreyja Karpatija i ranija verzija 260.000 modela na ESP32-S3 navedeni su samo kao smjernice i primjeri prethodnih radova: kod, kontrolne točke i metodologija nisu preuzeti iz njih. Izvorni kod esp32-ai distribuira se pod MIT licencom.
Izvor: linux.org.ru
