

Svaka operacija s velikim podacima zahtijeva velike računalne resurse. Uobičajeno premještanje podataka iz baze na Hadoop može trajati tjednima ili koštati koliko i krilo aviona. Ne želite čekati i trošiti? Uravnotežite opterećenje na različitim platformama. Jedan od načina je pushdown-optimizacija.
Zamolio sam vodećeg trenera u Rusiji za razvoj i administraciju proizvoda Informatica, Alekseja Ananjeva, da nam objasni funkciju pushdown-optimizacije u Informatica Big Data Management (BDM). Jeste li ikada učili raditi s proizvodima Informatica? Vjerojatno vam je baš Aleksej govorio osnove PowerCentra i objašnjavao kako graditi mape.
Aleksej Ananjev, vođa sektora za obuku u DIS Grupi
Što je pushdown?
Mnogi od vas su već upoznati s Informatica Big Data Management (BDM). Proizvod može integrirati velike podatke iz različitih izvora, premještati ih između različitih sustava, omogućuje lagan pristup, profilira ih i još mnogo toga.
U spretnim rukama BDM može činiti čuda: zadaci će se izvoditi brzo i s minimalnim računalnim resursima.
Želite li i vi to? Naučite koristiti funkciju pushdown u BDM za raspodjelu računalnog opterećenja između različitih platformi. Tehnologija pushdown omogućuje pretvaranje mape u skriptu i odabir okruženja u kojem će ta skripta biti pokrenuta. Mogućnost odabira omogućuje kombiniranje prednosti različitih platformi i postizanje njihove maksimalne učinkovitosti.
Za postavljanje okruženja za izvođenje skripte potrebno je odabrati tip pushdown. Skripta se može potpuno izvršiti na Hadoopu ili djelomično rasporediti između izvora i odredišta. Postoje 4 moguća tipa pushdown. Mapu se ne mora pretvarati u skriptu (native). Mapu se može izvršiti maksimalno na izvoru (source) ili potpuno na izvoru (full). Također, mapu se može pretvoriti u Hadoop skriptu (none).
Pushdown-optimizacija
Navedenih 4 tipa može se različito kombinirati – optimizirati pushdown prema konkretnim potrebama sustava. Na primjer, često je korisnije izvući podatke iz baze podataka, koristeći njezine vlastite mogućnosti. A obraditi podatke – snagom Hadoopa, kako ne bi opterećivali samu bazu.
Razmotrimo slučaj kada su i izvor i prijemnik u bazi podataka, a platformu za izvršavanje transformacija možemo odabrati: ovisno o postavkama to će biti Informatica, server baze podataka ili Hadoop. Ovaj primjer će omogućiti najpreciznije razumijevanje tehničke strane rada ovog mehanizma. Naravno, u stvarnom životu ovakva situacija se ne javlja, ali za demonstraciju funkcionalnosti ona je najprikladnija.
Uzmimo mapiranje za čitanje dviju tablica u jedinstvenoj bazi podataka Oracle. A rezultati čitanja neka se zapisuju u tablicu u istoj bazi. Shema mapiranja će biti sljedeća:
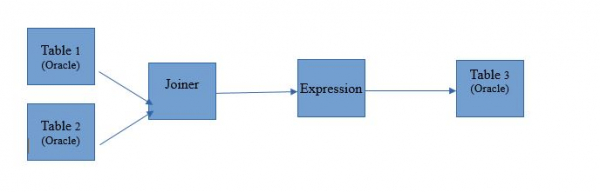
U obliku mapiranja na Informatica BDM 10.2.1 to izgleda ovako:
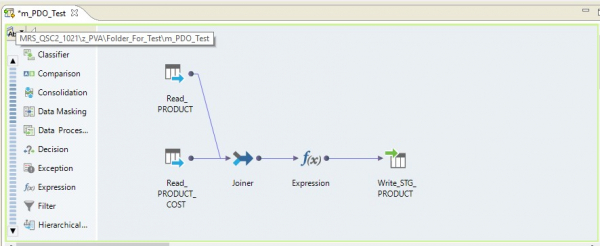
Tip pushdown – native
Ako odaberemo tip pushdown native, mapiranje će se izvesti na serveru Informatica. Podaci će biti pročitani sa servera Oracle, prebačeni na server Informatica, transformirani tamo i poslani u Hadoop. Drugim riječima, dobit ćemo uobičajeni ETL proces.
Tip pushdown – source
Pri odabiru tipa source dobivamo mogućnost raspodjele našeg procesa između serverom baza podataka (BDB) i Hadoop. Pri izvršavanju procesa s ovom postavkom, u bazu će stizati upiti za dohvat podataka iz tablica. A ostatak će se izvršavati u obliku koraka na Hadoop.
Shema izvršenja će izgledati ovako:
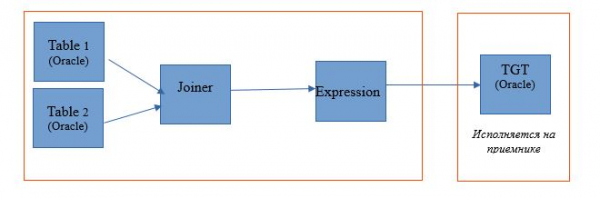
Ispod je primjer postavki okruženja za izvršavanje.
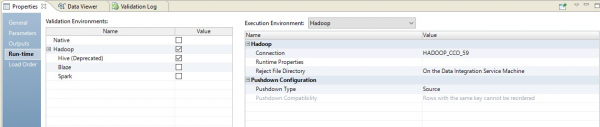
U ovom slučaju, mapiranje će se izvršavati u dva koraka. U njegovim postavkama ćemo vidjeti da se pretvorio u skriptu koja će biti poslana na izvor. Pri tome će se spajanje tablica i transformacija podataka izvršiti u obliku redefiniranog upita na izvoru.
Na slici ispod vidimo optimizirano mapiranje na BDM, a na izvoru redefinirani upit.
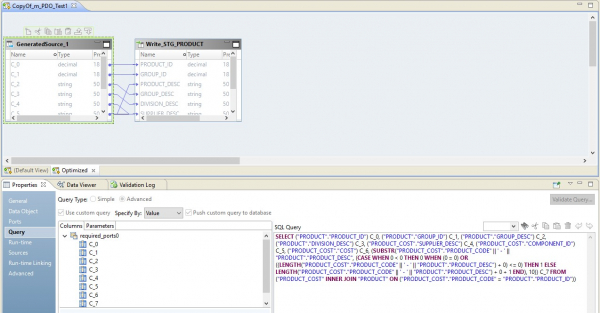
Uloga Hadoop-a u ovoj konfiguraciji svodi se na upravljanje protokom podataka – dirigovanje njima. Rezultat upita će biti poslan u Hadoop. Nakon završetka čitanja, datoteka iz Hadoop-a bit će zapisana u prijemnik.
Tip pushdown – full
Pri odabiru tipa full, mapiranje se potpuno pretvara u upit na BDB. A rezultat upita bit će poslan na Hadoop. Shema takvog procesa prikazana je ispod.
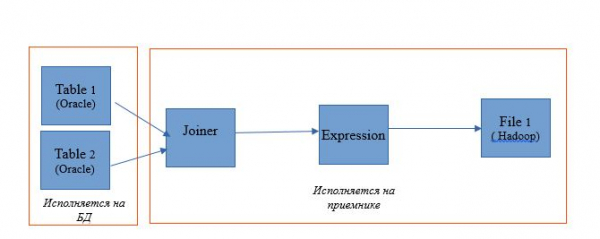
Primjer postavke prikazan je ispod.
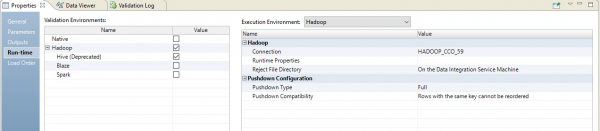
Kao rezultat dobit ćemo optimizirano mapiranje slično prethodnom. Razlika je samo u tome što će se cijela logika premjestiti na prijemnik u obliku redefiniranja njegove umetanja. Primjer optimiziranog mapiranja prikazan je ispod.
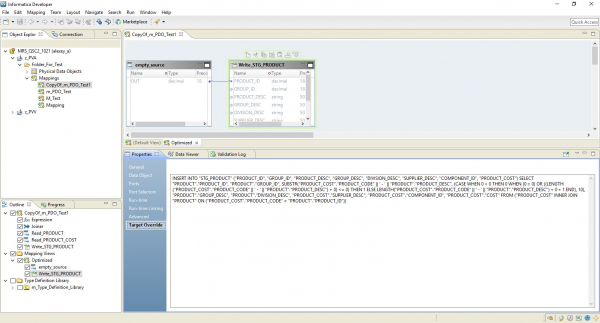
Ovdje, kao i u prethodnom slučaju, Hadoop igra ulogu dirigenta. Međutim, ovdje se cijeli izvor čita, a zatim se na razini prijemnika izvršava logika obrade podataka.
Tip pushdown – null
I posljednja opcija – tip pushdown, u okviru kojeg će se naše mapiranje pretvoriti u skriptu na Hadoopu.
Optimizirano mapiranje sada će izgledati ovako:
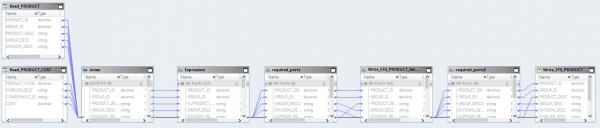
Ovdje će se podaci iz izvornih datoteka najprije pročitati na Hadoopu. Zatim će se tim istim sredstvima ta dva fajla spojiti. Nakon toga, podaci će se transformirati i učitati u bazu podataka.
Razumijevanjem principa optimizacije pushdown, mnoge procese rada s velikim podacima moguće je vrlo efikasno organizirati. Tako je nedavno jedna velika kompanija u samo nekoliko tjedana iz Hadoop skladišta iznijela velike podatke koje je prethodno prikupljala nekoliko godina.
Izvor: habr.com
