

KDB+, proizvod tvrtke — je široko poznata u nekim krugovima, izuzetno brza, kolona podataka namijenjena za pohranu vremenskih serija i analitičkih proračuna na njihovoj osnovi. Prvotno je bila (i još uvijek je) vrlo popularna u financijskoj industriji — koristi je svih top 10 investicijskih banaka, kao i mnoge poznate hedge fondove, burze i druge organizacije. U posljednje vrijeme, KX je odlučila proširiti svoju korisničku bazu i sada nudi rješenja i u drugim područjima gdje postoje velike količine podataka, organiziranih po vremenu ili na neki drugi način — telekomunikacije, bioinformatika, proizvodnja itd. Također su postali partner tima Aston Martin Red Bull Racing u „Formuli 1“, gdje pomažu u prikupljanju i obradi podataka sa senzora automobila i analizi testova u aerodinamičkom tunelu. U ovom članku želim objasniti koje karakteristike KDB+ čine je ultraefikasnom, zašto su tvrtke spremne trošiti velike iznose na nju i konačno, zašto ovo zapravo nije samo baza podataka.
U ovom članku ću nastojati objasniti u cjelini što predstavlja KDB+, koje mogućnosti i ograničenja ima, te koja je njena korisnost za tvrtke koje žele obraditi velike količine podataka. Neću se upuštati u detalje implementacije KDB+ i u detalje njenog programskog jezika Q. Ove teme su vrlo opsežne i zaslužuju odvojene članke. Mnogo informacija na te teme može se pronaći na web stranici code.kx.com, uključujući knjigu o Q — Q For Mortals (vidi vezu u nastavku).
Neki pojmovi
- In-memory baza podataka. Baza podataka koja pohranjuje podatke u radnoj memoriji radi bržeg pristupa. Prednosti takve baze su jasne, dok su nedostaci mogućnost gubitka podataka, te potreba za velikom količinom memorije na serveru.
- Kolona baz podataka. Baza podataka gdje su podaci pohranjeni po kolonama, a ne zapis za zapisom. Glavna prednost ove baze je da su podaci iz jedne kolone pohranjeni zajedno na disku i u memoriji, što znatno ubrzava pristup tim podacima. Nema potrebe učitavati kolone koje se ne koriste u upitu. Glavni nedostatak — teško je modificirati i brisati zapise.
- Vremenska serija. Podaci s kolonom tipa datum ili vrijeme. Obično je za takve podatke važna vremenska raspodjela, kako bi se lako utvrdilo koja stavka prethodi ili slijedi trenutnoj, ili kako bi se primijenile funkcije čiji rezultati ovise o redoslijedu zapisa. Klasične baze podataka izgrađene su na posve drugom principu — predstavljanje skupa zapisa kao mnoštva, gdje redoslijed zapisa uopće nije definiran.
- Vektor. U kontekstu KDB+ — to je lista elemenata istog atomskog tipa, na primjer, brojeva. Drugim riječima, niz elemenata. Nizovi, za razliku od lista, mogu se pohraniti kompaktno i obraditi koristeći vektorske instrukcije procesora.
Povijesne informacije
Tvrtka KX osnovana je 1993. godine od strane Arthura Whitneyja, koji je prije toga radio u banci Morgan Stanley na jeziku A+, nasljedniku APL — izuzetno originalnom i u svoje vrijeme popularnom jeziku u financijskom svijetu. Naravno, u KX Arthur je nastavio u istom duhu i stvorio vektorsko-funkcionalni jezik K, slijedeći ideje radikalnog minimalizma. Programi napisani u K izgledaju kao kaotičan skup interpunkcijskih znakova i posebnih simbola, značenje znakova i funkcija ovisi o kontekstu, a svaka operacija nosi znatno više značenja nego što je to slučaj u konvencionalnim programskim jezicima. Zbog toga program u K zauzima minimalan prostor — nekoliko redaka može zamijeniti stranice teksta verbose jezika poput Jave — i predstavlja izuzetno sažetu realizaciju algoritma.
Funkcija na K koja implementira većinu LL1 parser generatora prema zadanoj gramatici:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/1_r),"]";""]]}
Ovu filozofiju ekstremne učinkovitosti s minimalnim pokretima, Arthur je ostvario i u KDB+, koji je uveden 2003. godine (mislim da je sada jasno odakle dolazi slovo K u nazivu) i nije ništa drugo do interpreter četvrte verzije jezika K. Na K je dodana korisniku prijatnija verzija K pod nazivom Q. U Q je također dodana podrška za specifični dijalekat SQL — QSQL, a u interpreter — podrška za tablice kao sistemski tip podataka, sredstva za rad s tablicama u memoriji i na disku itd.
Dakle, s gledišta korisnika, KDB+ je jednostavno interpreter jezika Q s podrškom za tablice i izraze sličnim SQL-u u stilu LINQ iz C#. Ovo je ključna razlika KDB+ od drugih baza podataka i njena glavna konkurentska prednost koja se često previdi. Ovo nije baza podataka + pomoćni invalidski jezik, već potpuno moćan programski jezik + ugrađena podrška za funkcije baze podataka. Ova razlika će igrati odlučujuću ulogu prilikom nabrajanja svih prednosti KDB+. Na primjer...
Veličina
Prema modernim merilima, KDB+ ima jednostavno mikroskopske dimenzije. To je u doslovnom smislu jedna izvršna datoteka veličine manjoj od jednog megabajta i jedna mala tekstualna datoteka s nekim sistemskim funkcijama. U stvarnosti — manje od jednog megabajta, a za ovaj program kompanije plaćaju desetine hiljada dolara godišnje za jedan procesor na serveru.
- Takva veličina omogućava KDB+ da se odlično snalazi na bilo kojoj opremi — od mikro računala Pi do servera s terabajtima memorije. Na funkcionalnost to nikako ne utiče, naprotiv, Q se pokreće trenutno, što omogućava njegovo korišćenje i kao skriptni jezik.
- S takvom veličinom, interpreter Q potpuno staje u keš procesora, što ubrzava izvršavanje programa.
- S takvom veličinom izvršne datoteke, proces Q zauzima neznatno malo prostora u memoriji, može se pokretati u stotinama. Pri tome, po potrebi, Q može upravljati i desetinama-stotinama gigabajta memorije unutar jednog procesa.
Svestranost
Q je savršeno prikladan za širok spektar zadataka. Proces Q može funkcionirati kao povijesna baza podataka i omogućiti brzi pristup terabajtima informacija. Na primjer, imamo desetine povijesnih baza, od kojih neki dani podataka, nerazvijeni, zauzimaju više od 100 gigabajta. Ipak, uz razumne limite, upit prema bazi će se izvršiti u desetak do stotina milisekundi. U cjelini, za korisničke upite imamo univerzalni vremenski limit - 30 sekundi - koji se vrlo rijetko aktivira.
S istom lakoćom Q može biti i in-memory baza podataka. Dodavanje novih podataka u tablice u memoriji događa se tako brzo da su korisnički upiti ograničavajući faktor. Podaci u tablicama se pohranjuju po kolonama, što znači da svaka operacija na koloni koristi procesorski cache do maksimuma. Uz to, u KX-u su se potrudili implementirati sve osnovne operacije poput aritmetičkih putem vektorskih instrukcija procesora, maksimizirajući njihovu brzinu. Q također može izvršavati zadatke koji nisu svojstveni bazama podataka - na primjer, obrađivati stream podatke i izračunavati u 'stvarnom vremenu' (s kašnjenjem od nekoliko desetaka milisekundi do nekoliko sekundi, ovisno o zadatku) razne agregatne funkcije za financijske instrumente za različite vremenske intervale ili modelirati utjecaj izvršene transakcije na tržište i vršiti njeno profiliranje praktički odmah nakon njezina izvršenja. U takvim zadacima, najčešće, glavnu vremensku latenciju ne donosi Q, već potreba za usklađivanjem podataka iz različitih izvora. Visoka brzina se postiže zato što su podaci i funkcije koje ih obrađuju u jednom procesu, a obrada se svodi na izvršavanje nekoliko QSQL izraza i joinova, koji se ne interpretiraju, već izvršavaju binarnim kodom.
Na kraju, na Q-u se mogu pisati i svi servisi. Na primjer, Gateway procesi, koji automatski raspoređuju korisničke upite prema odgovarajućim bazama i serverima. Programer ima potpunu slobodu implementirati bilo koji algoritam za balansiranje, prioritetizaciju, otpornost na greške, pristupne privilegije, kvote i zapravo sve što želi. Glavni problem ovdje je što će to sve morati sami implementirati.
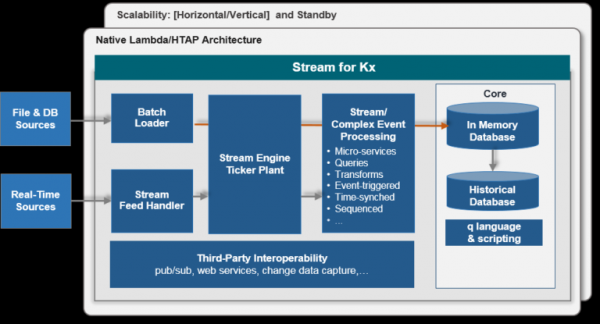
Primjerice, navest ću koji tipovi procesa postoje kod nas. Svi su aktivno korišteni i rade zajedno, spajajući u jednu cjelinu desetke različitih baza, obrađujući podatke iz mnoštva izvora i opslužujući stotine korisnika i aplikacija.
- Konektori (feedhandler) za data izvore. Ovi procesi obično koriste vanjske biblioteke koje se učitavaju u Q. C sučelje u Q je izuzetno jednostavno i omogućuje lako kreiranje proxy funkcija za bilo koju C/C++ biblioteku. Q je dovoljno brz da se nosi, na primjer, s obradom toka FIX poruka sa svih europskih burzi u isto vrijeme.
- Distribucijski podaci (tickerplant), koji služe kao posrednički link između konektora i potrošača. U isto vrijeme, bilježe dolazne podatke u poseban binarni log, osiguravajući otpornost za potrošače na gubitke veze ili ponovna pokretanja.
- In-memory baze podataka (rdb). Ove baze omogućuju maksimalno brzi pristup sirovim svježim podacima, pohranjujući ih u memoriji. Obično, akumuliraju podatke u tablicama tijekom dana i poništavaju ih noću.
- Persist baze podataka (pdb). Ove baze osiguravaju pohranu podataka za današnji dan u povijesnu bazu. Obično, za razliku od rdb, ne pohranjuju podatke u memoriji, već koriste poseban cache na disku tijekom dana i kopiraju podatke u ponoć u povijesnu bazu.
- Povijesne baze (hdb). Ove baze osiguravaju pristup podacima za prethodne dane, mjesece i godine. Njihova veličina (u danima) ograničena je samo veličinom tvrdih diskova. Podaci mogu biti pohranjeni bilo gdje, uključujući na različitim diskovima radi bržeg pristupa. Postoji mogućnost kompresije podataka korištenjem nekoliko odabranih algoritama. Struktura baze je dobro dokumentirana i jednostavna, podaci se pohranjuju kronološki u običnim datotekama, tako da ih se može obrađivati i pomoću alata operativnog sustava.
- Baze s agregiranim informacijama. Pohranjuju različite aggrege, obično grupirane po nazivu instrumenta i vremenskom intervalu. In-memory baze ažuriraju svoje stanje pri svakoj dolaznoj poruci, dok povijesne pohranjuju prethodno izračunate podatke za brži pristup povijesnim podacima.
- Na kraju, gateway procesi, koji podržavaju aplikacije i korisnike. Q omogućuje potpuno asinkrono procesiranje dolaznih poruka, njihovo raspoređivanje po bazama, provjeru prava pristupa itd. Napominjem, poruke nisu ograničene i najčešće nisu SQL izrazi, kao što to biva u drugim bazama podataka. Najčešće je SQL izraz skriven u posebnoj funkciji i konstruira se na temelju parametara koje korisnik zahtijeva — provodi se konverzija vremena, filtracija, podaci se normaliziraju (na primjer, cijena dionica se prilagođava ako je bilo isplata dividendi) itd.
Tipična arhitektura za jedan tip podataka:
Brzina
Iako je Q interpretirani jezik, to je ujedno i vektorski jezik. To znači da mnoge ugrađene funkcije, posebno aritmetičke, prihvaćaju argumente bilo kojeg oblika — brojevi, vektori, matrice, liste, a od programera se očekuje da program implementira kao operacije nad nizovima. U takvom jeziku, ako zbrajate dva vektora od milijun elemenata, više nije važno što je jezik interpretiran, zbrajanje će se obavljati superoptimiziranom binarnom funkcijom. Budući da većina vremena u Q programima odlazi na operacije s tablicama koje koriste ove osnovne vektorizirane funkcije, na izlazu imamo prilično dobru brzinu rada, koja omogućava obradu ogromnog volumena podataka čak i u jednom procesu. To je slično matematičkim bibliotekama u Pythonu — iako je sam Python prilično spor jezik, ima mnogo prekrasnih biblioteka poput numpy, koje omogućuju obradu numeričkih podataka brzinom kompiliranog jezika (usput, numpy je ideološki blizak Q-u).
Osim toga, KX je vrlo pažljivo pristupio dizajnu tablica i optimizaciji rada s njima. Prvo, podržava se nekoliko vrsta indeksa koji su podržani ugrađenim funkcijama i mogu se primijeniti ne samo na stupce tablica, već i na bilo koje vektore — grupiranje, sortiranje, atribut jedinstvenosti i posebna grupacija za povijesne baze. Indeks se postavlja elementarno i automatski se ispravlja prilikom dodavanja elemenata u stupac/vektor. Indeksi se jednako uspješno mogu primjenjivati na stupce tablica i u memoriji i na disku. Prilikom izvođenja QSQL upita, indeksi se automatski koriste kad god je to moguće. Drugo, rad s povijesnim podacima odrađuje se putem mehanizma prikaza datoteka OS-a (memory map). Velike tablice nikada se ne učitavaju u memoriju, umjesto toga potrebni stupci prikazuju se izravno u memoriji i stvarno se učitava samo ona njihova djela (tu pomažu i indeksi) koja su potrebna. Za programera nema razlike nalaze li se podaci u memoriji ili ne, mehanizam rada s mmap potpuno je skriven u dubinama Q.
KDB+ je nerelacijska baza podataka, tablice mogu sadržavati proizvoljne podatke, pri čemu redoslijed redaka u tablici ostaje nepromijenjen prilikom dodavanja novih elemenata i može se i treba koristiti pri pisanju upita. Ova značajka je posebno potrebna za rad s vremenskim serijama (podatci s burze, telemetrija, logovi događaja), jer ako su podaci sortirani prema vremenu, korisniku nije potrebno primjenjivati nikakve SQL trikove kako bi pronašao prvi ili posljednji redak u vremenskom smislu ili N redaka, odredio koji redak slijedi nakon N-tog retka itd. Još više se pojednostavljuju spojevi tablica, na primjer, pronalaženje posljednje kotacije za 16000 transakcija VOD.L (Vodafone) u tablici od 500 milijuna elemenata traje otprilike sekundu na disku i nekoliko milisekundi u memoriji.
Primjer spoja prema vremenu — quote tablica prikazuje se u memoriji, stoga nije potrebno navesti VOD.L u where, neizravno se koriste indeks na sym stupcu i ta činjenica da su podaci sortirani prema vremenu. Gotovo svi spojevi u Q su obične funkcije, a ne dio select izraza:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Na kraju, vrijedi napomenuti da su inženjeri u KX, počevši od samog Arthura Whitneyja, stvarno opsjednuti efikasnošću i ulažu sve napore kako bi izvukli maksimum iz standardnih funkcija Q i optimizirali najčešće obrasce korištenja.
Zaključak
KDB+ je popularna među poslovanjem prvenstveno zahvaljujući svojoj izvanrednoj svestranosti — jednako dobro služi kao in-memory baza, kao baza za pohranu terabajta povijesnih podataka, i kao platforma za analizu podataka. Zbog toga što se obrada podataka odvija izravno unutar baze, postiže se velika brzina rada i ušteda resursa. Potpuni programski jezik integriran s funkcijama baze podataka omogućuje realizaciju cijelog potrebnog sklopa procesa na jednoj platformi — od prikupljanja podataka do obrade korisničkih upita.
Dodatne informacije
Nedostaci
Značajan nedostatak KDB+/Q je visok prag ulaska. Jezik ima neobičnu sintaksu, neke funkcije su jako preopterećene (value, na primjer, ima oko 11 varijanti korištenja). Najvažnije je da zahtijeva radikalno drugačiji pristup pisanju programa. U vektorskom jeziku potrebno je stalno razmišljati u terminima transformacija nizova, sve petlje implementirati kroz nekoliko varijanti funkcija map/reduce (koje se nazivaju adverbs u Q), nikada ne pokušavati uštedjeti zamjenom vektorskih operacija atomarnim. Na primjer, za pronalaženje indeksa N-tog pojavljivanja elementa u nizu bi trebalo pisati:
1. (where element=vector)[N]
iako to izgleda izuzetno neučinkovito s obzirom na C/Java (= stvara boolovski vektor, where vraća indekse true elemenata u njemu). No, takav zapis čini smisao izraza jasnijim i koristite brze vektorske operacije umjesto sporih atomarnih. Konceptualna razlika između vektorskog jezika i ostalih usporediva je s razlikom između imperativnog i funkcionalnog pristupa programiranju, i na to treba biti spreman.
Neki korisnici su također nezadovoljni QSQL-om. Naime, on samo izgleda kao pravi SQL. U stvarnosti, to je samo interpreter SQL-sličnih izraza koji ne podržava optimizaciju upita. Korisnik mora sam napisati optimalne upite, i to na Q, što mnogi nisu spremni učiniti. S druge strane, naravno, uvijek se može samostalno napisati optimalan upit umjesto oslanjanja na crnu kutiju-optimizator.
Kao plus, knjiga o Q — Q For Mortals dostupna je besplatno na , gdje se također nalaze mnogi drugi korisni materijali.
Još jedan veliki nedostatak je cijena licence. To su deseci tisuća dolara godišnje za jedan CPU. Samo velike tvrtke si mogu priuštiti takve troškove. U posljednje vrijeme, KX je učinio politiku licenciranja fleksibilnijom i omogućuje plaćanje samo za vrijeme korištenja ili iznajmljivanje KDB+ u oblacima Googlea i Amazona. Također, KX nudi za preuzimanje (32-bitna verzija ili 64-bitna na zahtjev).
Konkurenti
Postoji prilično mnogo specijaliziranih baza podataka temeljenih na sličnim principima — kolonske, in-memory, orijentirane na vrlo velike količine podataka. Problem je u tome što su to specijalizirane baze podataka. Svijetli primjer je Clickhouse. Ova baza podataka ima vrlo sličan princip pohrane podataka na disku i izgradnje indeksa kao KDB+, a neki zahtjevi izvršava brže od KDB+, iako ne znatno. No, čak i kao baza podataka, Clickhouse je specijaliziranija od KDB+ — web analitika naspram slobodnih vremenskih serija (ovo razlikovanje je jako važno — zbog njega, na primjer, u Clickhouse-u nije moguće koristiti redoslijed zapisa). Ali, najvažnije, Clickhouse nema univerzalnost KDB+, jezika koji omogućava obradu podataka neposredno u bazi, umjesto da ih prethodno učitate u zasebnu aplikaciju, da izgradite slobodne SQL izraze, primijenite proizvoljne funkcije u zahtjevu, stvorite procese koji nisu vezani za izvršavanje funkcija povijesne baze. Stoga je teško uspoređivati KDB+ s drugim bazama, one mogu biti bolje u pojedinim scenarijima korištenja ili jednostavno bolje kada se radi o zadacima klasičnih baza podataka, ali mi nije poznat drugi tako učinkovit i univerzalan alat za obradu vremenskih podataka.
Integracija s Pythonom
Kako bi se olakšao rad s KDB+ za ljude koji nisu upoznati s tehnologijom, KX je stvorio biblioteke za usku integraciju s Pythonom unutar jednog procesa. Možete pozvati bilo koju Python funkciju iz Q, i obrnuto — pozvati bilo koju Q funkciju iz Pythona (konkretno QSQL izraze). Biblioteke konvertiraju po potrebi (radi učinkovitosti ne uvijek) podatke iz formata jednog jezika u format drugog. Na kraju, Q i Python žive u tako uskoj simbiozi da se granice između njih brišu. Kao rezultat, programer s jedne strane ima potpuni pristup brojnim korisnim Python bibliotekama, a s druge strane dobiva integriranu u Python brzu bazu za rad s velikim podacima, što je osobito korisno onima koji se bave strojnim učenjem ili modeliranjem.
Rad s Q u Pythonu:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Linkovi
Web stranica kompanije —
Web stranica za programere —
Knjiga Q For Mortals (na engleskom) —
Članci o primjenama KDB+/Q od zaposlenika kx —
Izvor: habr.com
