

26. veljače održali smo meet-up Apache Ignite GreenSource, gdje su govorili suradnici open source projekta . Važan događaj u životu ove zajednice bila je rekonstrukcija komponente , koja omogućava implementaciju korisničkih mikroslužbi izravno u klasteru Ignite. O tom složenom postupku na meet-upu je govorio , softverski inženjer i već više od dvije godine suradnik Apache Ignite.
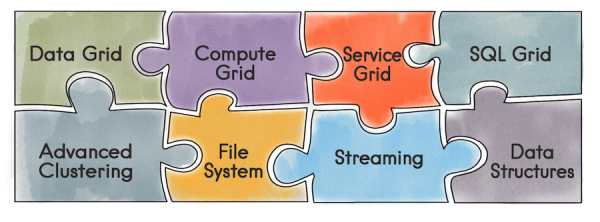
Krenimo od toga što je Apache Ignite uopće. To je baza podataka koja predstavlja distribuirano Key/Value spremište s podrškom za SQL, transakcije i keširanje. Osim toga, Ignite omogućava distribuciju korisničkih servisa izravno u klasteru Ignite. Razvojnim inženjerima na raspolaganju su svi alati koje Ignite nudi — distribuirane strukture podataka, Messaging, Streaming, Compute i Data Grid. Na primjer, korištenjem Data Grid-a nestaje problem upravljanja posebnom infrastrukturom za pohranu podataka, a kao posljedica toga dolazi do smanjenja troškova.
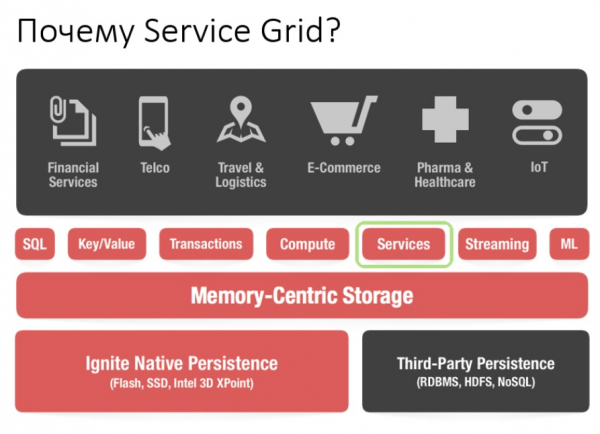
Korištenjem API-ja Service Grid, moguće je implementirati servis jednostavnim navođenjem sheme implementacije i samog servisa u konfiguraciji.
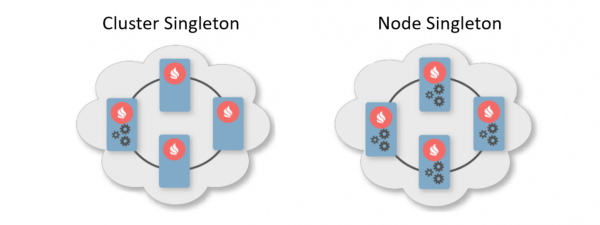
Obično shema implementacije označava broj instanci koje trebaju biti raspoređene na čvorovima klastera. Postoje dvije tipične sheme implementacije. Prva je Cluster Singleton: u bilo kojem trenutku u klasteru bit će zajamčeno dostupna jedna instanca korisničkog servisa. Druga je Node Singleton: na svakom čvoru klastera raspoređena je po jedna instanca servisa.
Također, korisnik može odrediti broj instanci servisa u cijelom klasteru i definirati predikat za filtriranje odgovarajućih čvorova. U takvom scenariju Service Grid će sam izračunati optimalnu distribuciju za implementaciju servisa.
Osim toga, postoji funkcija poznata kao Affinity Service. Affinity je funkcija koja određuje vezu ključeva s particijama i veze particija s čvorovima u topologiji. Na temelju ključa može se odrediti primarni čvor na kojem se pohranjuju podaci. Na taj način možete povezati vlastitu uslugu s ključem i cache-om affinity funkcije. U slučaju promjene affinity funkcije, doći će do automatske redeploy. Tako će biti uvijek smještena blizu podataka s kojima treba raditi, što će smanjiti troškove pristupa informacijama. Ovu shemu možemo nazvati nekom vrstom kolociranih izračuna.
Sada kada smo razjasnili čari Service Grida, pričat ćemo o njegovoj povijesti razvoja.
Što je bilo prije
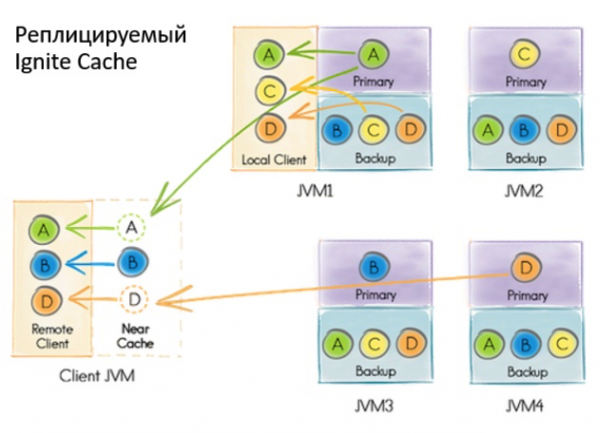
Prošla implementacija Service Grida temeljila se na transakcionom repliciranom sistemskom cacheu Ignite. Pod pojmom "cache" u Ignite podrazumijeva se skladište. Dakle, to nije nešto privremeno, kako bi se moglo pomisliti. Iako je cache repliciran i svaka čvor sadrži cjelokupni skup podataka, unutar cache-a postoji particionirano prikazivanje. To je povezano s optimizacijom skladišta.
Što se događalo kada je korisnik želio deploy-ati uslugu?
- Svi čvorovi u klasteru potpisivali su se za ažuriranje podataka u skladištu pomoću ugrađenog mehanizma Continuous Query.
- Inicirajući čvor je pod read-committed transakcijom napravio unos u bazu koji je sadržavao konfiguraciju usluge, uključujući serijalizirani instanc.
- Kada bi primio obavijest o novom unosu, koordinator bi izračunao raspodjelu na temelju konfiguracije. Dobiveni objekt bi se zapisivao natrag u bazu.
- Ako je čvor bio uključen u raspodjelu, koordinator ga je trebao deploy-ati.
Što nas nije zadovoljilo
U nekom trenutku smo došli do zaključka: ovako se ne može raditi s uslugama. Razloga je bilo nekoliko.
Ako bi tijekom deploya došlo do neke greške, mogli bismo saznati samo iz logova onog čvora gdje se sve dogodilo. Postojao je samo asinkroni deploy, pa je nakon vraćanja kontrole korisniku iz metode deploya bilo potrebno dodatno vrijeme za pokretanje usluge — i u to vrijeme korisnik nije mogao upravljati ničim. Da bismo dalje razvijali Service Grid, dodavali nove funkcije, privukli nove korisnike i olakšali svima život, trebali smo promijeniti nešto.
Kada smo projektirali novu Service Grid, prvenstveno smo željeli jamčiti sinkrono implementiranje: čim korisniku bude vraćena kontrola od API-ja, odmah može koristiti usluge. Također smo htjeli omogućiti inicijatoru da obrađuje greške implementacije.
Osim toga, htjeli smo olakšati implementaciju, a to znači izbjeći transakcije i rebalance. Iako je keš replikabilan i nema balansa, tijekom velike implementacije s mnogo čvorova javili su se problemi. Prilikom promjene topologije, čvorovi moraju razmjenjivati informacije, a kod velike implementacije ti podaci mogu biti vrlo obimni.
Kada je topologija bila nestabilna, koordinator je morao ponovo izračunati raspodjelu usluga. U cjelini, kada se mora raditi s transakcijama na nestabilnoj topologiji, to može dovesti do teško predvidljivih grešaka.
Problemi
Koje bi to globalne promjene bile bez pratećih problema? Prvi od njih bio je promjena topologije. Treba razumjeti da u svakom trenutku, čak i tijekom implementacije usluge, čvor može ući u klaster ili iz njega izaći. Štoviše, ako čvor uđe u klaster tijekom implementacije, bit će potrebno konzistentno prenijeti sve informacije o uslugama u novi čvor. Ne radi se samo o onome što je već implementirano, već i o trenutnim i budućim implementacijama.
To je samo jedan od problema koji se može skupiti u zaseban popis:
- Kako implementirati statički konfigurirane usluge prilikom pokretanja čvora?
- Što učiniti kada čvor izađe iz klastera – što ako je čvor hostao usluge?
- Što učiniti ako se koordinator promijenio?
- Što učiniti ako se klijent ponovo poveže na klaster?
- Treba li obraditi zahtjeve za aktiviranje/deaktiviranje i kako?
- A što ako je pozvan destruktor keša, a imamo povezane afinitetne usluge?
I to nije sve.
Rešenje
Kao cilj izabrali smo pristup vođen događajima s implementacijom komunikacije procesa putem poruka. U Ignite su već implementirana dva komponente koja omogućuju čvorovima da međusobno šalju poruke — communication-spi i discovery-spi.
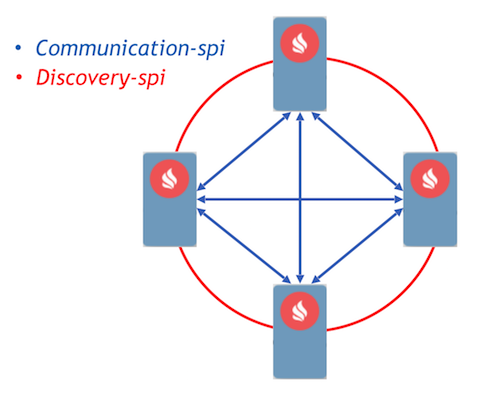
Communication-spi omogućava čvorovima izravnu komunikaciju i slanje poruka. Savršeno je za prijenos velikih količina podataka. Discovery-spi omogućava slanje poruke svim čvorovima u klasteru. U standardnoj implementaciji to se radi prema 'prsten' topologiji. Također postoji integracija s Zookeeper, u tom slučaju koristi se 'zvjezdasta' topologija. Važno je napomenuti da discovery-spi osigurava isporuku poruka u točnom redoslijedu svim čvorovima.
Razmotrimo protokol implementacije. Sve korisničke zahtjeve za implementaciju i deimplementaciju šalju se putem discovery-spi. To omogućava sljedeće jamstva:
- Zahtjev će biti primljen svim čvorovima u klasteru. To će omogućiti nastavak obrade zahtjeva u slučaju promjene koordinatora. Također to znači da za jednu poruku svaki čvor dobije sve potrebne metapodatke, poput konfiguracije usluge i njezinog serijaliziranog instance.
- Strog redoslijed isporuke poruka omogućava rješavanje sukoba konfiguracija i konkurentnih zahtjeva.
- Budući da se pristup čvora u topologiji također obrađuje putem discovery-spi, novi čvor će dobiti sve potrebne podatke za rad s uslugama.
Pri primanju zahtjeva, čvorovi u klasteru validiraju ga i formiraju zadatke za obradu. Ovi se zadaci stavljaju u red i zatim obrađuju u drugom procesu kroz odvojenog radnika. Ovo je realizirano tako jer implementacija može trajati značajno dugo i odgađanje skupljeg discovery-toka je neprihvatljivo.
Sve zahtjeve iz reda obrađuje upravitelj implementacije. Ima posebnog radnika koji izvlači zadatak iz ovog reda i inicijalizira ga za početak razmatranja. Nakon toga slijede sljedeće radnje:
- Svaki čvor samostalno izračunava raspodjelu zahvaljujući novoj determinističkoj funkciji dodeljivanja.
- Čvorovi formiraju poruku s rezultatima implementacije i šalju je koordinatoru.
- Koordinator agregira sve poruke i formira rezultat cjelokupnog procesa implementacije, koji se šalje putem discovery-spi svim čvorovima u klasteru.
- Pri primitku rezultata, proces implementacije završava, nakon čega se zadatak uklanja iz reda.
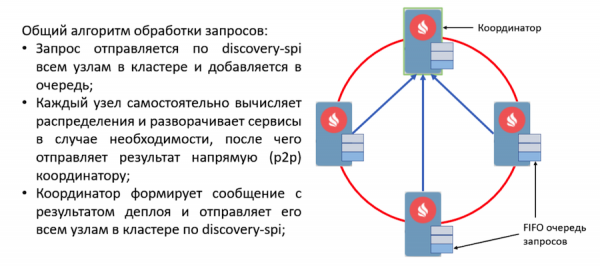
Novi event-driven dizajn: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Ako se prilikom postavljanja dogodi greška, čvor odmah uključuje tu grešku u poruku koju šalje koordinatoru. Nakon agregacije poruka, koordinator će imati informacije o svim greškama tokom implementacije i poslaće tu poruku preko discovery-spi. Informacije o greškama biće dostupne na bilo kojem čvoru u klasteru.
Prema ovom algoritmu se obrađuju svi važni događaji u Service Grid-u. Na primer, promena topologije je takođe poruka preko discovery-spi. A u celini, ako uporedimo sa onim što je bilo, protokol je ispao prilično lagan i pouzdan. Dovoljno da obrađuje svaku situaciju tokom implementacije.
Što dolazi sljedeće
Sada o planovima. Svaka veća promena u projektu Ignite se sprovodi kao inicijativa za poboljšanje Ignite-a, takozvani IEP. Redizajn Service Grida takođe ima IEP — sa duhovitim naslovom „Zamena ulja u Servisu Gridu“. Ali u stvarnosti, nismo promenili ulje u motoru, već ceo motor.
Zadatke u IEP-u smo podelili na 2 faze. Prva — velika faza, koja se sastoji u prepravci protokola implementacije. Već je uključena u glavni repozitorij, možete isprobati novi Service Grid, koji će se pojaviti u verziji 2.8. Druga faza obuhvata mnoge druge zadatke:
- Toplotni rediploj
- Verzionisanje usluga
- Povećanje otpornosti na greške
- Tanki klijent
- Alati za praćenje i merenje raznih metrika
Na kraju, možemo vam preporučiti Service Grid za izgradnju sistema otpornog na greške visoke dostupnosti. Takođe vas pozivamo da dođete kod nas na i delite svoje iskustvo. Vaše iskustvo je zaista važno za zajednicu, pomoći će da se shvati kuda dalje krenuti i kako u budućnosti razvijati komponentu.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish