

Naša tvrtka od 2008. godine uglavnom se bavi upravljanjem infrastrukturom i 24-satnom tehničkom podrškom za web projekte: imamo više od 400 klijenata, što čini otprilike 15% elektroničke trgovine u Hrvatskoj. Samim tim, podrška ima vrlo raznoliku arhitekturu. Ako nešto padne, dužni smo to popraviti unutar 15 minuta. No, kako bismo razumjeli da je došlo do nesreće, potrebno je nadzirati projekt i reagirati na incidente. Kako to učiniti?
Mislim da u organizaciji ispravnog sustava monitoringa dolazi do problema. Da tih problema nije bilo, moj izlaganje bi se sastojalo od jednog tezisa: "Molimo vas instalirajte Prometheus + Grafana i dodatke 1, 2, 3". Nažalost, više to ne funkcioniše. A glavni problem leži u tome što svi nastavljaju vjerovati u nešto što je postojalo 2008. godine, s obzirom na softverske komponente.
Što se tiče organizacije sustava monitoringa, riskirao bih reći da... ne postoji projekata s pravilnim monitoringom. Situacija je toliko loša da, ako nešto padne, postoji rizik da će ostati nezapaženo — svi su uvjereni da se "sve nadzire".
Možda se sve nadzire. Ali kako?
Svi smo se susreli s pričom sličnom sljedećoj: radi određeni DevOps, neki administrator, a timu developera dolazi i kaže — "objavili smo, sada nadzirite". Što nadzirati? Kako to radi?
U redu. Nadziremo na stari način. A ono se već mijenja, i otkriva se da ste nadzirali servis A, koji je postao servis B, koji komunicira sa servisom C. No, tim developera vam kaže: "Instalirajte softver, on bi trebao sve nadzirati!"
Što se promijenilo? — Sve se promijenilo!
2008. godina. Sve je bilo savršeno
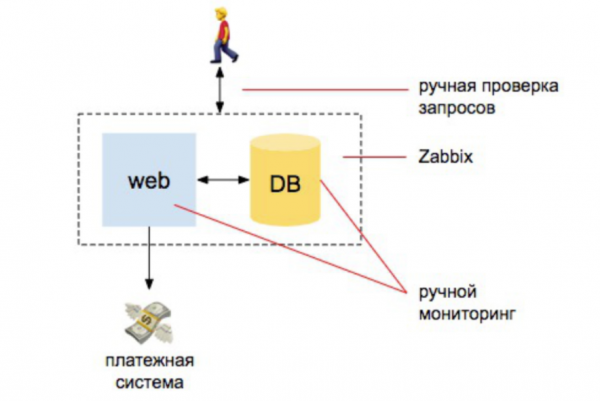
Ima par developera, jedan server, jedan server BD. Odatle sve i ide. Imamo određene informacije, postavljamo Zabbix, Nagios, Cacti. Potom postavljamo jasne alerte za CPU, rad diskova, prostor na diskovima. Također provodimo nekoliko ručnih provjera da li web stranica odgovara i da li narudžbe dolaze u bazu. I to je to – više-manje smo zaštićeni.
Ako usporedimo obujam posla koji je tada obavljao administrator radi osiguranja nadzora, 98% toga je bilo automatsko: osoba koja se bavi nadzorom mora razumjeti kako postaviti Zabbix, kako ga konfigurirati i postaviti alarme. A 2% — za vanjske provjere: da li web stranica odgovara i izvršava upite u bazu, da li su novi narudžbe stigli.
2010. godina. Raste opterećenje.
Počinjemo skalirati webove, dodajemo pretraživač. Želimo biti sigurni da katalog proizvoda sadrži sve proizvode. I da pretraživanje proizvoda funkcionira. Da baza radi, da se narudžbe izvršavaju, da web stranica odgovara vanjskim zahtjevima i odgovara s dva, poslužitelja i da korisnik ne bude izbačen sa web stranice dok se prebacuje na drugi poslužitelj, itd. Broj entiteta raste.
Pri tome, entitet povezan s infrastrukturom i dalje ostaje najveći u umu menadžera. I dalje u mislima postoji ideja da osoba koja se bavi nadzorom — to je osoba koja će postaviti Zabbix i moći ga konfigurirati.
Ali istovremeno se pojavljuju poslovi vezani uz izvođenje vanjskih provjera, stvaranje skupa skripti za upite pretraživača, skup skripti za provjeru da se pretraživanje mijenja tijekom indeksiranja, skup skripti koje provjeravaju da se proizvodi isporučuju službi isporuke, itd.
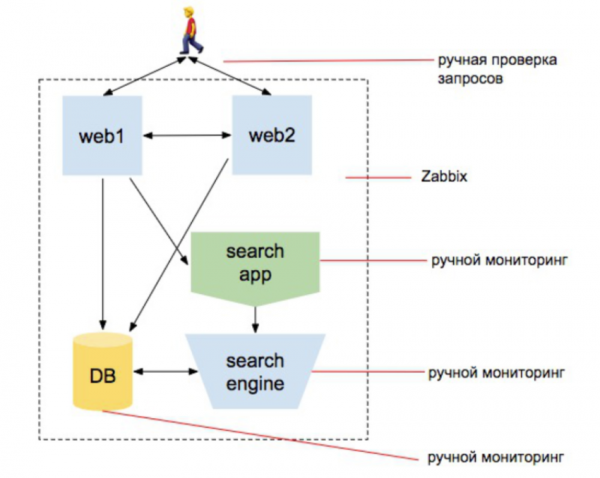
Primijetite: tri puta sam napisao "skup skripti". To jest, odgovorna osoba za nadzor više nije ona koja samo instalira Zabbix. To je osoba koja počinje programirati. No, u glavama tima zasad se ništa ne mijenja.
Međutim, svijet se mijenja, postajući sve složeniji. Dodaje se sloj virtualizacije, nekoliko novih sustava. Počinju međusobno komunicirati. Tko je rekao "miriše na mikroservise?" No svaki servis još uvijek izgleda kao zasebna web stranica. Možemo mu pristupiti i razumjeti da pruža potrebne informacije i da radi samostalno. I ako ste administrator koji se stalno bavi projektom koji se razvija 5-7-10 godina, ta znanja se akumuliraju: dolazi nova razina — postali ste je svjesni, dolazi još jedna razina — postali ste je svjesni…
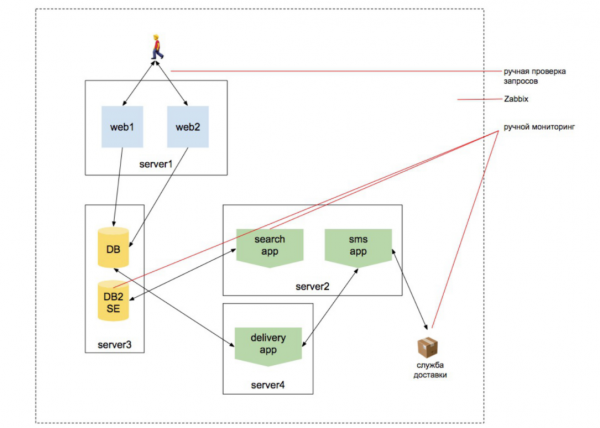
No rijetko tko održava projekt 10 godina.
Sažetak za nadzornika
Zamislite da ste došli u novi startup koji je odmah okupio 20 developera, napisao 15 mikroslužbi, a vi ste admin kojem kažu: „Izgradi CI/CD. Molim te.” Izgradili ste CI/CD i odjednom čujete: „Teško nam je raditi s produkcijom u 'kocki', ne razumijući kako će aplikacija funkcionirati u njoj. Napravi nam pij sandbox u toj istoj 'kocki'.
Napravili ste taj sandbox u toj kocki. Odmah vam kažu: „Želimo stage bazu podataka koja će se svakodnevno ažurirati s produkcije, kako bismo razumjeli da to radi na bazi podataka, ali istovremeno ne želimo pokvariti produkcijsku bazu podataka.”
Živite u svemu tome. Ostale su 2 tjedna do izlaska, i kažu vam: „Sad bi to sve trebalo monitorirati...” Dakle, monitorirati klaster infrastrukturu, monitorirati mikroservisnu arhitekturu, monitorirati rad s vanjskim servisima...
A kolege iznose iz glave uobičajeni obrazac i govore: „Pa ovdje je sve jasno! Stavi program koji će to sve monitorirati.” Da, da: Prometheus + Grafana + dodaci.
I dodaju pri tome: „Imaš otprilike dva tjedna, učini da sve bude pouzdano.”
U gomili projekata koje vidimo, na monitoring se dodjeljuje jedna osoba. Zamislite da želimo unajmiti čovjeka na 2 tjedna koji će se baviti monitoringom i sastavljamo mu životopis. Koje vještine bi taj čovjek trebao imati — uzimajući u obzir sve prethodno rečeno?
- Trebalo bi razumjeti monitoring i specifičnosti rada hardverske infrastrukture.
- Trebao bi razumjeti specifičnosti monitoringa Kubernetes-a (svi žele u 'kocku', jer se može abstrahirati od svega, skrivajući se, jer će admin riješiti ostalo) — samog po sebi, njegove infrastrukture, i razumjeti kako monitorirati aplikacije unutar njega.
- Trebalo bi shvatiti da se servisi međusobno komuniciraju posebnim načinima i znati specifičnosti interakcije servisa jedni s drugima. Sasvim je realno vidjeti projekt gdje se dio servisa komunicira sinkrono, jer drugačije ne može. Na primjer, backend ide preko REST-a, preko gRPC do servisa za katalog, dobiva popis proizvoda i vraća ga natrag. Ovdje se ne može čekati. A s drugim servisima radi asinkrono. Prenijeti narudžbu u službu dostave, poslati e-mail itd.
Vjerojatno ste se već izgubili od svega ovog? A admin kojem je potrebno to monitorirati, još više se izgubio. - Mora biti sposoban planirati i pravilno organizirati jer posla je svakim danom sve više.
- Stoga mora razviti strategiju iz uslužnog modela kako bi razumio kako to konkretno nadzirati. Potrebno mu je razumijevanje arhitekture projekta i njegovog razvoja + poznavanje tehnologija koje se koriste u razvoju.
Podsjetimo se na potpuno normalan slučaj: dio usluga je na php-u, dio na Go-u, a dio na JS-u. Oni na neki način međusobno surađuju. Odatle dolazi termin 'mikroservis': postalo je toliko odvojenih sustava da programeri ne mogu shvatiti projekt u cjelini. Jedan dio tima piše usluge na JS-u, koje rade same za sebe i ne znaju kako funkcionira ostatak sustava. Drugi dio piše usluge na Pythonu i ne zaranja u to kako rade druge usluge, oni su izolirani u svom području. Treći - piše usluge na php-u ili nečemu drugom.
Sva ta 20 osoba podijeljena je na 15 usluga, a postoji samo jedan admin koji sve to treba razumjeti. Čekajte! Upravo smo sustav podijelili na 15 mikroservisa, jer 20 ljudi ne može razumjeti cijeli sustav.
Ali treba to nekako nadzirati...
Što na kraju? Na kraju postoji jedna osoba koja shvaća sve što cjelokupna ekipa programera ne može shvatiti, a pritom još mora znati i moći ono što smo naveli iznad - hardversku infrastrukturu, infrastrukturu Kubernetes itd.
Što reći... Houston, imamo problem.
Nadzor modernog programskog projekta - to je samostalan programski projekt.
Iz lažne sigurnosti da je nadzor softver, dolazimo do vjere u čuda. A čuda, nažalost, ne postoje. Ne možete jednostavno postaviti zabbix i čekati da sve proradi. Nema smisla postaviti Grafanu i nadati se da će sve biti u redu. Većina vremena će biti utrošena na organizaciju provjera rada usluga i njihovih međusobnih interakcija, provjere kako rade vanjski sustavi. U stvarnosti, 90% vremena će se potrošiti ne na pisanje skripti, već na razvoj softvera. A time bi se trebala baviti ekipa koja razumije rad projekta.
Ako u ovoj situaciji jednu osobu pustimo da se bavi nadzorom, doći će do katastrofe. Što se i događa posvuda.
Na primjer, postoje razne usluge koje komuniciraju međusobno preko Kafke. Primili smo narudžbu, poslali smo poruku o narudžbi u Kafku. Postoji usluga koja sluša informacije o narudžbi i upravlja otpremom proizvoda. Tu je i usluga koja sluša informacije o narudžbi i šalje e-mail korisniku. A zatim se pojavljuje još mnogo usluga i počinjemo se gubiti.
A ako to predate administratoru i developerima u trenutku kada je do lansiranja ostalo malo vremena, osoba će morati razumjeti cijeli ovaj protokol. Drugim riječima, projekt ovakvog opsega zahtijeva značajno vrijeme, i to bi trebalo biti predviđeno u razvoju sustava.
No, vrlo često, posebno u startupima, vidimo kako se monitoring odgađa. "Sada ćemo napraviti Proof of Concept, pokrenut ćemo ga, neka pada – spremni smo na to. A onda ćemo sve to nadzirati." Kada (ili ako) projekt počne donositi novac, biznis želi dodati još više funkcija — jer je počelo raditi, znači treba još napredovati! A vi ste u trenutku kada prvo treba nadzirati sve prethodno, što ne traje 1% vremena, već znatno više. I, usput rečeno, za monitoring će biti potrebni developeri, a lakše ih je usmjeriti prema novim funkcijama. Na kraju se pišu nove funkcije, sve se diže, a vi ste u beskonačnom deadlocku.
Kako dakle nadzirati projekt od samog početka, i što učiniti ako vam je dodijeljen projekt koji treba nadzirati, a ne znate odakle početi?
Prvo, potrebno je planirati.
Lirska digresija: vrlo često se počinje s monitoringom infrastrukture. Na primjer, imamo Kubernetes. Počnimo s postavljanjem Prometheusa s Grafanom, instalirat ćemo pluginove za monitoring "kubika". Ne samo programeri, već i administratori imaju žalosnu praksu: "Instalirat ćemo ovaj plugin, a plugin zna kako to učiniti." Ljudi vole početi s jednostavnim i razumljivim stvarima, a ne s važnim radnjama. I monitoring infrastrukture je jednostavan.
Prvo odlučite što i kako želite pratiti, a zatim odaberite alat, jer drugi ljudi ne mogu razmišljati umjesto vas. I trebaju li? Drugi ljudi su razmišljali o sebi, o univerzalnom sustavu — ili nisu razmišljali uopće dok su pisali ovu pluginu. I to što ovaj plugin ima 5000 korisnika, ne znači da donosi neku korist. Možda ćete postati 5001. samo zato što je prije vas već bilo 5000 ljudi.
Ako ste počeli pratiti infrastrukturu i backend vaše aplikacije prestane odgovarati, svi korisnici će izgubiti vezu s mobilnom aplikacijom. Pojavit će se greška. Doći će vam i reći 'Aplikacija ne radi, čime se bavite?' — 'Pratimo.' — 'Kako pratite, ako ne vidite da aplikacija ne radi?!'
- Smatram da bi praćenje trebalo započeti upravo s ulazne točke korisnika. Ako korisnik ne vidi da aplikacija radi — sve, to je neuspjeh. A sustav praćenja treba to prvo prijaviti.
- Tek tada možemo pratiti infrastrukturu. Ili to učiniti paralelno. S infrastrukturom je lakše — tu konačno možemo jednostavno postaviti Zabbix.
- A sada trebamo ići u korijene aplikacije kako bismo razumjeli gdje nešto ne radi.
Moja glavna misao je – praćenje treba ići paralelno s procesom razvoja. Ako ste odvojili tim za praćenje za druge zadatke (izrada CI/CD, sandbox, reorganizacija infrastrukture), praćenje će početi zaostajati i možda nikada nećete uhvatiti razvoj (ili će ranije ili kasnije morati stati).
Sve po razinama
Ovako ja vidim organizaciju sustava praćenja.
1) Razina aplikacije:
- praćenje poslovne logike aplikacije;
- praćenje health-metrika servisa;
- integracijsko praćenje.
2) Razina infrastrukture:
- praćenje razine orkestracije;
- praćenje sistemskog softvera;
- praćenje razine 'hardvera'.
3) Ponovno razina aplikacije — ali već kao inženjerskog proizvoda:
- prikupljanje i praćenje logova aplikacije;
- APM;
- tracing.
4) Upozorenja:
- organizacija sustava obavijesti;
- organizacija sustava dežurstava;
- organizacija 'baze znanja' i workflow obrada incidenata.
Važno: dolazimo do alertinga ne nakon, već odmah! Ne trebate pokretati monitoring i „kako-tako kasnije“ smišljati kome će stizati alerti. Jer u čemu je svrha monitoringa: razumjeti gdje u sustavu nešto ne djeluje ispravno i obavijestiti odgovarajuće ljude o tome. Ako to ostavite za kraj, odgovarajući ljudi saznat će da nešto ne štima tek kada dobiju poziv „ništa nam ne radi“.
Razina aplikacije — monitoring poslovne logike
Ovdje se radi o provjerama samog čina da aplikacija radi za korisnika.
Ova razina treba biti postavljena u fazi razvoja. Na primjer, imamo zamišljeni Prometheus: on pristupa serveru koji se bavi provjerama, poziva endpoint, a endpoint dolazi i provjerava API.
Kad često traže da nadgledaju glavnu stranicu kako bi osigurali da web stranica radi, programeri daju endpoint koji se može pozivati svaki put kada je potrebno potvrditi da API radi. A programeri u tom trenutku također razvijaju /api/test/helloworld.
Jedini način da se uvjerite da sve radi? — Ne!
- Izrada takvih provjera — u suštini, zadatak je programera. Unit testove trebaju pisati programeri koji pišu kod. Jer, ako to date administratoru: „Čovječe, evo ti popis API protokola svih 25 funkcija, molim te, nadgledaj sve!“ — ništa od toga.
- Ako napravite print “hello world”, nitko nikada neće saznati da API treba i zapravo radi. Svaka promjena API-ja treba povući promjenu provjera.
- Ako već imate takvu situaciju – obustavite značajke i odvojite programere koji će napisati te provjere, ili se pomirite s gubicima, pomirite se s tim da ništa nije provjereno i da će pasti.
Tehnički savjeti:
- Obavezno organizirajte vanjski server za provjere — morate biti sigurni da je vaš projekt dostupan vanjskom svijetu.
- Organizirajte provjeru cijelog API-ja, a ne samo pojedinačnih endpoint-a.
- Kreirajte prometheus-endpoint s rezultatima provjera.
Razina aplikacije — monitoring health-metra
Sada se radi o vanjskim health-metricama usluga.
Odlučili smo da pratimo sve "ručice" aplikacije pomoću eksternih provera koje pozivamo iz spoljnog monitoring sistema. No to su zaista "ručice" koje korisnik "vidi". Želimo da budemo sigurni da nam sami servisi rade. U ovom slučaju, situacija je bolja: u K8s postoje health checkovi koji barem omogućavaju "kockici" da se uveri da servis funkcioniše. No, polovina provera koje sam video su isti oni print "hello world". Tj. on poziva jedanput posle deploy-a, dobije odgovor da je sve u redu — i to je sve. A kod servisa, koji preko REST-a izlaže svoj API, postoji ogromna količina ulaza tog istog API-ja, koji takođe treba pratiti, jer želimo znati da funkcioniše. I njega pratimo iznutra.
Kako to ispravno tehnički implementirati: svaki servis izlaže endpoint o svom trenutnom radnom stanju, a u grafikonima Grafana (ili bilo koju drugu aplikaciju) vidimo status svih servisa.
- Svaka promena API-ja treba da vodi do promene provera.
- Novi servis kreirajte odmah sa health metrikama.
- Admin može doći do developera i tražiti "dodajte mi par karakteristika da sve razumem i da mogu dodati informacije o tome u svoj monitoring sistem". Međutim, developeri obično odgovaraju "Nećemo dodavati ništa dve nedelje pre isporuke."
Neka menadžeri razvoja budu svesni da će biti takvih gubitaka, neka i nadredjeni menadžeri razvoja znaju. Jer, kada sve propadne, neko će i dalje zvati i zahtevati da se "stalno padajući servis" (c) prati. - Usput, izdvojite programere za pisanje dodataka za Grafana — to će biti velika pomoć za administratore.
Nivo aplikacije — Integracijski monitoring
Integracijski monitoring fokusira se na praćenje komunikacije između kritičnih poslovnih sistema.
Na primer, postoji 15 servisa koji međusobno komuniciraju. To više nisu odvojeni sajtovi. Tj. ne možemo pozvati servis sam za sebe, dobiti /helloworld i shvatiti da servis funkcioniše. Jer web servis za poručivanje treba da pošalje informacije o porudžbini u magistralu — iz magistrale služba za skladištenje treba da primi ovu poruku i dalje raditi s njom. A servis za slanje e-mailova treba da to dalje obradi, itd.
Stoga, ne možemo razumjeti, pokušavajući svaki pojedini servis, kako sve to funkcionira. Jer imamo neku sabirnicu kroz koju se sve komunicira i međusobno djeluje.
Zbog toga bi ova faza trebala odražavati fazu testiranja servisa u interakciji s drugim servisima. Nije moguće, samo nadgledajući posrednika poruka, uspostaviti nadzor komunikacije. Ako postoji servis koji isporučuje podatke, i servis koji ih prima, pri nadzoru posrednika vidjet ćemo samo podatke koji putuju s jedne na drugu stranu. Čak i ako nekako uspijemo nadgledati interakciju ovih podataka iznutra — da neki proizvođač objavljuje podatke, netko ih čita, taj tok nastavlja teći u Kafka — to nam i dalje neće pružiti informacije ako je jedan servis poslao poruku u jednoj verziji, a drugi servis nije očekivao tu verziju i propustio je. Nećemo saznati za to, jer će nam servisi reći da sve radi.
Kako preporučujem to raditi:
- Za sinkronu komunikaciju: krajnja točka izvršava zahtjeve povezanim servisima. Tj. uzimamo tu krajnju točku, pokrećemo skriptu unutar servisa koja ide kroz sve točke i govori 'mogu ovdje povući, i ovdje povući, mogu ovdje povući…'
- Za asinkronu komunikaciju: dolazne poruke — krajnja točka provjerava sabirnicu na prisutnost testnih poruka i isporučuje status obrade.
- Za asinkronu komunikaciju: odlazne poruke — krajnja točka šalje testne poruke na sabirnicu.
Kako to obično ide: imamo servis koji šalje podatke na sabirnicu. Dolazimo u taj servis i tražimo da nam ispriča o svom integracijskom zdravlju. I ako servis treba da proda neku poruku negdje dalje (WebApp), on će tu testnu poruku prodati. A ako zovemo servis s strane OrderProcessing, on prvo objavljuje ono što može objaviti neovisno, a ako postoje neke ovisne stvari — onda čita iz sabirnice skup testnih poruka, razumije što može obraditi, javlja to i, ako treba, objavljuje ih dalje, i o tome javlja — sve je u redu, živ sam.
Vrlo često čujemo pitanje „kako to možemo testirati na stvarnim podacima?” Na primjer, radi se o istoj usluzi narudžbi. Narudžba šalje poruke u skladište, gdje se proizvodi odbacuju: ne možemo to testirati na stvarnim podacima, jer „moji proizvodi će biti odbijeni!” Rješenje: u ranoj fazi planirati cijeli ovaj test. Već imate unit testove koji koriste mock-ove. Dakle, to učinite na dubljoj razini, gdje će prolaziti kanal komunikacije koji neće naštetiti poslovanju.
Razina infrastrukture
Nadzor infrastrukture – to je nešto što se već dugo smatra samim nadzorom.
- Nadzor infrastrukture se može i mora pokrenuti kao zaseban proces.
- Ne treba započinjati s nadzorom infrastrukture na aktivnom projektu, čak i ako to jako želite. To je bolna točka za sve DevOps-ove. „Prvo ću nadzirati klaster, zatim ću nadzirati infrastrukturu“ – tj. prvo će nadzirati ono što je nisko, a u aplikaciju neće ulaziti. Jer aplikacija je nejasna stvar za DevOps-a. To mu je prepušteno, a on ne razumije kako to funkcionira. A infrastrukturu razumije i započinje s njom. No ne – uvijek trebate prvo nadzirati aplikaciju.
- Ne pretjerujte s brojem obavijesti. S obzirom na složenost modernih sustava, upozorenja stižu neprekidno, i s tom gomilom upozorenja treba nekako živjeti. A osoba koja je na pozivu, pogledavši stotinu upozorenja, odlučit će „ne želim o tome razmišljati”. Upozorenja trebaju obavještavati samo o kritičnim stvarima.
Razina aplikacije kao poslovne jedinice
Ključne točke:
- ELK. To je industrijski standard. Ako iz bilo kojeg razloga ne agregirate logove, odmah to počnite raditi.
- APM. Vanjski APM kao način brzog zatvaranja nadzora aplikacije (NewRelic, BlackFire, Datadog). Možete privremeno postaviti ovaj alat da biste na neki način razumjeli što se događa.
- Tracing. U desetinama mikroservisa morate piti sve, jer zahtjev više ne postoji sam za sebe. Kasnije je vrlo teško dodati, stoga je bolje odmah planirati tracing u razvoju — to je posao i alat programera. Ako još niste implementirali – implementirajte! Vidi Jaeger/Zipkin.
Upozorenje
- Organizacija sustava obavijesti: u uvjetima praćenja velikog broja stvari mora postojati jedinstveni sustav slanja obavijesti. To se može napraviti putem Grafane. Na Zapadu svi koriste PagerDuty. Obavijesti trebaju biti jasne (na primjer, odakle dolaze…). Također, poželjno je kontrolirati dolaze li obavijesti uopće.
- Organizacija sustava dežurstva: alarmi ne bi trebali dolaziti svima (ili će svi reagirati u gužvi, ili nitko neće). On-call trebaju biti i programeri: obavezno definirajte područja odgovornosti, izradite jasne upute i navedite tko konkretno naziva u ponedjeljak i srijedu, a tko u utorak i petak (inače neće zvati niti u slučaju velike nesreće — bojat će se da će probuditi i uznemiriti: ljudi općenito ne vole zvati i buditi druge, posebno noću). Objasnite da traženje pomoći nije znak nesposobnosti („tražim pomoć — znači loš sam radnik”), potičite zahtjeve za pomoć.
- Organizacija „baze znanja” i workflow obrade incidenata: za svaki ozbiljan incident treba biti zakazan postmortem, kao privremena mjera trebaju biti zabilježene radnje koje će riješiti incident. Uvedite praksu da ponavljajući alarmi predstavljaju grijeh; trebaju se riješiti u kodu ili infrastrukturnim radovima.
Tehnološki stog
Zamislimo da imamo sljedeći stog:
- prikupljanje podataka — Prometheus + Grafana;
- analiza logova — ELK;
- za APM ili Tracing — Jaeger (Zipkin).

Izbor opcija nije kritičan. Jer, ako ste na početku shvatili kako pratiti sustav i izradili plan, kasnije već počinjete birati alate prema svojim zahtjevima. Pitanje je što ste odlučili pratiti na početku. Jer, možda alat koji ste izabrali na početku nije uopće prikladan za vaše zahtjeve.
Nekoliko tehničkih trenutaka koje vidim svuda u posljednje vrijeme:
Prometheus se gura unutar Kubernetes-a — tko je to smislio?! Ako vam padne klaster, što ćete učiniti? Ako imate složen klaster unutar, trebala bi raditi neka vrsta unutarnjeg sustava praćenja, i neka vrsta vanjskog, koja će prikupljati podatke iznutra klastera.
Unutar klastera prikupljamo logove i sve ostalo. No sustav za nadzor treba biti vani. Vrlo često u klasteru gdje je Prometheus postavljen unutra, postoje sustavi koji rade vanjske provjere funkcioniranja web stranice. A što ako vam veza s vanjskim svijetom padne i aplikacija ne radi? Ispada da je unutar sve u redu, ali korisnicima to ne pomaže.
Zaključci
- Razvoj nadzora nije samo instalacija alata, već razvoj softverskog proizvoda. 98% današnjeg nadzora je kodiranje. Kodiranje u servisima, kodiranje vanjskih provjera, provjere vanjskih servisa i svega ostalog.
- Ne žalite vrijeme programera na nadzor: to može zauzeti do 30% njihovog rada, ali isplati se.
- Devs, ne brinite se što ne možete nešto nadzirati, jer neke stvari zahtijevaju potpuno drugačiji način razmišljanja. Niste bili programeri, a rad na nadzoru je uistinu njihov posao.
- Ako projekt već radi i nije nadziran (a vi ste menadžer) — osigurajte resurse za nadzor.
- Ako je proizvod već u produkciji, a vi ste devops kojem je rečeno „postavite nadzor“ — pokušajte objasniti vodstvu o čemu sam sve ovo govorio.
Ovo je proširena verzija izlaganja na konferenciji Saint Highload++.
Ako vas zanimaju moje ideje i razmišljanja o IT-u i sličnim temama, evo možete 🙂
Izvor: habr.com
