

Pozdrav svima! Moje ime je Pavel Agalecki. Radim kao tim lider u timu koji razvija sustav dostave Lamoda. Godine 2018. sam govorio na konferenciji HighLoad++, a danas želim predstaviti transkript svog izlaganja.
Moja tema se fokusira na iskustvo naše tvrtke u implementaciji sustava i usluga u različitim okruženjima. Počevši od naših prapovijesnih vremena, kada smo implementirali sve sustave na obične virtualne poslužitelje, do postupnog prelaska s Nomada na implementaciju u Kubernetes. Ispričat ću zašto smo to učinili i s kakvim smo se problemima susretali tijekom procesa.

Implementacija aplikacija na VM
Krenut ćemo od toga da su prije 3 godine svi sustavi i usluge tvrtke bili implementirani na obične virtualne poslužitelje. Tehnički je bilo organizirano tako da je sav kod naših sustava bio pohranjen i sastavljen koristeći sredstva automatske izrade, uz pomoć jenkins-a. Pomoću Ansible-a, iz našeg sustava za kontrolu verzija, otpuštan je na virtualne poslužitelje. Svaki sustav koji je bio u našoj tvrtki bio je implementiran, bar, na 2 poslužitelja: jedan je bio head, a drugi tail. Ova dva sustava bila su apsolutno identična po svim svojim postavkama, snagama, konfiguracijama i ostalom. Razlika između njih bila je samo u tome što je head primao korisnički promet, dok tail nikada nije primao promet korisnika.
Zašto je to učinjeno?
Kada smo implementirali nove verzije naše aplikacije, željeli smo osigurati mogućnost besprijekornog otpuštanja, tj. bez vidljivih posljedica za korisnike. To se postizalo tako da je nova sastavljena verzija pomoću Ansible-a otpuštena na tail. Tamo su ljudi koji su se bavili implementacijom mogli provjeriti i uvjeriti se da sve radi: sve metrike, odjeli i aplikacije rade; potrebni skripti se pokreću. Tek nakon što su se uvjerili da je sve u redu, promet se preusmjerio. Počeo je ići na onaj poslužitelj koji je do tada bio tail. A onaj koji je do tada bio head ostao je bez korisničkog prometa, pri čemu je imao prethodnu verziju naše aplikacije.
Dakle, za korisnike je to bilo neprimjetno. Budući da je prebacivanje trenutačno, jer je to jednostavno prebacivanje balansirača opterećenja. Vrlo se lako možete vratiti na prethodnu verziju jednostavnim prebacivanjem balansirača natrag. Također smo mogli provjeriti sposobnosti aplikacije u produkciji prije nego što korisnički promet počne dolaziti, što je bilo vrlo praktično.
Koje smo prednosti vidjeli u svemu tome?
- Prije svega, to je dovoljno jednostavno funkcionira. Svima je jasno kako takva shema implementacije radi, jer je većina ljudi ikada radila implementaciju na obične virtualne poslužitelje.
- To je dovoljno sigurno, budući da je tehnologija implementacije jednostavna, ispitana od strane tisuća tvrtki. Milijuni poslužitelja se upravo tako implementiraju. Teško je nešto pokvariti.
- I konačno, mogli smo dobiti atomsku implementaciju. Implementacije koje se korisnicima događaju trenutačno, bez uočljivog koraka prebacivanja između stare i nove verzije.
No u svemu tome također smo vidjeli nekoliko nedostataka:
- Osim produkcijskog okruženja, postoji i okruženje za razvoj, kao i druga okruženja. Na primjer, QA i predprodukcija. U tom trenutku imali smo mnogo poslužitelja i oko 60 servisa. Iz tog razloga smo morali za svaki servis održavati ažuriranu verziju virtualne mašine. Ako želite ažurirati biblioteke ili instalirati nove ovisnosti, morate to učiniti u svim okruženjima. Također je bilo potrebno uskladiti vrijeme kada planirate implementirati novu verziju vaše aplikacije s vremenom kada devops izvrši potrebne postavke okruženja. U tom slučaju lako možete završiti u situaciji gdje se okruženja malo razlikuju odmah u svim okruženjima. Na primjer, u QA okruženju bit će jedne verzije biblioteka, a u produkciji druge, što može dovesti do problema.
- Kompleksnost u ažuriranju ovisnosti vaše aplikacije. Ovo ne zavisi od vas, već od drugog tima. Naime, od devops tima koji održava poslužitelje. Morate im postaviti odgovarajući zadatak i dati opis onoga što želite učiniti.
- U to vrijeme smo također htjeli podijeliti naše velike monolite na manje usluge, kako bismo shvatili da će ih vjerojatno biti sve više. Tada smo već imali više od 100 njih. Za svaku novu uslugu trebalo je kreirati novu virtualnu mašinu koju je također trebalo održavati i postavljati. Osim toga, bila je potrebna najmanje jedna druga mašina. Tome je dodatno trebala i QA okolina. To uzrokuje probleme i čini stvaranje i pokretanje novih sustava za vas kompliniranim, skupim i dugotrajnim procesom. Zbog toga smo odlučili da će biti lakše preći s postavljanja običnih virtualnih mašina na postavljanje naših aplikacija u docker kontejnerima. Uz docker, potrebna je i sustav koji može pokrenuti aplikacije u klasteru, jer jednostavno ne možete pokrenuti kontejner samo tako. Obično želite pratiti koliko je kontejnera pokrenuto, tako da se pokreću automatski. Iz tog razloga trebali smo odabrati sustav upravljanja.
Dugo smo razmišljali o tome koju od njih uzeti. Činjenica je da je tada ovaj stak od običnih virtualnih servera bio pomalo zastario, jer su tu bile starije verzije operativnih sustava. U nekom trenutku je čak bila instalirana FreeBSD, koja nije bila baš jednostavna za održavanje. Razumjeli smo da moramo što brže migrirati u docker. Naši DevOps su pogledali svoje iskustvo s različitim rješenjima i odabrali sustav poput Nomada.
Prijelaz na Nomad
Nomad je proizvod tvrtke “HashiCorp”. Oni su poznati i po drugim svojim rješenjima:
«Consul»
— to je sredstvo za otkrivanje usluga. «Terraform»
— sustav za upravljanje serverima koji vam omogućuje da ih postavite putem konfiguracije, poznate kao infrastructure-as-code. «Vagrant»
omogućuje vam postavljanje virtualnih mašina lokalno ili u oblaku putem određenih konfiguracijskih datoteka. Nomad se tada činio kao dovoljno jednostavno rješenje na koje se može brzo preći bez promjene cijele infrastrukture. Osim toga, dovoljno je lako za naučiti. Stoga je upravo njega izabran kao sustav filtriranja našeg kontejnera.
Što vam je potrebno da uopće postavite svoj sustav u Nomad?
Prije svega, potreban vam je
- docker image docker slika aplikacije. Potrebno ga je izraditi i smjestiti u spremište slika docker. U našem slučaju to je artifactory — sustav koji omogućava puštanje raznih artefakata različitih tipova. Može pohraniti arhive, docker slike, PHP composer pakete, NPM pakete i tako dalje.
- Također je potrebno konfiguracijske datoteke, koji će reći Nomadu što, gdje i u kojim količinama želite deployati.
Kada govorimo o Nomadu, kao format informacijske datoteke koristi HCL jezik, što je skraćenica za HashiCorp Configuration Language. To je nadmnoštvo Yaml-a, koje vam omogućava da opišete svoju uslugu u terminima Nomada.
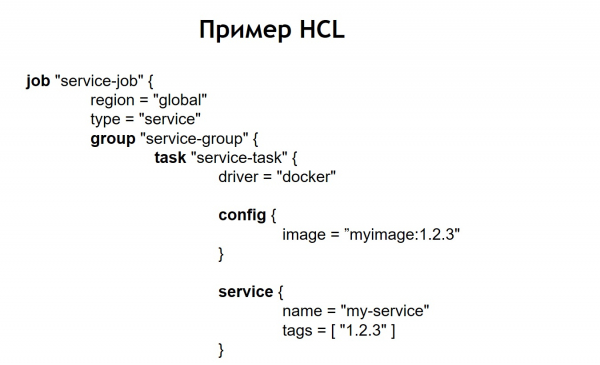
Omogućava vam da navedete koliko kontejnera želite deployati, iz kojih slika im proslijedite razne parametre pri deployanju. Na taj način, alimentirate ovu datoteku Nomadu, a on pokreće kontejneru u produkciji prema njoj.
U našem slučaju shvatili smo da bi bilo nepraktično pisati potpuno iste, identične HCL datoteke za svaku uslugu, jer ih ima puno i ponekad ih želite ažurirati. Ponekad se dogodi da jedna usluga nije deployana u jednom primjerku, već u više varijanti. Na primjer, jedan od sustava koji imamo u produkciji ima više od 100 instanci u produkciji. Pokreću se iz istih slika, ali se razlikuju po konfiguracijskim postavkama i datotekama.
Stoga smo odlučili da će nam biti zgodno pohraniti sve naše konfiguracijske datoteke za deploy u jednom zajedničkom repozitoriju. Na taj način postaju pregledne: lako ih je održavati i možete vidjeti koje sustave imamo. U slučaju potrebe također nije teško nešto ažurirati ili promijeniti. Dodavanje novog sustava također neće biti problem — dovoljno je jednostavno stvoriti konfiguracijsku datoteku unutar novog direktorija. Unutar tog direktorija nalaze se datoteke: service.hcl, koja sadrži opis naše usluge i neki env-datoteke, koje omogućavaju da se ta usluga, nakon deployanja u produkciju, konfigurira.
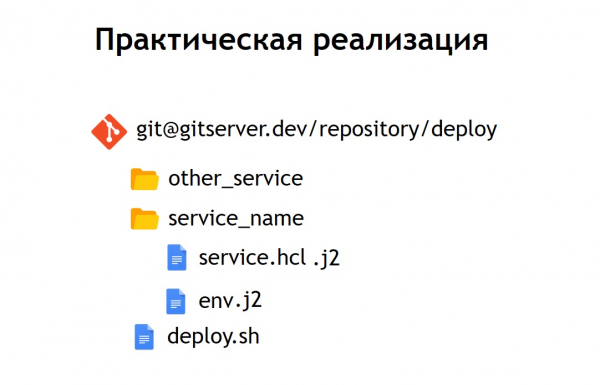
Međutim, neke naše usluge nisu deployane u produkciji u jednom primjerku, već u više odjednom. Zato smo odlučili da će nam biti praktično pohranjivati ih ne u čistom obliku, već u šabloniziranom obliku. Kao jezik šablonizacije odabrali smo jinja 2. U tom formatu čuvamo kako konfiguracije samog servisa, tako i env datoteke potrebne za njega.
Osim toga, stavili smo u repozitorij zajednički skript za implementaciju koji omogućava pokretanje i implementaciju vašeg servisa u produkciji, u potrebnom okruženju, u ciljanom odredištu. Kada smo pretvorili naš HCL konfiguraciju u predložak, ta HCL datoteka, koja je prije bila obična Nomad konfiguracija, sada izgleda malo drugačije.
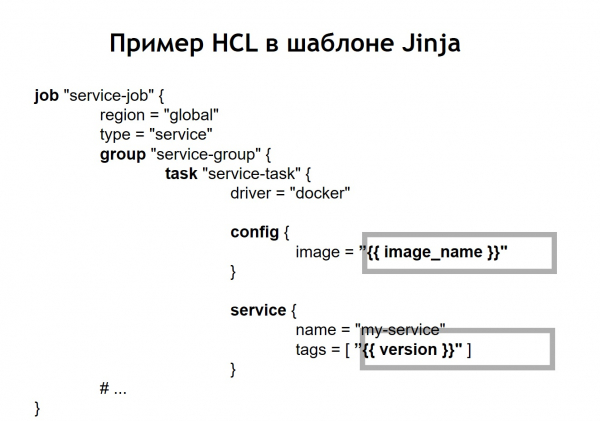
Odnosno, zamijenili smo neka mjesta s promenjivim u konfiguraciji s umetanjima promenjivih koje se uzimaju iz env datoteka ili drugih izvora. Osim toga, dobili smo mogućnost dinamičkog generisanja HCL datoteka, što znači da možemo primenjivati ne samo obična umetanja promenjivih. Budući da jinja podržava petlje i uslove, takođe možemo kreirati konfiguracijske datoteke koje se menjaju u zavisnosti od toga gde tačno implementirate svoje aplikacije.
Na primjer, želite implementirati svoj servis u preprodukciji i u produkciji. Recimo da u preprodukciji ne želite pokretati cron skripte, već samo želite videti servis na odvojenoj domeni, kako biste se uverili da funkcioniše. Za svakoga ko implementira servis, proces izgleda vrlo jednostavno i jasno. Potrebno je samo izvršiti datoteku deploy.sh, navesti koji servis želite implementirati i u koje odredište. Na primjer, želite implementirati neku sistemu u Rusiju, Belorusiju ili Kazahstan. Za to je dovoljno samo promijeniti jedan od parametara, i dobićete ispravnu konfiguracijsku datoteku.
Kada je Nomad servis već implementiran u vašem klasteru, izgleda ovako.
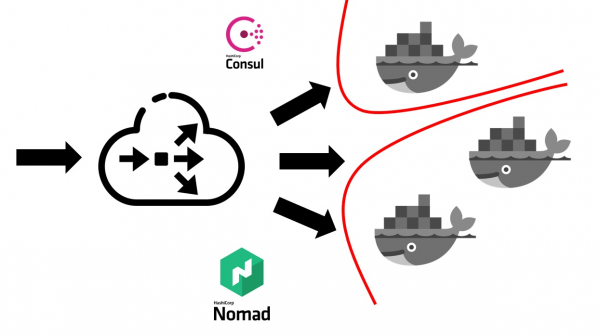
Za početak, potreban vam je neki balancer izvana koji će primati sav korisnički promet. On će raditi zajedno s Consulom i saznati od njega gde se, na kojoj nodi, po kojem IP-adresu se nalazi određeni servis koji odgovara nekom domenskom imenu. Servisi u Consulu pojavljuju se iz samog Nomada. Budući da su to proizvodi iste kompanije, međusobno su prilično povezani. Možemo reći da Nomad iz kutije može registrovati sve servise pokrenute unutar Consula.
Nakon što vaš vanjski balancer sazna kojem servisu treba preusmjeriti promet, preusmjerava ga u odgovarajući kontejner ili u više kontejnera koji odgovaraju vašoj aplikaciji. Naravno, potrebno je razmišljati i o sigurnosti. Iako se svi servisi pokreću na istim virtualnim strojevima unutar kontejnera, obično je potrebno zabraniti slobodan pristup iz bilo kojeg servisa drugom. To smo postigli segmentacijom. Svaki servis pokretan je u svojoj virtualnoj mreži, na kojoj su postavljena pravila usmjeravanja i pravila dopuštanja/zabranjivanja pristupa drugim sustavima i servisima. Oni su mogli biti unutar ovog klastera ili izvan njega. Na primjer, ako želite zabraniti servisu da se poveže s određenom bazom podataka, to možete postići segmentacijom na razini mreže. To znači da čak ni greškom ne možete slučajno povezati iz testnog okruženja na vašu produkcijsku bazu.
Koliko nas je koštao proces prelaska u smislu ljudskih resursa?
Prelazak cijele kompanije na Nomad trajao je otprilike 5-6 mjeseci. Prelazili smo uslugu po uslugu, ali prilično brzim tempom. Svaki tim trebao je stvoriti vlastite kontejneri za usluge.
Kod nas je usvojen pristup u kojem svaka ekipa samostalno odgovara za docker slike svojih sustava. DevOps pružaju zajedničku infrastrukturu potrebnu za implementaciju, tj. podršku samom klasteru, podršku CI sustavu i tako dalje. U to vrijeme više od 60 sustava prešlo je na Nomad, što je rezultiralo s oko 2000 kontejnera.
DevOps odgovara za zajedničku infrastrukturu svega što je vezano uz implementaciju, s poslužiteljima. Svaka razvojna ekipa, s druge strane, odgovara za realizaciju kontejnera za svoj konkretni sustav, budući da samo tim zna što im je zapravo potrebno u tom ili onom kontejneru.
Razlozi za napuštanje Nomada
Koje smo prednosti dobili prelaskom na implementaciju pomoću Nomada i dockera?
- Mi osigurali jednake uvjete za sve okruženja. U razvoju, QA okruženju, predprodukciji i produkciji koriste se isti kontejnerski obrasci sa istim zavisnostima. Stoga imate gotovo nula šanse da u produkciju stigne nešto što niste prethodno testirali lokalno ili u testnom okruženju.
- Također smo otkrili da je dovoljno lako dodati novu uslugu. Bilo koji novi sistemi s aspekta implementacije pokreću se vrlo jednostavno. Dovoljno je otići u repozitorij koji sadrži konfiguracije, dodati još jednu konfiguraciju za vaš sistem i sve je spremno. Možete implementirati vaš sistem u produkciju bez dodatnog napora od devops-a.
- Sve konfiguracijske datoteke u jednom zajedničkom repozitoriju bile su pregledne. U trenutku kada smo implementirali naše sisteme pomoću virtualnih servera, koristili smo Ansible, gdje su konfiguracije bile u istom repozitoriju. Međutim, za većinu programera, raditi s tim je bilo malo teže. Ovde je volumen konfiguracija i koda koji trebate dodati da biste implementirali uslugu značajno smanjen. Također, za devops je vrlo lako popraviti ili promeniti to. U slučaju prijelaza, na primer, na novu verziju Nomad-a, mogu masovno ažurirati sve operativne datoteke koje se nalaze na istom mestu.
Ali smo se također suočili s nekim nedostacima:
Ispostavilo se da nismo uspjeli postići bezšavne implementacije u slučaju Nomad-a. Prilikom puštanja kontejnera iz različitih okruženja moglo se desiti da je on bio pokrenut i Nomad ga je prepoznavao kao spremnog za primanje saobraćaja. To se događalo još pre nego što se aplikacija unutar njega uspela pokrenuti. Iz tog razloga je sistem tokom kratkog perioda počeo davati 500 greške, jer je saobraćaj počeo da ide na kontejner koji još nije bio spreman da ga primi.
Suočili smo se sa nekim greškamaNajveća greška je u tome što Nomad ne može dobro upravljati velikim klasterima, posebno ako imate mnogo sustava i kontejnera. Kada želite staviti jedan od servera u održavanje koji je uključen u Nomad klaster, postoji velika vjerojatnost da će klaster početi loše reagirati i raspasti se. Neki kontejneri mogu, na primjer, pasti i nisu u mogućnosti da se ponovno pokrenu—to će vas kasnije koštati mnogo, ako su svi vaši sustavi u produkciji unutar klastera upravljanog Nomadom.
Zbog toga smo odlučili razmisliti o tome kuda dalje ići. Tada smo već puno bolje razumjeli što želimo postići. Naime, želimo pouzdanost, malo više funkcionalnosti nego što nudi Nomad i zreliji, stabilniji sustav.
U tom smislu, naš izbor je pao na Kubernetes kao najpopularniju platformu za pokretanje klastera. Osobito s obzirom na to da je veličina i broj naših kontejnera bili prilično veliki. Za takve ciljeve, Kubernetes se pokazao kao najprikladniji sustav koji smo mogli razmotriti.
Prijelaz na Kubernetes
Malo ću reći o osnovnim konceptima Kubernetesa i kako se razlikuju od Nomada.
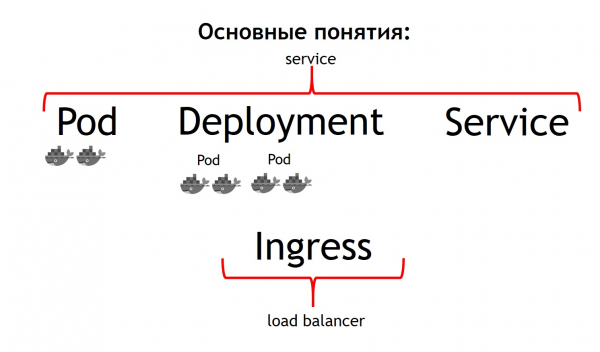
Prvo, osnovni koncept u Kubernetesu je pojam pod. Pod — to je grupa jednog ili više kontejnera koji se uvijek pokreću zajedno. Oni rade kao da su uvijek na jednoj virtualnoj mašini. Imaju međusobnu dostupnost putem IP adrese 127.0.0.1 na različitim portovima.
Pretpostavimo da imate PHP aplikaciju koja se sastoji od nginx i php-fpm — klasična shema. Vjerojatno ćete htjeti da nginx i php-fpm kontejneri uvijek budu zajedno. Kubernetes to omogućuje opisivanjem njih kao jednog zajedničkog poda. Upravo to nismo mogli dobiti pomoću Nomada.
Drugi koncept je deployment. Naime, pod kao takav je efemerna stvar, pokreće se i nestaje. Želite li prvo ubiti sve svoje prethodne kontejnere, a zatim odmah pokrenuti nove verzije, ili ih želite izdavati postupno—za ovaj proces je odgovoran koncept deployment. On opisuje kako implementirate svoje pode, u kojem broju i kako ih ažurirati.
Treći koncept je usluga. Vaš service je zapravo vaš sustav koji prima određeni promet i zatim ga usmjerava na jedan ili više podova koji odgovaraju vašem servisu. To znači da omogućuje slanje cijelog ulaznog prometa na određeni servis s određenim imenom na te konkretne podove. Osim toga, osigurava vam ravnotežu prometa. Možete pokrenuti dva poda svoje aplikacije i cijeli ulazni promet će se ravnomjerno rasporediti između povezanih podova ovog servisa.
I četvrti osnovni pojam — Ingress. To je servis koji se pokreće u Kubernetes klasteru. On djeluje kao vanjski balansirnik opterećenja koji preuzima sve zahtjeve. Zahvaljujući API-ju Kubernetes Ingress može odrediti kamo treba poslati te zahtjeve. A to čini vrlo fleksibilno. Možete reći da sve zahtjeve za ovaj host i određeni URL šaljete na ovaj servis. A te zahtjeve koji dolaze na ovaj host i drugi URL šaljemo na drugi servis.
Najbolje u pogledu onoga tko razvija aplikaciju je to što možete sami upravljati tim svime. Definiranjem Ingress konfiguracije, možete cijeli promet koji dolazi na određeni API slati na posebne kontejnere, na primjer, one napisane u Go-u. A ovaj promet, koji dolazi na istu domenu, ali na drugi URL, slati na kontejnere napisane u PHP-u, gdje ima puno logike, ali nisu baš brzi.
Ako usporedimo sve ove pojmove s Nomad-om, možemo reći da su prva tri pojma zajedno Service. A posljednji pojam u Nomad-u ne postoji. Umjesto toga, koristili smo vanjski balansirnik: to može biti haproxy, nginx, nginx+ i slično. U slučaju Kubernetesa ne morate uvesti ovaj dodatni pojam odvojeno. Međutim, ako pogledate Ingress iznutra, to može biti ili nginx, ili haproxy, ili traefik, ali kao da je ugrađen u Kubernetes.
Svi pojmovi koje sam opisao su, u suštini, resursi koji postoje unutar Kubernetes klastera. Za njihovo opisivanje u klasteru koriste se yaml-format, koji je čitljiviji i poznatiji od HCL datoteka u slučaju Nomada. Ali strukturno opisuju, primjerice, pod isto to. Kažu — želim deploy-ati takve podove ondje, s takvim slikama, u takvom broju.
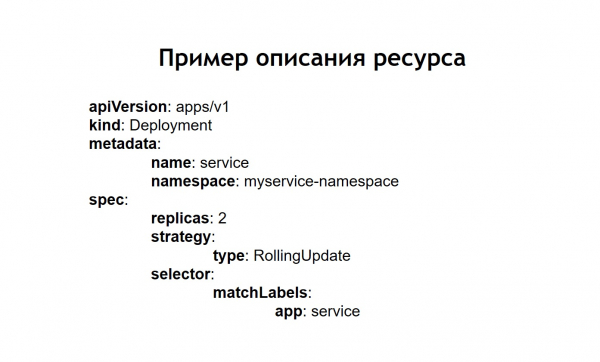
Osim toga, shvatili smo da ne želimo ručno kreirati svaki pojedinačni resurs: deployment, servise, Ingress i slično. Umjesto toga, željeli smo pri deployu opisati svaki naš sustav u terminima Kubernetesa, kako ne bismo morali ručno ponovo kreirati sve potrebne zavisnosti resursa u pravom redoslijedu. Kao takav sustav, koji nam je omogućio to, odabran je Helm.
Osnovni pojmovi u Helmu
Helm – to je menadžer paketa za Kubernetes. Vrlo je sličan tome kako rade upravitelji paketa u programskim jezicima. Omogućuje vam pohranu servisa, koji se sastoji, na primjer, od deploymenta nginx-a, deploymenta php-fpm-a, konfiguracije za Ingress, configmaps (to je entitet koji vam omogućuje definiranje env i drugih parametara za vaš sustav) u obliku takozvanih chartova. Pri tome Helm radi iznad Kubernetesa. Dakle, to nije neka sustav koja stoji sa strane, već jednostavno još jedan servis koji se pokreće unutar klastera. Komunicirate s njim putem njegovog API-ja kroz konzolnu naredbu. Njegova pogodnost i ljepota leže u tome što, čak i ako se helm pokvari ili ga izbrišete iz klastera, vaši servisi neće nestati, jer helm služi u suštini samo za pokretanje sustava. Za funkcionalnost i stanje servisa dalje odgovara sam Kubernetes.
Također smo shvatili da templating, koju smo ranije bili prisiljeni raditi sami putem ugrađivanja jinj-a u naše konfiguracije, predstavlja jednu od glavnih mogućnosti helma. Sve konfiguracije koje stvarate za vaše sustave pohranjuju se u helmu u obliku predložaka, koji su malo slični jinja, ali zapravo koriste templating jezika Go, na kojem je helm napisan, kao i Kubernetes.
Helm nam dodaje još nekoliko dodatnih pojmova.
Chart — to je opis vašeg servisa. U drugim upraviteljima paketa nazvali bi ga paketom, bundleom ili nečim sličnim. Ovdje se to naziva chart.
Values – to su varijable koje želite koristiti za sastavljanje vaših konfiguracija iz predložaka.
ObjavaSvaki put kada se usluga koja se implementira pomoću helma ažurira, dobiva inkrementalnu verziju izdanja. Helm pamti kakva je bila konfiguracija usluge pri prethodnim izdanjima. Stoga, ako je potrebno vratiti se, dovoljno je izvršiti naredbu helm rollback, navodeći prethodnu verziju izdanja. Čak i ako u trenutku vraćanja odgovarajuća konfiguracija u vašem repozitoriju nije dostupna, helm se i dalje sjeća kakva je ona bila i vratit će vaš sustav u stanje u kojem je bio pri prethodnom izdanju.
Kada koristimo helm, obične konfiguracije za Kubernetes također postaju predlošci u kojima možete koristiti varijable, funkcije i primjenjivati uvjetne operatore. Na taj način možete sastaviti konfiguraciju vaše usluge ovisno o okruženju.
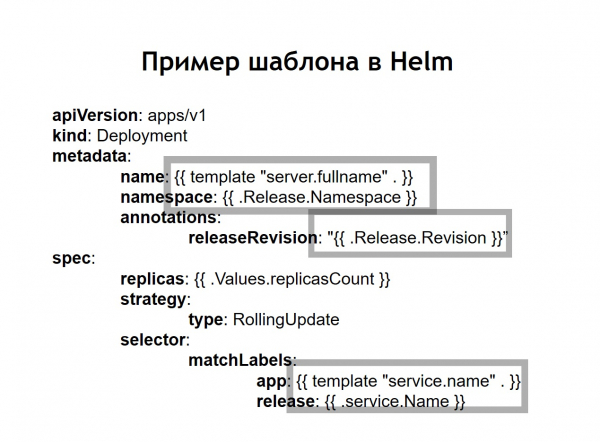
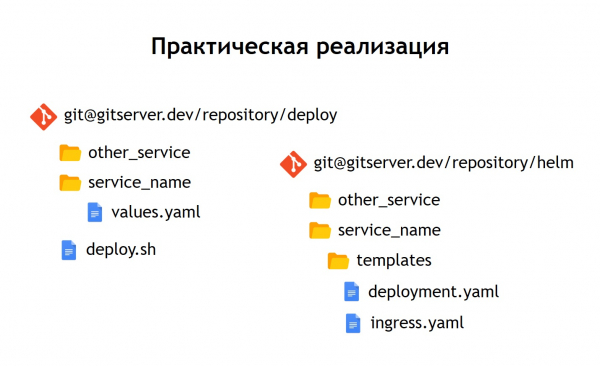
U praksi smo odlučili postupiti malo drugačije nego smo to radili s Nomadom. Ako su u Nomadu u jednom repozitoriju bile pohranjene i konfiguracije za implementaciju, te n-varijable potrebne za implementaciju naše usluge, ovdje smo odlučili podijeliti ih na dva različita repozitorija. U repozitoriju „deploy“ pohranjuju se samo n-varijable potrebne za implementaciju, dok su u repozitoriju „helm“ pohranjene konfiguracije ili chartovi.
Što nam je to donijelo?
Iako u samim konfiguracijskim datotekama ne pohranjujemo neke zaista osjetljive podatke, poput lozinki za baze podataka. One se pohranjuju kao tajne u Kubernetesu, no ipak postoje posebne stvari kojima ne želimo dati pristup svima. Stoga je pristup repozitoriju „deploy“ više ograničen, a repozitorij „helm“ sadrži samo opis usluge. Iz tog razloga mu se može sigurno osigurati pristup širem krugu osoba.
Budući da imamo ne samo produkcijsko, nego i druga okruženja, zahvaljujući ovakvom razdvajanju možemo ponovno koristiti naše helm-chartove za implementaciju usluga ne samo u produkciji, nego i, na primjer, u QA-okruženju. Čak i za lokalno pokretanje koristeći Minikube — to je stvar za lokalno pokretanje Kubernetesa.
Unutar svake repozitorija ostavili smo razdvajanje na posebne direktorije za svaku uslugu. To jest, unutar svake direktorije nalaze se predlošci koji se odnose na odgovarajući chart i opisuju resurse koje je potrebno implementirati za pokretanje našeg sustava. U repozitoriju 'deploy' ostavili smo samo env datoteke. U ovom slučaju nismo koristili templating putem jinja, jer helm sam po sebi nudi templating funkcionalnost već u osnovi – to je jedna od njegovih ključnih značajki.
Ostavili smo skriptu za implementaciju – deploy.sh, koja pojednostavljuje i standardizira pokretanje za implementaciju putem helma. Tako, za bilo koga tko želi implementirati, sučelje implementacije izgleda točno onako kao što je bilo u slučaju implementacije putem Nomada. Isti deploy.sh, naziv vaše usluge i mjesto na koje je želite implementirati. To dovodi do toga da se unutar pokreće helm. On zauzvrat prikuplja konfiguracije iz predložaka, ubacuje potrebne values datoteke, a zatim implementira, prosljeđujući ih u Kubernetes.
Zaključci
Kubernetes usluga izgleda složenije nego Nomad.
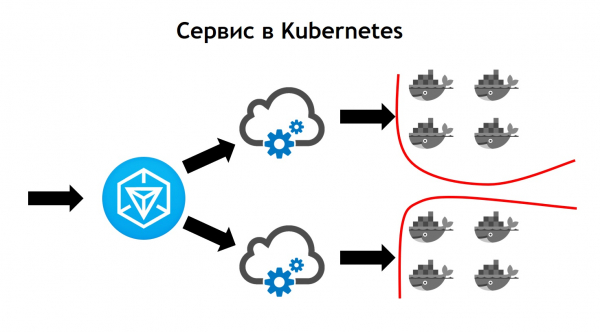
Ovdje izlazni promet dolazi u Ingress. To je upravo front-kontroler koji preuzima sve zahtjeve i potom ih šalje odgovarajućim uslugama na temelju zahtjeva. Određuje ih na osnovu konfiguracija, koje su dio opisa vaše aplikacije u helmu i koje programeri postavljaju samostalno. Usluga zatim šalje zahtjeve na svoje podove, tj. konkretne kontejnere, balansirajući ulazni promet između svih kontejnera koji pripadaju toj usluzi. I, naravno, ne smijemo zaboraviti da, kada je riječ o sigurnosti na razini mreže, ne trebamo nikamo odlaziti. Stoga se u Kubernetes klasteru provodi segmentacija koja se temelji na označavanju. Sve usluge imaju određene oznake, kojima su pridružena prava pristupa tim ili onim vanjskim/unutarnjim resursima unutar ili izvan klastera.
Prilikom prelaska, primijetili smo da Kubernetes ima sve mogućnosti koje je imao Nomad, koji smo ranije koristili, a također dodaje mnogo novog. Može se proširiti putem plugina, kao i kroz prilagođene tipove resursa. To znači da imate mogućnost ne samo koristiti nešto što dolazi s Kubernetesom, već i kreirati vlastiti resurs i servis koji će čitati taj resurs. To pruža dodatne mogućnosti za proširenje vašeg sustava bez potrebe za reinstaliranjem Kubernetesa ili promjenama.
Primjer takve upotrebe je Prometheus, koji se pokreće unutar našeg Kubernetes klastera. Da bi počeo prikupljati metrike s određenog servisa, moramo dodati dodatni tip resursa u opis servisa, takozvani servis-monitor. Prometheus, zbog svoje sposobnosti da čita prilagođene tipove resursa dok se pokreće u Kubernetesu, automatski počinje prikupljati metrike iz novog sustava. To je vrlo praktično.
Prvi deploy koji smo napravili u Kubernetesu bio je u ožujku 2018. I tijekom tog vremena nikada nismo imali problema s njim. Dovoljno stabilno radi bez značajnih grešaka. Osim toga, možemo ga dalje proširivati. Za sada, možemo reći da nam njegove mogućnosti odgovaraju, a tempo razvoja Kubernetesa nam se jako sviđa. Trenutno se više od 3000 kontejnera nalazi u Kubernetesu. Klaster se sastoji od nekoliko Node-a. Ujedno je održavan, stabilan i vrlo kontroliran.
Izvor: habr.com
