

Sviđa vam se petak! Sve je manje vremena do početka tečaja , pa danas dijelimo prijevod još jednog korisnog materijala na ovu temu.
U procesu razvoja obavljeno je impresivno poboljšanje sekcioniranja tablica. Sekcioniranje tablica je funkcija koja postoji u PostgreSQL dovoljno dugo, ali, ako to možemo reći, praktički nije postojala do verzije 10, u kojoj je postala vrlo korisna funkcija. Ranije smo tvrdili da su naslijeđene tablice naša implementacija sekcioniranja, i to je istina. Samo je ovaj način tjerao raditi veći dio posla ručno. Na primjer, ako ste željeli da se tupke umetnu u sekcije tijekom INSERT-a, morali ste postaviti okidače da to učine umjesto vas. Sekcioniranje putem nasljeđivanja bilo je vrlo sporo i složeno za razvoj dodatnih funkcija preko njega.
U PostgreSQL 10 svjedočili smo rođenju „deklarativnog sekcioniranja” — funkcije koja je namijenjena rješavanju mnogih problema koji su bili nerazriješeni korištenjem starog nasljeđivanja. To je dovelo do pojave mnogo moćnijeg alata koji nam omogućava horizontalnu podjelu podataka!
Usporedba značajki
U PostgreSQL 11 pojavio se impresivan skup novih značajki koje pomažu povećati učinkovitost i učiniti sekcionirane tablice transparentnijima za aplikacije.
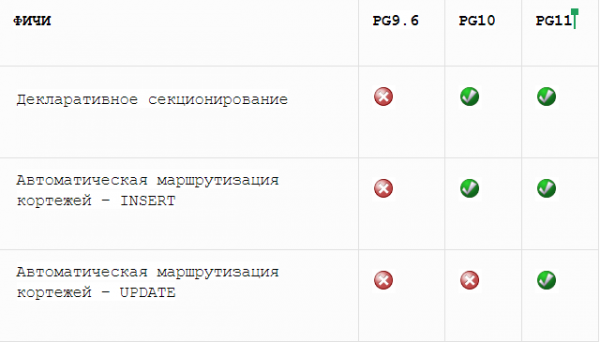
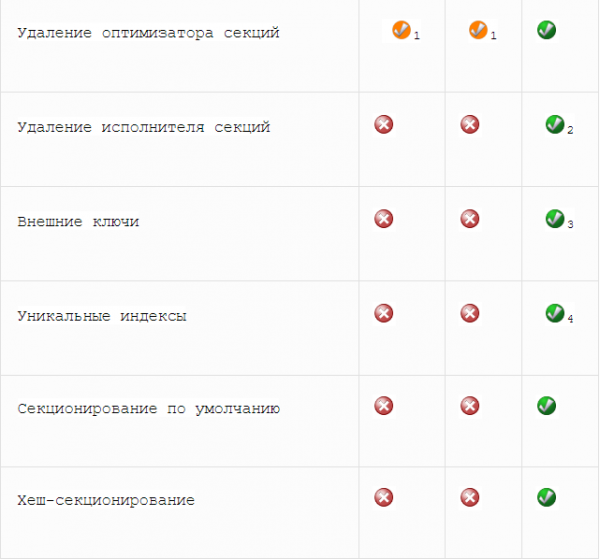
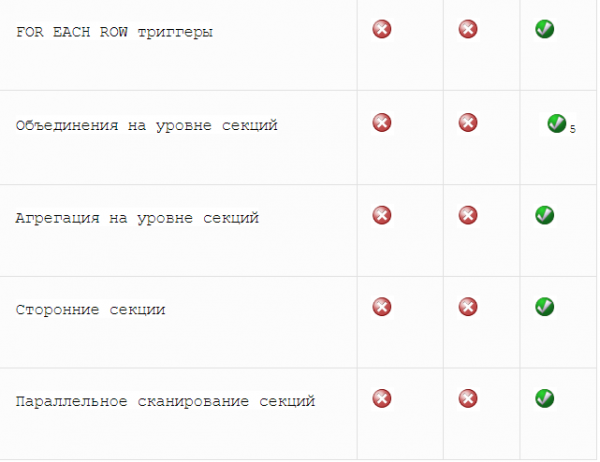
1. Korištenje ograničavajućih iznimaka
2. Dodaje samo čvorove
3. Samo za sekcioniranu tablicu koja se referira na nesectioniranu
4. Indeksi moraju sadržavati sve ključne stupce sekcije
5. Ograničenja na sekciji s obje strane moraju se podudarati
Performanse
Ovdje također imamo dobre vijesti! Dodana je nova metoda . Ovaj novi algoritam može odrediti odgovarajuće sekcije pregledavajući uvjet upita GDJE. Prethodni algoritam, s druge strane, provjeravao je svaku sekciju kako bi utvrdio može li ispuniti uvjet GDJE. To je dovelo do dodatnog povećanja vremena planiranja kako se broj sekcija povećava.
U verziji 9.6, s particioniranjem uz nasljeđivanje, usmjeravanje tuplica unutar particije obično se provodilo pisanjem triggerske funkcije koja je sadržavala niz IF izraza za umetanje tuplice u ispravnu particiju. Ove su funkcije mogle biti vrlo spore tijekom izvođenja. S deklarativnim particioniranjem, dodanim u verziji 10, to je postalo znatno brže.
Korištenjem particionirane tablice sa 100 particija, možemo procijeniti performanse učitavanja 10 milijuna redaka u tablicu s 1 BIGINT stupcem i 5 INT stupaca.
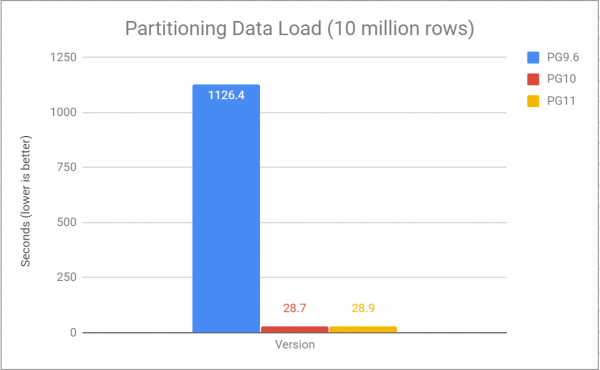
Performanse upita na ovoj tablici za pretraživanje jedne indeksirane stavke i izvršenje DML za manipulaciju jednom stavkom (koristeći samo 1 procesor):
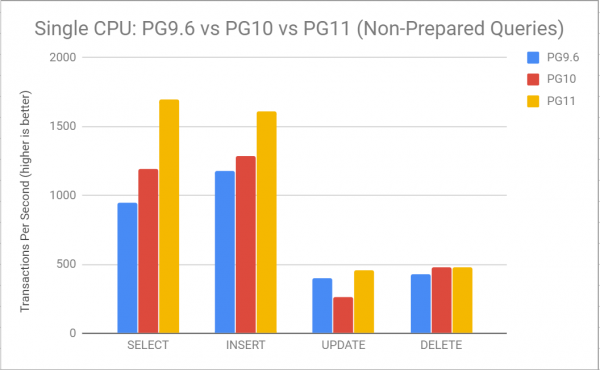
Ovdje vidimo da su performanse svake operacije značajno porasle nakon PG 9.6. Upiti SELECT izgledaju mnogo bolje, posebno oni koji su sposobni isključiti mnoge particije tijekom planiranja upita. To znači da planirnik može preskočiti veći dio posla koji je ranije trebao obaviti. Na primjer, više se ne grade putanje za nepotrebne particije.
Zaključak
Particioniranje tablica počinje postajati vrlo snažna funkcija u PostgreSQL-u. Omogućuje brzo iznošenje podataka online i njihovo prebacivanje u offline, ne čekajući završetak sporih masovnih DML operacija.To također znači da se povezani podaci mogu čuvati zajedno, što omogućuje pristup potrebnim podacima mnogo učinkovitije. Poboljšanja učinjena u ovoj verziji bila bi nemoguća bez programera, recenzenta i komitera koji su neumorno radili na svim ovim značajkama.
Hvala svima njima! PostgreSQL 11 izgleda jednostavno fantastično!
Evo jednog kratkog, ali zanimljivog članka. Podijelite komentare, kao i ne zaboravite se prijaviti na , u okviru kojeg će biti detaljno izložena programa tečaja.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish