

U Linuxu postoji mnogo alata za debuggiranje jezgre i aplikacija. Većina njih negativno utječe na performanse aplikacija i ne može se koristiti u produkciji.
Prije nekoliko godina — eBPF. Omogućava praćenje jezgre i korisničkih aplikacija s niskim prekomjernim troškovima i bez potrebe za ponovnom izradom programa ili učitavanjem vanjskih modula u jezgru.
Sada već postoji mnogo aplikativnih alata koji koriste eBPF, a u ovom članku ćemo razmotriti kako napisati vlastiti alat za profiliranje temeljen na biblioteci . Članak je temeljen na stvarnim događajima. Proći ćemo kroz put od pojave problema do njegovog rješavanja, kako bismo pokazali kako se postojeći alati mogu koristiti u konkretnim situacijama.
Ceph je spor
U Ceph klaster je dodan novi host. Nakon migracije dijela podataka na njega primijetili smo da je brzina obrade zapisničkih zahtjeva na njemu znatno niža nego na drugim poslužiteljima.
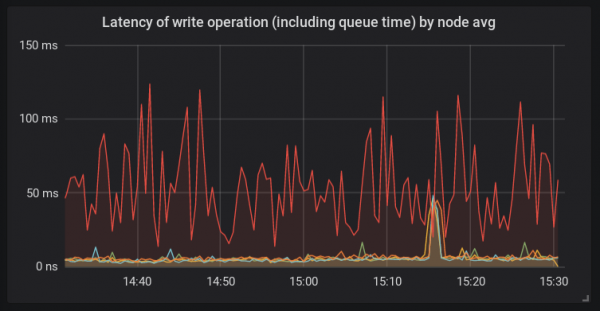
Za razliku od drugih platformi, na ovom hostu korišten je bcache i nova jezgra Linux 4.15. Host takve konfiguracije korišten je ovdje prvi put. I u tom trenutku bilo je jasno da bi problem mogao imati nekoliko korijena.
Istraživanje hosta
Počnimo s time da pogledamo što se događa unutar procesa ceph-osd. Za to ćemo iskoristiti i (više o kojem možete pročitati ):
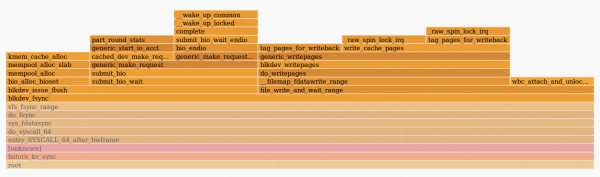
Slika nam govori da je funkcija fdatasync() potrošila puno vremena prilikom slanja zahtjeva u funkciji generic_make_request(). To znači da je vjerojatno uzrok problema negdje izvan samog osd demona. To može biti ili jezgra ili diskovi. Izlaz iostat pokazivao je visoke latencije obrade zahtjeva bcache diskovima.
Pri provjeri hosta otkrili smo da demon systemd-udevd troši mnogo CPU vremena — oko 20% na nekoliko jezgri. Ovo je bizarno ponašanje, pa je potrebno istražiti njegov uzrok. Budući da systemd-udevd radi s ueventima, odlučili smo ih pogledati preko udevadm monitor. Čini se da se generira velika količina change-događaja za svaki blok uređaja u sustavu. To je prilično neobično, pa ćemo morati pogledati što generira sve te događaje.
Korištenje BCC alata
Kao što smo već ustanovili, jezgra (i ceph demon u sistemskom pozivu) troši mnogo vremena u generic_make_request(). Pokušat ćemo izmjeriti brzinu rada ove funkcije. U već postoji izvrsna alatka — funclatency. Tracirat ćemo demon po njegovom PID-u s intervalom između ispisivanja informacija od 1 sekunde i ispisivati rezultat u milisekundama.
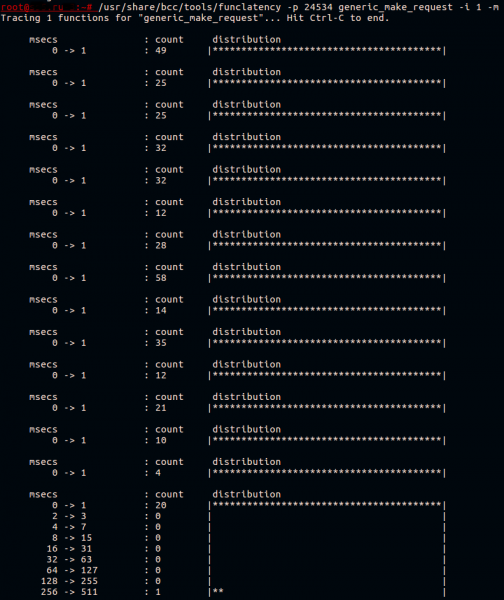
Obično ova funkcija radi brzo. Sve što radi jest da proslijedi zahtjev u red vozača uređaja.
Bcache je složen uređaj koji se zapravo sastoji od tri diska:
- backing device (keširani disk), u ovom slučaju to je spor HDD;
- caching device (keširajući disk), ovdje je to jedna particija NVMe uređaja;
- virtualni uređaj bcache s kojim aplikacija radi.
Znamo da prijenos zahtjeva usporava, ali za koji od ovih uređaja? Riješit ćemo to malo kasnije.
Trenutno znamo da ueventi vjerovatno uzrokuju probleme. Nije jednostavno pronaći što točno uzrokuje njihovu generaciju. Pretpostavimo da je to neki softver koji se pokreće periodički. Pogledajmo koji se softver pokreće u sustavu koristeći skriptu execsnoop iz istog . Pokrenimo ga i usmjerimo izlaz u datoteku.
Na primjer, ovako:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Nećemo ovdje prenositi puni izlaz execsnoop, ali jedan zanimljiv redak izgledao je ovako:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\\^ ([0-9]*) C.*\\1\\'
Treća kolona je PPID (glavni PID) procesa. Proces s PID-om 5802 bio je jedan od niti našeg sustava nadzora. Provjerom konfiguracije sustava nadzora pronađeni su pogrešno postavljeni parametri. Temperatura HBA-adaptera mjerila se svakih 30 sekundi, što je znatno češće nego što je potrebno. Nakon promjene intervala provjere na duži, otkrili smo da je kašnjenje obrade zahtjeva na ovom hostu prestalo biti uočljivo u usporedbi s ostalim hostovima.
Ali još uvijek nije jasno zašto je bcache uređaj toliko usporavao. Pripremili smo testnu platformu s identičnom konfiguracijom i pokušali reproducirati problem pokretanjem fio na bcache, povremeno pokrećući udevadm trigger za generiranje uevents.
Pisanje alata temeljenih na BCC
Pokušat ćemo napisati jednostavnu alatku za traciranje i ispisivanje na ekranu najsporijih poziva generic_make_request(). Također nas zanima naziv diska za koji je ova funkcija pozvana.
Plan je jednostavan:
- Registrujemo kprobe na generic_make_request():
- Spremamo u memoriju ime diska, dostupno kroz argument funkcije;
- Spremamo vremensku oznaku.
- Registrujemo kretprobe na povratku iz generic_make_request():
- Dobivamo trenutni vremenski žig;
- Tražimo spremljeni vremenski žig i uspoređujemo ga s trenutnim;
- Ako je rezultat veći od zadanog, tada pronalazimo spremljeno ime diska i ispisujemo ga na terminal.
Kprobes i kretprobes koriste mehanizam točaka prekida za promjenu koda funkcija u hodu. Možete pročitati i članak o ovoj temi. Ako pogledate kod raznih alata u , možete primijetiti da imaju identičnu strukturu. Stoga ćemo u ovom članku izostaviti parsiranje argumenata skripte i preći na samu BPF program.
Tekst eBPF unutar python skripte izgleda ovako:
bpf_text = """ # Ovdje će biti kod bpf programa """
Za razmjenu podataka između funkcija, eBPF programi koriste . Tako ćemo postupiti i mi. Kao ključ koristi ćemo PID procesa, a kao vrijednost definirati strukturu:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Ovdje registriramo hash tablicu koja se zove p, s ključem tipa u64 i vrijednošću tipa struct data_t. Tablica će biti dostupna u kontekstu našeg BPF programa. Makro BPF_PERF_OUTPUT registrira drugu tablicu, nazvanu events, koja se koristi za u korisnički prostor.
Pri mjerenju kašnjenja između poziva funkcije i povratka iz nje, ili između poziva različitih funkcija, potrebno je uzeti u obzir da dobiveni podaci moraju pripadati jednom kontekstu. Drugim riječima, treba se sjetiti mogućeg paralelnog pokretanja funkcija. Imamo mogućnost izmjeriti kašnjenje između poziva funkcije u kontekstu jednog procesa i povratka iz te funkcije u kontekstu drugog procesa, ali to bi vjerojatno bilo beskorisno. Dobar primjer ovdje može biti , gdje se kao ključ hash tablice postavlja pokazivač na struct request, koja odražava jedan zahtjev za disk.
Dalje, trebamo napisati kod koji će se izvršavati prilikom poziva ispitivane funkcije:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Ovdje će se kao drugi argument umetnuti prvi argument pozvane funkcije . Nakon toga dobijemo PID procesa, u kontekstu kojeg radimo, i trenutačnu vremensku oznaku u nanosekundama. Sve to zapisujemo u sveže dodijeljenu struct data_t data. Ime diska dobijamo iz strukture bio, koja se predaje prilikom poziva generic_make_request(), i spremamo ga u istu strukturu data. Posljednji korak je dodavanje unosa u hash-tablicu, o kojoj smo ranije govorili.
Sljedeća funkcija će se pozvati na povratku iz generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Ova funkcija je slična prethodnoj: saznajemo PID procesa i vremensku oznaku, ali ne alociramo memoriju za novu strukturu data. Umjesto toga, tražimo u hash-tablici postojeću strukturu po ključu == trenutačni PID. Ako je struktura pronađena, saznajemo ime pokrenutog procesa i dodajemo ga u nju.
Binarno pomjeranje, koje ovdje koristimo, potrebno je da dobijemo GID niti, tj. PID glavnog procesa koji je pokrenuo nit, u kontekstu kojeg radimo. Funkcija koju zovemo vraća i GID niti i njen PID u jednoj 64-bitnoj vrijednosti.
Pri ispisu na terminal nas trenutno ne zanima nit, ali nas zanima glavni proces. Nakon usporedbe dobivene latencije s postavljenim praga, predajemo našu strukturu data u korisnički prostor kroz tablicu events, nakon čega brišemo unos iz p.
U Python skripti koja će učitati ovaj kod, potrebno je zamijeniti MIN_US i FACTOR s pragovima latencije i jedinica vremena koje ćemo proslijediti kroz argumente:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Sada trebamo pripremiti BPF program kroz i registrirati uzorke:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Također ćemo morati definirati struct data_t u našem skriptu, inače ništa nećemo moći pročitati:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
Zadnji korak je prikaz podataka na terminalu:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# formatiranje izlaza
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Sam skript je dostupan na . Pokušajmo pokrenuti ga na testnoj platformi gdje je pokrenut fio koji zapisuje na bcache, i pozvati udevadm monitor:
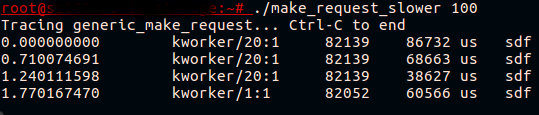
Napokon! Sada vidimo da ono što se činilo kao usporavanje bcache uređaja zapravo je usporavajući poziv generic_make_request() za keširani disk.
Zaronite u Kernel
Što točno usporava tijekom prijenosa zahtjeva? Vidimo da se kašnjenje javlja čak i prije nego što započne evidentiranje zahtjeva, tj. evidentiranje konkretnih zahtjeva za daljnju statistiku (proc/diskstats ili iostat) još nije započelo. Ovo se lako može provjeriti pokretanjem iostat-a tijekom reprodukcije problema, ili , koji se temelji na početku i završetku evidentiranja zahtjeva. Nijedna od ovih alatki neće pokazati probleme za zahtjeve prema keširanom disku.
Ako pogledamo funkciju generic_make_request(), vidjet ćemo da se prije početka evidentiranja zahtjeva pozivaju još dvije funkcije. Prva — generic_make_request_checks(), izvršava provjere zakonitosti zahtjeva u odnosu na postavke diska. Druga — , u kojoj postoji zanimljiv poziv :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
U njemu kernel čeka na odmrzavanje reda. Mjerimo kašnjenje blk_queue_enter():
~# /usr/share/bcc/tools/funclatency blk_queue_enter -i 1 -m
Praćenje 1 funkcije "blk_queue_enter"... Pritisnite Ctrl-C za kraj.

 	msecs           	: broj 	distribucija
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: broj 	distribucija
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: broj 	distribucija
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Čini se da smo blizu rješenja. Funkcije korištene za "zamrzavanje/odmrzavanje" reda su i . Koriste se kada je potrebno promijeniti postavke reda zahtjeva, potencijalno opasne za zahtjeve koji se nalaze u tom redu. Kada se poziva blk_mq_freeze_queue() funkcijom inkrementira se brojač q->mq_freeze_depth. Nakon toga jezgra čeka da se ispražn java red u .
Vrijeme čekanja za čišćenje ovog reda jednako je kašnjenju diska, jer jezgra čeka završetak svih operacija stavljenih u red. Kada se red isprazni, primjene se promjene postavki. Nakon toga poziva se , smanjujući brojač freeze_depth.
Sada znamo dovoljno da ispravimo situaciju. Komanda udevadm trigger rezultira primjenom postavki za blok uređaj. Ove postavke opisane su u pravilima udev. Možemo saznati koje točno postavke „zamrzavaju“ red tako da pokušamo promijeniti ih preko sysfs ili pogledamo izvorni kod jezgre. Također, možemo isprobati BCC alat , koji će na terminal ispisati tragove stoga jezgre i korisničkog prostora za svaki poziv blk_freeze_queue, na primjer:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Udev pravila se rijetko mijenjaju i obično to ide pod kontrolom. Tako vidimo da čak i primjena već zadanih vrijednosti izaziva porast kašnjenja u prijenosu zahtjeva od aplikacije do diska. Naravno, generirati udev događaje kada nema nikakvih promjena u konfiguraciji diskova (na primjer, uređaj nije priključen/isključen) nije najbolja praksa. Ipak, možemo pomoći jezgru da ne obavlja besposlen rad i ne „zamrzava“ red zahtjeva ako za tim nema potrebe. ispravljaju situaciju.
Zaključak
eBPF je vrlo fleksibilan i moćan alat. U članku smo razmotrili jedan praktični slučaj i demonstrirali mali dio onoga što je moguće učiniti. Ako vas zanima razvoj BCC alata, vrijedi pogledati , koja dobro opisuje osnove rada.
Postoje i drugi zanimljivi alati za ispravljanje grešaka i profiliranje, temeljeni na eBPF-u. Jedan od njih je , koji omogućuje pisanje snažnih jednostrukih i malih programa na jeziku sličnom awku. Drugi je , koji omogućuje prikupljanje niskonaponskih metrika visoke razlučivosti izravno na vaš prometheus poslužitelj, s mogućnošću daljnjeg dobijanja lijepe vizualizacije i čak upozorenja.
Izvor: habr.com
