

Pozdrav svima. U ovom članku ću vam reći zašto smo u Avitu prije devet mjeseci odabrali Kafka i što ona zapravo predstavlja. Podijelit ću jedan od slučajeva upotrebe — poslužitelj poruka. Na kraju ćemo razgovarati o tome koje prednosti smo stekli primjenom pristupa Kafka as a Service.
Problem
Za početak malo konteksta. Prije neko vrijeme počeli smo se udaljavati od monolitne arhitekture, a sada u Avitu već imamo nekoliko stotina različitih usluga. Svaka od njih ima svoje skladište, svoj tehnološki okvir i odgovara za svoj dio poslovne logike.
Jedan od problema s velikim brojem usluga je komunikacija. Usluga A često želi saznati informacije koje ima usluga B. U tom slučaju usluga A se obraća usluzi B putem sinkronog API-ja. Usluga C želi znati što se događa kod usluga G i D, a one, zauzvrat, interesiraju usluge A i B. Kada tako 'radoznalih' usluga postane mnogo, veze među njima postaju zamršen splet.
Pri tome, usluga A može u bilo kojem trenutku postati nedostupna. I što u tom slučaju raditi usluzi B i svim ostalim uslugama koje su na nju vezane? A ako je za izvršenje poslovne operacije potrebno napraviti niz uzastopnih sinkronih poziva, vjerojatnost neuspjeha cijele operacije postaje još veća (i veća je što je taj niz dulji).
Izbor tehnologije
U redu, problemi su jasni. Može ih se eliminirati uspostavljanjem centraliziranog sustava razmjene poruka među uslugama. Sada svakoj usluzi dovoljno je samo da zna za ovaj sustav razmjene poruka. U dodatku, sam sustav treba biti otporan na greške i horizontalno skalabilan, a u slučaju kvara akumulirati potrebne zahtjeve za naknadnu obradu.
Sada odaberimo tehnologiju na kojoj će se realizirati dostava poruka. Za to prvo trebamo razumjeti što od nje očekujemo:
- poruke ne smiju biti izgubljene;
- poruke se mogu duplicirati;
- poruke se mogu pohranjivati i čitati u razdoblju od nekoliko dana (postojani spremnik);
- usluge se mogu pretplatiti na podatke koji ih zanimaju;
- više usluga može čitati iste podatke;
- poruke mogu sadržavati detaljan, opsežan payload (event-carried state transfer);
- ponekad je potrebna garancija redoslijeda poruka.
Također, bilo nam je od ključne važnosti odabrati što skalabilniji i pouzdaniji sustav s visokom propusnošću (najmanje 100k poruka po nekoliko kilobajta u sekundi).
U ovoj fazi oprostili smo se od RabbitMQ (teško je održati stabilnim pri visokim rps), PGQ iz SkyTools (nedovoljno brz i loše skalabilan) i NSQ (nepersistentan). Sve ove tehnologije koristimo u našoj tvrtki, ali za zadatak koji smo imali nisu bile prikladne.
Nakon toga, počeli smo gledati nove tehnologije za nas — Apache Kafka, Apache Pulsar i NATS Streaming.
Prvo smo odbacili Pulsar. Odlučili smo da su Kafka i Pulsar prilično slična rješenja. Iako je Pulsar provjeren od strane velikih tvrtki, noviji je i teoretski nudi nižu latenciju, odlučili smo zadržati Kafku kao de facto standard za ove zadatke. Vjerojatno ćemo se u budućnosti vratiti Apache Pulsaru.
I tako su ostala dva kandidata: NATS Streaming i Apache Kafka. Oba rješenja smo detaljno proučili, i oba su se uklapala u zadatak. No na kraju smo se bojali relativne mladosti NATS Streaming (i toga što je jedan od glavnih developera, Tyler Treat, odlučio napustiti projekt i započeti vlastiti — Liftbridge). Uz to, Clustering način rada NATS Streaming nije omogućavao snažno horizontalno skaliranje (vjerojatno to više nije problem nakon uvođenja partitioning režima 2017. godine).
Ipak, NATS Streaming je sjajna tehnologija napisana u Go i ima podršku Cloud Native Computing Foundation. Za razliku od Apache Kafke, ne treba mu Zookeeper za rad (možda, ), jer unutar koristi RAFT. Pritom je NATS Streaming jednostavniji za administraciju. Ne isključujemo mogućnost da se opet vratimo ovoj tehnologiji.
Ipak, naš današnji pobjednik je Apache Kafka. Našim testovima pokazala se dovoljno brza (više od milijun poruka u sekundi pri čitanju i pisanju sa veličinom poruka od 1 kilobajta), dovoljno pouzdana, dobro skalabilna i provjerena iskustvom u proizvodnji od strane velikih tvrtki. Osim toga, Kafka podržava najmanje nekoliko velikih komercijalnih tvrtki (mi, na primjer, koristimo Confluent verziju), a također ima razvijen ekosustav.
Pregled Kafke
Prije nego što počnemo, odmah preporučujem odličnu knjigu — «Kafka: The Definitive Guide» (ima i na ruskom prijevodu, ali termini pomalo zbunjuju). U njemu se može pronaći informacija potrebna za osnovno razumijevanje Kafke i čak nešto više. Sama dokumentacija od Apache i blog od Confluent također su odlično napisani i lako se čitaju.
Dakle, pogledajmo kako Kafka funkcionira iz ptičje perspektive. Osnovna topologija Kafke sastoji se od producer, consumer, broker i zookeeper.
Broker
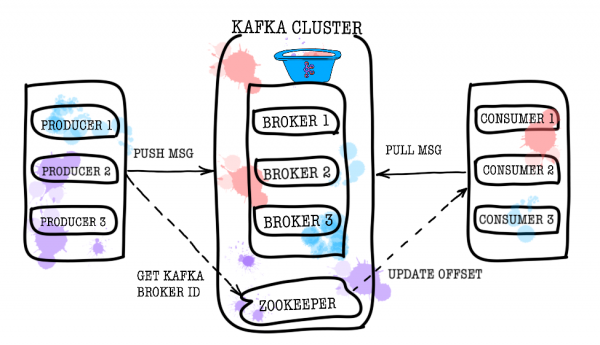
Za pohranu vaših podataka odgovoran je broker. Svi podaci pohranjuju se u binarnom obliku, a broker malo zna o tome što predstavljaju i kakva im je struktura.
Svaki logički tip događaja obično se nalazi u svom zasebnom topiku. Na primjer, događaj stvaranja oglasa može otići u topik item.created, dok događaj njegove promjene ide u item.changed. Topici se mogu smatrati klasifikatorima događaja. Na razini topika mogu se postaviti sljedeći konfiguracijski parametri:
- prostor pohranjenih podataka i/ili njihova starost (retention.bytes, retention.ms);
- faktor redundancije podataka (replication factor);
- maksimalna veličina jedne poruke (max.message.bytes);
- minimalni broj usklađenih replika, pri čemu se podaci mogu zapisati u topik (min.insync.replicas);
- mogućnost prebacivanja na neusaglašenu prošlu repliku s potencijalnim gubitkom podataka (unclean.leader.election.enable);
- i još mnogo drugih ().
S druge strane, svaki topik se dijeli na jednu ili više particija. Upravo u particijama se na kraju nalaze događaji. Ako je u klasteru više od jednog brokera, tada će se particije ravnomjerno rasporediti po svim brokerima (koliko je to moguće), što će omogućiti skaliranje opterećenja za pisanje i čitanje u jedan topik odjednom na nekoliko brokera.
Na disku se podaci za svaku particiju pohranjuju u obliku datoteka segmenata, koji su prema zadanim postavkama jednaki jednom gigabajtu (kontrolira se putem log.segment.bytes). Važna značajka — uklanjanje podataka iz particija (pri aktivaciji retention) događa se upravo segmenatima (ne može se ukloniti jedan događaj iz particije, može se ukloniti samo cijeli segment, i to samo neaktivni).
Zookeeper
Zookeeper djeluje kao skladište metapodataka i koordinator. On može reći jesu li brokeri živi (na ovo se može gledati kroz zookeeper pomoću zookeeper-shell naredbe ls /brokers/ids), koji od brokera je kontroler (get /controller), jesu li particije u sinhronom stanju sa svojim replikama (get /brokers/topics/topic_name/partitions/partition_number/state). Također, upravo će prema zookeeperu prvo ići producer i consumer kako bi saznali na kojem brokeru se nalaze koje teme i particije. U slučajevima kada je za temu postavljen faktor replikacije veći od 1, zookeeper će pokazati koje particije su vođe (u njih će se vršiti zapisivanje i iz njih će se čitati). U slučaju pada brokera, upravo će u zookeeperu biti zabilježene informacije o novim vođama-particijama (od verzije 1.1.0 asinkrono, ).
U starijim verzijama Kafke zookeeper je bio odgovoran i za pohranu ofseta, no sada se oni pohranjuju u posebnu temu __consumer_offsets na brokeru (iako još uvijek možete koristiti zookeeper u te svrhe).
Najjednostavniji način da vaše podatke pretvorite u bundeve je upravo gubitak informacija sa zookeepera. U takvom scenariju bit će jako teško razumjeti što i odakle treba čitati.
Producer
Producer je najčešće servis koji vrši neposredno zapisivanje podataka u Apache Kafku. Producer odabire temu u kojoj će se pohranjivati njegove tematske poruke i počinje zapisivati informacije u nju. Na primjer, producer može biti servis za oglase. U tom slučaju, slat će u tematske teme događaje poput „oglas kreiran“, „oglas ažuriran“, „oglas uklonjen“ i sl. Svaki događaj pritom predstavlja par ključ-vrijednost.
Po defaultu, svi se događaji raspoređuju po particijama teme round-robinom ako ključ nije zadan (gubeći redosljed), a putem MurmurHash (ključ) ako ključ postoji (redoslijed unutar jedne particije).
Ovde odmah treba napomenuti da Kafka garantira redoslijed događaja samo unutar jedne particije. No, zapravo to često nije problem. Na primjer, može se zagarantirati da će se sve promjene jednog te istog oglasa dodavati u jednu particiju (time se čuva redoslijed tih promjena unutar oglasa). Također se može slati redni broj u jednom od polja događaja.
Consumer
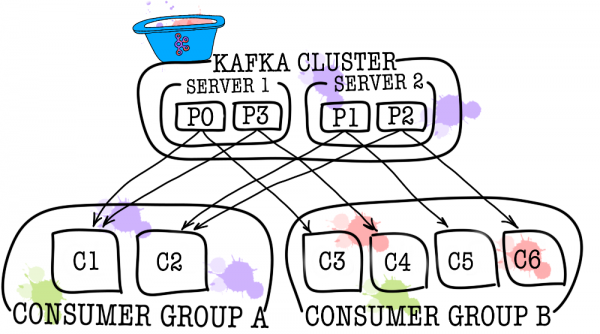
Korisnik je odgovoran za preuzimanje podataka iz Apache Kafke. Ako se vratimo na prethodni primjer, korisnik može biti usluga za moderaciju. Ova usluga će biti pretplaćena na temu usluge oglasa i prilikom pojave novog oglasa primit će ga i analizirati u skladu s određenim zadanim politikama.
Apache Kafka pamti koja su posljednja događanja primili korisnici (za to se koristi pomoćna tema __consumer__offsets), čime se osigurava da prilikom uspješnog čitanja korisnik ne primi istu poruku dva puta. Ipak, ako koristite opciju enable.auto.commit = true i potpuno predate praćenje položaja korisnika Kafki, može doći do . U produkcijskom kodu položaj korisnika se najčešće kontrolira ručno (programer upravlja trenutkom kada se obavezno mora dogoditi commit pročitane poruke).
U slučajevima kada jedan korisnik nije dovoljan (na primjer, kada je pritisak novih događaja vrlo velik), možete dodati još nekoliko korisnika povezivanjem u grupu korisnika. Grupa korisnika logički predstavlja iste korisnike, ali s raspodjelom podataka među članovima grupe. To omogućuje svakom članstvu da preuzme svoj dio poruka, čime se povećava brzina čitanja.
Rezultati testiranja
Ovdje neću pisati mnogo objašnjenja, samo ću podijeliti dobivene rezultate. Testiranje je provedeno na 3 fizičke mašine (12 CPU, 384GB RAM, 15k SAS DISK, 10GBit/s Net), brokeri i zookeeper su implementirani u lxc.
Testiranje performansi
Tijekom testiranja dobiveni su sljedeći rezultati.
- Brzina zapisivanja poruka veličine 1KB s 9 proizvođača istovremeno — 1300000 događaja u sekundi.
- Brzina čitanja poruka veličine 1KB s 9 korisnika istovremeno — 1500000 događaja u sekundi.
Testiranje otpornosti na greške
Tijekom testiranja dobiveni su sljedeći rezultati (3 brokera, 3 zookeepers).
- Nepredviđeno zaustavljanje jednog od brokera ne dovodi do zaustavljanja ili nedostupnosti klastera. Rad se nastavlja u normalnom režimu, ali preostali brokeri imaju veću opterećenost.
- Nepredviđeno isključivanje dva brokera u klasteru od tri brokera s min.isr = 2 dovodi do nedostupnosti klastera za pisanje, ali dostupnosti za čitanje. U slučaju da je min.isr = 1, klaster ostaje dostupan i za čitanje i za pisanje. Ipak, ovaj režim je u suprotnosti s zahtjevom za visokom sigurnošću podataka.
- Nepredviđeno isključivanje jednog od Zookeeper poslužitelja ne dovodi do zaustavljanja ili nedostupnosti klastera. Rad nastavlja teći normalno.
- Nepredviđeno isključivanje dva Zookeeper poslužitelja dovodi do nedostupnosti klastera sve dok se ne obnovi rad barem jednog od Zookeeper poslužitelja. Ova tvrdnja vrijedi za Zookeeper klaster sa 3 poslužitelja. U rezultatu istraživanja odlučeno je povećati Zookeeper klaster na 5 poslužitelja kako bi se povećala otpornost na greške.
Kafka kao usluga
Uvjerili smo se da je Kafka odlična tehnologija koja rješava zadatak koji je pred nama (implementacija poslužitelja poruka). Ipak, odlučili smo zabraniti uslugama izravan pristup Kafki i zatvorili smo je iznad uslugom data-bus. Zašto smo to učinili? Uistinu postoji nekoliko razloga.
Data-bus je preuzeo sve zadatke povezane s integracijom s Kafkom (implementacija i konfiguracija potrošača i proizvođača, nadzor, obavještavanje, bilježenje, skaliranje itd.). Tako se integracija s poslužiteljem poruka odvija maksimalno jednostavno.
Data-bus omogućuje apstrahiranje od specifičnog jezika ili biblioteke za rad s Krakom.
Data-bus omogućuje drugim uslugama da se apstrahiraju od sloja skladištenja. Možda ćemo u nekom trenutku zamijeniti Kafku s Pulsarom, a da to nitko ne primijeti (sve usluge znaju samo za API data-bus).
Data-bus je preuzeo validaciju shema događaja.
Uz pomoć data-bus-a implementirana je autentifikacija.
Pod okriljem data-bus-a možemo bez zastoja, neprimjetno ažurirati verzije Kafke, centralizirano upravljati konfiguracijama proizvođača, potrošača, brokera itd.
Data-bus je omogućio dodavanje potrebnih značajki koje nedostaju u Kafki (poput revizije tema, nadzora anomalija u klasteru, stvaranja DLQ itd.).
Data-bus omogućuje centralizirano upravljanje prebacivanjem svih usluga.
Trenutno je dovoljno povezati mali biblioteku u kod svojeg servisa da biste započeli s slanjem događaja u brokersku uslugu. To je to. Imate mogućnost pisanja, čitanja i skaliranja s jednom linijom koda. Cjela implementacija je skrivena od vas, vani se nalaze samo nekoliko rukohvata tipa veličine paketa. Iza kulisa servis data-bus podiže u Kubernetesu potrebni broj instanci proizvođača i potrošača i daje im potrebnu konfiguraciju, ali sve to je transparentno za vaš servis.
Naravno, ne postoji zlatna sredina, i ovaj pristup ima svoja ograničenja.
- Data-bus se treba održavati vlastitim snagama, za razliku od vanjskih biblioteka.
- Data-bus povećava broj interakcija između servisa i brokerske usluge, što dovodi do smanjenja performansi u odnosu na golu Kafku.
- Nije uvijek jednostavno sakriti sve od servisa, ne želimo duplicirati funkcionalnosti KSQL-a ili Kafka Streams-a u data-bus, stoga ponekad moramo dopustiti servisima da direktno pristupaju.
U našem slučaju, prednosti su prevagnule nad nedostacima, i odluka da zaštitimo brokersku uslugu kao zaseban servis se opravdala. Tijekom godine eksploatacije nismo imali ozbiljnih kvarova ili problema.
P.S. Hvala mojoj djevojci, Ekaterini Obaljajev, za super slike uz ovaj članak. Ako vam se sviđaju, pronaći će se još više ilustracija.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish