

Naletio sam na zanimljiv materijal o umjetnoj inteligenciji u igrama. S objašnjenjem osnovnih stvari o AI kroz jednostavne primjere, a također sadrži mnogo korisnih alata i metoda za njegovu ugodnu razvoj i dizajn. Kako, gdje i kada ih koristiti — također je obuhvaćeno.
Većina primjera je napisana u pseudokodu, tako da duboko znanje programiranja nije potrebno. Ispod su 35 stranica teksta s slikama i GIF-ovima, pa se pripremite.
UPD. Ispričavam se, ali već sam napravio vlastiti prijevod ovog članka na Habr. . Njegovu verziju možete pročitati , ali kao da je članak prošao pored mene (koristio sam pretraživač, ali nešto nije išlo kako treba). A budući da pišem blog posvećen game development-u, odlučio sam ostaviti svoju verziju prijevoda za pretplatnike (neki su mi dijelovi oblikovani drugačije, a neki su namjerno propušteni po savjetu developera).
Što je AI?
Igračka AI fokusira se na to koje radnje objekt treba poduzeti, ovisno o uvjetima u kojima se nalazi. To se obično naziva upravljanjem "inteligenicnim agentima", gdje je agent igraći lik, vozilo, bot, a ponekad i nešto apstraktnije: cijela grupa entiteta ili čak civilizacija. U svakom slučaju, to je stvar koja treba uočiti svoju okolinu, donositi odluke na temelju toga i djelovati u skladu s njima. To se naziva ciklusom Sense/Think/Act (Osjeti/Misli/Djeluj):
- Sense: agent pronalazi ili dobiva informacije o stvarima u svojoj okolini koje mogu utjecati na njegovo ponašanje (prijetnje u blizini, predmeti za prikupljanje, zanimljiva mjesta za istraživanje).
- Think: agent odlučuje kako reagirati (razmatra je li dovoljno sigurno prikupiti predmete ili se prvo treba boriti/skloniti).
- Act: agent poduzima radnje za ostvarenje prethodne odluke (počinje se kretati prema neprijatelju ili predmetu).
- …sada se situacija promijenila zbog radnji likova, pa se ciklus ponavlja s novim podacima.
AI se obično fokusira na dio ciklusa pod nazivom Sense. Na primjer, autonomni automobili snimaju ceste, kombiniraju to s podacima iz radara i lidara te ih tumače. Uglavnom to čini strojno učenje, koje obrađuje ulazne podatke i daje im smisao, izvlačeći semantičke informacije kao što je 'ima još jedan automobil 20 jardi ispred vas'. Ovo su tako zvani problemi klasifikacije.
Igrama nije potreban složen sustav za ekstrakciju informacija, budući da je većina podataka neizostavan dio igre. Nema potrebe pokretati algoritme prepoznavanja slika kako bi se utvrdilo ima li neprijatelj ispred — igra to već zna i prenosi informacije direktno u proces donošenja odluka. Stoga je dio ciklusa Sense često puno jednostavniji od Think i Act.
Ograničenja igrivog AI-a
AI ima niz ograničenja koja se moraju poštovati:
- AI nije potrebno unaprijed trenirati kao da je to algoritam strojnog učenja. Nema smisla pisati neuronsku mrežu tijekom razvoja kako bi se promatralo desetke tisuća igrača i učilo najbolji način igre protiv njih. Zašto? Zato što igra nije objavljena, a igrača nema.
- Igra mora zabavljati i pružati izazov, stoga agenti ne bi smjeli pronalaziti najbolji pristup protiv ljudi.
- Agentima je potrebno izgledati realistično kako bi igrači imali osjećaj da igraju protiv pravih ljudi. Program AlphaGo nadmašio je čovjeka, ali odabrani potezi bili su daleko od tradicionalnog shvaćanja igre. Ako igra imitira ljudskog protivnika, taj osjećaj ne bi trebao postojati. Algoritam treba biti prilagođen kako bi donosio uvjerljive odluke, a ne idealne.
- AI mora djelovati u stvarnom vremenu. To znači da algoritam ne može monopolizirati upotrebu procesora dulje vrijeme za donošenje odluka. Čak i 10 milisekundi za to je predugo, jer većini igara trebaju od 16 do 33 milisekundi da izvrše cijelu obradu i prijeđu na sljedeći okvir grafike.
- Idealno bi bilo da barem dio sustava upravlja podacima, kako bi "neprogrameri" mogli unositi promjene, i kako bi ispravke bile brže.
Pogledajmo pristupe AI-u koji obuhvaćaju cijeli ciklus Sense/Think/Act.
Donositi osnovne odluke
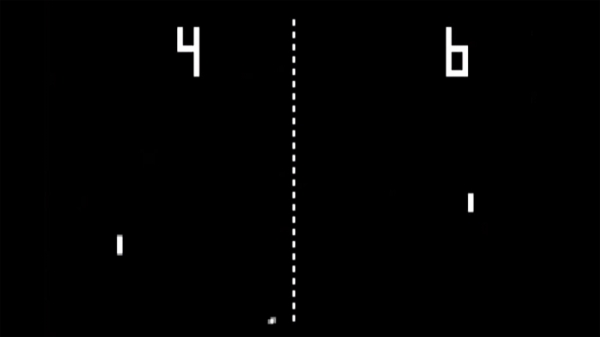
Počnimo s najjednostavnijom igrom - Pong. Cilj: pomaknuti platformu (paddle) tako da se lopta odbija od nje, a ne prolazi pored. To je poput tenisa, u kojem gubite ako ne odbijete loptu. Ovdje je zadatak AI relativno lagan - odlučiti u kojem smjeru pomaknuti platformu.
Uslugovni operatori
Za AI u Pong-u postoji najjasnije rješenje - uvijek pokušavati postaviti platformu ispod lopte.
Jednostavan algoritam za to, napisan u pseudokodu:
svaki okvir/azuriranje dok igra traje:
ako je lopta lijevo od platforme:
pomakni platformu lijevo
inače, ako je lopta desno od platforme:
pomakni platformu desno
Ako se platforma pomiče brzinom lopte, to je idealan algoritam za AI u Pong-u. Nema potrebe za kompliciranjem, ako podataka i mogućih radnji za agenta nema mnogo.
Ovaj pristup je toliko jednostavan da je cijeli ciklus Sense/Think/Act jedva primjetan. No, on postoji:
- Dio Sense nalazi se u dva uslužna operatora if. Igra zna gdje je lopta i gdje je platforma, pa AI dobiva te informacije od nje.
- Dio Think također uključuje dva uslužna operatora if. Oni predstavljaju dva rješenja koja su u ovom slučaju međusobno isključiva. Kao rezultat toga, bira se jedna od tri akcije - pomakni platformu lijevo, pomakni desno, ili ništa ne raditi ako je već ispravno postavljena.
- Dio Act nalazi se u operatorima Move Paddle Left i Move Paddle Right. Ovisno o dizajnu igre, oni mogu pomaknuti platformu trenutno ili s određenom brzinom.
Takvi se pristupi nazivaju reaktivan - postoji jednostavan skup pravila (u ovom slučaju uslužni operatori if u kodu) koji reagiraju na trenutno stanje svijeta i djeluju.
Stablo odluka
Primjer s igrom Pong zapravo odgovara formalnoj konceptu AI, nazvanoj stablo odluka. Algoritam ga prolazi kako bi došao do 'lista' - odluke o tome koju akciju poduzeti.
Izradimo blok dijagram stabla odluka za algoritam naše platforme:
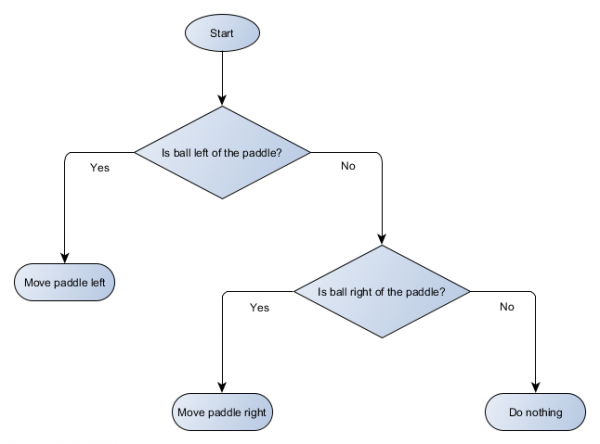
Svaki dio stabla naziva se čvor (node) - AI koristi teoriju grafova za opisivanje sličnih struktura. Postoje dvije vrste čvorova:
- Čvorovi odluka: izbor između dviju alternativa na temelju provjere nekog uvjeta, gdje je svaka alternativa predstavljena kao poseban čvor.
- Konačni čvorovi: akcija koja se izvršava, predstavljajući konačnu odluku.
Algoritam počinje od prvog čvora ('korijena' stabla). On ili donosi odluku o tome kojem podčvoru preći, ili izvršava radnju pohranjenu u čvoru, i završava.
Koje je onda prednosti, ako stablo odluka obavlja istu funkciju kao if-operatori u prethodnom dijelu? Postoji opći sustav gdje svaka odluka ima samo jedan uvjet i dva moguća rezultata. To omogućuje programeru da iz podataka koji predstavljaju odluke u stablu kreira AI, izbjegavajući njegovo hardkodiranje. Prikažimo to u obliku tablice:
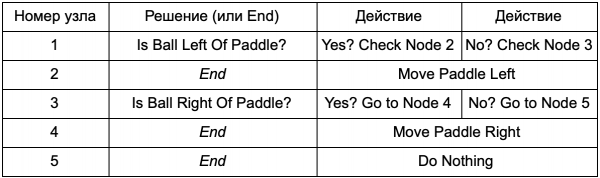
Na strani koda dobit ćete sustav za čitanje redaka. Kreirajte čvor za svaki od njih, povežite logiku donošenja odluka temeljenu na drugom stupcu i podčvorove na temelju trećeg i četvrtog stupca. Još uvijek trebate programirati uvjete i radnje, ali sada će struktura igre biti složenija. U nju dodajete dodatne odluke i radnje, a potom prilagođavate cijeli AI jednostavno uređujući tekstualnu datoteku s definicijom stabla. Kasnije predajete datoteku game designeru, koji može promijeniti ponašanje bez rekompilacije igre i promjene koda.
Stabla odluka su izuzetno korisna kada se automatski grade na temelju velikog skupa primjera (na primjer, koristeći ID3 algoritam). To ih čini učinkovitim i visokoučinkovitim alatom za klasifikaciju situacija na temelju prikupljenih podataka. Međutim, prelazimo s jednostavnog sustava za odabir radnji agenata.
Skripte
Proučili smo sustav stabla odluka koji je koristio unaprijed stvorene uvjete i radnje. Osoba koja dizajnira AI može organizirati stablo onako kako želi, ali se još uvijek mora oslanjati na programera koji je to sve programirao. Što ako bismo mogli dati dizajneru alate za kreiranje vlastitih uvjeta ili radnji?
Da programer ne bi morao pisati kod za uvjete Is Ball Left Of Paddle i Is Ball Right Of Paddle, može stvoriti sustav u kojem će dizajner zapisivati uvjete za provjeru ovih vrijednosti. Tada bi podaci stabla odluka izgledali ovako:
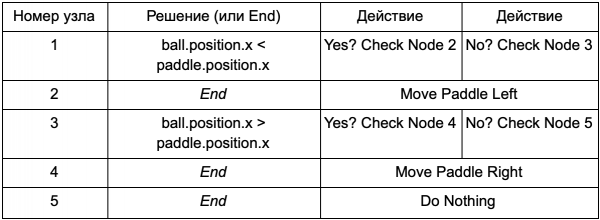
U suštini, ovo je isto kao u prvoj tabeli, ali rešenja imaju vlastiti kod koji je malo sličan delu if-operatora. U kodu, ovo bi se očitavalo u drugom stupcu za čvorove odlučivanja, ali umesto da traži konkretne uslove za izvršavanje (Da Li Je Lopta Levo Od Padelice), procenjuje uslovni izraz i vraća true ili false u skladu s tim. Ovo se ostvaruje pomoću skriptnih jezika Lua ili Angelscript. Korišćenjem njih, programer može koristiti objekte u svojoj igri (lopta i padelica) i kreirati varijable koje su dostupne u scenariju (ball.position). Osim toga, skriptni jezik je jednostavniji od C++. Ne zahteva potpunu fazu kompajliranja, što ga čini idealnim za brzo prilagođavanje logike igre i omogućava "ne-programerima" da sami kreiraju potrebne funkcije.
U datom primeru, skriptni jezik se koristi samo za procenu uslovnog izraza, ali se takođe može koristiti i za akcije. Na primer, podaci Move Paddle Right mogu postati skriptni operator (ball.position.x += 10). Tako da se akcija takođe definiše u skripti, bez potrebe za programiranjem Move Paddle Right.
Može se otići još dalje i potpuno napisati stablo odluka na skriptnom jeziku. Ovo će biti kod u obliku čvrsto programiranih (hardcoded) uslovnih operatora, ali će se nalaziti u spoljnim skriptim datotekama, što znači da mogu biti promenjeni bez ponovnog kompajliranja celog programa. Često se može promeniti skriptna datoteka direktno tokom igre kako bi se brzo testirale različite reakcije AI.
Reagovanje na događaje
Gore navedeni primeri savršeno se uklapaju u Pong. Nastoje kontinuirano pokrenuti ciklus Sense/Think/Act i delovati na osnovu poslednjeg stanja sveta. Ali u složenijim igrama treba reagovati na pojedinačne događaje, a ne procenjivati sve odjednom. U tom slučaju, Pong nije najbolji primer. Uzmimo drugi.
Zamislite pucačku igru u kojoj su neprijatelji nepomični sve dok ne otkriju igrača, nakon čega deluju u zavisnosti od svoje "specijalizacije": neko će krenuti da "napada", dok će neki napadati iz daljine. Ovo je još uvek osnovni reaktivni sistem — "ako je igrač primećen, uradi nešto" — ali se može logički podeliti na događaj Igrač Primećen (Player Seen) i reakciju (izaberi odgovor i izvrši ga).
To se vraća u ciklus Sense/Think/Act. Možemo kodirati dio Sense koji će na svakom okviru provjeravati — vidi li AI igrača. Ako ne — ništa se ne događa, ali ako ga vidi, tada se stvara događaj Player Seen. U kodu će biti odvojeni odjeljak u kojem piše: „kada se dogodi događaj Player Seen, učini“, gdje je — odgovor koji vam je potreban za pristup dijelovima Think i Act. Tako ćete postaviti reakcije na događaj Player Seen: za „napadačkog“ lika — ChargeAndAttack, a za snajperistu — HideAndSnipe. Ove veze mogu se stvoriti u datoteci s podacima radi brzog uređivanja bez potrebe za ponovnim kompajliranjem. I ovdje se može koristiti jezik skripti.
Prihvaćanje složenih odluka
Iako su jednostavni sustavi reakcija vrlo učinkoviti, postoje mnoge situacije kada to nije dovoljno. Ponekad je potrebno donositi različite odluke temeljene na onome što agent radi u tom trenutku, ali to predstavljati kao uvjet je teško. Ponekad postoji previše uvjeta da bi ih se učinkovito prikazalo u stablu odluka ili skripti. Ponekad je potrebno unaprijed procijeniti kako će se situacija promijeniti prije nego donesemo odluku o sljedećem koraku. Za rješavanje ovih problema potrebni su složeniji pristupi.
Konačna stanja
Konačna stanja ili FSM (Finite State Machine) — to je način da se kaže da se naš agent trenutno nalazi u jednom od nekoliko mogućih stanja, i da može prelaziti iz jednog stanja u drugo. Takvih stanja ima određena količina — odatle i naziv. Najbolji primjer iz stvarnog života je semafor. Na različitim mjestima postoje različite sekvence svjetla, ali princip je isti — svako stanje predstavlja nešto (stoj, idi itd.). Semafor je u bilo kojem trenutku u samo jednom stanju i prelazi iz jednog u drugo na temelju jednostavnih pravila.
S NPC-ima u igrama slična je priča. Uzmimo za primjer stražara s ovim stanjima:
- Patrulirajući (Patrolling).
- Napadački (Attacking).
- Bježeći (Fleeing).
I s ovim uvjetima za promjenu njegovog stanja:
- Ako stražar vidi protivnika, napada.
- Ako stražar napada, ali više ne vidi protivnika, vraća se patruliranju.
- Ako stražar napada, ali je teško ranjen, bježi.
Također možemo napisati if-uvjete s varijablom stanja stražara i razne provjere: ima li u blizini neprijatelj, koja je razina zdravlja NPC-a itd. Dodajmo još nekoliko stanja:
- Neaktivnost (Idling) — između patrola.
- Traženje (Searching) — kada je primijećen neprijatelj koji se sakrio.
- Traženje pomoći (Finding Help) — kada je neprijatelj primijećen, ali je prejak za borbu nasamo.
Odabir za svakog od njih je ograničen — na primjer, stražar neće ići tražiti sakrivenog neprijatelja ako mu je zdravlje nisko.
Na kraju, ogroman popis „ako“ <x и y, но не z>, tada <p>može postati previše opterećen, stoga je potrebno formalizirati metodu koja će nam omogućiti da zadržimo u umu stanja i prijelaze između stanja. Da bismo to postigli, uzet ćemo u obzir sva stanja i pod svakim stanjem zabilježiti popis svih prijelaza u druga stanja, zajedno s potrebnim uvjetima za njih.
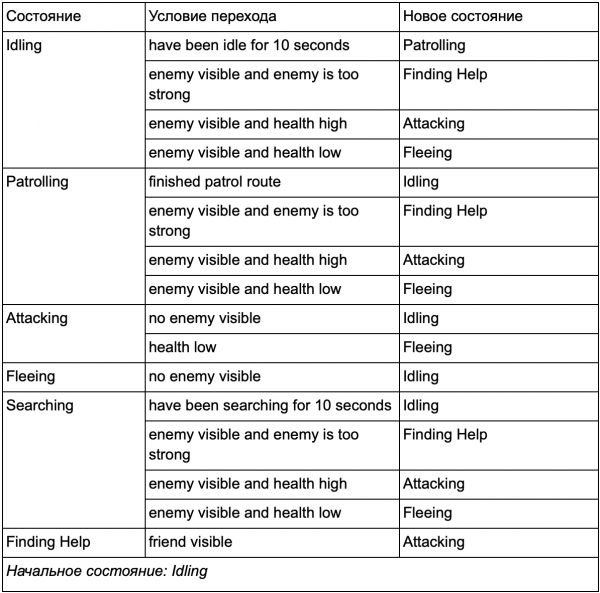
Ovo je tablica prijelaza stanja — sveobuhvatan način predstavljanja FSM-a. Nacrtajmo dijagram i dobijemo potpuni pregled kako se ponašanje NPC-a mijenja.
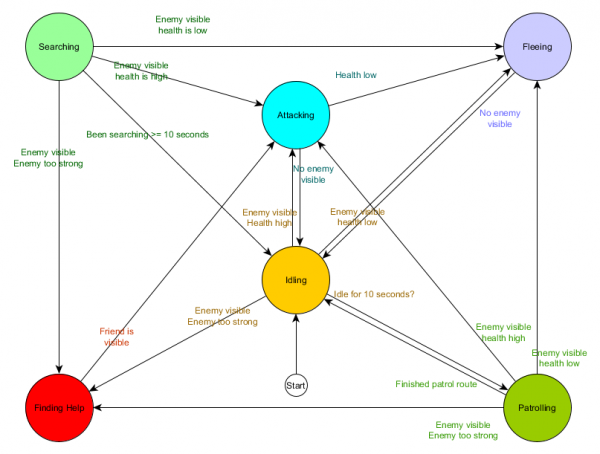
Dijagram odražava bit donošenja odluka za ovog agenta na temelju trenutne situacije. Svaka strelica pokazuje prijelaz između stanja, ako je uvjet pored nje istinit.
Svake se izmjene provjerava trenutno stanje agenta, pregledava se popis prijelaza, i ako su uvjeti za prijelaz ispunjeni, on prihvaća novo stanje. Na primjer, svaki kadar provjerava istječe li 10-sekundni timer, a ako jest, stražar prelazi iz stanja Idling u Patrolling. Na sličan način, stanje Attacking provjerava zdravlje agenta — ako je nisko, prelazi u stanje Fleeing.
Ovo je obrada prijelaza između stanja, ali što je s ponašanjem koje se odnosi na sama stanja? Što se tiče implementacije stvarnog ponašanja za specifično stanje, obično postoje dvije vrste "kuka" gdje dodjeljujemo radnje FSM-u:
- Radnje koje povremeno provodimo za trenutno stanje.
- Radnje koje poduzimamo prilikom prijelaza iz jednog stanja u drugo.
Primjeri za prvu vrstu. Stanje Patrolling svaki kadar će pomicati agenta po ruti patroliranja. Stanje Attacking svaki kadar će pokušati započeti napad ili preći u stanje kada je to moguće.
Za drugu vrstu razmotrit ćemo prijelaz 'ako je neprijatelj vidljiv i neprijatelj je previše snažan, prelazimo u stanje Pronalaženje Pomoći. Agent mora odabrati kamo otići po pomoć i zapamtiti te informacije kako bi stanje Pronalaženje Pomoći znalo kuda se obratiti. Kada pomoć bude pronađena, agent se vraća u stanje Napad. U tom trenutku će htjeti obavijestiti saveznika o prijetnji, pa može doći do radnje ObavijestiPrijateljaOPrijetnji.
I ponovno možemo pogledati ovaj sustav kroz prizmu ciklusa Osjećati/Misliti/Glumiti. Osjećati se manifestira u podacima koji se koriste u logici prijelaza. Misliti se odnosi na prijelaze dostupne u svakom stanju. A Glumiti se provodi akcijama koje se periodično izvršavaju unutar stanja ili na prijelazima između stanja.
Ponekad kontinuirano provjeravanje uvjeta prijelaza može biti skupo. Na primjer, ako svaki agent izvršava složene izračune svaki okvir kako bi odredio vidi li neprijatelje i može li preći iz stanja Patroliranje u Napad — oduzet će mnogo vremena procesora.
Važne promjene u stanju svijeta mogu se smatrati događajima koji će se obrađivati čim se pojave. Umjesto da FSM provjerava uvjet prijelaza 'može li moj agent vidjeti igrača?' svaki okvir, može se postaviti zaseban sustav koji će provjeravati rjeđe (na primjer, 5 puta u sekundi). I rezultat će biti Igrač Viđen kada provjera prođe.
To se proslijeđuje u FSM, koji sada mora preći u uvjet Prijem događaja Igrač Viđen i odgovarajuće reagirati. Konačno ponašanje je isto, osim gotovo neprimjetne kašnjenja prije odgovora. Međutim, performanse su se poboljšale kao rezultat odvajanja dijela Osjećanja u zaseban dio programa.
Hijerarhijska konačna stanja mašina
Međutim, raditi s velikim FSM-ima nije uvijek praktično. Ako želimo proširiti stanje napada zamjenjujući ga odvojenim KrvavimNapadom (bliži borbeni) i DalekimNapadom (daleki borbeni), morat ćemo promijeniti prijelaze iz svih drugih stanja koja dovode do stanja Napad (trenutne i buduće).
Sigurno ste primijetili da u našem primjeru ima mnogo dupliciranih prijelaza. Većina prijelaza u stanju Idling identična je prijelazima u stanju Patrolling. Bilo bi dobro ne ponavljati se, posebno ako dodamo više sličnih stanja. Ima smisla grupirati Idling i Patrolling pod zajedničkom oznakom „neborbena”, gdje postoje samo jedan zajednički skup prijelaza u borbena stanja. Ako tu oznaku zamislimo kao stanje, Idling i Patrolling postat će podstanja. Primjer upotrebe odvojene tablice prijelaza za novo neborbeno podstanje:
Osnovna stanja:
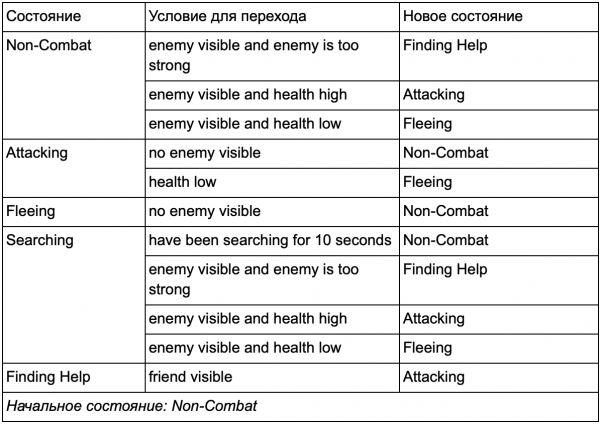
Stanje izvan borbe:
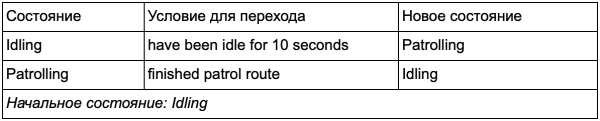
I u obliku dijagrama:
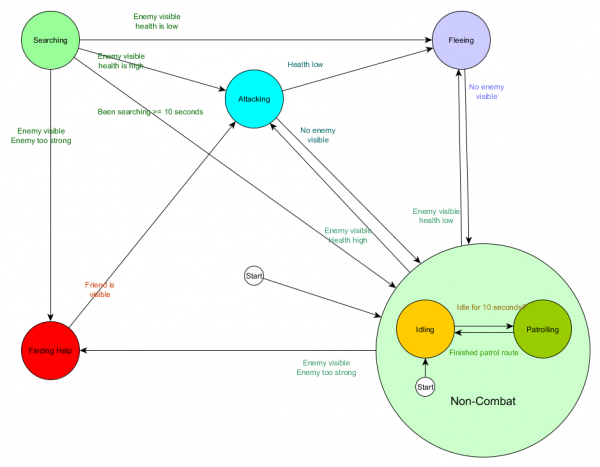
Ovo je isti sustav, ali s novim neborbenim stanjem koje uključuje Idling i Patrolling. Svako stanje sadrži FSM s podstanjima (a ta podstanja, zauzvrat, sadrže vlastite FSM — i tako dalje koliko vam je potrebno), što nas dovodi do Hijerarhijskog Konačnog Stanja ili HFSM (hierarchical finite state machine). Grupiranjem neborbenog stanja, izrezali smo gomilu suvišnih prijelaza. Isto to možemo učiniti za bilo koja nova stanja s zajedničkim prijelazima. Na primjer, ako u budućnosti proširimo stanje Attacking na stanja MeleeAttacking i MissileAttacking, ona će postati podstanja koja će se međusobno prelaziti na temelju udaljenosti do neprijatelja i dostupnosti municije. Na kraju, složeni modeli ponašanja i podmodele ponašanja mogu se predstaviti s minimalno dupliciranim prijelazima.
Stablo ponašanja
S HFSM-om stvaraju se složene kombinacije ponašanja na jednostavan način. Ipak, postoji manja poteškoća, jer donošenje odluka u obliku pravila prijelaza čvrsto je povezano s trenutnim stanjem. A u mnogim igrama to je upravo ono što je potrebno. Pa pomno korištenje hijerarhije stanja može smanjiti broj ponavljanja tijekom prijelaza. No ponekad su potrebna pravila koja djeluju neovisno o tome u kojem se stanju nalazite ili koja se primjenjuju gotovo u svim stanjima. Na primjer, ako zdravlje agenta padne na 25%, željet ćete da pobjegne neovisno o tome je li bio u borbi, neaktivan ili u razgovoru — morat ćete dodati ovaj uvjet u svako stanje. A ako vaš dizajner kasnije želi promijeniti prag niskog zdravlja s 25% na 10%, time će se opet morati baviti.
Idealno, za ovu situaciju potrebna je sustav u kojem su odluke "u kojem stanju biti" izvan samih stanja, kako bi se izmjene mogle izvršiti na jednom mjestu bez potrebe za promjenom uvjeta prijelaza. Ovdje se javljaju stabla ponašanja.
Postoji nekoliko načina za njihovu implementaciju, ali suština je otprilike ista i slična stablu odluka: algoritam počinje s "korijenskim" čvorom, a u stablu se nalaze čvorovi koji predstavljaju ili odluke ili akcije. Istina je da postoje neka ključna razlikovanja:
- Sada čvorovi vraćaju jednu od tri vrijednosti: Succeeded (ako je posao završen), Failed (ako se ne može pokrenuti) ili Running (ako je još uvijek u procesu i nema konačnog rezultata).
- Nema više čvorova odluka za odabir između dviju alternativa. Umjesto njih postoje čvorovi Decorator, koji imaju jedan podčvor. Ako uspiju, izvršavaju svoj jedini podčvor.
- Čvorovi koji izvršavaju akcije vraćaju vrijednost Running za predstavljanje akcija koje se izvršavaju.
Ovaj mali skup čvorova može se kombinirati za stvaranje velike količine složenih modela ponašanja. Zamislimo HFSM stražara iz prethodnog primjera kao stablo ponašanja:
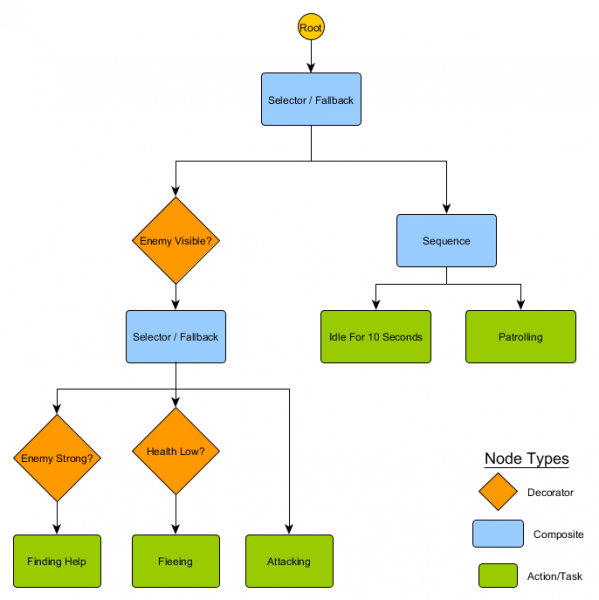
S ovom strukturom ne bi trebalo biti eksplicitnog prijelaza između stanja Idling/Patrolling i stanja Attacking ili bilo kojeg drugog. Ako je neprijatelj vidljiv, a zdravlje lika je nisko, izvršenje će stati na čvoru Fleeing, bez obzira na to koji je čvor prethodno izvršavao — Patrolling, Idling, Attacking ili bilo koji drugi.
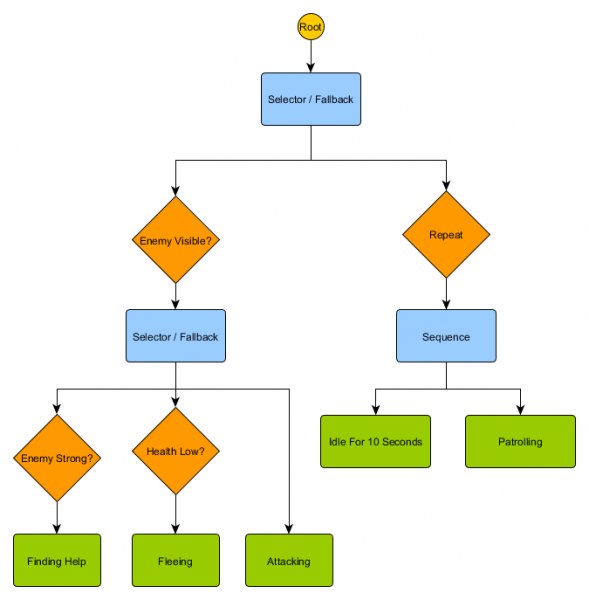
Stabla ponašanja su složena — postoji mnogo načina za njihovo konstruiranje, a pronalaženje pravog spoja dekoratora i sastavnih čvorova može biti problematično. Također, nema pitanja koliko često provjeravati stablo — želimo li prolaziti kroz njega svaki put ili samo kada se jedan od uvjeta promijeni? Kako čuvati stanje povezano s čvorovima — kako znati kada smo bili u stanju Idling 10 sekundi ili kako znati koji su čvorovi izvršavani prošli put kako bismo ispravno obradili slijed?
Zbog toga postoji puno implementacija. Na primjer, u nekim sustavima čvorovi dekoratora su zamijenjeni ugrađenim dekoratorima. Oni ponovno ocjenjuju stablo kada se uvjeti dekoratora promijene, pomažu u povezivanju čvorova i osiguravaju periodična ažuriranja.
Sustav temeljen na korisnosti
Neke igre imaju brojne različite mehanike. Idealno bi bilo da iskoriste sve prednosti jednostavnih i općih pravila prijelaza, ali nije nužno u obliku potpune strukture ponašanja. Umjesto da imaju točno definirani skup odluka ili stablo mogućih radnji, jednostavnije je proučiti sve radnje i odabrati onu koja je trenutno najprikladnija.
Sistem zasnovan na korisnosti pomoći će u tome. To je sistem u kojem agent ima mnoštvo radnji i sam bira koju će izvršiti, oslanjajući se na relativnu korisnost svake od njih. Gdje je korisnost proizvoljna mjera koliko je važno ili poželjno izvršiti tu radnju za agenta.
Izračunatu korisnost radnje na osnovu trenutnog stanja i okruženja, agent može provjeriti i odabrati najprikladnije drugo stanje u bilo kojem trenutku. To je slično FSM-u, osim što su prijelazi definirani ocjenama za svako potencijalno stanje, uključujući i trenutne. Napomena: odabiremo najkorisniju radnju za prijelaz (ili ostajemo ako smo je već izvršili). Za veću raznolikost, to može biti ponderirani, ali slučajni odabir iz malog popisa.
Sistem dodjeljuje proizvoljan raspon vrijednosti korisnosti — na primjer, od 0 (potpuno nepoželjno) do 100 (potpuno poželjno). Svaka radnja ima niz parametara koji utječu na izračun te vrijednosti. Vraćajući se našem primjeru čuvara:
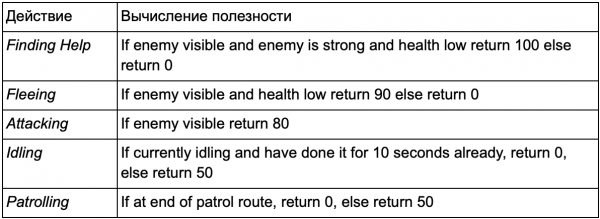
Prijelazi između radnji su nejasni — svako stanje može uslijediti nakon bilo kojeg drugog. Prioriteti radnji određeni su vrijednostima korisnosti koje se vraćaju. Ako je neprijatelj vidljiv, a taj neprijatelj jak, dok je zdravlje lika nisko, tada će i Izbjegavanje i Pronalazak pomoći vratiti visoke nenulte vrijednosti. Pri čemu će Pronalazak pomoći uvijek biti veći. Slično tome, neborbene radnje nikada ne vraćaju više od 50, pa će stoga uvijek biti niže od borbenih. To treba uzeti u obzir pri kreiranju radnji i izračunavanju njihove korisnosti.
U našem primjeru akcije vraćaju ili fiksnu konstantnu vrijednost ili jednu od dvije fiksne vrijednosti. Realističniji sustav predviđa vraćanje ocjene iz kontinuiranog raspona vrijednosti. Na primjer, akcija Bijeg vraća više vrijednosti korisnosti ako je zdravlje agenta nisko, dok akcija Napad vraća niže vrijednosti ako je neprijatelj prejak. Zbog toga akcija Bijeg ima prioritet nad Napadom u svakoj situaciji kada agent osjeća da nema dovoljno zdravlja za pobijediti protivnika. To omogućuje da se prioriteti akcija mijenjaju na temelju različitih kriterija, što čini ovaj pristup fleksibilnijim i promjenjivijim od stabla ponašanja ili FSM.
Svaka akcija ima mnogo uvjeta za izračun programa. Mogu se napisati na jeziku skriptiranja ili u obliku niza matematičkih formula. U The Sims, koji modelira raspored dana lika, dodaje se dodatna razina izračuna — agent dobiva niz "motivacija" koje utječu na ocjene korisnosti. Ako je lik gladan, s vremenom će postati još gladniji, a rezultat korisnosti akcije JediteHranu će rasti sve dok lik ne izvrši tu akciju, smanjujući razinu gladi i vraćajući vrijednost JediteHranu na nulu.
Ideja izbora akcija na temelju sustava ocjena prilično je jednostavna, pa se sustav temeljen na korisnosti može koristiti kao dio procesa donošenja odluka AI-a, a ne kao njihova potpuna zamjena. Stablo odluka može zatražiti ocjenu korisnosti dva dječja čvora i odabrati onog s višom ocjenom. Slično tome, stablo ponašanja može imati sastavni čvor korisnosti za procjenu korisnosti akcija kako bi odlučilo koju dijeljenicu izvršiti.
Kretanje i navigacija
U prethodnim primjerima imali smo platformu koju smo pomicali lijevo ili desno, te čuvara koji je patrolirao ili napadao. No kako zapravo obrađujemo kretanje agenta tijekom određenog vremenskog razdoblja? Kako postavljamo brzinu, kako izbjegavamo prepreke i kako planiramo put ako je dolazak na odredište složeniji od jednostavnog kretanja u ravnoj liniji? Poglejmo to.
Upravljanje
Na početku ćemo pretpostaviti da svaki agent ima brzinu koja uključuje koliko brzo se kreće i u kojem smjeru. Može se mjeriti u metrima u sekundi, kilometrima na sat, pikselima u sekundi itd. Podsjećajući se na ciklus Sense/Think/Act, možemo zamisliti da dio Think odabire brzinu, dok dio Act primjenjuje tu brzinu na agenta. Obično igre imaju fizički sustav koji obavlja taj zadatak umjesto vas, proučavajući vrijednost brzine svakog objekta i regulirajući je. Stoga se može prepustiti AI-ju jedan zadatak — odlučiti kakvu brzinu agent treba imati. Ako je poznato gdje agent treba biti, treba ga premjestiti u pravom smjeru određenom brzinom. Vrlo trivijalna jednadžba:
desired_travel = destination_position – agent_position
Zamislite 2D svijet. Agent se nalazi na točki (-2,-2), odredišna točka negdje na sjeveroistoku na točki (30, 20), a potreban put za agenta da bi stigao tamo je (32, 22). Pretpostavimo da su te pozicije mjerene u metrima — ako uzmemo brzinu agenta od 5 metara u sekundi, tada ćemo skalirati naš vektor premještanja i dobiti brzinu otprilike (4.12, 2.83). S tim parametrima agent bi stigao na odredište gotovo nakon 8 sekundi.
Vrijednosti se mogu ponovno izračunati u bilo kojem trenutku. Ako je agent bio na pola puta do cilja, premještaj bi bio polovina duljine, no budući da je maksimalna brzina agenta 5 m/s (to smo odlučili ranije), brzina će biti ista. To također funkcionira za pokretne ciljeve, omogućujući agentu da učini male prilagodbe dok se kreću.
Međutim, želimo više varijabilnosti — na primjer, polako povećati brzinu kako bismo simulirali lika koji se kreće iz stojećeg stanja prema trčanju. Isto se može učiniti i na kraju prije zaustavljanja. Ove značajke poznate su kao ponašanja upravljanja, od kojih svako ima specifična imena: Seek (traženje), Flee (bježanje), Arrival (dolazak) itd. Ideja je da se sile ubrzanja mogu primijeniti na brzinu agenta, na temelju usporedbe položaja agenta i trenutne brzine s odredištem, kako bi se koristili različiti načini premještanja prema cilju.
Svako ponašanje ima malo drugačiju svrhu. Seek i Arrival su načini pomicanja agenta prema odredištu. Obstacle Avoidance (izbjegavanje prepreka) i Separation (odvajanje) ispravljaju kretanje agenta kako bi izbjegli prepreke na putu ka cilju. Alignment (suglasnost) i Cohesion (povezanost) drže agente zajedno dok se kreću. Bilo koji broj različitih ponašanja upravljanja može se zbrojiti u jedan vektor putanje uzimajući u obzir sve faktore. Agent koristi ponašanja Arrival, Separation i Obstacle Avoidance kako bi se držao podalje od zidova i drugih agenata. Ovaj pristup dobro funkcionira u otvorenim lokacijama bez suvišnih detalja.
U težim uvjetima, zbrajanje različitih ponašanja djeluje lošije — na primjer, agent može zaglaviti u zidu zbog sukoba između Arrival i Obstacle Avoidance. Stoga je potrebno razmatrati opcije koje su složenije od jednostavnog zbrajanja svih vrijednosti. Jedan od načina je: umjesto zbrajanja rezultata svakog ponašanja, možemo razmotriti kretanje u različitim smjerovima i odabrati najbolju opciju.
Međutim, u složenom okruženju s slijepim ulicama i odabirom u kojem smjeru ići, trebat će nam nešto još naprednije.
Traženje puta
Ponašanja upravljanja savršeno odgovaraju jednostavnom kretanju na otvorenom terenu (fudbalsko igralište ili arena), gdje je doći od A do B izravan put s malim odmakom od prepreka. Za složene rute potrebna nam je metoda traženja puta koja je način istraživanja svijeta i donošenje odluka o ruti kroz njega.
Najjednostavnije je preklopiti mrežu na svaki kvadrat uz agenta i procijeniti u kojima od njih je dozvoljeno kretanje. Ako je neki od njih odredišna točka, slijedite od nje putanju od svakog kvadrata do prethodnog, sve dok ne dođete do početka. To je putanja. Inače, ponavljajte postupak s najbližim drugim kvadratima dok ne pronađete odredište ili ne završite kvadrate (to znači da ne postoji moguća ruta). Ovo je ono što je formalno poznato kao Pretraživanje u širini ili BFS (Breadth-First Search). U svakom koraku gleda u svim smjerovima (zato širina). Prostor pretraživanja nalikuje valu koji se kreće, sve dok ne dođe do tražene lokacije — područje pretraživanja proširuje se u svakom koraku dok ne obuhvati konačnu točku, nakon čega se može pratiti put do početka.
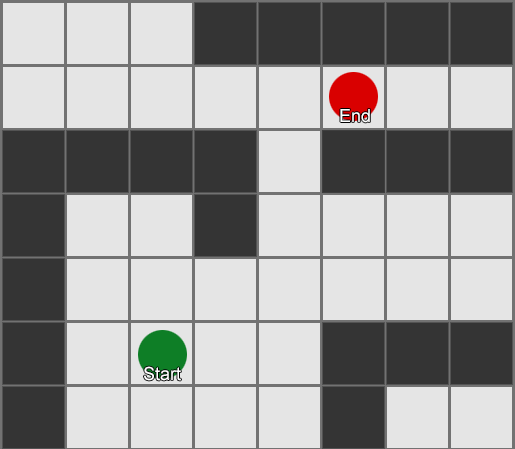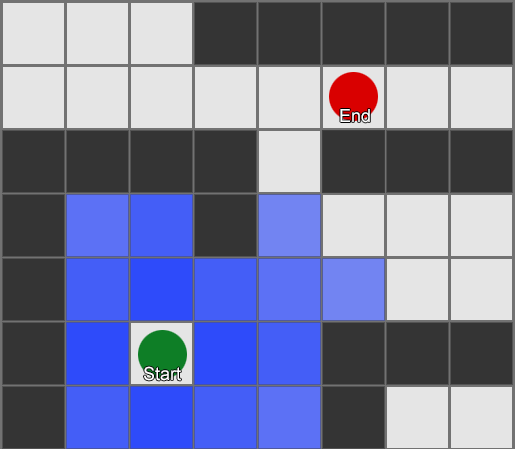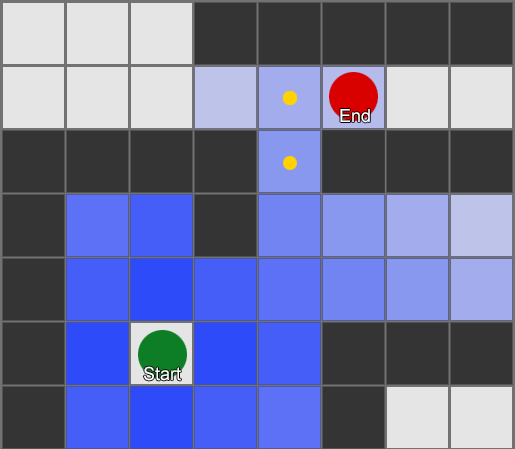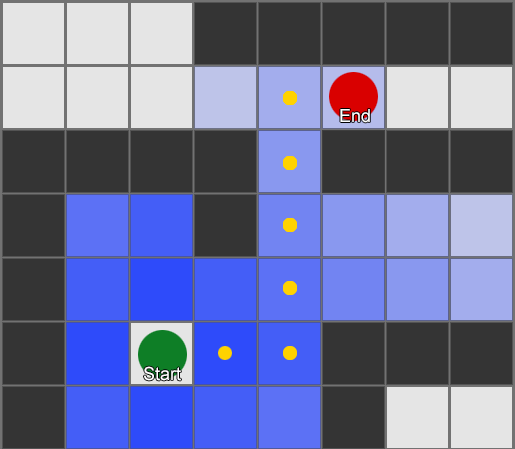
Kao rezultat toga, dobit ćete popis kvadrata koji čine potrebnu putanju. To je putanja (odavde, pathfinding) — popis mjesta koje će agent posjetiti slijedeći do odredišta.
S obzirom na to da znamo položaj svakog kvadrata u svijetu, možemo koristiti ponašanja upravljanja (steering behaviours) za kretanje po putu — od čvora 1 do čvora 2, zatim od čvora 2 do čvora 3 i tako dalje. Najjednostavnija opcija je usmjeriti se prema središtu sljedećeg kvadrata, ali je još bolje zaustaviti se na sredini rubne strane između trenutnog kvadrata i sljedećeg. Time će agent moći skratiti kutove oštrih zavoja.
Algoritam BFS ima i nedostatke — istražuje jednaku količinu kvadrata u "pogrešnom" smjeru koliko i u "pravom". Ovdje se pojavljuje složeniji algoritam pod nazivom A* (A star). On radi isto, ali umjesto slijepog istraživanja susjednih kvadrata (zatim susjeda susjeda, zatim susjeda susjeda susjeda itd.), skuplja čvorove u popis i sortira ih tako da sljedeći istraživani čvor uvijek bude onaj koji će dovesti do najkraće rute. Čvorovi se sortira na temelju heuristike koja uzima u obzir dvije stvari — "cijenu" hipotetske rute do potrebnog kvadrata (uključujući sve troškove kretanja) i procjenu koliko je taj kvadrat daleko od odredišta (pomjerajući pretraživanje u pravom smjeru).
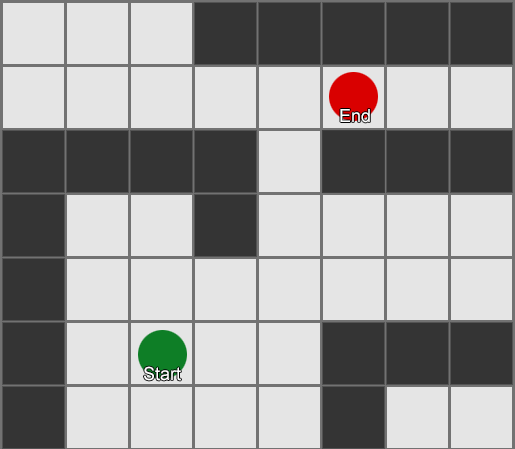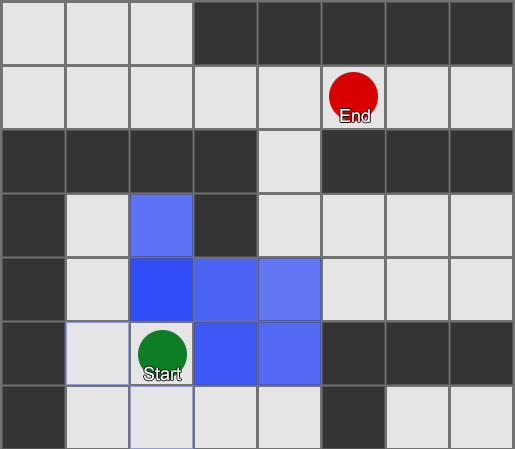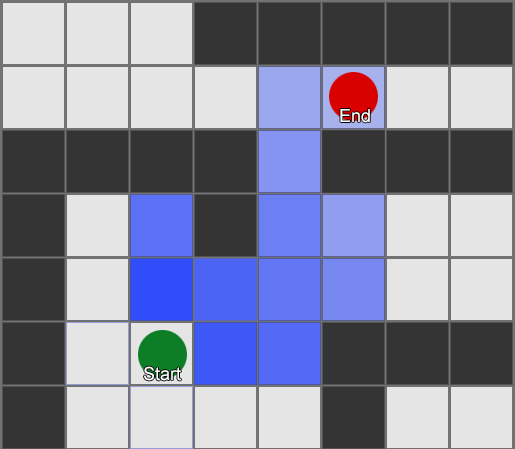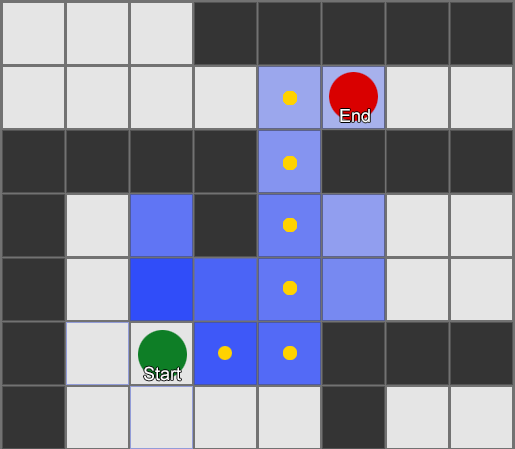
U ovom primjeru agenta istražuje jedan kvadrat po jedan, svaki put birajući susjedni koji je najperspektivniji. Dobiveni put je isti kao kod BFS-a, ali tijekom procesa razmotreno je manje kvadrata — što ima značajan utjecaj na performanse igre.
Kretanje bez mreže
Ali većina igara nije postavljena na mreži i često je ne moguće napraviti bez ugrožavanja realističnosti. Potrebni su kompromisi. Kolike bi trebale biti veličine kvadrata? Preveliki — i neće moći pravilno predstavljati male hodnike ili zavoje, premali — bit će previše kvadrata za pretraživanje, što će na kraju potrajati puno vremena.
Prvo što treba razumjeti jest da mreža daje graf povezanih čvorova. A* i BFS algoritmi zapravo rade na grafovima i uopće se ne brinu o našoj mreži. Mogli bismo staviti čvorove bilo gdje u igrivom svijetu: uz povezanost između bilo koja dva povezana čvora, kao i između početne i završne točke i barem jednog od čvorova — algoritam će raditi jednako dobro kao i prije. To se često naziva sustavom putnih točaka (waypoint), jer svaki čvor predstavlja značajnu poziciju u svijetu, koja može biti dio bilo kojeg broja hipotetičkih putova.
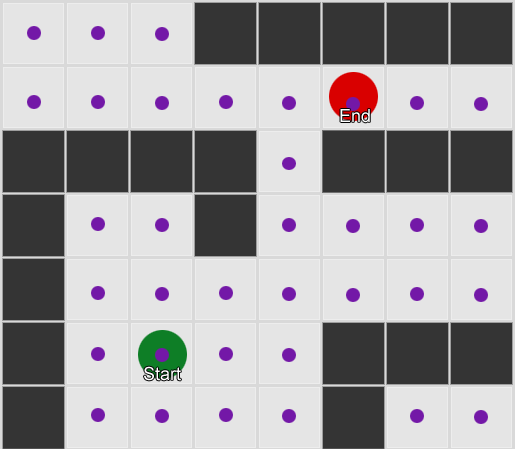
Primjer 1: čvor u svakom kvadratu. Pretraživanje počinje iz čvora u kojem se nalazi agent i završava u čvoru potrebnog kvadrata.
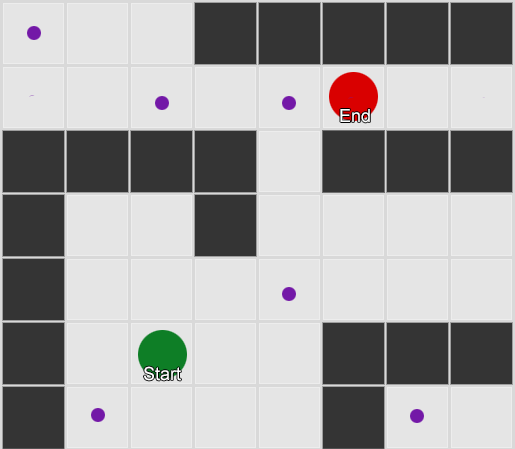
Primjer 2: manji skup čvorova (putnih točaka). Pretraživanje počinje u kvadratu s agentom, prolazi kroz potrebni broj čvorova i zatim se nastavlja do odredišta.
Ovo je prilično fleksibilan i moćan sustav. No potrebna je određena opreznost prilikom odluka gdje i kako postaviti putne točke, inače agenti možda jednostavno neće vidjeti najbližu točku i neće moći započeti put. Bilo bi lakše kada bismo mogli automatski postaviti putne točke na temelju geometrije svijeta.
Tu se pojavljuje navigacijska mreža ili navmesh (navigation mesh). To je obično 2D-mreža trokuta koja se postavlja na geometriju svijeta — svugdje gdje agentu nije dopušteno hodanje. Svaki od trokuta u mreži postaje čvor u grafu i ima do tri susjedna trokuta, koja postaju susjedni čvorovi u grafu.
Ova slika je primjer iz Unity motora — analizirao je geometriju u svijetu i stvorio navmesh (na snimci svijetloplava boja). Svaki poligon u navmeshu predstavlja područje na kojem agent može stajati ili se kretati s jednog poligona na drugi. U ovom primjeru, poligoni su manji od katova na kojima se nalaze — to je učinjeno kako bi se uzele u obzir dimenzije agenta, koje će izlaziti izvan svog nominalnog položaja.
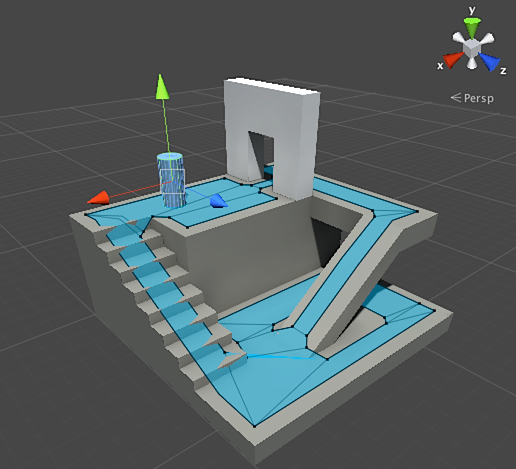
Možemo tražiti put kroz ovu mrežu, ponovno koristeći A* algoritam. To će nam dati gotovo idealnu rutu u svijetu, koja uzima u obzir svu geometriju, a nema viška čvorova ili stvaranja putokaza.
Pathfinding je preširoka tema koja ne može stati u samo jedan odjeljak članka. Ako želite detaljnije proučiti ovu temu, pomoći će vam .
Planiranje
Uvidjeli smo kroz pathfinding da ponekad nije dovoljno samo odabrati smjer i krenuti — moramo odabrati put i napraviti nekoliko skretanja kako bismo stigli do odredišta. Ovu ideju možemo sažeti: postizanje cilja nije samo sljedeći korak, već čitava sekvenca, gdje ponekad trebamo pogledati unaprijed nekoliko koraka kako bismo znali kakav bi trebao biti prvi. To se naziva planiranje. Pathfinding se može smatrati jednim od nekoliko dodataka planiranju. Iz perspektive našeg ciklusa Sense / Think / Act, to je ono gdje dio Think planira nekoliko dijelova Act za budućnost.
Razmotrit ćemo na primjeru društvene igre Magic: The Gathering. Igramo prvi s takvim skupom karata u ruci:
- Swamp — daje 1 crnu manu (karta zemlje).
- Forest — daje 1 zelenu manu (karta zemlje).
- Fugitive Wizard — zahtijeva 1 plavu manu za prizivanje.
- Elvish Mystic — zahtijeva 1 zelenu manu za prizivanje.
Preostale tri karte ignoriramo radi jednostavnosti. Prema pravilima, igraču je dopušteno odigrati 1 kartu zemlje po potezu, može „tapnuti“ tu kartu da izvuče manu iz nje, a zatim koristiti čarolije (uključujući prizivanje stvorenja) prema količini mane. U ovoj situaciji igrač zna da treba igrati Forest, „tapnuti“ 1 zelenu manu, a zatim prizvati Elvish Mystic. Ali kako to može otkriti AI igre?
Jednostavno planiranje
Trivijalni pristup je isprobati svaku radnju redom, dok ne ostane ni jedna prikladna. Gledajući karte, AI vidi da može odigrati Swamp. I odigra ga. Ima li drugih radnji na ovom potezu? Ne može prizvati ni Elvish Mystic ni Fugitive Wizard, budući da je za njihovo prizivanje potrebna zelena, odnosno plava mana, dok Swamp daje samo crnu manу. A već ne može igrati Forest, jer je već odigrao Swamp. Tako je AI odigrao prema pravilima, ali je to učinio loše. Moguće je poboljšati.
Planiranje može pronaći popis radnji koje igra dovode u željeno stanje. Baš kao što je svaka kvadrata na putu imala susjede (u pathfinding), svaka radnja u planu također ima susjede ili nasljednike. Možemo tražiti te radnje i sljedeće radnje, dok ne postignemo željeno stanje.
U našem primjeru, željeni rezultat je „prizvati stvorenje, ako je moguće“. Na početku poteza vidimo samo dva moguća djelovanja, dozvoljena pravilima igre:
1. Odigrati Swamp (rezultat: Swamp u igri)
2. Odigrati Forest (rezultat: Forest u igri)
Svaka usvojena radnja može dovesti do daljnjih radnji i zatvoriti druge, opet ovisno o pravilima igre. Zamislite da smo odigrali Swamp — to će ukloniti Swamp kao sljedeći korak (već smo ga odigrali), također će ukloniti i Forest (jer prema pravilima možete odigrati jednu kartu zemlje po potezu). Nakon toga AI dodaje kao sljedeći korak — dobijanje 1 crne mane, jer drugih opcija nema. Ako nastavi dalje i odabere Tap the Swamp, dobit će 1 jedinicu crne mane i neće moći učiniti ništa s njom.
1. Odigrati Swamp (rezultat: Swamp u igri)
1.1 „Tapnuti“ Swamp (rezultat: Swamp „tapnut“, +1 jedinica crne mane)
Nema dostupnih radnji – KRAJ
2. Odigrati Forest (rezultat: Forest u igri)
Popis radnji je bio kratak, zapali smo u zastoju. Ponavljamo proces za sljedeću radnju. Igramo Forest, otvaramo radnju „dobiti 1 zelenu manu“, koja zauzvrat otvara treću radnju — prizivanje Elvish Mystic.
1. Odigrati Swamp (rezultat: Swamp u igri)
1.1 „Tapnuti“ Swamp (rezultat: Swamp „tapnut“, +1 jedinica crne mane)
Nema dostupnih radnji – KRAJ
2. Odigrati Forest (rezultat: Forest u igri)
2.1 „Tapnuti“ Forest (rezultat: Forest „tapnut“, +1 jedinica zelene mane)
2.1.1 Prizvati Elvish Mystic (rezultat: Elvish Mystic u igri, -1 jedinica zelene mane)
Nema dostupnih radnji – KRAJ
Na kraju, istražili smo sve moguće radnje i pronašli plan za prizivanje stvorenja.
Ovo je vrlo pojednostavljeni primjer. Preporučljivo je odabrati najbolji mogući plan, a ne bilo koji koji zadovoljava određene kriterije. Općenito, potencijalne planove može se procijeniti na temelju krajnjeg rezultata ili ukupne koristi od njihovog ostvarivanja. Možete si dodijeliti 1 bod za igru karte zemlje i 3 boda za prizivanje stvorenja. Igrati Swamp bio bi plan koji donosi 1 bod. A igrati Forest → Tap the Forest → prizvati Elvish Mystic — odmah donosi 4 boda.
Ovako funkcionira planiranje u Magic: The Gathering, no istom logikom se to primjenjuje i u drugim situacijama. Na primjer, pomjeriti pijuna kako biste oslobodili prostor za potez slona u šahu. Ili skloniti se iza zida kako bi sigurno pucali u XCOM-u. Uglavnom, shvatili ste bit.
Unaprijeđeno planiranje
Ponekad postoji previše potencijalnih radnji da bi se razmatrala svaka moguća opcija. Vraćajući se na primjer s Magic: The Gathering: recimo da u igri imate nekoliko karata zemlje i stvorenja — broj mogućih kombinacija poteza može se mjeriti desecima. Postoji nekoliko rješenja za taj problem.
Prvi način je backwards chaining (obrnuto formiranje lanca). Umjesto da prolazite kroz sve kombinacije, bolje je započeti s konačnim rezultatom i pokušati pronaći izravnu stazu. Umjesto puta od korijena drveta do određenog lista, mi se krećemo u suprotnom smjeru — od lista prema korijenu. Ova metoda je jednostavnija i brža.
Ako protivnik ima 1 jedinicu zdravlja, možete pronaći plan "nanijeti 1 ili više jedinica štete". Da biste to postigli, potrebno je ispuniti niz uvjeta:
1. Štetu može nanijeti čarolija — ona mora biti u ruci.
2. Da biste odigrali čaroliju — potrebna je mana.
3. Da biste dobili manu — potrebno je odigrati kartu zemlje.
4. Da biste odigrali kartu zemlje — potrebno je imati je u ruci.
Drugi način je best-first search (najbolji prvi pretraživač). Umjesto prolaska kroz sve puteve, odabiremo najprikladniji. Najčešće ova metoda daje optimalan plan bez nepotrebnog troška na pretraživanje. A* je oblik najboljeg prvog pretraživača — istražujući najperspektivnije rute od samog početka, već može pronaći najbolji put bez potrebe da provjerava ostale opcije.
Zanimljivo i sve popularnije rješenje za pretraživanje najbolja-prvo je Monte Carlo Tree Search. Umjesto da nasumično pogađa koji su planovi bolji dok bira svaku sljedeću akciju, algoritam bira nasumične nasljednike na svakom koraku sve dok ne dosegne kraj (kada plan dovede do pobjede ili poraza). Tada se konačni rezultat koristi za povećanje ili smanjenje procjene 'težine' prethodnih opcija. Ponovnim izvođenjem ovog procesa nekoliko puta zaredom, algoritam daje dobru procjenu koja je sljedeća akcija najbolja, čak i ako se situacija promijeni (ako protivnik poduzme mjere da ometa igrača).
U priči o planiranju u igrama ne može se zaobići Goal-Oriented Action Planning ili GOAP (planiranje akcija usmjereno na cilj). To je široko korištena i raspravljačka metoda, ali osim nekoliko karakterističnih detalja, to je u suštini metoda unazadnog povezivanja o kojoj smo govorili ranije. Ako je zadatak bio 'uništi igrača', a igrač se nalazi iza zaklona, plan može izgledati ovako: uništi granatom → dođi do nje → baci.
Obično postoji više ciljeva, svaki s vlastitim prioritetom. Ako cilj s najvišim prioritetom ne može biti ostvaren (nijedna kombinacija akcija ne stvara plan 'uništi igrača', jer igrač nije vidljiv), AI se vraća ciljevima s nižim prioritetom.
Obuka i prilagodba
Već smo spomenuli da igraći AI obično ne koristi strogo učenje, jer to nije pogodno za upravljanje agentima u stvarnom vremenu. No to ne znači da ne možemo nešto posuditi iz ove oblasti. Želimo imati takvog protivnika u pucačkim igrama od kojeg se može nešto naučiti. Na primjer, saznati o najboljim pozicijama na mapi. Ili protivnika u borilačkim igrama koji bi blokirao često korištene kombinacije igrača, motivirajući korištenje drugih. Dakle, strogo učenje može biti vrlo korisno u takvim situacijama.
Statistika i vjerojatnosti
Prije nego što pređemo na složene primjere, procijenimo koliko daleko možemo ići, uzimajući nekoliko jednostavnih mjerenja i koristeći ih za donošenje odluka. Na primjer, strategija u stvarnom vremenu — kako možemo odrediti može li igrač započeti napad u prvih nekoliko minuta igre i koju obranu pripremiti protiv toga? Možemo proučiti prošlo iskustvo igrača kako bismo razumjeli koja bi mogla biti buduća reakcija. Počinjemo s time da nemamo takve podatke, no možemo ih prikupiti — svaki put kada AI igra protiv čovjeka, može zabilježiti vrijeme prvog napada. Nakon nekoliko sesija dobit ćemo prosječnu vrijednost vremena kada će igrač napasti u budućnosti.
Prosječne vrijednosti također imaju problem: ako je igrač 20 puta napao, a 20 puta igrao polako, potrebne vrijednosti bit će negdje na sredini, a to nam ne daje ništa korisno. Jedno od rješenja je ograničenje ulaznih podataka — možemo uzeti u obzir posljednjih 20.
Sličan pristup koristi se prilikom procjene vjerojatnosti određenih radnji, pretpostavljajući da će prošle preferencije igrača biti slične u budućnosti. Ako nas igrač napadne pet puta vatrenom kuglom, dva puta munjom i jedan put iz blizine, očito je da preferira vatrenu kuglu. Ekstrapolirajmo i vidimo vjerojatnost korištenja različitog oružja: vatrena kugla = 62,5%, munja = 25% i bliska borba = 12,5%. Našem igračkom AI-u treba se pripremiti za obranu od vatre.
Još jedna zanimljiva metoda je korištenje Naive Bayes Classifier (naivnog bayesovskog klasifikatora) za proučavanje velikih količina ulaznih podataka i klasificiranje situacije kako bi AI reagirao na pravilan način. Bayesovski klasifikatori najpoznatiji su po korištenju u filtrima neželjene pošte. Tamo proučavaju riječi, uspoređuju ih s tim gdje su se te riječi ranije pojavljivale (u neželjenoj pošti ili ne) i donose zaključke o dolaznim porukama. Možemo učiniti isto čak i s manjim brojem ulaznih podataka. Na temelju svih korisnih informacija koje AI vidi (na primjer, koje neprijateljske jedinice su stvorene, ili koje čarolije koriste, ili koje tehnologije istražuju), i konačnog rezultata (rat ili mir, „napasti” ili braniti se itd.) — odabrat ćemo odgovarajuće ponašanje AI-a.
Svi ovi načini učenja su dovoljni, ali je poželjno koristiti ih na temelju podataka iz testiranja. AI će naučiti prilagoditi se različitim strategijama koje su koristili vaši playtesteri. AI koji se prilagođava igraču nakon objave može postati previše predvidljiv ili, s druge strane, previše težak za pobjedu.
Prilagodba na temelju vrijednosti
Uzimajući u obzir sadržaj našeg svijeta igre i pravila, možemo promijeniti skup vrijednosti koje utječu na donošenje odluka, a ne samo koristiti ulazne podatke. Radimo to ovako:
- Neka AI prikuplja podatke o stanju svijeta i ključnim događajima tijekom igre (kako je navedeno gore).
- Izmijenit ćemo nekoliko važnih vrijednosti na temelju tih podataka.
- Realizirat ćemo svoje odluke, temeljene na obradi ili ocjenjivanju tih vrijednosti.
Na primjer, agent ima nekoliko soba za odabir na karti first-person shootera. Svaka soba ima svoju vrijednost koja određuje koliko je poželjna za posjet. AI nasumično odabire u koju sobu će ići, oslanjajući se na vrijednost. Tada agent pamti u kojoj je sobi ubijen i smanjuje njezinu vrijednost (vjerojatnost povratka u tu sobu). Slično tomu, ako agent uništi mnogo protivnika, tada se vrijednost sobe povećava.
Markovljeva model
Što ako koristimo prikupljene podatke za predviđanje? Ako zapamtimo svaku sobu u kojoj viđamo igrača tijekom određenog vremenskog razdoblja, možemo predvidjeti u koju sobu bi igrač mogao preći. Prateći i bilježeći kretanje igrača po sobama, možemo ih prognozirati.
Uzmimo tri sobe: crvenu, zelenu i plavu. Također i opažanja koja smo zabilježili tijekom gledanja igranja:
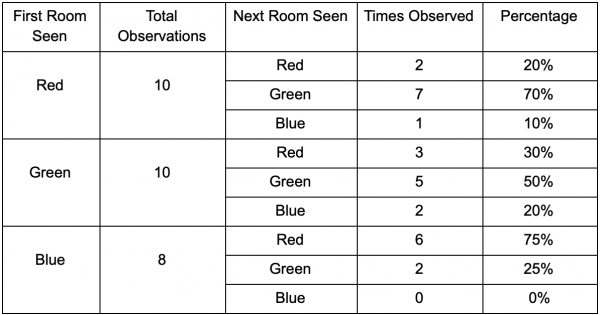
Broj opažanja svake sobe gotovo je jednak — gdje bismo mogli stvoriti dobru zamku još ne znamo. Prikupljanje statistike također se otežava respawnom igrača koji se pojavljaju ravnomjerno po karti. No podaci o sljedećoj sobi u koju ulaze nakon respawna — već su korisni.
Vidljivo je da zelena soba privlači igrače – većina ljudi iz crvene prelazi u nju, od kojih 50% ostaje dalje. Plava soba, s druge strane, ne uživa popularnost, rijetko se u nju ulazi, a ako se i uđe, ne ostaje se dugo.
No podaci nam govore nešto važnije – kada je igrač u plavoj sobi, sljedeća soba u kojoj ćemo ga vjerojatno vidjeti bit će crvena, a ne zelena. Iako je zelena soba popularnija od crvene, situacija se mijenja ako je igrač u plavoj. Sljedeće stanje (tj. soba u koju će igrač preći) ovisi o prethodnom stanju (tj. sobi u kojoj se igrač trenutno nalazi). Zbog istraživanja zavisnosti, predviđat ćemo točnije nego da smo samo brojali promatranja neovisno jedno o drugome.
Predvođenje budućeg stanja na temelju podataka iz prošlog stanja naziva se Markovljevim modelom (Markov model), a takvi primjeri (sa sobama) nazivaju se Markovljevim lancima. Budući da modeli predstavljaju vjerojatnosti promjena između uzastopnih stanja, vizualno se prikazuju u obliku FSM s vjerojatnostima oko svakog prijelaza. Ranije smo koristili FSM za predstavljanje ponašajnog stanja u kojem se agent nalazio, ali ovaj koncept se može primijeniti na bilo koje stanje, bez obzira na to je li povezano s agentom ili ne. U ovom slučaju, stanja predstavljaju sobu koju agent zauzima:
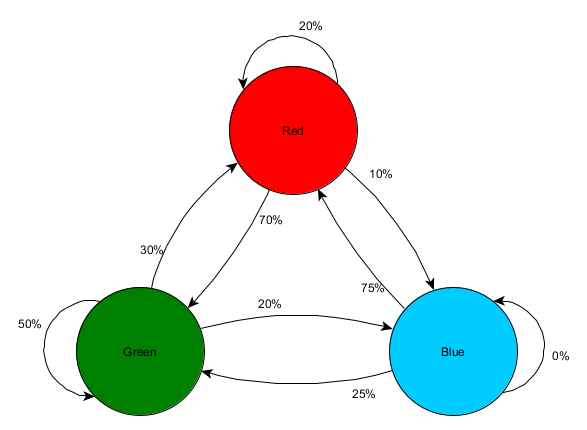
To je jednostavna verzija prikaza relativne vjerojatnosti promjena stanja, koja AI-u pruža mogućnost predviđanja sljedećeg stanja. Moguće je predvidjeti nekoliko koraka unaprijed.
Ako je igrač u zelenoj sobi, postoji 50% šanse da će ostati u njoj prilikom sljedeće promjene. No, koja je vjerojatnost da će još uvijek biti tu čak i nakon toga? Postoji ne samo šansa da je igrač ostao u zelenoj sobi nakon dva promatranja, već i šansa da je otišao i vratio se. Evo nove tablice koja uzima u obzir nove podatke:
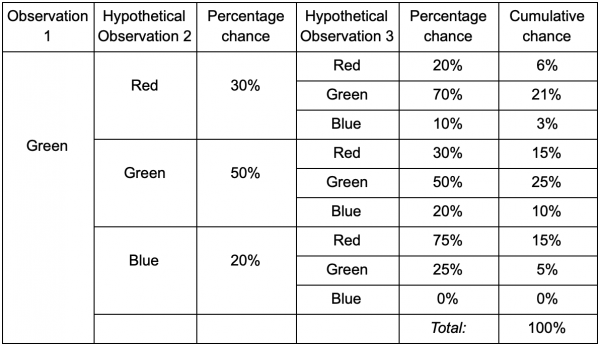
Iz nje se vidi da će šansa da vidimo igrača u zelenoj sobi nakon dva promatranja biti 51% – 21% da će doći iz crvene sobe, 5% da će igrač posjetiti plavu sobu između njih, i 25% da igrač uopće neće napustiti zelenu sobu.
Tablica je samo vizualni alat - postupak zahtijeva samo množenje vjerojatnosti na svakom koraku. To znači da možete zagledati daleko u budućnost uz jedan uvjet: pretpostavljamo da je šansa da uđete u sobu potpuno ovisna o trenutnoj sobi. Ovo se naziva Markovljevom svojstvom - buduće stanje ovisi samo o sadašnjosti. No, to nije stopostotno točno. Igrači mogu mijenjati odluke ovisno o drugim faktorima: razina zdravlja ili količina municije. Budući da ne bilježimo te vrijednosti, naši će prognoze biti manje točne.
N-Grame
A što je s primjerom borbene igre i predviđanjem kombinacijskih poteza igrača? Ista stvar! No, umjesto jednog stanja ili događaja, istraživat ćemo cijele sekvence od kojih se sastoji kombinirani udar.
Jedan od načina da to učinite je pohraniti svaki unos (npr. Kick, Punch ili Block) u međuspremniku i zapisati cijeli međuspremnik kao događaj. Tako, igrač neprestano pritisne Kick, Kick, Punch kako bi izvodio napad SuperDeathFist; sustav AI pohranjuje sve unose u međuspremniku i pamti posljednja tri, koja se koriste na svakom koraku.
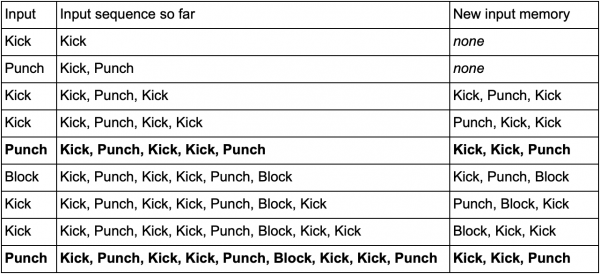
(Podebljane su linije kada igrač započinje napad SuperDeathFist.)
AI će vidjeti sve opcije kada je igrač odabrao Kick, zatim još jedan Kick, a nakon toga primijetiti da je sljedeći unos uvijek Punch. To će agentu omogućiti da prognozira kombinacijski potez SuperDeathFist i blokira ga, ako je moguće.
Te sekvence događaja nazivaju se N-gramima, gdje je N broj pohranjenih elemenata. U prethodnom primjeru bila je to 3-grama (trigram), što znači: prva dva unosa koriste se za predviđanje trećeg. Prema tome, u 5-grami prva četiri unosa predviđaju peti i tako dalje.
Razvijatelj treba pažljivo odabrati veličinu N-grama. Manji broj N zahtijeva manje memorije, ali također pohranjuje manju povijest. Na primjer, 2-grama (bigram) će pohranjivati Kick, Kick ili Kick, Punch, ali neće moći pohraniti Kick, Kick, Punch, stoga AI neće reagirati na kombinaciju SuperDeathFist.
S druge strane, veći brojevi zahtijevaju više memorije i AI će se teže obučiti, jer će se pojaviti mnogo više mogućih opcija. Ako ste imali tri moguća unosa Kick, Punch ili Block, a koristili smo 10-gramu, dobit ćemo oko 60 tisuća različitih varijanti.
Modela bigram je jednostavan Markovljev lanac — svaki par "prošlo stanje/trenutno stanje" je bigram, a možete predvidjeti drugo stanje na temelju prvog. 3-gram i veći N-grami također se mogu smatrati Markovljevim lancima, gdje svi elementi (osim posljednjeg u N-gramu) zajedno čine prvo stanje, a posljednji element je drugo. Primjer s borbenom igrom prikazuje šansu prijelaza iz stanja Kick i Kick u stanje Kick i Punch. Razmatrajući više zapisa ulazne povijesti kao jednu jedinicu, u suštini, transformiramo ulaznu sekvencu u dio cjelokupnog stanja. To nam daje Markovsku osobinu koja omogućuje korištenje Markovljevih lanaca za predviđanje sljedećeg unosa i pogađanje koji će combo-potez biti sljedeći.
Zaključak
Razgovarali smo o najčešće korištenim alatima i pristupima u razvoju umjetne inteligencije. Također smo razmotrili situacije u kojima ih treba primijeniti i gdje su posebno korisni.
To bi trebalo biti dovoljno za razumijevanje osnovnih stvari u igračkoj AI. No, naravno, to nije iscrpan popis svih metoda. Manje popularne, ali jednako učinkovite uključuju:
- optimizacijske algoritme, uključujući uspon po brdima, gradijentni spust i genetske algoritme
- takmičarske algoritme pretraživanja/planiranja (minimax i alpha-beta pruning)
- klasifikacijske metode (perceptroni, neuronske mreže i mašine potpornih vektora)
- sustave za obradu percepcije i memorije agenata
- arhitektonske pristupe AI (hibridni sustavi, podgrupe arhitektura i drugi načini preklapanja AI sustava)
- alate za animaciju (planiranje i usklađivanje pokreta)
- faktore performansi (razina detaljnosti, anytime algoritmi, i timeslicing)
Internetski resursi na temu:
1. Na GameDev.net postoji , kao i .
2. sadrži brojne prezentacije i članke o širokom spektru povezanih s razvojem igračkog AI-a.
3. uključuje teme sa summita GDC AI, od kojih su mnoge dostupne besplatno.
4. Korisni materijali također se mogu pronaći na stranici .
5. Tommy Thompson, istraživač AI-a i razvoj igara, objavljuje videe na YouTube kanalu s objašnjenjem i proučavanjem AI-a u komercijalnim igrama.
Knjige na temu:
1. Serija knjiga Game AI Pro predstavlja zbirke kratkih članaka koji objašnjavaju kako implementirati specifične funkcije ili kako rješavati određene probleme.
2. Serija AI Game Programming Wisdom — prethodnik serije Game AI Pro. Sadrži starije metode, ali gotovo sve su još uvijek relevantne danas.
3. — to je jedan od osnovnih tekstova za sve koji žele razumjeti opće područje umjetne inteligencije. Ova knjiga nije o razvoju igara — ona poučava osnovne principe AI.
Izvor: habr.com
