

Razvili smo dizajn mreže data centara koji omogućava implementaciju računalnih klastera većih od 100 tisuća poslužitelja s vršnom propusnošću (bisection bandwidth) većom od jednog petabajta u sekundi.
Iz izvještaja Dmitrija Afanasjeva saznat ćete o glavnim načelima novog dizajna, skaliranju topologija, problemima koji se pojavljuju, mogućim rješenjima, karakteristikama usmjeravanja i skaliranja funkcija forwarding plane suvremenih mrežnih uređaja u 'gusto' (densely connected) topologijama s velikim brojem ECMP ruta. Također, Dima je ukratko govorio o organizaciji vanjske povezanosti, fizičkom sloju, sustavu kabela i načinima daljnjeg povećanja kapaciteta.
— Dobar dan svima! Ja sam Dmitrij Afanasjev, mrežni arhitekt Yandexa i prvenstveno se bavim dizajnom mreža data centara.
Moj govor će biti o ažuriranim mrežama data centara Yandexa. To je u značajnoj mjeri evolucija dizajna koji smo imali, ali u isto vrijeme postoje i neki novi elementi. Ovo je pregledna prezentacija jer je trebalo strpati dosta informacija u kratko vrijeme. Počinjemo s odabirom logičke topologije. Zatim ćemo dati pregled control plane i problema s skalabilnošću data plane, odabrati što će se događati na fizičkom nivou, a pogledat ćemo i na neke karakteristike uređaja. Dotaknuti ćemo se i onoga što se događa u data centru s MPLS-om, o kojem smo razgovarali prije nekog vremena.
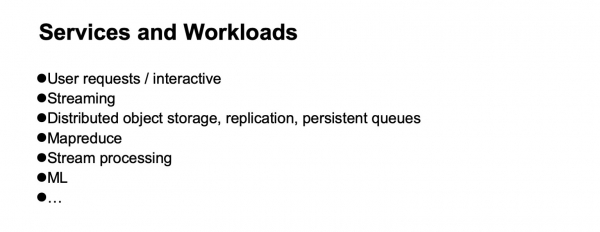
Dakle, što je Yandex s obzirom na opterećenja i usluge? Yandex je tipičan hyperscaler. Kada gledamo prema korisnicima, prvo se obrađuju korisnički upiti. Također, tu su različite streaming usluge i isporuka podataka, jer imamo i storage usluge. Kada gledamo prema backendu, pojavljuju se infrastrukturna opterećenja i usluge, poput distribuiranih objektnih pohrana, replikacije podataka i, naravno, persistent queues. Jedan od glavnih tipova opterećenja su MapReduce i slični sustavi, obrada streamova, strojno učenje itd.
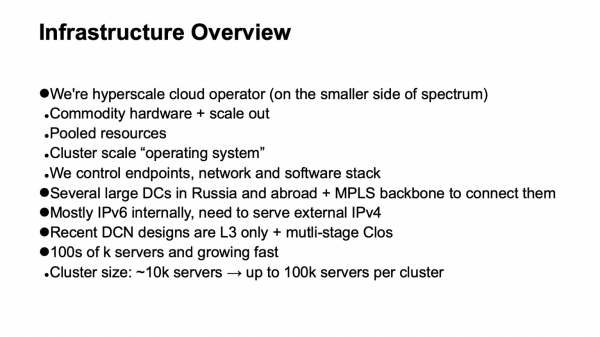
Kako je postavljena infrastruktura na kojoj se sve ovo temelji? Opet, mi smo sasvim tipični hiperskalir, iako smo možda malo bliže onoj strani spektra gdje se nalaze manji hiperskaliri. Ali imamo sve atribute. Koristimo commodity hardware i horizontalno skaliranje gdje god je to moguće. Imamo potpuno prisutno poolanje resursa: ne radimo s pojedinačnim strojevima ili rackovima, već ih ujedinjavamo u veliki bazen zamjenjivih resursa s dodatnim uslugama koje se bave planiranjem i alokacijom, te radimo sa svim tim bazenom.
Tako dolazimo do sljedeće razine — operativnih sustava razine računalnog klastera. Vrlo je važno što potpuno kontroliramo tehnologijski stik koji koristimo. Kontroliramo krajnje točke (hostove), mrežu i programski stik.
Imamo nekoliko velikih podatkovnih centara u Rusiji i inozemstvu. Njih povezuje backbone koji koristi MPLS tehnologiju. Naša unutarnja infrastruktura gotovo je potpuno izgrađena na IPv6, no s obzirom na to da moramo opsluživati vanjski promet, koji još uvijek dolazi uglavnom putem IPv4, moramo na neki način dostaviti zahtjeve koji dolaze putem IPv4 do frontend-poslužitelja, i malo se još kretati prema vanjskom IPv4 internetu — na primjer, za indeksiranje.
Posljednjih nekoliko iteracija dizajna mreža podatkovnih centara koristi višeslojne Clos topologije, a u njima se primjenjuje samo L3. Odlazili smo od L2 prije nekog vremena i odahnuli. Na kraju, naša infrastruktura uključuje stotine tisuća računalnih (serverskih) instanci. Maksimalna veličina klastera prije nekog vremena bila je oko 10 tisuća servera. Ovo je u značajnoj mjeri uvjetovano time kako mogu raditi ti operativni sustavi razine klastera, planeri, alokacija resursa itd. Kako je došlo do napretka na strani infrastrukturnog softvera, cilj je doseg od oko 100 tisuća servera u jednom računalnom klasteru, i imamo zadatak — znati izgraditi mrežne tvornice koje omogućuju učinkovito poolanje resursa u takvom klasteru.
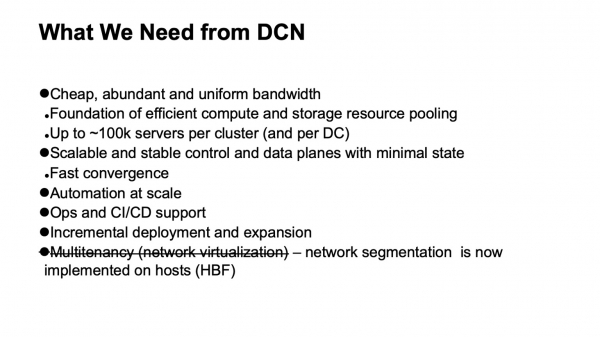
Što želimo od mreže podatkovnog centra? Prije svega, mnogo jeftinog i dovoljno ravnomjerno raspoređenog propusnog opsega. Jer mreža je temelj na temelju kojeg možemo vršiti pooling resursa. Nova ciljna veličina je oko 100 tisuća poslužitelja u jednom klasteru.
Također, naravno, želimo skalabilnu i stabilnu upravljačku platformu, jer na tako velikoj infrastrukturi se često javljaju problemi, čak i zbog slučajnih događaja, a ne želimo da nam i upravljačka platforma stvara glavobolje. Pri tome želimo minimalizirati stanje u njoj. Što manje stanja, to bolje i stabilnije sve funkcionira, lakše je dijagnosticirati.
Naravno, potrebna nam je automatizacija, jer ručno upravljanje takvom infrastrukturom je nemoguće, a to je već odavno postalo nemoguće. Potrebna nam je podrška operativnim aktivnostima i CI/CD podrška, koliko god to bilo moguće.
Kod takvih veličina podatkovnih centara i klastera postavljen je problem podrške inkrementalnom implementacijama i proširenju bez prekida usluge. Ako se na klasterima veličine tisuću strojeva, možda bliže desetak tisuća strojeva, oni još uvijek mogu implementirati kao jednu operaciju — to jest, planiramo proširenje infrastrukture, a nekoliko tisuća strojeva dodaje se kao jedna operacija, tada klaster veličine do sto tisuća strojeva ne nastaje odmah, nego se gradi tijekom određenog vremena. I poželjno je da tijekom tog vremena infrastruktura koja je već implementirana bude dostupna.
I jedan zahtjev koji smo imali, a koji je nestao: to je podrška multitenantnosti, dakle virtualizacije ili segmentacije mreže. Sada to ne trebamo raditi na razini mrežne fabrike, jer je segmentacija prebačena na hote, što nam je značajno olakšalo skaliranje. Zahvaljujući IPv6 i velikom adresnom prostoru, nismo trebali koristiti duplicirane adrese u unutrašnjosti infrastrukture, sva adresacija je već bila jedinstvena. A budući da smo filtriranje i segmentaciju mreže prebacili na hote, ne trebamo stvarati nikakve virtualne mrežne entitete unutar mreža podatkovnih centara.
Vrlo važna stvar je to što nam ne treba. Ako se neke funkcije mogu ukloniti iz mreže, to uvelike olakšava život i obično proširuje izbor dostupne opreme i softvera, a također značajno olakšava dijagnostiku.
Dakle, što nam ne treba, od čega smo se mogli odreći, ne uvijek s radošću u trenutku kada se to događalo, ali s velikim olakšanjem kada je proces završio?
Prvo, odustajanje od L2. Ne trebamo L2 ni stvarni ni emulirani. Ne koristi se u značajnoj mjeri jer kontroliramo stog aplikacija. Naše aplikacije su horizontalno skalirane, rade s L3 adresiranjem, i ne brinu se previše što je neki pojedinačni instanca isključena, već jednostavno otpuštaju novi, ne mora izlaziti na staroj adresi jer postoji poseban sloj za otkrivanje usluga i praćenje mašina unutar klastera. Tu zadaću ne prebacujemo na mrežu. Zadatak mreže je isporučiti pakete iz točke A u točku B.
Također nemamo situacije u kojima se adrese kreću unutar mreže i to treba pratiti. U mnogim dizajnima to je obično potrebno za održavanje mobilnosti VM-a. Ne koristimo mobilnost virtualnih mašina unutar interne infrastrukture velikog Yandexa, a osim toga, smatramo da, čak i ako se to radi, ne bi trebalo biti potpomognuto mrežom. Ako je stvarno potrebno, to se treba raditi na razini hostova, i adrese koje mogu migrirati treba smjestiti u overlay mreže kako ne bismo previše dirali i pravili previše dinamičkih promjena u sustavu usmjeravanja same underlay (transportne mreže).
Još jedna tehnologija koju ne koristimo je multicast. Rado ću objasniti zašto. To uvelike olakšava život jer, ako je netko imao iskustva s njim i gledao kako izgleda control plane multikasta - u svim instalacijama osim najjednostavnijih, to je velika glavobolja. Štoviše, teško je pronaći dobro funkcionirajuću otvorenu implementaciju, na primjer.
I konačno, projektiramo naše mreže tako da u njima ne bude previše promjena. Možemo se osloniti na to da je protok vanjskih događaja u sustavu usmjeravanja mali.
Koje se probleme javljaju i koja ograničenja treba imati na umu prilikom dizajniranja mreže data centra? Cijena, naravno. Skalabilnost, do kojeg nivoa želimo rasti. Potreba za proširenjem bez prekida usluge. Propusnost, dostupnost. Vidljivost onoga što se događa u mreži, za sustave nadzora, za operativne timove. Podrška automatizaciji — opet, koliko je to moguće, budući da se različiti zadaci mogu rješavati na različitim razinama, uključujući uvođenje dodatnih slojeva. Pa, i ne-[ovisnost]-o dobavljačima. Iako je u različitim povijesnim razdobljima, ovisno o vremenskom razdoblju na koje se gleda, ta neovisnost bila lakša ili teža za postizanje. Ako uzmemo rez čipova mrežnih uređaja, do nedavno se o neovisnosti o dobavljačima, ako smo željeli i čipove s velikom propusnošću, moglo govoriti vrlo uvjetno.
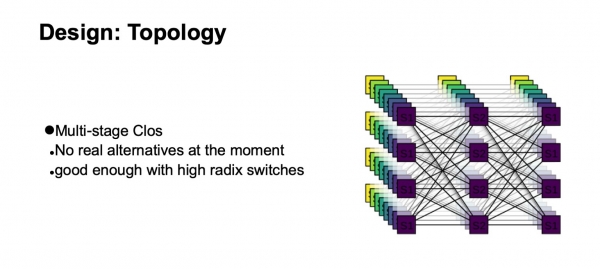
Prema kojoj logičkoj topologiji ćemo graditi našu mrežu? To će biti više nivojski Clos. U stvari, trenutno ne postoje stvarne alternative. I Clos topologija je dovoljno dobra, čak i ako je usporedimo s različitim naprednim topologijama koje su više u domenu akademskog interesa, ako imamo prekidače s visokim radiksom.
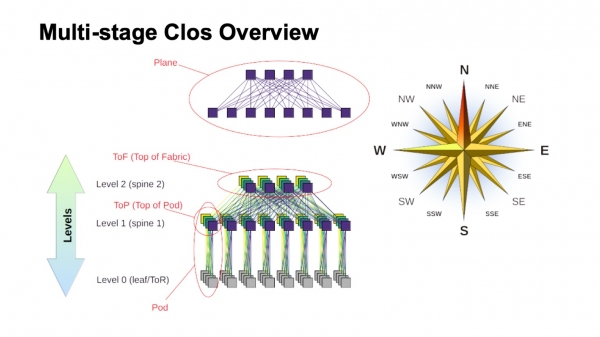
Kako otprilike izgleda višeslojna Clos mreža i kako se nazivaju različiti elementi u njoj? Prvo, rosa vjetrova, da se orijentiramo gdje je sjever, gdje jug, gdje istok, gdje zapad. Mreže ovog tipa obično grade oni koji imaju vrlo veliki promet istok — zapad. Što se tiče ostalih elemenata, na vrhu je prikazan virtualni prekidač sastavljen od manjih prekidača. To je osnovna ideja rekurzivnog građenja Clos mreža. Uzimamo elemente s nekim radiksom i povezujemo ih tako da ono što dobijemo možemo smatrati prekidačem s većim radiksom. Ako je potrebno još više, postupak se može ponoviti.
U slučajevima, poput dvonivojnih Clos arhitektura, kada se jasno mogu izdvojiti komponente koje su na mom dijagramu vertikalne, one se obično nazivaju ravninama. Kada bismo gradili Clos sa tri nivoa spine switcheva (svi koji nisu granični i ne ToR switchevi, a koji se koriste samo za tranzit), ravnine bi izgledale složenije, dok dvonivojni izgledaju ovako. Blok ToR ili leaf switcheva i povezani spine switchevi prvog nivoa nazivamo Pod. Spine switchevi nivoa spine-1 na vrhu Poda su top of Pod, vrh Poda. Switchevi koji se nalaze na vrhu cele fabrike su gornji sloj fabrike, Top of fabric.
Naravno, postavlja se pitanje: Clos mreže se grade već neko vreme, a sama ideja potiče još iz vremena klasične telefonije i TDM mreža. Možda se pojavilo nešto bolje, možda se može učiniti bolje? I da, i ne. Tehnički da, ali u praksi u bliskoj budućnosti sigurno ne. Postoji određeni broj zanimljivih topologija, neke od njih se čak koriste u proizvodnji, na primer, Dragonfly se koristi u HPC aplikacijama; postoji takođe zanimljive topologije poput Xpander, FatClique, Jellyfish. Ako pogledate izlaganja na konferencijama poput SIGCOMM-a ili NSDI-a u poslednje vreme, može se primetiti relativno veliki broj radova na alternativnim topologijama koje imaju bolje osobine (ovakve ili onakve) od Clos-a.
Ali sve te topologije imaju jednu zanimljivu osobinu. Ona sprečava njihovu implementaciju u mrežama data centara koje pokušavamo graditi na commodity hardveru i koje koštaju dovoljno razumne novce. U svim tim alternativnim topologijama, nažalost, velika većina propusnosti nije dostupna preko najkraćih putanja. Stoga odmah gubimo mogućnost korišćenja tradicionalnog kontrolnog sistema.
Tehnički, rešenje ovog problema je poznato. To su, na primer, modifikacije link state sa korišćenjem k-shortest path, ali, opet, ne postoje takvi protokoli koji su implementirani u proizvodnji i masovno dostupni na opremi.
Štoviše, budući da je velika većina kapaciteta dostupna ne najkraćim putovima, moramo modificirati ne samo kontrolnu ravninu kako bi birala sve te putove (usput, ovo predstavlja znatno veće stanje u kontrolnoj ravni). Također moramo modificirati ravninu prosljeđivanja, a obično su potrebne najmanje dvije dodatne funkcije. To je mogućnost donošenja svih odluka o prosljeđivanju paketa odjednom, na primjer, na hostu. U stvarnosti, ovo je izvorno usmjeravanje, ponekad u literaturi o međusobnom povezivanju nazivaju se odlukama o prosljeđivanju svakodnevno. I još adaptivno usmjeravanje — to je već funkcija koja nam je potrebna na mrežnim elementima, svodeći se, primjerice, na to da biramo sljedeći hop na temelju informacija o najmanjoj opterećenosti reda. Kao primjer, moguće su i druge varijante.
Dakle, smjer je zanimljiv, ali, nažalost, trenutno ga ne možemo primijeniti.
OK, zaustavljamo se na logičkoj topologiji Clos. Kako ćemo je skalirati? Pogledajmo kako je strukturirana i što se može učiniti.
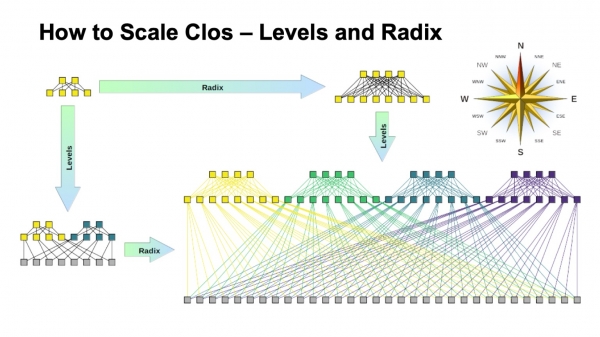
U Clos mreži postoje dva osnovna parametra koja možemo varirati i dobiti tako različite rezultate: radix elemenata i broj razina u mreži. Imamo shematski prikaz kako to oboje utječe na veličinu. U idealnom slučaju kombiniramo i jedno i drugo.
Vidljivo je da je završna širina Clos mreže proizvod po svim razinama spine switcheva južnog radiksa, koliko imamo linkova prema dolje, kako se grana. Ovo je način na koji skaliramo veličinu mreže.
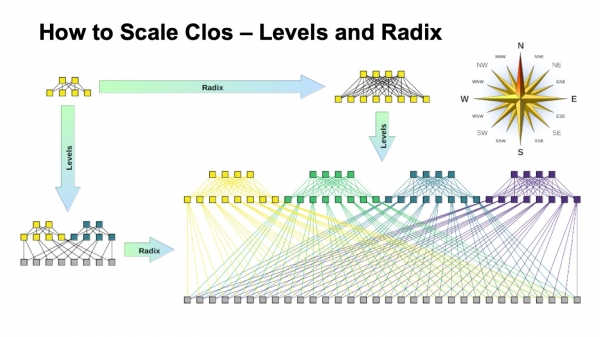
Što se tiče kapaciteta, posebno na ToR switchevima, postoje dvije opcije skaliranja. Ili možemo, zadržavajući opću topologiju, koristiti brže linkove, ili možemo dodavati veći broj ravnina.
Ako pogledamo rašireni prikaz Clos mreže (u donjem desnom kutu) i vratimo se na ovu sliku s Clos mrežom dolje...
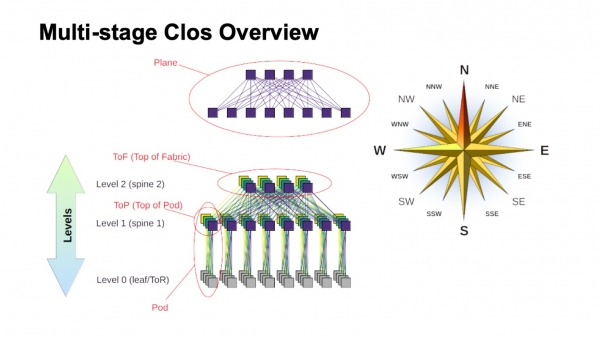
...to je točno ista topologija, ali je na ovoj slajdu stisnuta kompaktnije i ravnine fabrike su preklopljene jedna na drugu. To je isto.
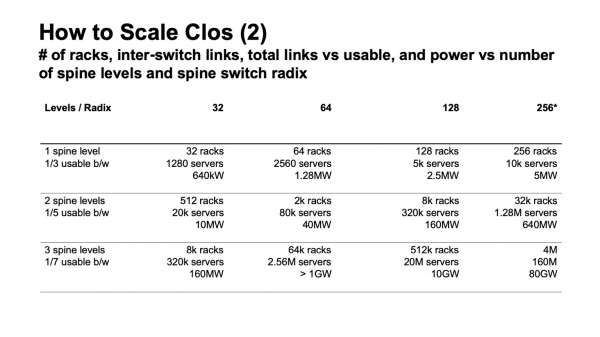
Kako izgleda skaliranje Clos mreže u brojkama? Ovdje su navedeni podaci o maksimalnoj širini koju mreža može imati, koliko maksimalan broj ormarića, ToR switcheva ili leaf switcheva, ako nisu smješteni u ormarićima, možemo dobiti ovisno o tome koji nam je radix switcheva, korištenih za spine razine, a koliko razina koristimo.
Ovdje je prikazano koliko imamo regala, koliko servera i približno koliko sve to može trošiti prema procjeni od 20 kW po regalu. Malo prije sam spomenuo da ciljamo na veličinu klastera od otprilike 100 tisuća servera.
Vidljivo je da unutar ove konstrukcije zanimanje predstavljaju dva i pol varijante. Postoji varijanta s dva sloja spine i 64-portnim switchevima koja malo zaostaje. Zatim su tu izvrsno uklopljene varijante za 128-portne (s radiksom 128) spine switcheve s dva nivoa, ili switchevi s radiksom 32 s tri nivoa. I u svim slučajevima, s većim radiksom i više nivoa, može se napraviti vrlo velika mreža, ali ako pogledate očekivanu potrošnju, obično su to gigavati. Kablirati se može, ali toliko električne energije na jednoj lokaciji teško ćemo dobiti. Ako pogledate statistiku, javne podatke o data centrima — vrlo malo se može pronaći data centara s procijenjenom snagom većom od 150 MW. Ono što je veće obično su data centri kampusi, nekoliko velikih data centara smještenih dovoljno blizu jedni drugima.
Postoji još jedan važan parametar. Ako pogledate lijevu kolonu, tamo je navedena upotrebljiva propusnost. Nije teško primijetiti da u Clos mreži značajan dio portova odlazi na povezivanje switcheva međusobno. Upotrebljiva propusnost, korisna propusnost, — to je ono što se može povezati napolje, prema serverima. Naravno, govorim o teoretskim portovima i konkretno o propusnosti. Obično su linkovi unutar mreže brži od linkova prema serverima, ali za jedinicu propusnosti, koliko je možemo izdati prema našem server opremi, dolazi još neka propusnost unutar same mreže. I što više nivoa napravimo, to su veći specifični troškovi za pružanje ove propusnosti napolje.
Štoviše, čak ni ova dodatna propusnost nije sasvim jednaka. Dok su rasponi kratki, možemo koristiti nešto poput DAC (direct attach copper, tj. twinax kablovi), ili multimodnu optiku, koja još uvijek košta relativno razumnu cijenu. Čim pređemo na dulje raspon i — obično je to single mode optika, a trošak te dodatne propusnosti značajno raste.
I ponovno, vraćajući se na prethodni slajd, ako gradimo Clos mrežu bez ponovne potpisivanja, nije teško pogledati shemu i vidjeti kako je mreža izgrađena — dodajući svaki nivo spine switch-eva, ponavljamo cijeli opseg koji je bio na dnu. Plus nivo — plus cijela ta ista širina, još toliko koliko je bilo na prethodnom nivou, portova na switchevima, opet toliko transceivera. Stoga je poželjno minimizirati broj nivoa spine switch-eva.
Na osnovu ove slike, jasno je da se želimo graditi na nečemu poput switcheva s radiksom 128.
Ovdje je u suštini sve isto što sam sada ispričao, ovaj slajd je više za kasnije razmatranje.
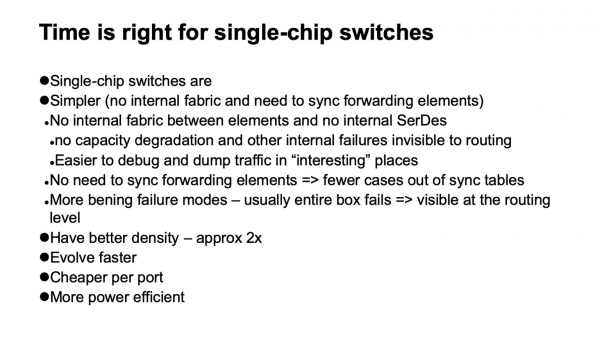
Koje su mogućnosti, što možemo odabrati kao takve switcheve? Vrlo dobra vijest za nas je da se sada konačno mogu graditi takve mreže na jedničipnim switchevima. To je sjajno, imaju mnogo dobrih karakteristika. Na primjer, gotovo da nemaju unutarnju strukturu. To znači da se lakše kvare. Kvare se, naravno, ali se, na sreću, kvare cijeli. U modularnim uređajima ima mnogo kvarova (vrlo neugodnih), kada s gledišta susjeda i kontrolne ravni izgleda da funkcionira, ali, na primjer, nedostaje mu dio fabrike, i ne radi punim kapacitetom. A promet se ravnoteži na temelju onoga što je potpuno funkcionalno, a možemo doći do preopterećenja.
Ili, na primjer, javljaju se problemi s backplane-om, jer unutar modularnog uređaja također postoji visoko brzi SerDes-ovi — struktura je unutra zapravo složena. Ili su mu tablice sinkronizirane ili nisu sinkronizirane između forwarding elemenata. U svakom slučaju, bilo koji proizvodni modularni uređaj, koji se sastoji od velikog broja elemenata, obično unutar sebe sadrži istu Clos mrežu, samo što je jako teško dijagnosticirati. Često čak i samim dobavljačima je teško dijagnosticirati.
I ima veliki broj scenarija grešaka u kojima uređaj degradira, ali ne ispada potpuno iz topologije. Budući da imamo veliku mrežu, aktivno se koristi uravnoteženje između identičnih elemenata, mreža je vrlo redovna, to jest jedan put, na kojem je sve u redu, ne razlikuje se od drugog puta, isplativije nam je jednostavno izgubiti dio uređaja iz topologije nego se suočiti sa situacijom u kojoj neki od njih izgleda rade, a izgleda i ne rade.
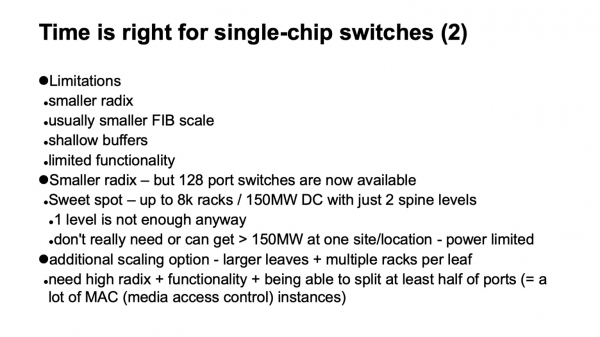
Sljedeća prijatna osobina uređaja s jednim čipom – oni evoluiraju bolje, brže. Također, obično imaju bolji kapacitet. Ako uzmemo velike sastavljene konstrukcije koje imamo, na krug, kapacitet po rack-jedini od portova iste brzine ispada gotovo dvostruko bolji nego kod modularnih uređaja. Uređaji koji su izgrađeni oko jednog čipa ispostavljaju se znatno jeftinijima od modularnih i troše manje energije.
Ali, naravno, sve to nije bez razloga, postoje i nedostaci. Prvo, gotovo uvijek manji radiks od modularnih uređaja. Ako možemo dobiti uređaj izgrađen oko jednog čipa s 128 portova, modularni možemo dobiti već na nekoliko stotina portova bez ikakvih problema.
To je primjetno manja veličina tablica za prosljeđivanje i, u pravilu, svega što se tiče skalabilnosti data plane-a. Plitki baferi. I, obično, prilično ograničena funkcionalnost. No, pokazuje se da ako znate ova ograničenja i na vrijeme se pobrinete da ih zaobiđete ili jednostavno uzmete u obzir, nije tako strašno. Manji radiks više nije problem na novijim uređajima sa radiksom od 128, možemo se izgraditi u dva sloja spine-a. A ispod dva ništa zanimljivo za nas u veličini se ionako ne može izgraditi. S jednim nivoom dobijamo posve male klastere. Čak su i naši prethodni dizajni i zahtjevi ionako premašili.
U stvarnosti, ako je rješenje negdje na rubu, postoji još jedan način za skaliranje. Budući da je posljednji (ili prvi), najniži nivo gdje se poslužitelji povezuju — ToR switchevi ili leaf switchevi, ne moramo ih povezivati samo na jednu ormar. Stoga, ako rješenje ne doseže negdje do dvostruko, možemo razmisliti o korištenju prekidača s većim radikalom na donjem nivou i povezivanju, na primjer, dva ili tri ormara na jedan prekidač. To je također opcija, ima svoje troškove, ali vrlo dobro funkcionira i može se pokazati kao dobro rješenje kada je potrebno povećati veličinu negdje do dvostruko.
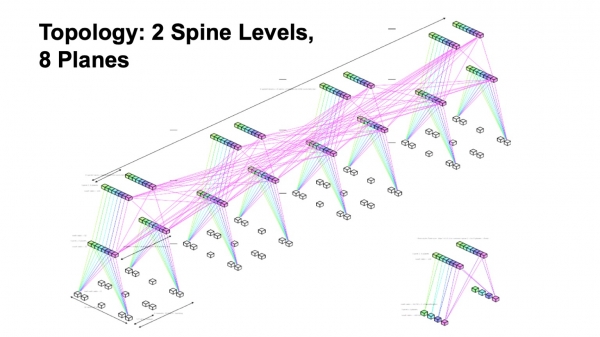
Završavajući, gradimo se prema topologiji s dva nivoa spine, s osam slojeva fabrike.
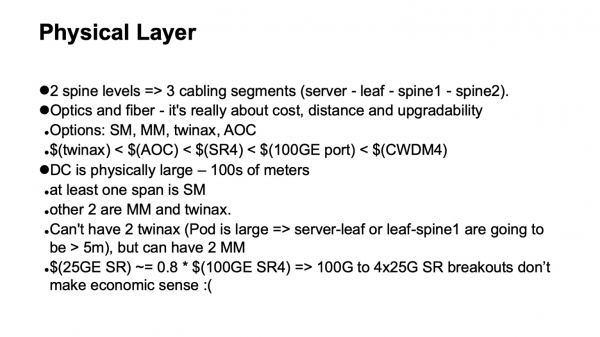
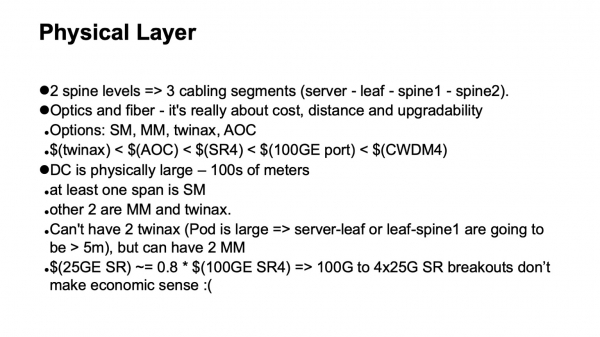
Što će se dogoditi s fizičkim aspektima? Vrlo jednostavne kalkulacije. Ako imamo dva nivoa spine, to znači da imamo ukupno tri nivoa prekidača, i očekujemo da će u mreži biti tri kabelska segmenta: od poslužitelja do leaf switcheva, do spine 1, do spine 2. Opcije koje možemo koristiti su twinax, multimode, single mode. I ovdje treba uzeti u obzir koja je dostupna propusnost, kolika će to biti cijena, koji su fizički dimenzije, koje razmake možemo preći i kako ćemo se nadograditi.
Što se tiče cijene, sve se može postaviti u liniju. Twinax je znatno jeftiniji od aktivne optike, jeftiniji od multimode transceivers, kada se uzima na razmak od kraja, nešto jeftiniji od 100-gigabitnog porta prekidača. I on, pažnja, je jeftiniji od single mode optike, jer se na razmacima gdje je potrebna single mode, u data centrima iz raznih razloga smisleno koristi CWDM, paralelni single mode (PSM) nije baš praktičan, dolazi do vrlo velikih paketa vlakana, i ako se zadržimo na tim tehnologijama, dobijemo otprilike takvu hijerarhiju cijena.
Još jedna napomena: nažalost, nije baš moguće koristiti razdvojene 100 na 4x25 multimode portove. Zbog osobitosti konstrukcije transceiversa SFP28 nije mnogo jeftiniji od QSFP28 na 100 Gb. I ova razdvajanje za multimode ne funkcionira baš dobro.
Jedno dodatno ograničenje je da zbog veličine računalnih klastera i broja servera naši podatkovni centri postaju fizički veliki. To znači da će barem jedan prolaz morati biti izveden s jednim modom. Ponovno, zbog fizičke veličine Pods, neće biti moguće proći dva prolaza twinax žicama (bakarnim kablovima).
Na kraju, ako optimiziramo troškove i uzmemo u obzir geometriju te konstrukcije, dobit ćemo jedan prolaz twinaxom, jedan prolaz multimodom i jedan prolaz jednim modom koristeći CWDM. To uzima u obzir moguće putove za nadogradnju.
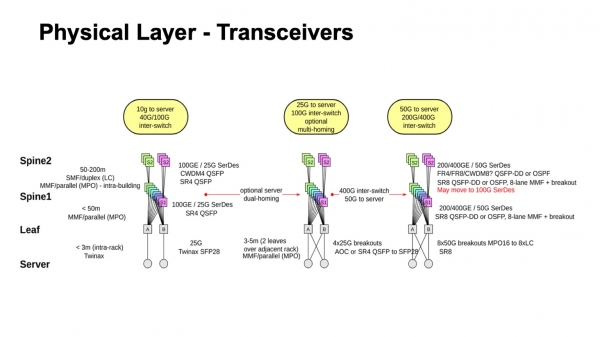
Otprilike ovako izgleda, što je nedavno bilo, kamo idemo i što je moguće. Jasno je, barem, kako se kretati prema 50-gigabitnim SerDes i za multimod i za jednim modom. Štoviše, ako pogledamo što imamo u jednim mod transiverima sada i u budućnosti za 400G, često se događa da kada dolaze 50G SerDes s električne strane, onda u optiku može ići već 100 Gbps po traci. Stoga je vrlo moguće da umjesto prelaska na 50 dođe do prelaska na 100-gigabitne SerDes i 100 Gbps po traci, jer se prema obećanjima mnogih dobavljača njihova dostupnost očekuje relativno brzo. Razdoblje kada su 50G SerDes bili najbrži čini se da neće dugo trajati, jer će 100G SerDes biti predstavljeni već sljedeće godine.
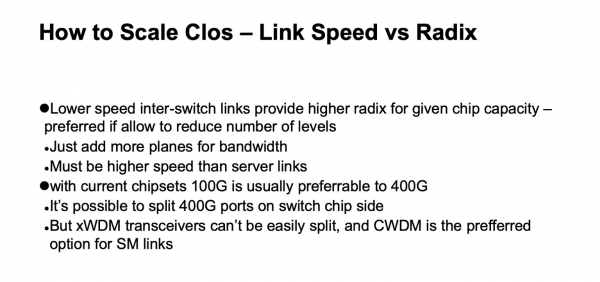
Još jedna nijansa u vezi s odabirom fizike. U principu, već sada možemo primijeniti 400- ili 200-gigabitne portove koristeći 50G SerDes. No, ispostavlja se da u tome nema posebnog smisla, jer, kao što sam ranije spomenuo, želimo imati dovoljno velik radiks na preklopnicima, naravno, unutar razumnog okvira. Želimo 128. A ako imamo ograničenu propusnost čipa i povećavamo brzinu veze, radiks se prirodno smanjuje, čuda nema.
A ukupnu propusnost možemo povećati povećanjem broja ravnina, pri čemu nema značajnih troškova, možemo dodati broj ravnina. A ako izgubimo radiks, morat ćemo uvesti dodatnu razinu, stoga prema trenutnim izračunima i maksimalnoj dostupnoj propusnosti na jedan čip, čini se da je učinkovitije koristiti 100-gigabitne portove, jer omogućuju veći radiks.
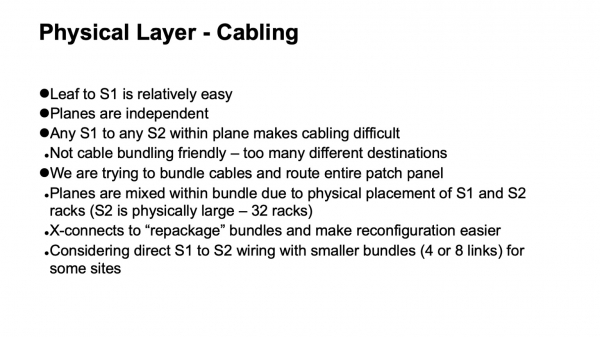
Sljedeće pitanje je kako je organizirana fizika, ali iz perspektive kabelske infrastrukture. Ispostavlja se da je ona organizirana prilično zanimljivo. Kabeli između leaf-switchova i prvog razreda spine-switcheva — tu nema previše veza, sve je relativno jednostavno. Međutim, ako uzmemo jednu razinu, ono što se odvija unutar — potrebno je povezati sve spine-switcheve prvog razreda sa svim spine-switchevima drugog razreda.
Osim toga, obično postoje određene želje o tome kako bi to trebalo izgledati unutar data centra. Na primjer, željeli smo spojiti kablove u bundle i povući ih tako da se jedna visoko gustoća patch-panel odvede u potpunosti u drugi patch-panel, kako ne bi bilo 'zoo' po dužinama. Usponili smo riješiti taj zadatak. Ako isprva pogledamo logičku topologiju, može se vidjeti da su razine neovisne, svaka razina može se graditi sama za sebe. No, kada dodamo takvo bundling i želimo potpuno povući patch-panel u patch-panel, onda moramo unutar jednog bundla miješati različite razine i uvesti međustrukturu u obliku optičkih cross-connect-a, kako bismo ih prepakirali od onoga kako su bili sastavljeni na jednom segmentu, u ono kako će biti sastavljeni na drugom segmentu. Zahvaljujući tome dobivamo lijepu značajku: cijela složena komunikacija ne izlazi iz okvira ormarića. Kada je potrebno nešto snažno ispreplesti, 'rasvijetliti razine', kako se to ponekad naziva u Clos-mrežama, sve se to koncentrira unutar jednog ormarića. Nemamo jako raštrkanih, do pojedinačnih veza, komunikacija između ormarića.
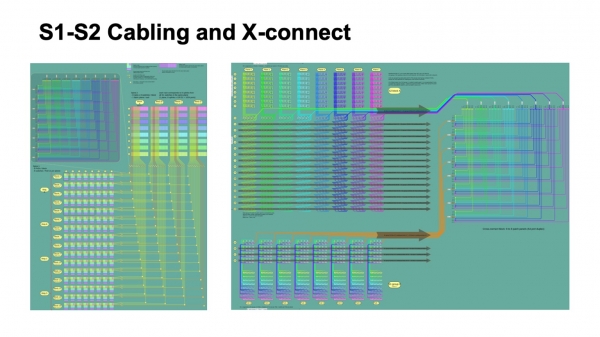
Ovako to izgleda iz perspektive logičke organizacije kabelske infrastrukture. Na slici lijevo, šareni blokovi prikazuju blokove spine-switcheva prvog razreda, po osam komada, i četiri bundlea kablova koji idu od njih, te se ukrštaju s bundleima koji dolaze od blokova spine-2-switcheva.
Mali kvadrati označavaju presjeke. U gornjem lijevom kutu prikazana je razrada svakog takvog presjeka, što je zapravo modul za križne konekcije od 512 do 512 portova, koji prepakira kabele tako da dolaze u jedinstveni ormar, gdje postoji samo jedna razina spine-2. A s desne strane prikazana je razrada ove slike malo detaljnija u odnosu na nekoliko Pods na razini spine-1, i kako se to pakira u križnom konektoru, kako dolazi na razinu spine-2.
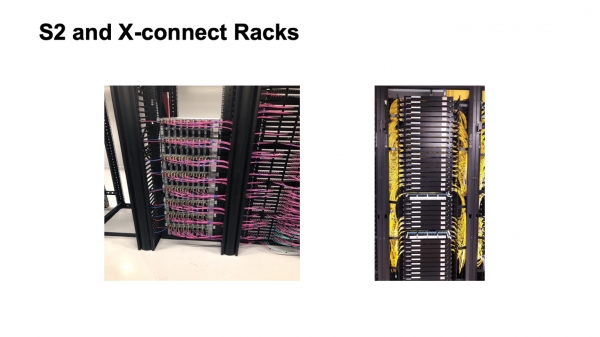
Evo kako to izgleda. Još nije potpuno sastavljen ormar spine-2 (lijevo) i ormar križnog konektora. Nažalost, nije baš mnogo toga vidljivo. Cijela ova konstrukcija se trenutno razvija u jednom od naših velikih data centara koji se širi. To je rad u tijeku, bit će lijepše, bit će bolje popunjeno.
Važno pitanje: odabrali smo logičku topologiju, izgradili fiziku. Što će biti s kontrolnom ravninom? Dosta je dobro poznato iz iskustva eksploatacije, postoji određeni broj izlaganja da su link state protokoli dobri, lijepo je raditi s njima, ali, nažalost, u gusto povezanim topologijama loše se skaliraju. I postoji jedan glavni faktor koji to sprječava — to je način na koji radi flooding u link state protokolima. Ako samo uzmemo algoritam flooding-a te pogledamo kako je naša mreža strukturirana, vidjet ćemo da će na svakom koraku biti vrlo veliki fanout, što će jednostavno preplaviti kontrolnu ravninu ažuriranjima. Konkretno takve topologije s tradicionalnim algoritmom flooding-a u link state protokolima se jako loše miješaju.
Odabir — koristiti BGP. Kako ga pravilno pripremiti, opisano je u RFC 7938 o korištenju BGP-a u velikim data centrima. Osnovne ideje su jednostavne: minimalan broj prefiksa na hostu i uopće minimalan broj prefiksa u mreži, koristiti agregaciju ako je moguće i suzbijati path hunting. Želimo vrlo pažljivo, vrlo kontrolirano širenje ažuriranja, ono što se naziva valley free. Želimo da se ažuriranja, prolazeći kroz mrežu, razvijaju točno jedanput. Ako se originišu dolje, idu prema gore, razvijaju se ne više od jednom. Ne smije biti ziggzaga. Ziggzagi su jako loši.
Da bismo to postigli, koristimo prilično jednostavnu shemu kako bismo iskoristili osnovne mehanizme BGP-a. To znači da koristimo eBGP koji radi na link lokalnom nivou, a autonomne sisteme dodeljujemo na sledeći način: autonomni sistem na ToR-u, autonomni sistem za ceo blok spine-1 prekidača jednog Pod-a, i zajednički autonomni sistem za ceo Top of Fabric. Nije teško pogledati i uveriti se da čak i normalno ponašanje BGP-a daje nam širenje ažuriranja koje želimo.
Naravno, potrebno je dizajnirati adresaciju i agregaciju adresa tako da bude u skladu sa načinom na koji je postavljena rutiranje, kako bi se obezbedila stabilnost kontrolne ravni. L3 adresacija u transportu povezana je s topologijom, jer bez toga ne možemo postići agregaciju; bez toga, pojedinačne adrese će ući u sistem rutiranja. Još jedna stvar je da se agregacija, nažalost, ne meša dobro sa multi-path, jer kada imamo multi-path i agregaciju, sve je u redu kada je cela mreža funkcionalna, bez grešaka. Nažalost, čim greške u mreži postanu prisutne i simetrija topologije se izgubi, možemo doći do tačke od koje je oglašena agregacija iz koje ne možemo dalje da prođemo tamo gde nam je potrebno. Zato je najbolje agregirati tamo gde dalje nema multi-path, u našem slučaju to su ToR prekidači.
Zapravo, moguće je agregirati, ali oprezno. Ako možemo da izvršimo kontrolisanu dezagregaciju prilikom pojave grešaka u mreži. Ali to je prilično složen zadatak; čak smo razmatrali da li je moguće dodati dodatnu automatizaciju i konačne automate koji će pravilno upravljati BGP-om kako bi se postiglo željeno ponašanje. Nažalost, obrada ugla slučajeva veoma je nejasna i složena, a povezivanjem spoljne opreme na BGP ovaj zadatak se ne rešava dobro.
Veoma zanimljiv rad u ovom smislu obavljen je u okviru RIFT protokola, o kojem će biti reči na sledećem predavanju.
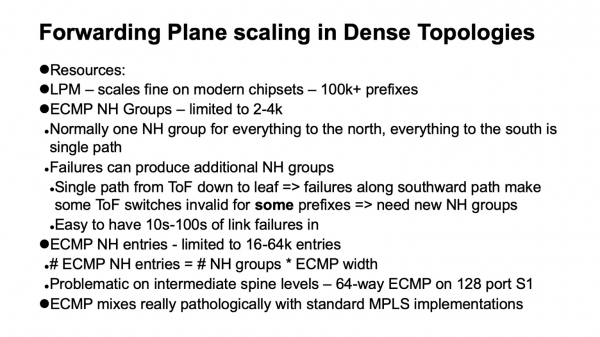
Još jedna važna stvar je kako se data plane skaliraju u gustim topologijama, gde imamo veliki broj alternativnih puteva. Pri tome se koriste nekoliko dodatnih struktura podataka: ECMP grupe koje opisuju grupe Next Hop.
U normalno funkcionirajućoj mreži, bez prekida, kada se krećemo prema gore u Clos-topologiji, dovoljno je koristiti samo jednu grupu, jer sve što nije lokalno opisuje se zadanim pravilom, možemo se kretati prema gore. Kada idemo odozgo prema dolje na jug, svi putevi nisu ECMP, to su jednostruki putevi. Sve je u redu. Problem je u tome, i posebnost klasične Clos-topologije je da, ako gledamo vrh tkanine, za bilo koji element, do bilo kojeg elementa na dnu, postoji jedan put. Ako duž ovog puta dođe do prekida, taj specifični element na vrhu tkanine postaje nevalidan upravo za one prefikse koji leže iza pokvarenog puta. A za ostale ostaje valjan, pa moramo analizirati ECMP grupe i uvesti novo stanje.
Kako izgleda skalabilnost data plana na suvremenim uređajima? Ako radimo LPM (najduže podudaranje prefiksa), sve je prilično dobro, iznad 100k prefikasa. Ako govorimo o Next Hop grupama, situacija je lošija, 2-4 tisuće. Ako govorimo o tablici koja sadrži opis Next Hops (ili susjedstava), to je negdje od 16k do 64k. I to može postati problem. I ovdje dolazimo do zanimljivog izleta: što se dogodilo s MPLS-om u data centrima? U osnovi, željeli smo ga implementirati.
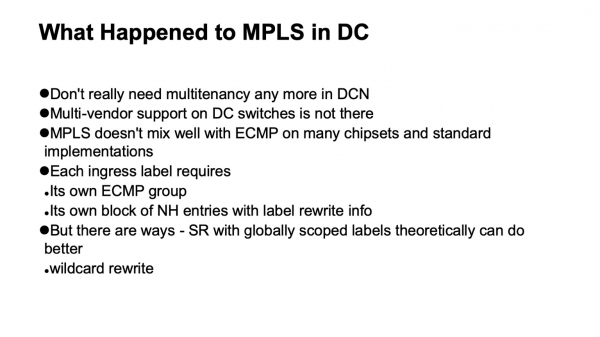
Desile su se dvije stvari. Uveli smo mikrosementaciju na poslužiteljima, više nam nije bilo potrebno raditi to na mreži. Nije bilo dobro s podrškom od različitih dobavljača, a pogotovo s otvorenim implementacijama na bijelim kutijama s MPLS-om. A osim toga, MPLS, barem njegove tradicionalne implementacije, nažalost, veoma loše funkcioniraju s ECMP-om. I to je razlog.
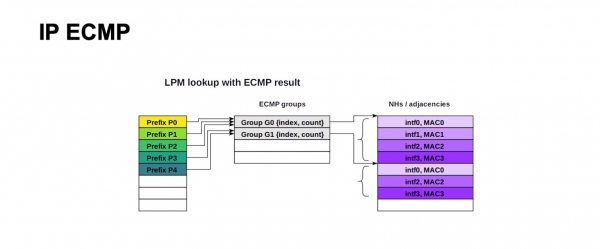
Ovako izgleda struktura ECMP prosljeđivanja za IP. Velik broj prefikasa može koristiti istu grupu i isti blok Next Hops (ili susjedstava, u različitoj dokumentaciji za različite uređaje to se može nazivati na različite načine). Smisao je u tome da se opisuje kao izlazna vrata i na što prepisati MAC adresu, kako bi se došlo do pravog Next Hopa. Za IP sve djeluje jednostavno, moguće je koristiti vrlo veliki broj prefikasa za istu grupu, isti blok Next Hops.
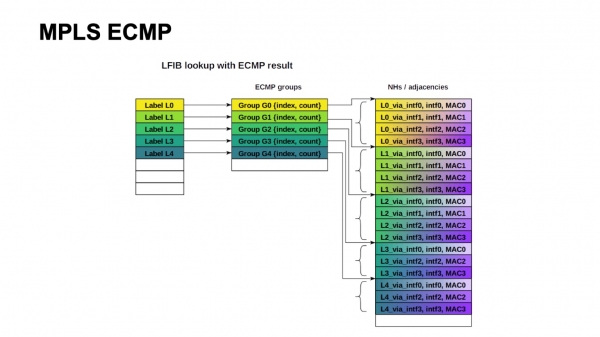
Klasična arhitektura MPLS podrazumijeva - ovisno o izlaznom sučelju, oznaka se može prepisivati na različite vrijednosti. Stoga moramo imati grupu i blok Next Hops za svaku ulaznu oznaku. I to, nažalost, ne skalira.
Nije teško primijetiti da je u našoj konstrukciji bilo potrebno oko 4000 ToR prekidača, a maksimalna širina je 64 puta ECMP, ako se od spajanja-1 prebacimo na spajanje-2. Teško se uklapamo, na granici, u jednu tablicu ECMP grupa, ako samo jedan prefiks izlazi s ToR, i uopće ne stajemo u tablicu Next Hops.
Sve nije beznadežno, jer arhitekture poput Segment Routing podrazumijevaju globalne oznake. Formalno bismo mogli ponovno spojiti sve te blokove Next Hops. Za to je potrebna operacija tipa wild card: uzeti oznaku i prepisati na istu bez konkretnog value-a. Ali nažalost, u dostupnim realizacijama to nije previše prisutno.
I na kraju, trebamo dovesti vanjski promet u data centar. Kako to učiniti? Ranije se promet unosio u Clos mreže odozgo. To jest, postojali su granični usmjerivači koji su se povezivali sa svim uređajima na vrhu tkanine. Ovo rešenje funkcioniše sasvim normalno u malim i srednjim razmerama. Nažalost, da bismo simultano uveli promet na sve elemente vrha tkanine, potrebno je dolaziti istovremeno na sve elemente, a kada ih pređe stotinu, ispostavlja se da nam je potreban veliki radiks i na graničnim usmjerivačima. Uglavnom, to košta novac, jer su granični usmjerivači funkcionalniji, njihovi portovi su skuplji, i dobije se ne baš lepa konstrukcija.
Druga opcija je unositi taj promet odozdo. Nije teško uvjeriti se da je Clos topologija izgrađena tako da se promet koji ulazi odozdo, to jest sa strane ToR, ravnomjerno distribuira po nivoima kroz cijelu Top of fabric u dvije iteracije, opterećujući cijelu mrežu. Stoga uvodimo poseban tip Poda, Edge Pod, koji osigurava vanjsku povezanost.
Postoji još jedna opcija. Tako, na primjer, radi Facebook. To im se zove Fabric Aggregator ili HGRID. Uveden je dodatni spine nivo kako bi se povezalo nekoliko datacentara. Ova konstrukcija je moguća ako nemamo dodatne funkcije na spojevima ili promjenu enkapsulacije. Ako ih ima, to su dodatne touch points, to je složeno. Obično se javljaju više funkcija i svojevrsna membrana koja odvaja različite dijelove datacentra. Ne treba raditi veliku membranu, a ako je zaista potrebna, postoje razlozi da se razmotri opcija nošenja, da se napravi što šira i da se premjesti na hostove. Tako to rade, na primjer, mnogi cloud operateri. Imaju overlays koji počinju s hostovima.
Koje vidimo mogućnosti razvoja? Prvo i najvažnije — poboljšanje podrške CI/CD pipeline-u. Želimo letjeti onako kako testiramo, i testirati onako kako letimo. To baš i ne funkcioniše dobro, jer je infrastruktura velika, duplicirati je za testove nije moguće. Treba razumjeti kako integrirati elemente testiranja u radnu infrastrukturu, a da je pritom ne oborimo.
Bolje instrumentiranje, bolji monitoring nikad ne škodi. Pitanje je samo ravnoteže truda i povratka. Ako se može razumnim snagama nešto dodati — to je vrlo dobro.
Otvoreni operativni sistemi za mrežne uređaje. Najbolji protokoli i najbolji sistemi usmjeravanja, kao što je RIFT. Također su potrebna istraživanja o primjeni najboljih shema kontrola zagušenja i, možda, uvođenje, barem na nekim tačkama, podrške RDMA unutar klastera.
Ako gledamo s perspektivom na dalju budućnost, potrebne su napredne topologije i, možda, mreže koje koriste manji overhead. Među novijim stvarima — nedavno su objavljene informacije o fabric tehnologiji za HPC Cray Slingshot, koja se temelji na commodity Ethernet-u, ali s opcijom korištenja mnogo kraćih naslova. Kao rezultat, overhead se smanjuje.
Sve treba raditi koliko god je to jednostavno moguće, ali ne jednostavnije. Složenost je neprijatelj skalabilnosti. Jednostavnost i redovne strukture su naši prijatelji. Ako se negdje može raditi scale out — radite. I uopće, trenutno je odlično baviti se mrežnim tehnologijama. Događa se mnogo zanimljivih stvari. Hvala.
Izvor: habr.com
