

Bok svima, ja sam Aleksandar, radim kao inženjer u CIAN-u i bavim se sistemskim administriranjem i automatizacijom infrastrukturnih procesa. U komentarima na jedan od prošlih članaka zamolili su nas da objasnimo odakle uzimamo 4 TB logova dnevno i što radimo s njima. Da, imamo puno logova, a za njihovu obradu stvoren je poseban infrastrukturni klaster koji nam omogućava brzo rješavanje problema. U ovom članku ću objasniti kako smo u godinu dana prilagodili ovaj sustav za rad s kontinuirano rastućim tokom podataka.
Od čega smo počeli
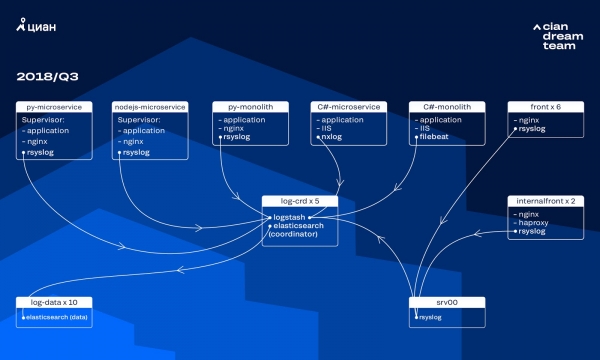
Posljednjih nekoliko godina opterećenje na cian.ru brzo je raslo, a do trećeg kvartala 2018. godine posjećenost resursa dostigla je 11.2 milijuna jedinstvenih korisnika mjesečno. U to vrijeme, u kritičnim trenucima smo gubili do 40% logova, zbog čega nismo mogli brzo reagirati na incidente i trošili smo puno vremena i truda na njihovo rješavanje. Također smo često nismo mogli pronaći uzrok problema, što je rezultiralo ponavljanjem istih nakon nekog vremena. To je bila katastrofa kojoj se trebalo posvetiti.
Tada smo koristili klaster od 10 data-nodova s ElasticSearch verzije 5.5.2 s standardnim postavkama indeksa za pohranu logova. Uveden je više od godinu dana kao popularno i pristupačno rješenje: tada tok logova nije bio tako velik, pa nije bilo smisla smišljati nestandardne konfiguracije.
Obradu dolaznih logova osiguravao je Logstash na različitim portovima na pet koordinatora ElasticSearch. Jedan indeks, neovisno o veličini, sastojao se od pet shardova. Organizirana je rotacija na satnoj i dnevnoj bazi, te je rezultat bio da je svaki sat u klasteru dolazilo otprilike 100 novih shardova. Dok logova nije bilo previše, klaster je dobro funkcionirao i nitko se nije usredotočio na njegove postavke.
Problemi brzi rast
Obujam generiranih logova brzo je rastao, jer su se dva procesa preklapala. S jedne strane, broj korisnika usluge je rastao. S druge strane, počeli smo aktivno prelaziti na mikroservisnu arhitekturu, razdvajajući naše stare monolite napisane u C# i Pythonu. Nekoliko desetaka novih mikroservisa, koji su zamijenili dijelove monolita, generiralo je znatno više logova za infrastrukturni klaster.
Skaliranje je upravo dovelo do toga da je klaster postao gotovo neurediv. Kada su logovi počeli pristizati brzinom od 20 tisuća poruka u sekundi, česta beskorisna rotacija povećala je broj shardova na 6 tisuća, a na jednu nodu je dolazilo više od 600 shardova.
To je dovodilo do problema s alokacijom radne memorije, a kada bi došlo do pada node, počinjao je simultani oporavak svih shardova, povećavajući promet i opterećujući ostale node, što je gotovo onemogućilo zapis podataka u klaster. U to vrijeme ostali smo bez logova. A pri problemu s serverom gubili bismo 1/10 klastera u suštini. Veliki broj malih indeksa dodatno je otežao situaciju.
Bez logova nismo razumjeli uzroke incidenta i mogli smo na kraju ponovno naletjeti na iste probleme, a u ideologiji naše ekipe to je bilo neprihvatljivo, jer su svi naši radni mehanizmi usmjereni upravo na suprotno — nikada ne ponavljati iste probleme. Za to su nam bili potrebni puni logovi i dostava gotovo u stvarnom vremenu, jer je tim inženjera na dužnosti pratio alerte ne samo od metrika, nego i od logova. Da bismo razumjeli opseg problema — u to vrijeme ukupna količina logova iznosila je oko 2 TB dnevno.
Postavili smo cilj — potpuno isključiti gubitak logova i skratiti vrijeme njihove dostave u ELK klaster na maksimalno 15 minuta tijekom izvanrednih situacija (na ovu brojku smo se kasnije oslanjali kao na unutarnji KPI).
Novi mehanizam rotacije i hot-warm node
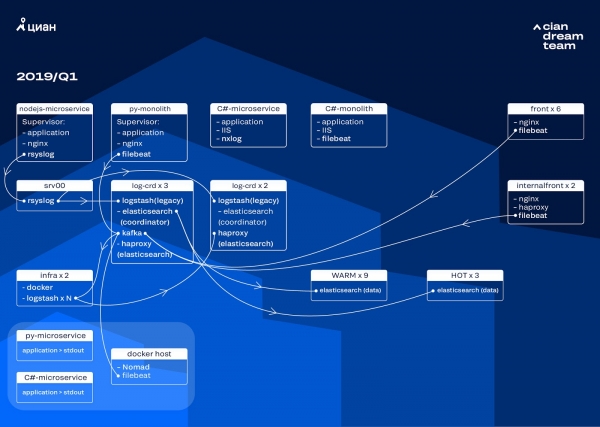
Transformaciju klastera započeli smo ažuriranjem verzije ElasticSearch s 5.5.2 na 6.4.3. Ponovno nam je klaster pete verzije pao, odlučili smo ga gasiti i potpuno ažurirati — logova ionako nema. Tako smo ovaj prijelaz izvršili za tek nekoliko sati.
Najveća transformacija u ovoj fazi bilo je implementiranje na tri čvora s koordinatorom kao međuspremnikom za Apache Kafka. Poslanička platforma oslobodila nas je od gubitka logova tijekom problema s ElasticSearch. Istovremeno smo dodali 2 čvora u klaster i prešli na hot-warm arhitekturu s tri „vruća“ čvora raspoređena u različitim ormarima u podatkovnom centru. Na njih smo preusmjerili logove koje ne smijemo gubiti pod nikakvim uvjetima — nginx, kao i logove grešaka aplikacija. Na ostale čvorove su odlazili manji logovi — debug, warning itd., a također su nakon 24 sata prelazili „važni“ logovi s „vrućih“ čvorova.
Kako bismo izbjegli povećanje broja malih indeksa, prešli smo s rotacije prema vremenu na mehanizam rollover. Na forumima je bilo mnogo informacija da je rotacija prema veličini indeksa vrlo nepouzdana, pa smo odlučili koristiti rotaciju prema broju dokumenata u indeksu. Analizirali smo svaki indeks i zabilježili broj dokumenata nakon kojeg bi trebala uslijediti rotacija. Na taj način smo postigli optimalnu veličinu shard-a — ne više od 50 GB.
Optimizacija klastera
Međutim, potpuno se nismo oslobodili problema. Nažalost, i dalje su se pojavljivali mali indeksi: nisu dostizali zadani volumen, nisu se rotirali i brisani su globalnim čišćenjem indeksa starijih od tri dana, budući da smo uklonili rotaciju prema datumu. To je dovodilo do gubitka podataka jer je indeks potpuno nestajao iz klastera, a pokušaj pisanja u nepostojeći indeks lomio je logiku curator-a, koji smo koristili za upravljanje. Alias za pisanje pretvarao se u indeks i lomio logiku rollover-a, uzrokujući nekontrolirani rast nekih indeksa do 600 GB.
Na primjer, za konfiguraciju rotacije:
curator-elk-rollover.yaml

---
actions:
  1:
    action: rollover
    options:
      name: "nginx_write"
      conditions:
        max_docs: 100000000
  2:
    action: rollover
    options:
      name: "python_error_write"
      conditions:
        max_docs: 10000000
U nedostatku rollover aliasa pojavila se greška:
ERROR     alias "nginx_write" not found.
ERROR     Failed to complete action: rollover.  : Unable to perform index rollover with alias "nginx_write".
Rješenje ovog problema ostavili smo za sljedeću iteraciju i prešli na drugo pitanje: primijenili smo pull logiku rada Logstasha, koji se bavi obradom dolaznih logova (uklanjanjem suvišnih informacija i obogaćivanjem). Smjestili smo ga u docker, koji pokrećemo putem docker-compose, a tamo smo također postavili logstash-exporter, koji šalje metrike u Prometheus za operativno praćenje protoka logova. Tako smo si omogućili da postepeno mijenjamo broj instanci logstasha, koji su odgovarali za obradu svake vrste logova.
Dok smo usavršavali klaster, posjećenost cian.ru porasla je na 12,8 milijuna jedinstvenih korisnika mjesečno. Kao rezultat, naši procesi transformacije malo su kasnili za promjenama na produkciji, i suočili smo se s tim da "topli" čvorovi nisu izdržavali opterećenje i usporavali su cijelu isporuku logova. "Vrući" podaci dolazili su bez grešaka, ali u isporuku ostalih morali smo intervenirati i napraviti ručni rollover kako bismo ravnomjerno rasporedili indekse.
Pri tome je skaliranje i promjena postavki instanci logstasha u klasteru bila otežana time što je to bio lokalni docker-compose, a sve radnje obavljale su se ručno (za dodavanje novih krajnjih točaka bilo je potrebno ručno proći kroz sve servere i svugdje izvršiti docker-compose up -d).
Preusmjeravanje logova
U rujnu ove godine još uvijek smo nastavljali razdvajati monolit, opterećenje na klasteru je raslo, a protok logova približavao se 30 tisuća poruka u sekundi.
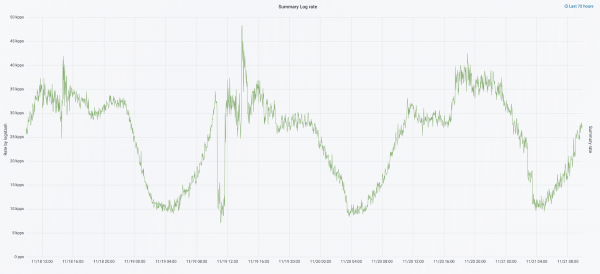
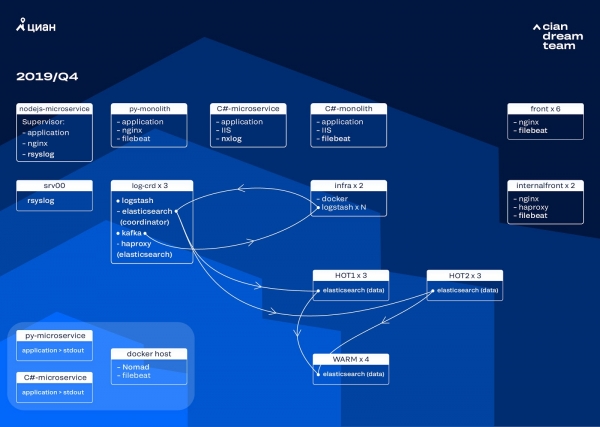
Sljedeću iteraciju započeli smo s ažuriranjem hardvera. Od pet koordinatora prešli smo na tri, zamijenili smo data-nodove i ostvarili uštede i u novcu i u volumenu pohrane. Za nodove koristimo dvije konfiguracije:
- Za "vruće" nodove: E3-1270 v6 / 960Gb SSD / 32 Gb x 3 x 2 (3 za Hot1 i 3 za Hot2).
- Za "tople" nodove: E3-1230 v6 / 4Tb SSD / 32 Gb x 4.
Na ovoj iteraciji izdvojili smo indeks s access-logovima mikroservisa, koji zauzima isto toliko prostora koliko i logovi frontovnog nginx-a, u drugu grupu od tri "vruća" nodova. Podatke na "vrućim" nodovima sada čuvamo 20 sati, a zatim ih premještamo na "tople" s ostalim logovima.
Problem o nestanku malih indeksa riješen je prilagodbom njihove rotacije. Sada se indeksi rotiraju svakih 23 sata, čak i ako ima malo podataka. To je malo povećalo broj shardova (sada ih je otprilike 800), ali s obzirom na performanse klastera, to je podnošljivo.
Kao rezultat toga, u klasteru imamo šest 'vrućih' i samo četiri 'topla' node. To uzrokuje lagano kašnjenje u upitima tokom dugih vremenskih intervala, ali povećanje broja nodova u budućnosti će riješiti ovaj problem.
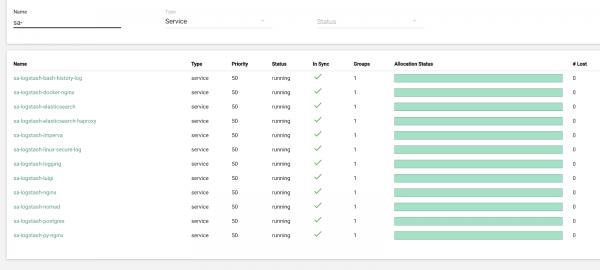
U ovoj iteraciji ispravili smo i problem s nedostatkom poluautomatskog skaliranja. Za to smo implementirali infrastrukturalni Nomad klaster - sličan onom koji već imamo na produkciji. Trenutno se broj Logstash-a ne mijenja automatski prema opterećenju, ali i do toga ćemo doći.
Planovi za budućnost
Implementirana konfiguracija se odlično skalira, a sada čuvamo 13,3 TB podataka — sve logove za 4 dana, što je potrebno za hitno razmatranje alertova. Dio logova pretvaramo u metrike koje pohranjujemo u Graphite. Kako bismo olakšali rad inženjera, imamo metrike za infrastrukturalni klaster i skripte za poluautomatsko ispravljanje tipičnih problema. Nakon povećanja broja data nodova, što je planirano za sljedeću godinu, prelazimo na čuvanje podataka sa 4 na 7 dana. To će biti dovoljno za operativni rad, jer uvijek nastojimo istražiti incidente što je brže moguće, a za dugoročna istraživanja imamo podatke telemetrije.
U listopadu 2019. godine, promet cian.ru porastao je na 15,3 milijuna jedinstvenih korisnika mjesečno. To je bilo ozbiljno ispitivanje arhitektonskog rješenja za dostavu logova.
Trenutno se pripremamo za nadogradnju ElasticSearch-a na verziju 7. No, za to će biti potrebno ažurirati mapping mnogih indeksa u ElasticSearch-u, budući da su prešli s verzije 5.5 i proglašeni su deprecated u verziji 6 (u verziji 7 ih jednostavno nema). To znači da će tijekom nadogradnje sigurno doći do nekih nepredviđenih okolnosti koje će nas na vrijeme ostaviti bez logova. Iz verzije 7 najviše očekujemo Kibanu s poboljšanim sučeljem i novim filtrima.
Glavni cilj smo postigli: prestali smo gubiti logove i smanjili vrijeme zastoja infrastrukturalnog klastera s 2-3 pada tjedno na nekoliko sati servisnih radova mjesečno. Sav taj rad u produkciji gotovo je neprimjetan. Međutim, sada možemo točno odrediti što se događa s našom uslugom, možemo brzo to raditi u mirnom režimu i ne brinuti se da će logovi biti izgubljeni. U cjelini, zadovoljni smo, sretni i pripremamo se za nove podvige, o kojima ćemo pričati kasnije.
Izvor: habr.com
