

Napomena za prijevod.: Ovaj članak, koji je napisao Galo Navarro, koji zauzima poziciju Principal Software Engineer u evropskoj kompaniji Adevinta, predstavlja zanimljivu i poučnu "istragu" u oblasti korištenja infrastrukture. Njegov izvorni naziv je malo izmijenjen u prijevodu zbog razloga koje autor objašnjava na početku.
Napomena autora: Čini se da je ova objava mnogo više pažnje nego što se očekivalo. I dalje primam uvredljive komentare o tome da naziv članka dovodi u zabludu i da su neki čitatelji razočarani. Razumijem razloge za to, zato ću, uprkos riziku da ubijem svu intrigu, odmah reći o čemu se radi u ovom članku. Kada prelazimo timove na Kubernetes, primjećujem zanimljivu stvar: svaki put kada se pojavi problem (na primjer, povećanje kašnjenja nakon migracije), prvo se krivi Kubernetes, ali se ispostavi da organizator inače nije kriv. Ovaj članak govori o jednom takvom slučaju. Njegov naziv ponavlja uzvik jednog od naših developera (kasnije ćete se uvjeriti da Kubernetes ovdje nije uopće kriv). U njemu nećete pronaći iznenađujuća otkrića o Kubernetesu, ali se možete nadati nekoliko dobrih lekcija o složenim sistemima.
Pre nekoliko nedelja moj tim je bio uključen u migraciju jednog mikroservisa na glavnu platformu koja uključuje CI/CD, okruženje temeljen na Kubernetesu, metrike i druge korisne alate. Prijelaz je bio probnog karaktera: planirali smo da ga uzmemo kao osnovu i migriramo još otprilike 150 servisa u narednim mesecima. Svi oni su odgovorni za rad nekih od najvećih online platformi u Španiji (Infojobs, Fotocasa itd.).
Nakon što smo postavili aplikaciju na Kubernetes i preusmjerili deo saobraćaja na nju, dočekao nas je zabrinjavajući iznenađenje. Kašnjenje (latencija) zahteva u Kubernetesu bilo je 10 puta veće nego u EC2. U osnovi, trebalo je ili tražiti rešenje za ovaj problem, ili odustati od migracije mikroservisa (i, možda, celog projekta).
Zašto je kašnjenje u Kubernetesu toliko više nego u EC2?
Da bismo pronašli usko grlo, prikupili smo metrike na celom putu zahteva. Naša arhitektura je jednostavna: API gateway (Zuul) proksira zahteve na instance mikroservisa u EC2 ili Kubernetes. U Kubernetesu koristimo NGINX Ingress Controller, a backend predstavlja obične objekte tipa s JVM aplikacijom na platformi Spring.
                                  EC2
                            +---------------+
                            |  +---------+  |
                            |  |         |  |
                       +-------> BACKEND |  |
                       |    |  |         |  |
                       |    |  +---------+  |
                       |    +---------------+
             +------+  |
Javni       |      |  |
      -------> ZUUL +--+
promet       |      |  |              Kubernetes
             +------+  |    +-----------------------------+
                       |    |  +-------+      +---------+ |
                       |    |  |       |  xx  |         | |
                       +-------> NGINX +------> BACKEND | |
                            |  |       |  xx  |         | |
                            |  +-------+      +---------+ |
                            +-----------------------------+
Činilo se da je problem bio povezan s kašnjenjem u ranoj fazi rada na backendu (označio sam problematično područje na grafikonu kao „xx”). U EC2, odgovor aplikacije trajao je oko 20 ms. U Kubernetesu, kašnjenje je raslo na 100—200 ms.
Brzo smo odbacili vjerojatne osumnjičene vezane uz promjenu okruženja. Verzija JVM-a ostala je ista. Problemi s kontejnerizacijom također nisu bili krivi: aplikacija je već uspješno radila u kontejnerima u EC2. Opterećenje? Međutim, primijetili smo visoka kašnjenja čak i pri 1 zahtjevu u sekundi. Pauze za sakupljanje smeća također su mogle biti zanemarene.
Jedan od naših Kubernetes administratora upitao je da li aplikacija ima vanjske ovisnosti, budući da su u prošlosti zahtjevi za DNS-om uzrokovali slične probleme.
Hipoteza 1: rješavanje DNS imena
Pri svakom zahtjevu naša aplikacija se od jednom do tri puta obraća AWS Elasticsearch instanci u domenu kao što je elastic.spain.adevinta.com. Unutar kontejnera imamo , stoga možemo provjeriti traje li doista pretraga domene dugo vremena.
DNS zahtjevi iz kontejnera:
[root@be-851c76f696-alf8z \/]# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 22 msec
;; Query time: 22 msec
;; Query time: 29 msec
;; Query time: 21 msec
;; Query time: 28 msec
;; Query time: 43 msec
;; Query time: 39 msec
Slični zahtjevi iz jednog od EC2 instanci gdje aplikacija radi:
bash-4.4# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 77 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
S obzirom na to da pretraga traje oko 30 ms, postalo je jasno da rješavanje DNS-a prilikom obraćanja Elasticsearch-u zaista pridonosi povećanju kašnjenja.
Međutim, to je bilo čudno iz dva razloga:
- Već imamo puno aplikacija u Kubernetesu koje komuniciraju s AWS resursima, ali nemaju velike latencije. Bez obzira na razlog, on se odnosi konkretno na ovu situaciju.
- Znamo da JVM provodi in-memory predmemoriranje DNS-a. U našim imazima,TTL je postavljen na
$JAVA_HOME/jre/lib/security/java.securityi postavljen na 10 sekundi:networkaddress.cache.ttl = 10. Drugim riječima, JVM bi trebao predmemorirati sve DNS upite na 10 sekundi.
Kako bismo potvrdili prvu hipotezu, odlučili smo se na neko vrijeme odmaknuti od upita prema DNS-u i vidjeti hoće li problem nestati. Najprije smo odlučili prekonfigurirati aplikaciju da se povezuje s Elasticsearch-om izravno putem IP adrese, a ne putem domene. To bi zahtijevalo promjenu koda i novo deployanje, pa smo jednostavno mapirali domenu na njezinu IP adresu u /etc/hosts:
34.55.5.111 elastic.spain.adevinta.comSada je kontejner skoro odmah dobivao IP. To je dovelo do određenog poboljšanja, ali smo se samo malo približili očekivanoj razini latencije. Iako je razrješenje DNS-a trajalo dugo, stvarni uzrok nam je i dalje izmičao.
Dijagnostika putem mreže
Odlučili smo analizirati promet iz kontejnera s pomoću tcpdump, kako bismo pratili što se točno događa u mreži:
[root@be-851c76f696-alf8z /]# tcpdump -leni any -w capture.pcap Zatim smo poslali nekoliko zahtjeva i preuzeli njihov kaputur (kubectl cp my-service:/capture.pcap capture.pcap) za daljnju analizu u .
U DNS upitima nije bilo ništa sumnjivo (osim jedne sitnice o kojoj ću kasnije govoriti). Ali bilo je određenih čudnosti u tome kako naš servis obrađuje svaki zahtjev. Ispod je snimak zaslona capture-a koji pokazuje prihvaćanje zahtjeva prije početka odgovora:
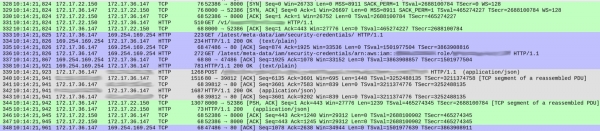
Brojevi paketa navedeni su u prvom stupcu. Za jasnoću sam obojio različite TCP tokove.
Zeleni tok, koji počinje od 328. paketa, pokazuje kako je klijent (172.17.22.150) uspostavio TCP vezu s kontejnerom (172.17.36.147). Nakon inicijalne razmjene (328-330), paket 331 je donio HTTP GET /v1/.. — ulazni zahtjev našem servisu. Cjeli proces trajao je 1 ms.
Sivi tok (od paketa 339) pokazuje da je naš servis poslao HTTP zahtjev instanci Elasticsearch-a (TCP razmjena nedostaje jer se koristi već postojeća veza). Na to je utrošeno 18 ms.
Sve je u redu, a vremena su otprilike u skladu s očekivanim latencijama (20-30 ms prema mjerenjima s klijenta).
Međutim, plava sekcija traje 86 ms. Što se u njoj događa? S paketom 333, naš servis poslao je HTTP GET zahtjev na /latest/meta-data/iam/security-credentials, a odmah nakon njega, preko istog TCP veze, još jedan GET zahtjev na /latest/meta-data/iam/security-credentials/arn:...
Otkrili smo da se to ponavlja s svakim zahtjevom u cijeloj tragikaciji. Rješavanje DNS-a je doista malo sporije u našim kontejnerima (objašnjenje ovog fenomena je vrlo zanimljivo, ali ću ga zadržati za poseban članak). Isprva se pokazalo da su veliki kašnjenja uzrokovana pozivima na AWS Instance Metadata servis pri svakom zahtjevu.
Hipoteza 2: suvišna pozivanja na AWS
Oba endpointa pripadaju . Naš mikroservis koristi ovu uslugu tijekom rada s Elasticsearchom. Oba poziva su dio osnovnog procesa autorizacije. Endpoint kojem se obraćamo pri prvom zahtjevu isporučuje IAM ulogu povezanu s instancom.
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
arn:aws:iam::<account_id>:role/some_role
Drugi zahtjev se obraća drugom endpointu za privremene ovlasti za ovu instancu:
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/arn:aws:iam::<account_id>:role/some_role`
{
    "Code" : "Success",
    "LastUpdated" : "2012-04-26T16:39:16Z",
    "Type" : "AWS-HMAC",
    "AccessKeyId" : "ASIAIOSFODNN7EXAMPLE",
    "SecretAccessKey" : "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY",
    "Token" : "token",
    "Expiration" : "2017-05-17T15:09:54Z"
}
Klijent ih može koristiti tijekom kratkog vremenskog perioda i povremeno se treba nabaviti nove certifikate (do njihovog Isteka). Model je jednostavan: AWS provodi čestu rotaciju privremenih ključeva iz sigurnosnih razloga, ali klijenti ih mogu keširati na nekoliko minuta, kompenzirajući smanjenje performansi povezano s dobivanjem novih certifikata.
AWS Java SDK bi trebao preuzeti odgovornost za organizaciju ovog procesa, no iz nekog razloga to ne funkcionira.
Pretražujući probleme na GitHubu, naišli smo na problem . Pomogao nam je odrediti pravac u kojem trebamo "kopati" dalje.
AWS SDK ažurira certifikate kada nastane jedna od sljedećih situacija:
- Rok isteka njihovog važenja (
Isteka) pada uEXPIRATION_THRESHOLD, fiksno postavljen u kodu na 15 minuta. - Od posljednjeg pokušaja ažuriranja certifikata prošlo je više vremena nego
REFRESH_THRESHOLD, unaprijed postavljen na 60 minuta.
Kako bismo provjerili stvarni rok isteka certifikata koje primamo, izvršili smo gornje cURL komande iz kontejnera i iz EC2 instance. Trajanje certifikata dobivenog iz kontejnera bilo je mnogo kraće: točno 15 minuta.
Sada je sve jasno: za prvi zahtjev naša usluga je primala privremene certifikate. Budući da njihov rok trajanja nije bio duži od 15 minuta, pri narednom zahtjevu AWS SDK je odlučio da ih obnovi. I to se dešavalo sa svakim zahtjevom.
Zašto je rok trajanja certifikata postao kraći?
AWS Instance Metadata servis je dizajniran za rad s EC2 instancama, a ne s Kubernetesom. S druge strane, nismo željeli mijenjati sučelje aplikacija. Za to smo iskoristili — alat koji uz pomoć agenata na svakom čvoru Kubernetesa omogućuje korisnicima (inženjerima koji implementiraju aplikacije u klaster) da dodijele IAM uloge kontejnerima u podovima kao da su EC2 instance. KIAM presreće pozive servisu AWS Instance Metadata i obrađuje ih iz svog cache-a, unaprijed ih dobivši od AWS-a. Iz perspektive aplikacije ništa se ne mijenja.
KIAM pruža kratkoročne certifikate podovima. To je razborito kada se uzme u obzir da je prosječno trajanje postojanja poda kraće od EC2 instance. Po zadanim postavkama rok trajanja certifikata .
Kao rezultat toga, ako se preklapaju obje zadane vrijednosti, nastaje problem. Svaki certifikat koji se pruža aplikaciji ističe za 15 minuta. Pri tome AWS Java SDK prisilno obnavlja svaki certifikat kojemu ostaje manje od 15 minuta do isteka.
Kao rezultat, privremeni certifikat se prisilno obnavlja s svakim zahtjevom, što dovodi do nekoliko poziva na AWS API i značajno povećava kašnjenje. U AWS Java SDK-u smo otkrili , u kojem se spominje sličan problem.
Rješenje se pokazalo jednostavnim. Samo smo ponovno postavili KIAM da traži certifikate s dužim rokom trajanja. Kada se to dogodilo, zahtjevi su počeli prolaziti bez sudjelovanja AWS Metadata servisa, a kašnjenje je čak pala na nižu razinu nego u EC2.
Zaključci
Na temelju našeg iskustva s migracijama, možemo reći da je jedan od najčešćih izvora problema — ne greške u Kubernetesu ili drugim elementima platforme. Također, to nije povezano s bilo kojim temeljim nedostacima u mikroservisima koje prenosimo. Problemi često nastaju jednostavno zato što spajamo različite elemente.
Miješamo složene sustave koji se nikada prije nisu međusobno povezivali, nadajući se da će zajedno stvoriti jedinstveni, veći sustav. Nažalost, što je više elemenata, to je veća mogućnost grešaka i viša entropija.
U našem slučaju, visoka latencija nije bila rezultat grešaka ili loših odluka u Kubernetesu, KIAM-u, AWS Java SDK-u ili našem mikroservisu. Ona je rezultat spajanja dva neovisna postavka postavljena prema zadanim postavkama: jedan u KIAM-u, drugi u AWS Java SDK-u. Obje postavke imaju smisla pojedinačno: aktivna politika ažuriranja certifikata u AWS Java SDK-u i kratak vijek trajanja certifikata u KAIM-u. No, kada se spoje, rezultati postaju nepredvidivi. Dva neovisna i logična rješenja ne moraju nužno imati smisla kada se spoje.
P.S. od prevodioca
Više informacija o arhitekturi alata KIAM za integraciju AWS IAM s Kubernetesom možete pronaći na od njegovih kreatora.
A na našem blogu također pročitajte:
- «»;
- «»;
- «»;
- «».
Izvor: habr.com
