

U svojoj struci često se susrećemo sa situacijama u kojima programer piše upit i razmišlja „baza je pametna, sama će se snaći!"«
U nekim slučajevima (djelomično zbog nepoznavanja mogućnosti baze podataka, djelomično zbog preuranjenih optimizacija) takav pristup dovodi do stvaranja „frankenštajna".
Najprije ću navesti primjer takvog upita:
-- za svaku ključnu paru pronalazimo povezane vrijednosti polja
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- pronalazimo min/max vrijednosti za svaki prvi ključ
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- povezujemo po prvom ključu ključne parove i min/max vrijednosti
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Kako bismo objektivno ocijenili kvalitetu upita, hajde da stvorimo neki proizvoljan skup podataka:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
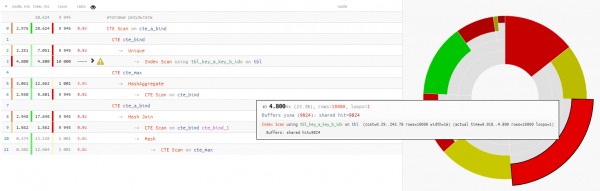
Ispostavlja se da samo čitavanje podataka zauzima manje od četvrtine ukupnog vremena izvršenja upita:
Razrađujemo detaljno
Pažljivo ćemo pogledati upit i postaviti pitanje:
- Zašto je ovdje WITH RECURSIVE ako nema rekurzivnih CTE?
- Zašto grupirati min/max vrijednosti u zasebnoj CTE, ako se one kasnije ionako povezuju s originalnim odabirom?
+25% vremena - Zašto na kraju koristiti ponovnu obradu iz prethodne CTE putem bezuvjetnog ‘SELECT * FROM’?
+14% vremena
U ovom slučaju još smo imali sreće što je za spajanje odabran Hash Join, a ne Nested Loop, jer bismo tada dobili ne jedan, već 10K prolaza CTE Scan!
malo o CTE ScanTu treba imati na umu da CTE Scan je ekvivalent Seq Scan — što znači da nema indeksiranja, već samo potpuno pretraživanje, koje bi zahtijevalo 10K x 0.3ms = 3000ms pri ciklusima po cte_max ili 1K x 1.5ms = 1500ms pri ciklusima po cte_bind!
Što smo zapravo željeli dobiti kao rezultat? Ah, obično upravo takvo pitanje se javlja negdje u petoj minuti analize „trokatnih" upita.
Željeli smo za svaku jedinstvenu ključnu paru prikazati min/max iz grupe prema key_a.
Pa hajde da iskoristimo :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 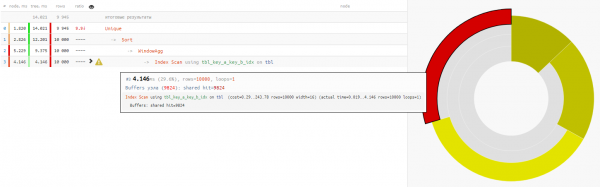
Budući da čitanje podataka u oba slučaja traje otprilike 4-5ms, naš ukupni dobitak u vremenu -32% je u čistom obliku opterećenje skinuto s CPU baze, ako se takav zahtjev izvodi dovoljno često.
Uglavnom, ne treba prisiljavati bazu da "okruglo nosi, kvadratno kotrlja".
Izvor: habr.com
