

Ponovo imaš zadatak detekcije objekata. Prioritet je brzina rada uz prihvatljivu tačnost. Uzimaš YOLOv3 arhitekturu i nastavljaš obučavanje. Tačnost (mAp75) je veća od 0.95. No brzina testiranja je još uvek niska. Prokletstvo.
Danas ćemo izbeći kvantizaciju. A ispod ćemo razmotriti Model Pruning — uklanjanje suvišnih delova mreže radi ubrzanja inferencije bez gubitka tačnosti. Jasno — odakle, koliko i kako možemo da uklonimo. Razjasnićemo kako to uraditi ručno i gde se može automatizovati. Na kraju — repozitorijum na keras.
Uvod
Na prethodnom poslu, u permškom Macroscopu, stekao sam naviku — uvek pratiti vreme izvršavanja algoritama. A vreme testiranja mreža uvek proveravati kroz filter adekvatnosti. Obično state-of-the-art u produkciji ne prolaze ovaj filter, što me i navelo na Pruning.
Pruning — stara tema o kojoj su govorili na 2017. godine. Osnovna ideja je smanjenje veličine obučene mreže bez gubitka tačnosti uklanjanjem raznih čvorova. Zvuči odlično, ali retko čujem o njenoj primeni. Možda nedostaju implementacije, nema članaka na ruskom jeziku ili jednostavno svi smatraju pruning za no-u koji ne dele.
Ali hajde da razmotrimo
Pogled u biologiju
Volim kada ideje iz biologije odstupaju u Deep Learning. Mogu se, poput evolucije, uzeti za ozbiljno (a znao si da je ReLU prilično sličan ?)
Proces Model Pruning takođe je blizak biologiji. Reakciju mreže ovde možemo uporediti sa plastičnošću mozga. Postoji nekoliko zanimljivih primera u knjizi :
- Mozak žene koja je od rođenja imala samo jednu polovinu, preprogramirao je samog sebe da izvršava funkcije nedostajuće polovine.
- Tip je sebi odsekao deo mozga odgovoran za vid. Tokom vremena, druge oblasti mozga preuzele su te funkcije. (ne pokušavamo ponovo)
Tako i iz vaše modele možete izrezati deo slabih konvolucija. U najgorem slučaju, preostale konvolucije će pomoći da nadomeste izrezane.
Da li voliš Transfer Learning ili učiš od nule?
Opcija broj jedan. Koristiš Transfer Learning na Yolov3, Retina, Mask-RCNN ili U-Net. No, najčešće nam ne treba prepoznavati 80 klasa objekata kao u COCO. U mojoj praksi sve se svodi na 1-2 klase. Može se pretpostaviti da je arhitektura za 80 klasa ovdje suvišna. Postavlja se pitanje kako smanjiti arhitekturu. Osim toga, želeo bih to učiniti bez gubitka postojećih unapred obučenih težina.
Opcija broj dva. Možda imaš puno podataka i računarskih resursa, ili ti jednostavno treba super prilagođena arhitektura. Nije važno. Ali učiš mrežu od nule. Uobičajeni redosled je da gledamo na strukturu podataka, biramo PREKOMERNU arhitekturu i povećavamo dropoutove da spriječimo pretreniranost. Video sam dropoute 0.6, Karl.
U oba slučaja mrežu možemo smanjiti. Motivirani. Sada idemo da istražimo šta je to rezanje pruning.
Opšti algoritam
Odlučili smo da možemo ukloniti konvolucije. Izgleda to vrlo jednostavno:
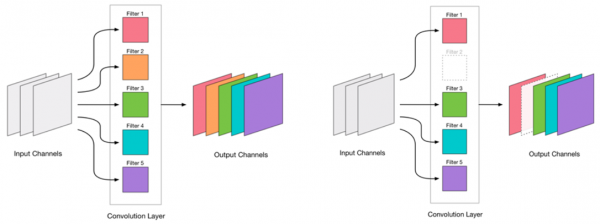
Uklanjanje bilo koje konvolucije predstavlja stres za mrežu, što obično dovodi do određenog rasta greške. S jedne strane, ovaj rast greške pokazuje koliko ispravno uklanjamo konvolucije (na primer, veliki rast ukazuje na to da nešto radimo pogrešno). No, mali rast je sasvim prihvatljiv i obično se eliminiše daljnjim malim prilagođavanjem s malim LR. Dodajemo korak prilagođavanja:
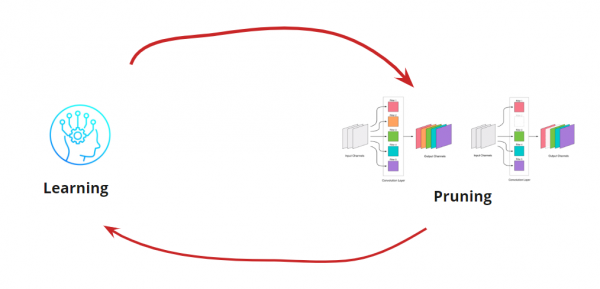
Sada moramo da shvatimo kada želimo da prekinemo naš ciklus Učenje<->Pruning. Postoje egzotične varijante kada moramo smanjiti mrežu do određene veličine i brzine izvođenja (na primer, za mobilne uređaje). Međutim, najčešći slučaj je nastavak ciklusa sve dok greška ne postane veća od dozvoljene. Dodajemo uslov:
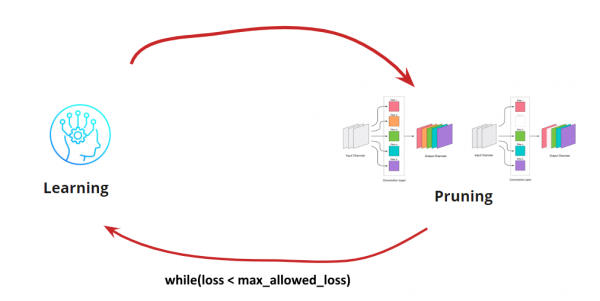
Dakle, algoritam postaje jasan. Ostaje da razjasnimo kako odrediti uklonjene konvolucije.
Pretraživanje uklonjenih konvolucija
Moramo ukloniti neke konvolucije. Napraviti žestok pristup i 'poništiti' bilo koje — loša je ideja, iako će funkcionisati. Ali budući da imamo glavu, možemo da razmislimo i pokušamo da istaknemo za uklanjanje 'slabe' konvolucije. Ima nekoliko opcija:
- . Ideja da konvolucije s malim vrednostima težina doprinose malo konačnom donošenju odluke.
- Najmanja L1-mjera s obzirom na prosjek i standardnu devijaciju. Dopunjuje se ocjenjivanjem karaktera raspodjele.
- Preciznije određivanje manje značajnih svitaka, ali prilično zahtjevno po vremenu i resursima.
- Druge
Svaka od opcija ima pravo na postojanje i svoje karakteristike realizacije. Ovdje ćemo razmotriti opciju s najmanjom L1-mjerom.
Ručno proces za YOLOv3.
U izvornoj arhitekturi sadrže se preostali blokovi. No, bez obzira koliko su odlični za duboke mreže, pomalo će nam smetati. Problem je u tome što nije moguće ukloniti svitke s različitim indeksima u tim slojevima:
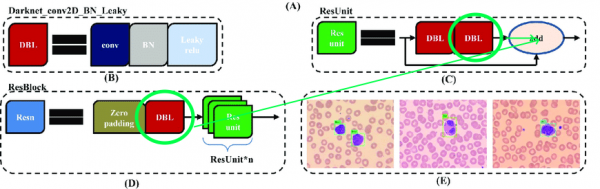
Stoga ćemo odabrati slojeve iz kojih možemo slobodno ukloniti svitke:

Sada ćemo izgraditi radnu petlju:
- Izbacujemo aktivacije.
- Procjenjujemo koliko izrezati.
- Izrežemo.
- Učimo 10 epoha s LR=1e-4.
- Testiramo.
Izbacivanje svitaka korisno je za procjenu koliko dijela možemo ukloniti u određenoj fazi. Primjeri izbacivanja:
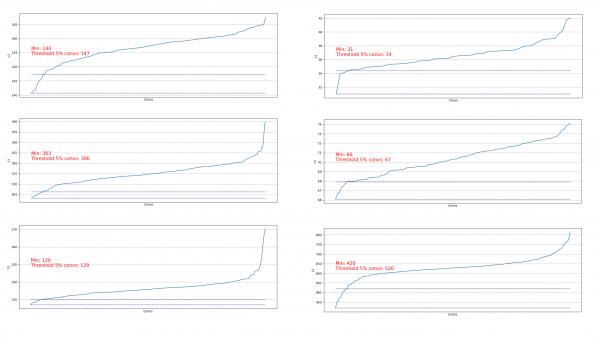
Vidimo da gotovo svuda 5% svitaka ima vrlo nisku L1-normu i možemo ih ukloniti. U svakoj fazi ovo izbacivanje se ponavljalo i izrađivala se procjena iz kojih slojeva i koliko možemo izrezati.
Cijeli proces sastojao se od 4 koraka (tu i svugdje brojevi za RTX 2060 Super):
| Korak | mAp75 | Broj parametara, mln | Veličina mreže, mb | Od izvorne, % | Vrijeme izvođenja, ms | Uvjet obrezivanja |
|---|---|---|---|---|---|---|
| 0 | 0.9656 | 60 | 241 | 100 | 180 | — |
| 1 | 0.9622 | 55 | 218 | 91 | 175 | 5% od svih |
| 2 | 0.9625 | 50 | 197 | 83 | 168 | 5% od svih |
| 3 | 0.9633 | 39 | 155 | 64 | 155 | 15% za slojeve s 400+ svitaka. |
| 4 | 0.9555 | 31 | 124 | 51 | 146 | 10% za slojeve s 100+ svitaka. |
Do drugog koraka pojavila se jedna pozitivna točka — u memoriju je stao batch-size 4, što je značajno ubrzalo proces ponovnog učenja.
U četvrtom koraku proces je prekinut, jer čak ni dugo ponovno učenje nije podiglo mAp75 na prethodne vrijednosti.
Na kraju je uspjelo ubrzati inferenciju za 15%, smanjiti veličinu za 35% i ne izgubiti u točnosti.
Automatizacija za jednostavnije arhitekture.
Za jednostavnije arhitekture mreža (bez uvjetnih add, concatenate i residual blokova) sasvim je moguće orijentirati se na obradu svih konvolucijskih slojeva i automatizirati proces izrezivanja svitaka.
Ovu opciju sam implementirao. .
Sve je jednostavno: od vas se traži samo funkcija gubitka, optimizator i batch-generatori:
import pruning
from keras.optimizers import Adam
from keras.utils import Sequence

train_batch_generator = BatchGenerator...
score_batch_generator = BatchGenerator...

opt = Adam(lr=1e-4)
pruner = pruning.Pruner("config.json", "categorical_crossentropy", opt)

pruner.prune(train_batch, valid_batch)
Ako je potrebno, moguće je promijeniti postavke konfiguracije:
{
    "input_model_path": "model.h5",
    "output_model_path": "model_pruned.h5",
    "finetuning_epochs": 10, # broj epoha za treniranje između koraka uklanjanja
    "stop_loss": 0.1, # gubitak za zaustavljanje procesa
    "pruning_percent_step": 0.05, # dio konvolucija za brisanje na svakom koraku uklanjanja
    "pruning_standart_deviation_part": 0.2 # pomak za ograničavanje dijela uklanjanja
}
Dodatno je implementirano ograničenje na temelju standardne devijacije. Cilj je ograničiti dio uklanja, isključujući konvolucije s već "dovoljnom" L1-mjerom:
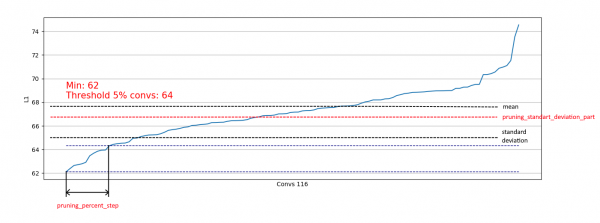
Na taj način omogućavamo brisanje samo slabih konvolucija iz distribucija sličnih desnoj i ne utječemo na brisanje iz distribucija sličnih lijevoj:
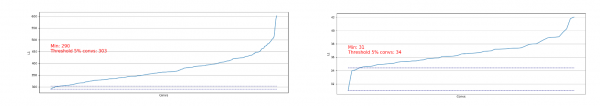
Kako se distribucija približava normalnoj, koeficijent pruning_standart_deviation_part može se odabrati iz:
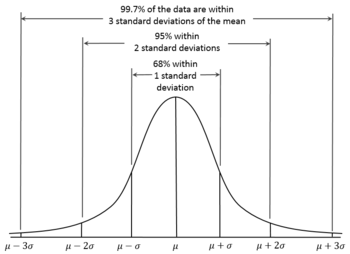
Preporučujem dopuštenje od 2 sigma. Ili se ne morate oslanjati na ovu karakteristiku, ostavljajući vrijednost < 1.0.
Na izlazu dobivamo graf veličine mreže, gubitka i vremena izvođenja mreže kroz cijeli test, normaliziranog na 1.0. Na primjer, ovdje je veličina mreže smanjena gotovo dva puta bez gubitka kvalitete (mala konvolucijska mreža sa 100k težina):
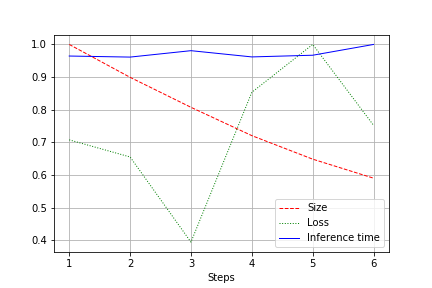
Brzina izvođenja podložna je normalnim fluktuacijama i praktički se nije promijenila. Ovo ima objašnjenje:
- Broj konvolucija mijenja se s prikladnih (32, 64, 128) na ne baš prikladne za grafičke kartice — 27, 51 i tako dalje. Ovdje mogu griješiti, ali vjerojatno to utječe.
- Arhitektura nije široka, ali je sekvencijalna. Smanjujući širinu, ne diramo dubinu. Na taj način smanjujemo opterećenje, ali ne mijenjamo brzinu.
Stoga se poboljšanje očituje u smanjenju opterećenja CUDA tijekom izvođenja za 20-30%, ali ne i u smanjenju vremena izvođenja.
Zaključci
Reflektirajmo. Razmotrili smo 2 opcije uklanjanja — za YOLOv3 (kada moramo raditi ručno) i za mreže s jednostavnijim arhitekturama. Vidljivo je da se u oba slučaja može postići smanjenje veličine mreže i ubrzanje bez gubitka točnosti. Rezultati:
- Smanjenje veličine
- Ubrzanje izvođenja
- Smanjenje opterećenja CUDA
- Kao posljedica, ekološka učinkovitost (Optimiziramo buduću upotrebu računalnih resursa. Negdje se raduje jedna )
Dodatak
- Nakon koraka uklanjanja može se dodati i kvantizacija (na primjer s TensorRT)
- Tensorflow pruža mogućnosti za . Radi.
- želim napredovati i bit ću zahvalan na pomoći
Izvor: habr.com
