

Napomena za prijevod.: U ovom članku, Banzai Cloud dijeli primjer korištenja svojih specijalnih alata za olakšavanje eksploatacije Kafke unutar Kubernetes-a. Uključene upute ilustriraju kako odrediti optimalnu veličinu infrastrukture i konfigurirati samu Kafku za postizanje potrebne propusnosti.
Apache Kafka je distribuirana platforma za streaming koja omogućuje izradu pouzdanih, skalabilnih i visokoučinkovitih sustava protoka u stvarnom vremenu. Njezine impresivne mogućnosti mogu se proširiti pomoću Kubernetes-a. Za to smo razvili i alat pod nazivom . Oni omogućuju pokretanje Kafke unutar Kubernetes-a i korištenje njenih različitih funkcija, kao što su fino podešavanje konfiguracije brokera, skaliranje na temelju metrika s ponovnim balansiranjem, rack awareness (svijest o hardverskim resursima), 'meko' (graceful) izdavanje ažuriranja i drugo.
Isprobajte Supertubes u svom klasteru:
curl https://getsupertubes.sh | sh i supertubes install -a --no-democluster --kubeconfigIli se obratite . Osim toga, možete pročitati o nekim mogućnostima Kafke, čije je korištenje automatizirano pomoći Supertubes i Kafka operatora. O tome smo već pisali na blogu:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Kada odlučite implementirati klaster Kafke unutar Kubernetes-a, zasigurno ćete se suočiti s problemom određivanja optimalne veličine osnovne infrastrukture i potrebom za finim podešavanjem konfiguracije Kafke kako bi se zadovoljili zahtjevi za propusnost. Maksimalna učinkovitost svakog brokera određena je učinkovitošću infrastrukturnih komponenti koje ga čine, kao što su memorija, procesor, brzina diska, propusnost mreže itd.
Idealan konfiguracija posrednika trebala bi biti takva da se svi elementi infrastrukture koriste na maksimumu svojih mogućnosti. Međutim, u stvarnom životu takva postavka je prilično složena. Vjerojatnije je da će korisnici konfigurirati posredničke postavke na način da maksimiziraju korištenje jednog ili dva sastavna dijela (disk, memorija ili procesor). Općenito, posrednik pokazuje maksimalnu izvedbu kada njegova konfiguracija omogućava puni rad najsporijeg komponente. Tako možemo dobiti grubu procjenu opterećenja s kojim se jedan posrednik može nositi.
Teoretski, također možemo procijeniti broj posrednika potrebnih za rad s određenim opterećenjem. Međutim, u praksi postoji toliko mnogo opcija postavljanja na različitim razinama da je procjena potencijalne izvedbe određene konfiguracije prilično teška (ako ne i nemoguća). Drugim riječima, jako je teško planirati konfiguraciju oslanjajući se na neku zadanu izvedbu.
Za korisnike Supertubes obično primjenjujemo sljedeći pristup: počinjemo s nekom postavkom (infrastruktura + podešavanja), zatim mjerimo njezinu izvedbu, prilagođavamo postavke posrednika i ponovno ponavljamo proces. To se odvija sve dok potencijal najsporijeg komponente infrastrukture nije potpuno iskorišten.
Na ovaj način dobivamo jasniju predstavu o tome koliko je posrednika potrebno klasteru da se nosi s određenim opterećenjem (broj posrednika također ovisi o drugim faktorima, poput minimalnog broja replika poruka za osiguranje otpornosti, broja vođa particija itd.). Uz to, dobivamo predstavu o tome kojeg infrastrukturnog komponenta je poželjno vertikalno skalirati.
U ovom članku govorit ćemo o koracima koje poduzimamo kako bismo "izvukli maksimum" iz najsporijih komponenti u početnim konfiguracijama i izmjerili propusnost Kafka klastera. Visokostabilna konfiguracija zahtijeva najmanje tri radna posrednika (min.insync.replicas=3), raspoređenih u tri različite dostupne zone. Za postavljanje, skaliranje i praćenje Kubernetes infrastrukture koristimo našu vlastitu platformu za upravljanje kontejnerima za hibridne oblake — . Podržava on-premise (bare metal, VMware) i pet tipova oblaka (Alibaba, AWS, Azure, Google, Oracle), kao i bilo koje njihove kombinacije.
Misli o infrastrukturi i konfiguraciji Kafka klastera
Za primjere navedene u nastavku, odabrali smo AWS kao dobavljača oblaka i EKS kao distribuciju Kubernetes. Sličnu konfiguraciju moguće je ostvariti pomoću — distribucija Kubernetes od Banzai Clouda, certificirana od strane CNCF.
Disk
Amazon nudi različite . U osnovi gp2 i io1 su temeljeni na SSD diskovima, međutim, za osiguranje visoke propusnosti gp2 troši stečene kredite (I/O krediti), stoga smo odabrali tip io1, koji nudi stabilnu visoku propusnost.
Tipovi instanci
Performanse Kafke uvelike ovise o vremenskom predmemoriranju operativnog sustava, stoga su nam potrebne instance s dovoljnom količinom memorije za brokere (JVM) i vremenskim predmemoriranjem. Instanca c5.2xlarge je dobar početak, jer ima 16 GB memorije i Nedostatak je to što može osigurati maksimalne performanse samo do 30 minuta svakih 24 sata. Ako radno opterećenje zahtijeva maksimalne performanse tijekom dužeg vremenskog perioda, treba razmotriti druge tipove instanci. Mi smo to tako i učinili, odlučivši se za c5.4xlarge.Osigurava maksimalnu propusnost od 593,75 MB/s.Maksimalna propusnost EBS volumena io1 je viša od one instanci c5.4xlarge., stoga je najsporiji element infrastrukture, očigledno, propusnost I/O ovog tipa instance (što također trebaju potvrditi rezultati naših opterećenih testova).
Mreža
Propusnost mreže trebala bi biti dovoljno velika u usporedbi s performansama VM instance i diska, inače mreža postaje usko grlo. U našem slučaju, mrežni sučelje c5.4xlarge. podržava brzinu do 10 Gb/s, što je značajno iznad propusnosti I/O VM instance.
Postavljanje brokera
Brokeri se trebaju deployati (planirati u Kubernetesu) na namjenske čvorove kako bi se izbjegla konkurencija s drugim procesima za resurse procesora, memorije, mreže i diska.
Verzija Jave
Logičan izbor je Java 11, budući da je kompatibilna s Dockerom u smislu da JVM ispravno određuje procesore i memoriju dostupnu kontejneru u kojem broker radi. Imajući na umu da su ograničenja procesora važna, JVM interno i transparentno postavlja broj GC i JIT-kompilatorskih niti. Koristili smo sliku Kafka banzaicloud/kafka:2.13-2.4.0, koja uključuje verziju Kafka 2.4.0 (Scala 2.13) na Javi 11.
Ako želite saznati više o Javi/JVM-u na Kubernetesu, obratite pažnju na naše sljedeće objave:
- ;
- .
Postavke memorije brokera
Postoje dva ključna aspekta u postavljanju memorije brokera: postavke za JVM i za pod Kubernetes. Ograničenje memorije postavljeno za pod mora biti veće od maksimalne heap veličine, kako bi JVM imao dovoljno prostora za Java metaprostor, koji se nalazi u vlastitoj memoriji, i za stranice keša operativnog sustava koje Kafka aktivno koristi. U našim testovima pokretali smo Kafka brokere s parametrima -Xmx4G -Xms2G, dok je ograničenje memorije za pod iznosilo 10 Gi. Imajte na umu da se postavke memorije za JVM mogu automatski dobiti putem -XX:MaxRAMPercentage i -X:MinRAMPercentage, na osnovu ograničenja memorije za pod.
Postavke procesora brokera
Općenito govoreći, može se poboljšati performanse povećanjem paralelizma povećavanjem broja niti koje Kafka koristi. Što je više procesora dostupno Kafki, to je bolje. U našem testu počeli smo s ograničenjem od 6 procesora i postupno (iterativno) povećavali njihov broj na 15. Osim toga, postavili smo num.network.threads=12 u postavkama brokera kako bismo povećali broj niti koje primaju podatke iz mreže i šalju ih. Odmah smo primijetili da replikant brokera ne može dovoljno brzo primati replike, pa smo povećali num.replica.fetchers na 4 kako bismo povećali brzinu s kojom replikant brokera replicira poruke od vođa.
Alat za generiranje opterećenja
Treba osigurati da kapacitet odabranog generatora opterećenja ne iscrpi prije nego što Kafka klaster (čija se benchmark testiranja vrše) dostigne svoj maksimalni kapacitet. Drugim riječima, potrebno je izvršiti prethodnu procjenu mogućnosti alata za generiranje opterećenja, kao i odabrati tipove instance s dovoljnom količinom procesora i memorije. U ovom slučaju, naš alat će proizvoditi više opterećenja nego što klaster Kafka može obraditi. Nakon brojnih eksperimenata, odlučili smo se na tri instance c5.4xlarge., od kojih je svaka pokrenula generator.
Benchmarking
Mjerenje performansi je iterativni proces koji uključuje sljedeće faze:
- postavljanje infrastrukture (EKS klastera, Kafka klastera, alata za generiranje opterećenja, te Prometheusa i Grafane);
- generiranje opterećenja tokom određenog razdoblja za filtriranje slučajnih odstupanja u prikupljenim mjerenjima performansi;
- fino podešavanje infrastrukture i konfiguracije brokera na osnovu zabilježenih mjerenja performansi;
- ponavljanje procesa sve dok se ne postigne željena razina propusnosti klastera Kafka. Pri tome bi trebala biti stabilno reproducirana i pokazivati minimalne varijacije u propusnosti.
U sljedećem poglavlju opisana su koraci koji su izvršeni tokom benchmark testiranja testnog klastera.
Alati
Za brzo postavljanje osnovne konfiguracije, generiranje opterećenja i mjerenje performansi korišteni su sljedeći alati:
- za organizaciju EKS klastera od Amazona s (za prikupljanje metrika Kafka i infrastrukture) i (za vizualizaciju tih metrika). Iskoristili smo integrirane u usluge koje omogućavaju federalno praćenje, centralizirano prikupljanje logova, skeniranje ranjivosti, oporavak od kvarova, sigurnost na korporativnoj razini i još mnogo toga.
- je alat za testiranje opterećenja Kafka klastera.
- Grafana ploče za vizualizaciju metrika Kafka i infrastrukture: , .
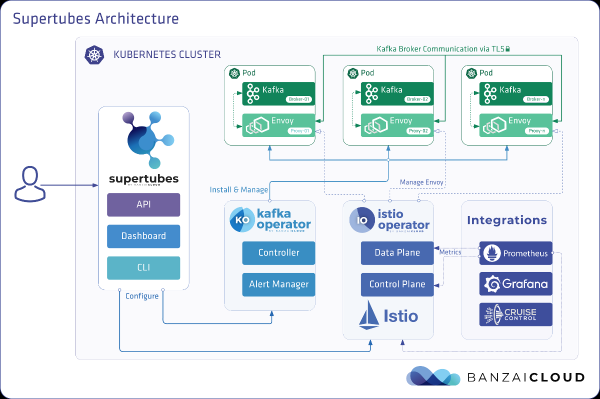
- Supertubes CLI za maksimalno jednostavno postavljanje Kafka klastera u Kubernetesu. Zookeeper, Kafka operator, Envoy i mnogi drugi sastavni dijelovi su instalirani i pravilno konfigurirani za pokretanje klastera Kafka spremnog za proizvodnju u Kubernetesu.
- Za instalaciju supertubes CLI iskoristite upute navedene .
EKS klaster
Pripremite EKS klaster s odvojenim radnim čvorovima c5.4xlarge. u različitim dostupnim zonama za podove s Kafka posrednicima, kao i odvojene čvorove za generator opterećenja i monitoring infrastrukturu.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonKada EKS klaster bude aktivan, uključite njegovu integriranu — on će postaviti Prometheus i Grafanu u klaster.
Sastavni dijelovi Kafka
Instalirajte sastavne dijelove Kafka (Zookeeper, kafka-operator) u EKS koristeći supertubes CLI:
supertubes install -a --no-democluster --kubeconfigKafka klaster
Zadano se u EKS koriste EBS volumeni tipa gp2, stoga je potrebno stvoriti posebnu klasu pohrane temeljenu na volumenu io1 za Kafka klaster:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Postavite za posrednike parametar min.insync.replicas=3 i implementirajte podove posrednika na čvorovima u tri različite dostupne zone:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Teme
Istovremeno smo pokretali tri instance generatora opterećenja. Svaka od njih piše u svoju temu, dakle ukupno nam trebaju tri teme:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
Za svaku temu faktor replikacije je 3 — minimalna preporučena vrijednost za visoko dostupne proizvodne sustave.
Alat za generiranje opterećenja
Pokrenuli smo tri instance generatora opterećenja (svaka upisuje u zasebnu temu). Za podove generatora opterećenja potrebno je postaviti afinitet čvora, kako bi se oni rasporedili samo na dodijeljene čvorove:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Nekoliko stvari na koje treba obratiti pažnju:
- Generator opterećenja generira poruke dužine 512 bajtova i objavljuje ih u Kafka serijama od 500 poruka.
- Pomoću argumenta
-required-acks=allobjavljivanje se smatra uspješnim kada su sve sinkronizirane replike poruka primljene i potvrđene brokersima Kafka. To znači da smo u benchmarku mjerili ne samo brzinu rada lidera koji primaju poruke, već i njihovi sljedbenika koji repliciraju poruke. Cilj ovog testa nije ocjenjivanje brzine čitanja od strane potrošača (consumers) nedavno prihvaćenih poruka, koje su trenutno u stranici predmemorije OS-a, i usporedbu s brzinom čitanja poruka koje se nalaze na disku. - Generator opterećenja paralelno pokreće 20 radnika (
-workers=20). Svaki radnik sadrži 5 producenata, koji zajednički koriste vezu radnika s klasterom Kafka. Na kraju, svaki generator broji 100 producenata, i svi oni šalju poruke u klaster Kafka.
Praćenje stanja klastera
Tijekom opterećenja testiranja Kafka klastera pratili smo i njegovo zdravlje kako bismo osigurali da nema ponovnih pokretanja podova, de-sinkroniziranih replikacija i maksimalne propusnosti s minimalnim fluktuacijama:
- Generator opterećenja bilježi standardnu statistiku o broju objavljenih poruka i razini grešaka. Postotak grešaka trebao bi ostati na
0,00%. - , implementiran od strane kafka operatora, pruža nadzornu ploču na kojoj također možemo pratiti stanje klastera. Za pregled ove nadzorne ploče izvršite:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - Razina ISR (broj replikacija „in-sync“) smanjenje i povećanje jednako je 0.
Rezultati mjerenja
3 brokera, veličina poruka — 512 bajtova
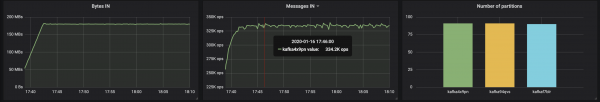
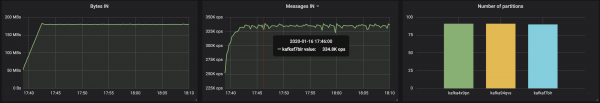
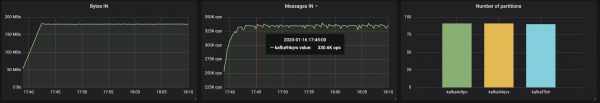
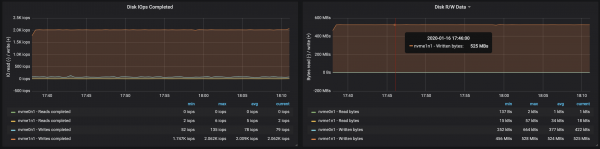
S particijama ravnomjerno raspoređenim po tri brokera, uspjeli smo postići performanse ~500 MB/s (otprilike 990 tisuća poruka u sekundi):
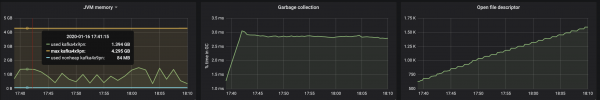
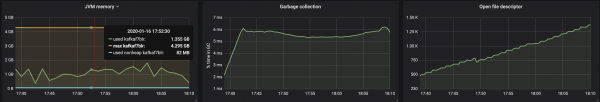
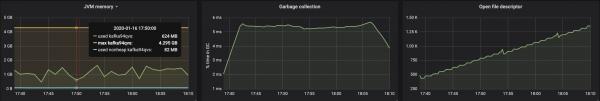
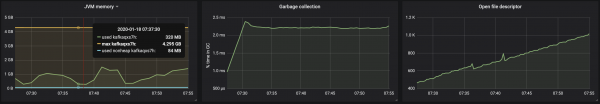
Potrošnja memorije virtualnog stroja JVM nije premašila 2 GB:
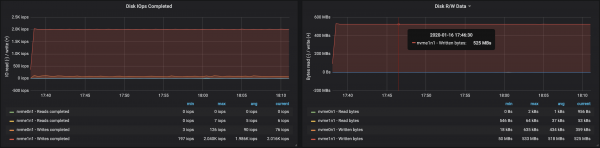
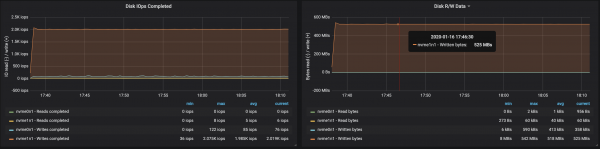
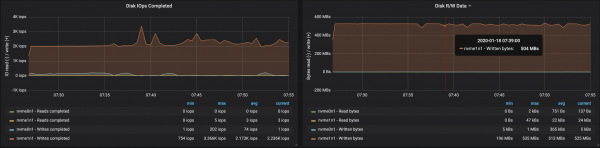
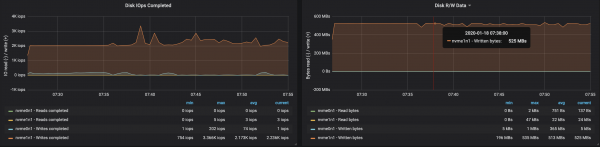
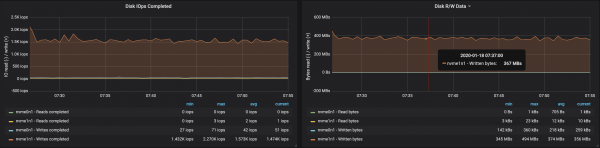
Propusnost diska dostigla je maksimalnu propusnost I/O čvora na svih tri instance na kojima su radili brokera:
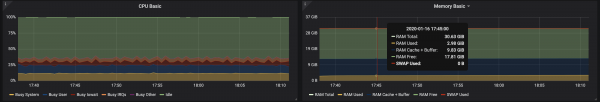
Iz podataka o korištenju memorije od strane čvorova, proizlazi da je sistemsko baferiranje i keširanje zauzelo ~10-15 GB:
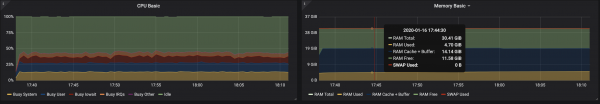
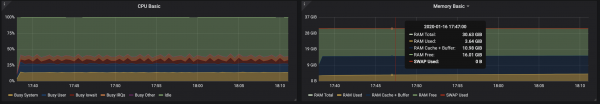
3 brokera, veličina poruka — 100 bajtova
S smanjenjem veličine poruka, propusnost opada otprilike 15-20%: utječe vrijeme koje je potrebno za obradu svake poruke. Osim toga, opterećenje procesora se gotovo udvostručilo.
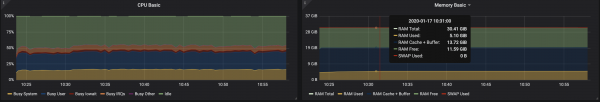
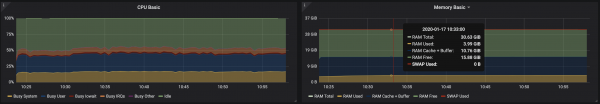
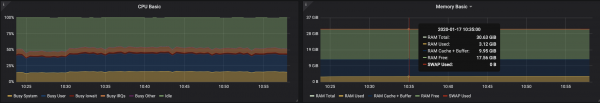
Budući da na čvorovima brokera i dalje postoje neiskorištena jezgra, performanse se mogu povećati mijenjanjem konfiguracije Kafke. To je složen zadatak, pa je za povećanje propusnosti bolje raditi s većim veličinama poruka.
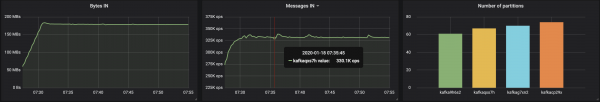
4 brokera, veličina poruka — 512 bajtova
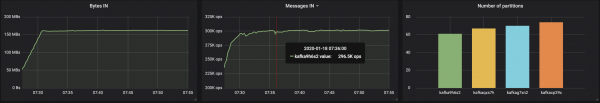
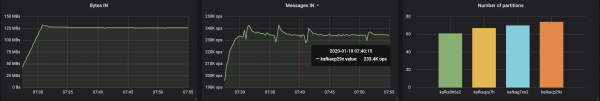
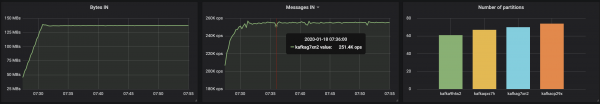
Performanse klastera Kafke mogu se lako povećati jednostavnim dodavanjem novih brokera i održavanjem ravnoteže particija (to osigurava ravnomjerno raspoređivanje opterećenja između brokera). U našem slučaju, nakon dodavanja brokera, propusnost klastera povećala se na ~580 MB/s (~1,1 milijuna poruka u sekundi). Rastući učinak bio je manji od očekivanog: prvenstveno je to objašnjeno nerazmjernim rasporedom particija (ne rade svi brokeri na vrhuncu svojih mogućnosti).
Korištenje memorije JVM mašine ostalo je ispod 2 GB:
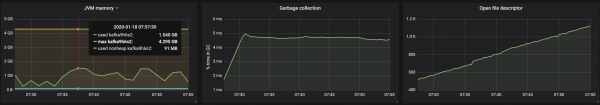
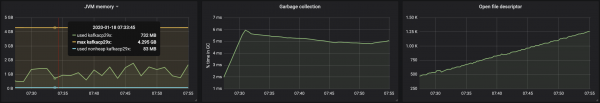
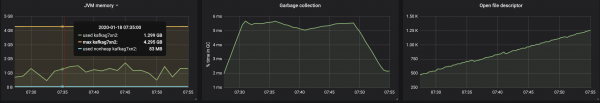
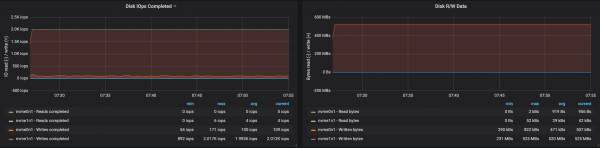
Na rad brokera s pohranjivačima utjecao je disbalans particija:
Zaključci
Gornji iterativni pristup može se proširiti kako bi obuhvatio složenije scenarije koji uključuju stotine potrošača, reparticioniranje, nadogradnje, ponovne pokrete podova itd. Sve to omogućuje nam procjenu granica mogućnosti Kafkinog klastera u različitim uvjetima, otkrivanje uskih grla u njegovom radu i pronalaženje načina da se nosimo s njima.
Razvili smo Supertubes za brzo i lako postavljanje klastera, njegovo konfiguriranje, dodavanje/uklanjanje brokera i tema, odgovor na obavijesti i osiguranje ispravnog rada Kafke u Kubernetesu u cjelini. Naš cilj je pomoći vam da se usredotočite na glavnu zadaću ("generirati" i "konzumirati" Kafkine poruke), dok ćemo sav težak posao prepustiti Supertubesu i Kafkinom operatoru.
Ako vas zanimaju tehnologije i Open Source projekti Banzai Clouda, pratite tvrtku na , ili .
P.S. od prevodioca
Pročitajte i na našem blogu:
- «»;
- «»;
- «».
Izvor: habr.com
