

Bok, Habr!
Podsjećamo vas da je objavljena još jedna iznimno zanimljiva i korisna o obrascima Kubernetes. Sve je počelo s "" Brendana Burnsa, a s druge strane, naš rad u ovom segmentu . Danas vam nudimo da pročitate članak s MinIO bloga, koji sažima trendove i specifičnosti obrazaca pohrane podataka u Kubernetesu.
Kubernetes je fundamentalno promijenio tradicionalne obrasce razvoja i implementacije aplikacija. Sada timu može trebati samo nekoliko dana za razvoj, testiranje i implementaciju aplikacije u različitim okruženjima, sve to unutar Kubernetes klastera. Ovakav rad s tehnologijama prethodnih generacija obično je trajao tjednima, ako ne i mjesecima.
Ovo ubrzanje postalo je moguće zahvaljujući apstrakciji koju pruža Kubernetes — to jest, zbog toga što Kubernetes sam upravlja interakcijama s niskonivnim detaljima fizičkih ili virtualnih mašina, omogućujući korisnicima da među ostalim parametrima odaberu potrebni procesor, potrebnu količinu RAM-a i broj instanci kontejnera. Budući da podršku Kubernetesu pruža ogromna zajednica, a primjena Kubernetes-a se stalno širi, on daleko prednjači među svim platformama za orkestraciju kontejnera.
Kako se korištenje Kubernetes-a širi, raste i zbunjenost oko obrazaca pohrane podataka koji se u njemu koriste..
U općoj konkurenciji za dio 'pite' Kubernetes (tj. za pohranu podataka), kada se razgovara o pohrani podataka, signal se gubi u snažnoj buci.
Kubernetes personificira moderni model razvoja i implementacije aplikacija, kao i njihovo upravljanje. Ovaj moderni model odvaja pohranu podataka od računanja. Da biste potpuno razumjeli ovu separaciju u kontekstu Kubernetes-a, također morate shvatiti što su aplikacije koje rade s pohranom stanja i one bez pohrane stanja, kao i kako se to usklađuje s pohranom podataka. U tom smislu, pristup REST API-ju korištenjem S3 ima očite prednosti u usporedbi s POSIX/CSI pristupom, karakterističnim za druga rješenja.
U ovom članku ćemo razgovarati o obrascima pohrane podataka u Kubernetesu i posebno se osvrnuti na raspravu o aplikacijama koje rade s i bez trajne pohrane, kako bismo u potpunosti razumjeli razliku između njih i zašto je ona važna. U nastavku ovog teksta bit će razmotrene aplikacije i korišteni obrasci pohrane podataka u svjetlu najboljih praksi rada s kontejnerima i Kubernetesom.
Kontejneri bez trajne pohrane
Kontejneri su po prirodi lagani i efemerni. Mogu se lako zaustaviti, ukloniti ili rasporediti na drugom čvoru – to su operacije koje traju samo nekoliko sekundi. U velikom sustavu orkestracije kontejnera takve se operacije neprekidno odvijaju, a korisnici čak ni ne primjećuju te promjene. Međutim, premještaji su mogući samo ako kontejner nema nikakve ovisnosti o čvoru na kojem se nalazi. O takvim se kontejnerima govori da rade bez trajne pohrane.
Kontejneri s trajnom pohranom
Ako kontejner pohranjuje podatke na lokalno povezanim uređajima (ili na blok uređaju), tada se pohrana podataka na kojoj se nalazi mora premjestiti na novi čvor zajedno s kontejnerom – u slučaju kvara. To je važno, jer inače aplikacija koja se pokreće u kontejneru neće moći ispravno funkcionirati, budući da mora pristupiti podacima sačuvanim na lokalnim medijima. O takvim se kontejnerima govori da rade s trajnom pohranom.
S tehničkog stajališta, kontejneri s trajnom pohranom također se mogu premještati na druge čvorove. To se obično postiže putem distribuiranih datotečnih sustava ili blok mrežnih skladišta podataka koji su priključeni na sve čvorove na kojima rade kontejneri. Na taj način kontejneri dobivaju pristup volumenima za trajnu pohranu podataka, a informacije se pohranjuju na diskovima raspoređenim po mreži. Ovu metodu ću nazvati "kontejnerskim pristupom s trajnom pohranom", i u ostatku članka ću je tako nazivati radi dosljednosti.
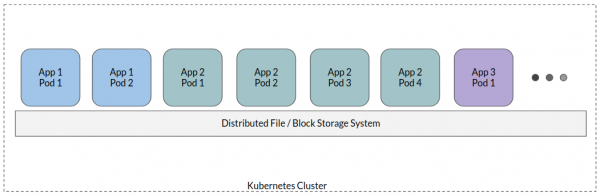
U tipičnom pristupu s kontejnerima s očuvanjem stanja, sve aplikacijske lopte su povezane s jednim distribuiranim datotečnim sustavom - tako se stvara svojevrsno zajedničko skladište, u kojem se nalaze svi podaci aplikacija. Iako su moguće neke varijacije, radi se o visokom razinu pristupa.
Sada se pozabavimo razlozima zašto je pristup kontejnerima s očuvanjem stanja u svijetu orijentiranom prema oblaku antipattern.
Projektiranje aplikacija orijentiranih prema oblaku
Tradicionalno, aplikacije su koristile baze podataka za strukturirano pohranjivanje informacija te lokalne diskove ili distribuirane datotečne sustave, u koje su se odlagali svi nestrukturirani ili čak polustrukturirani podaci. Kako su volumen nestrukturiranih podataka rasli, programeri su shvatili da je POSIX previše 'pričljiv', povezan je s značajnim troškovima i na kraju ometa rad aplikacije prilikom prelaska na stvarno velike razmjene.
To je uglavnom pridonijelo pojavi novog standarda pohrane podataka, odnosno oblačnim skladištima koja rade većinom putem REST API-ja, oslobađajući aplikaciju od opterećujućeg održavanja lokalnog skladišta podataka. U tom slučaju aplikacija zapravo prelazi u način rada bez očuvanja stanja (budući da se stanje nalazi u udaljenom skladištu). Moderne aplikacije se grade od nule uzimajući u obzir ovu činjenicu. Općenito, svaka moderna aplikacija koja obrađuje podatke razne vrste (logove, metapodatke, blobove itd.) izgrađena je prema oblačnoj paradigmi, gdje je stanje prebačeno u softverski sustav posebno dodijeljen za njegovu pohranu.
Pristup kontejnerima s očuvanjem stanja primorava cijelu ovu paradigmu da se vrati točno na ono s čega je započela!
Kada se koriste POSIX sučelja za pohranu podataka, aplikacije djeluju na način kao da pohranjuju stanje, a zbog toga se odstupa od najvažnijih postulata dizajniranja usmjerenog na oblake, to jest od mogućnosti prilagođavanja veličina radnih tokova aplikacije ovisno o ulaznom opterećenju, prebacivanja na novi čvor čim trenutni čvor otkaže, i tako dalje.
Pogledavši ovu situaciju pobliže, otkrivamo da se pri odabiru pohrane podataka ponovno suočavamo s dvojbom 'POSIX protiv REST API', ali s dodatnim pogoršanjem problema s POSIX-om, izazvanim distribuiranom prirodom Kubernetes okruženja. Konkretno,
- POSIX je ekstenzivan: semantika POSIX-a zahtijeva povezivanje svakog operacija s metapodacima i deskriptorima datoteka koji pomažu u održavanju stanja operacije. To dovodi do značajnih troškova, koji nemaju nikakvu stvarnu vrijednost. API-ji za pohranu objekata, posebno S3 API, oslobodili su se tih zahtjeva, omogućujući aplikaciji da djeluje, a zatim 'zaboravi' poziv. Odgovor sustava za pohranu podataka ukazuje je li je ta radnja uspješno izvedena ili nije. U slučaju neuspjeha, aplikacija može izvršiti ponovno pokušavanje.
- Mrežna ograničenja: U distribuiranom sustavu podrazumijeva se da može postojati više aplikacija koje pokušavaju zapisati podatke na isti priključeni uređaj. Stoga, osim što će se aplikacije natjecati jedna s drugom za propusnost (da bi poslala podatke na uređaj), sam sustav pohrane podataka će se natjecati za tu propusnost, distribuirajući podatke po fizičkim diskovima. Zbog ekstenzivnosti POSIX-a, broj mrežnih poziva raste nekoliko puta. S druge strane, S3 API osigurava jasno razdvajanje mrežnih poziva između onih koji dolaze od klijenta do servera i onih koji se odvijaju unutar servera.
- Sigurnost: Model sigurnosti POSIX zahtijeva aktivno sudjelovanje korisnika: administratori konfiguriraju određene razine pristupa za svakog korisnika ili grupu. Ova paradigma teško se prilagođava oblaku orijentiranom svijetu. Moderni aplikacije ovise o modelima sigurnosti vezanim uz API, gdje se prava pristupa definiraju kao skup pravila, dodjeljuju se servisni računi, privremene vjerodajnice itd.
- Upravljivost: Kontejneri s očuvanjem stanja nose određene troškove povezane s upravljanjem. Riječ je o usklađivanju paralelnog pristupa podacima, osiguravajući dosljednost podataka, sve to zahtijeva pažljivo razmatranje koji obrasci pristupa podacima se koriste. Potrebno je instalirati, nadzirati i konfigurirati dodatne programe, a ne spominjući dodatne napore u razvoju.
Kontejnersko sučelje za pohranu podataka
Iako je sučelje kontejnerske pohrane podataka (CSI) odlično pomoglo u širenju razine volumena Kubernetes, dijelom prenoseći ga vanjskim dobavljačima pohrane podataka, također je slučajno doprinijelo uvjerenju da je kontejnerski pristup s očuvanjem stanja preporučena metoda za pohranu podataka u Kubernetesu.
CSI je razvijen kao standard za pružanje proizvoljnih sustava blokovne i datotečne pohrane naslijeđenim aplikacijama pri radu s Kubernetesom. Kao što je prikazano u ovom članku, jedina situacija u kojoj je kontejnerski pristup s očuvanjem stanja (i CSI u njegovom sadašnjem obliku) opravdan je kada je sama aplikacija naslijeđeni sustav u kojem nije moguće dodati podršku za API objektne pohrane podataka.
Važno je razumjeti da, koristeći CSI u njegovom sadašnjem obliku, to jest, montirajući volumene pri radu s modernim aplikacijama, susrest ćemo se s otprilike istim problemima koji su se javljali u sustavima gdje je pohrana podataka organizirana u POSIX stilu.
Kvalitetniji pristup
U ovom slučaju važno je razumjeti da većina aplikacija po svojoj prirodi nije prilagođena za rad sa stanjem ili bez stanja. Takvo ponašanje ovisi o općoj arhitekturi sustava i o specifičnim opcijama odabranim prilikom dizajniranja. Razgovarajmo malo o aplikacijama koje zadržavaju stanje.
U načelu, svi podaci aplikacija mogu se podijeliti na nekoliko širokih tipova:
- Podaci o zapisima
- Podaci o vremenskim oznakama
- Podaci o transakcijama
- Metapodaci
- Slikovne kontenjere
- BLOB podaci (veliki binarni objekti)
Svi ovi tipovi podataka vrlo dobro se podržavaju na modernim platformama za pohranu podataka, a postoji nekoliko oblake orijentiranih platformi prilagođenih za isporuku podataka u svakom od ovih specifičnih formata. Na primjer, podaci o transakcijama i metapodaci mogu se nalaziti u modernoj oblaku orijentiranoj bazi podataka poput CockroachDB, YugaByte itd. Slikovne kontenjere ili BLOB podaci mogu se pohraniti u docker registru temeljenom na MinIO-u. Podaci vremenskih oznaka mogu se pohraniti u bazi podataka vremenskih serija, kao što je InfluxDB itd. Nećemo se ovdje upuštati u detalje svakog tipa podataka i odgovarajućih aplikacija, ali opća ideja je izbjeći trajnu pohranu podataka koja se temelji na lokalnom montaži diskova.
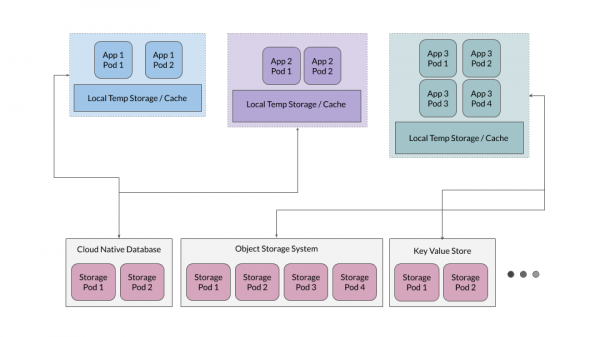
Osim toga, često se pokazuje učinkovitim pružiti razinu privremenog predmemoriranja koja služi aplikacijama kao svojevrsno skladište privremenih datoteka, ali aplikacije ne bi trebale ovisiti o toj razini kao izvoru istine.
Skladište za aplikacije s očuvanjem stanja
Dok je u većini slučajeva korisno držati aplikacije bez stanja, one aplikacije koje su namijenjene za pohranu podataka – poput baza podataka, objektnog skladišta, skladišta ključeva i vrijednosti – trebaju zadržati stanje. Razjasnimo zašto se ove aplikacije implementiraju na Kubernetesu. Kao primjer uzmimo MinIO, ali slični principi primjenjuju se i na bilo koje druge velike oblake orijentirane sustave za pohranu podataka.
Aplikacije orijentirane na oblak dizajnirane su za maksimalno učinkovitu upotrebu fleksibilnosti svojstvene kontejnerima. To znači da se ne čine nikakva pretpostavka o okruženju u kojem će se implementirati. Na primjer, MinIO koristi unutarnji mehanizam za višak kodiranja (erasure coding) koji pruža sustavu dovoljno otpornosti da ostane funkcionalan čak i u slučaju kvara polovice diskova. Također, MinIO upravlja integritetom i sigurnošću podataka koristeći vlastito heširanje i enkripciju na strani poslužitelja.
Za takve aplikacije orijentirane na oblak, lokalni trajni volumen (PV) je najprikladniji kao rezervno skladište. Lokalni PV omogućuje pohranu sirovih podataka, dok aplikacije koje rade na tim PV-ima samostalno prikupljaju informacije koje omogućuju skaliranje podataka i upravljanje rastućim zahtjevima za podacima.
Ovaj pristup je mnogo jednostavniji i značajno bolje se skalira u usporedbi s PV-ima temeljenim na CSI, koji donose vlastite razine upravljanja podacima i redundancije; naime, te razine obično ometaju aplikacije dizajnirane prema principu očuvanja stanja.
Odlučno usmjeravanje podataka od izračuna
U ovom članku govorili smo o tome kako se aplikacije preusmjeravaju na rad bez očuvanja stanja, ili, drugim riječima, pohrana podataka se odvaja od izračuna nad njima. Na kraju, razmotrit ćemo nekoliko stvarnih primjera ovog trenda.
, poznata platforma za analizu podataka, tradicionalno se koristila s očuvanjem stanja i implementacijom u HDFS datotečni sustav. Međutim, kako Spark prelazi u svijet orijentiran na oblak, ova platforma se sve više koristi bez očuvanja stanja s korištenjem `s3a`. Spark koristi s3a za prijenos stanja u druge sustave, dok sami Spark kontejneri rade potpuno bez očuvanja stanja. Druge velike tvrtke u području analitike velikih podataka, osobito, , , također prelaze na rad s odvojenim skladištenjem podataka i izračunima nad njima.
Slični obrasci su također prisutni na drugim velikim analitičkim platformama, uključujući Presto, Tensorflow to R, Jupyter. Izvozom stanja u udaljene oblake za pohranu podataka, mnogo je jednostavnije upravljati vašom aplikacijom i skalirati je. Osim toga, to doprinosi prenosivosti aplikacije u raznolika okruženja.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish