

Kanarinac je mala ptica koja stalno pjeva. Ove ptice su osjetljive na metan i ugljični monoksid. Čak i od male koncentracije štetnih plinova u zraku gube svijest ili umiru. Zlatoiskunici i rudari su nosili ptice sa sobom: dok kanarinci pjevaju, mogu raditi; ako su utihnuli — u rudniku je plin i vrijeme je za izlazak. Rudari su žrtvovali male ptice kako bi se iz rudnika vratili živi.
Slična praksa našla je svoje mjesto i u IT-u. Na primjer, u standardnom zadatku postavljanja nove verzije usluge ili aplikacije na produkciju uz prethodno testiranje. Testno okruženje može biti preskupo, automatizirani testovi ne pokrivaju sve što bi se željelo, a ne testirati i žrtvovati kvalitetu je rizično. U takvim situacijama pomaže pristup Canary Deployment, kada se malo stvarnog produkcijskog prometa usmjeri na novu verziju. Ovaj pristup pomaže sigurno provjeriti novu verziju na produkciji, žrtvujući malo radi velike cilja. Detaljnije o tome kako pristup funkcionira, čemu koristi i kako ga implementirati, reći će Andrej Markelov (), na primjeru implementacije u kompaniji Infobip.
Andrej Markelov — vodeći inženjer-programer u Infobipu, već 11 godina se bavi razvojem aplikacija na Javi u području financija i telekomunikacija. Razvija Open Source proizvode, aktivno sudjeluje u Atlassian Community i piše dodatke za proizvode Atlassian. Evangelist Prometheus, Docker i Redis.
O kompaniji Infobip
To je globalna telekomunikacijska platforma koja bankama, trgovcima, internetskim trgovinama i transportnim kompanijama omogućuje slanje poruka svojim klijentima putem SMS-a, push notifikacija, e-maila i glasovnih poruka. U takvom poslu stabilnost i pouzdanost su ključni, kako bi klijenti na vrijeme primali poruke.
IT infrastruktura Infobipa u brojkama:
- 15 podatkovnih centara širom svijeta;
- 500 jedinstvenih usluga u operaciji;
- 2500 instanci usluga, što je daleko više od broja timova;
- 4,5 Tbyte mjesečnog prometa;
- 4,5 milijarde telefonskih brojeva;
Posao raste, a s njim i broj izdanja. Izlazimo s 60 izdanja dnevno, jer klijenti žele više mogućnosti i kapaciteta. No, to je teško — usluga je puno, a timova malo. Moramo brzo pisati kod koji mora raditi u produkciji bez grešaka.
Izdanja
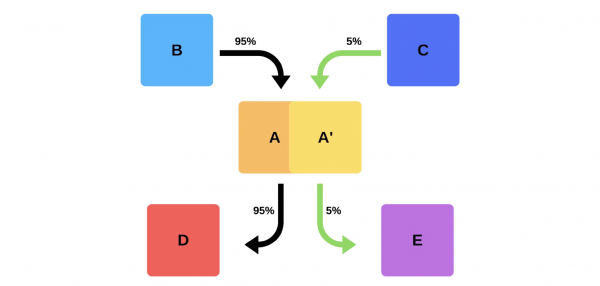
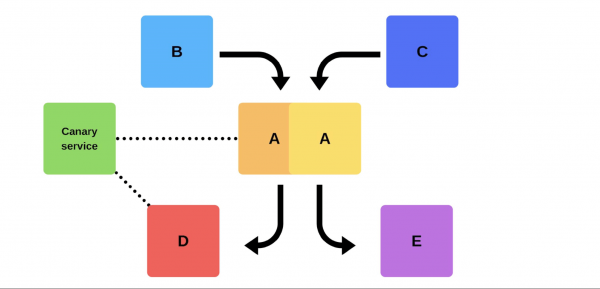
Tipična objava kod nas prolazi ovako. Na primjer, postoje usluge A, B, C, D i E, od kojih svaka razvija zasebna ekipa.
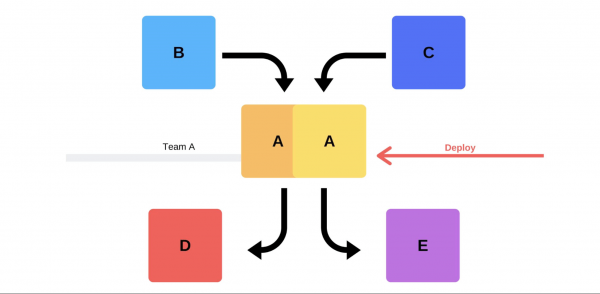
U nekom trenutku ekipa usluge A odlučuje da objavi novu verziju, ali ekipe usluga B, C, D i E o tome ne znaju. Imamo dva moguća postupka za ekipu usluge A.
Provesti inkrementalno objavljivanje: prvo zamijeniti jednu verziju, a zatim drugu.
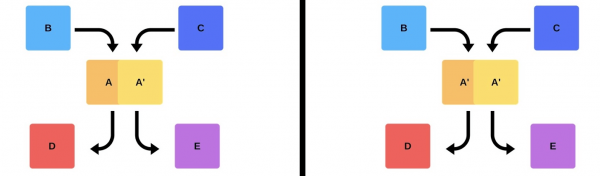
No postoji i druga opcija: ekipa pronađe dodatne resurse i strojeve, objavi novu verziju, a zatim preusmjeri usmjerivač, a verzija će postati aktivna na produkciji.
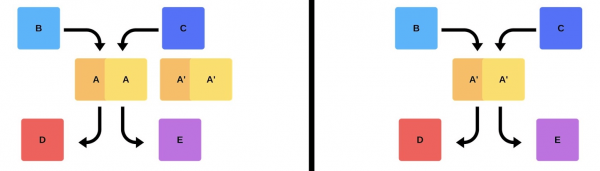
U svakom slučaju, nakon objavljivanja gotovo uvijek nastaju problemi, čak i ako je verzija testirana. Može se testirati ručno, automatski, ili se može uopće ne testirati — problemi će se pojaviti u svakom slučaju. Najjednostavniji i ispravni način da ih riješimo je vratiti se na radnu verziju. Nakon toga možemo istražiti štetu, uzroke i ispraviti ih.
Dakle, što želimo?
Problemi nam nisu potrebni. Ako klijenti otkriju probleme prije nas, to će utjecati na reputaciju. Stoga moramo brže otkrivati probleme od klijenata.Radeći proaktivno, minimiziramo štetu.
Istovremeno, želimo ubrzać objavljivanje, tako da se odvija brzo, lako, prirodno i bez stresa za ekipu. Inženjere, DevOps inženjere i programere treba čuvati — objava nove verzije je stresna situacija. Ekipa nije potrošni materijal; težimo racionalno koristiti ljudske resurse..
Problemi s objavljivanjem
Klijentski promet je nepredvidiv.Nemoguće je predvidjeti kada će biti minimalni klijentski promet. Ne znamo gdje i kada klijenti započinju svoje kampanje — možda noćas u Indiji, a sutra u Hong Kongu. S obzirom na velike razlike u vremenu, objavljivanje čak i u 2 ujutro ne jamči da klijenti neće pretrpjeti štetu.
Problemi s pružateljima.Messengeri i pružatelji su naši partneri. Ponekad imaju prekide koji uzrokuju greške tijekom objavljivanja novih verzija.
Distribuirane ekipe.Ekipe koje razvijaju klijentski dio i backend nalaze se u različitim vremenskim zonama. Zbog toga često ne mogu dogovoriti međusobnu suradnju.
Data centri se ne mogu ponoviti na stagingu.U jednom data centru ima 200 rackova — ponoviti to u sandboxu čak ni približno nije moguće.
Zastojinisu dopušteni! Imamo prihvatljivu razinu dostupnosti (Error Budget), kada radimo 99,99% vremena, dok su preostali postotci naše „pravo na grešku“. Postići 100% pouzdanosti je nemoguće, ali je važno neprekidno pratiti padove i zastoje.
Klasične opcije rješenja
Pisanje koda bez grešaka. Kada sam bio mladi programer, menadžeri su dolazili s molbom da objavimo verziju bez grešaka, ali to nije uvijek moguće.
Pisanje testova. Testovi rade, ali ponekad ne onako kako to posao želi. Zarađivanje novca nije zadatak testova.
Testiranje na stajalištu. Za 3,5 godine mog rada u Infobipu nikada nisam vidio da stanje stajališta barem djelomično odgovara produkciji.
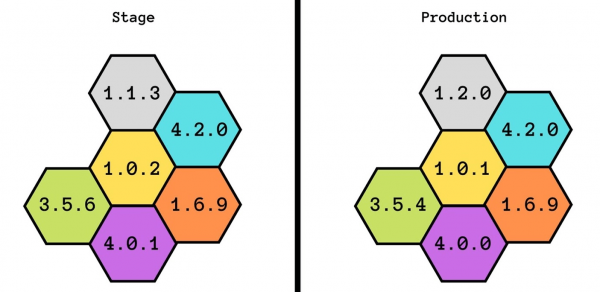
Čak smo pokušali razviti tu ideju: prvo smo imali stajalište, zatim pre-produkciju, a zatim pre-produkciju pre-produkcije. No, to također nije pomoglo — nisu se podudarali ni po kapacitetu. Sa stajalištem možemo jamčiti osnovnu funkcionalnost, ali ne znamo kako će funkcionirati pod opterećenjem.
Objavu radi onaj tko je razvijao. To je dobra praksa: čak i ako netko mijenja naziv komentara, odmah ga dodaje u produkciju. To pomaže razvijanju odgovornosti i ne zaboravljanju na unesene promjene.
Dodatne složenosti također postoje. Za programera je stres — trošiti mnogo vremena da sve provjeri ručno.
Dogovorene objave. Ovu opciju obično predlaže menadžment: „Dogovorimo se da ćemo svakodnevno testirati i dodavati nove verzije“. To ne funkcionira: uvijek postoji tim koji čeka ostale ili obrnuto.
Smoke testovi
Još jedan način rješavanja naših problema s implementacijom. Razmotrite kako smoke testovi rade na prethodnom primjeru kada tim A želi objaviti novu verziju.
Prvo tim implementira jedan instancu u produkciju. Porukama u instancu od moke imitira se stvarni promet, kako bi se podudarao s normalnim dnevnim prometom. Ako je sve u redu, tim prebacuje novu verziju na korisnički promet.
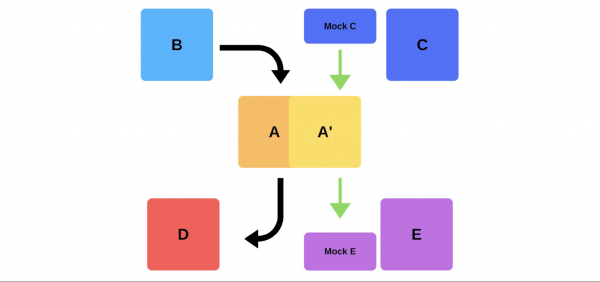
Druga opcija je implementirati s dodatnim hardverom. Tim ga testira u produkciji, zatim prebacuje, i sve radi.
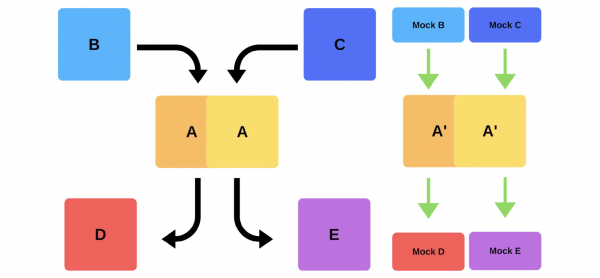
Nedostaci smoke testova:
- Testovima se ne može vjerovati. Gdje pronaći isti promet kao na produkciji? Može se koristiti jučerašnji ili tjedan dana stari, ali to ne odgovara uvijek trenutnom.
- Teško se održava. Treba održavati testne račune, stalno ih resetirati prije svakog implementiranja kada se u pohranu šalju aktivni zapisi. To je složenije nego pisanje testa u vlastitom pijesku.
Jedina prednost ovdje je — može se provjeriti izvedba.
Canary implementacije
Zbog nedostatka smoke testova počeli smo koristiti canary implementacije.
Praksa, slična onoj kako su rudari koristili kanarince za indikaciju razine plinova, našla je primjenu i u IT-u. Pustimo mali dio stvarnog produkcijskog prometa na novu verziju, pritom nastojeći ostati unutar Ugovora o razini usluge (SLA). SLA je naše „pravo na grešku“ koje možemo iskoristiti jednom godišnje (ili u nekom drugom vremenskom razdoblju). Ako sve bude u redu, dodamo više prometa. Ako ne — vraćamo prethodne verzije.
Implementacija i nijanse
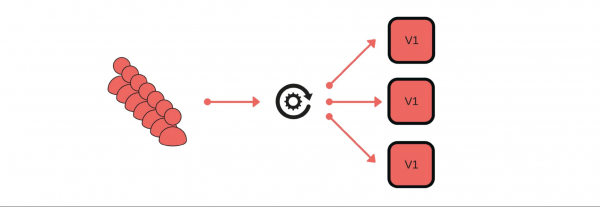
Kako smo implementirali canary implementacije? Na primjer, grupa klijenata šalje poruke putem naše usluge.
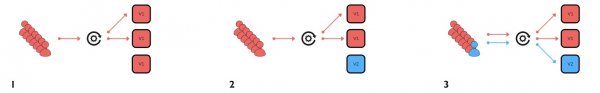
Implementacija prolazi ovako: uklanjamo jedan čvor s balansiranja opterećenja (1), mijenjamo verziju (2) i posebno puštamo malo prometa (3).
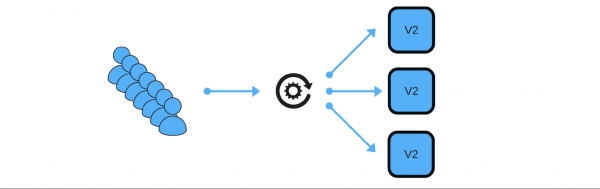
U cjelini, svi u grupi bit će zadovoljni, čak i ako jedan korisnik nije. Ako bude sve u redu — promijenimo sve verzije.
Pokažem kako to izgleda za mikroservise u većini slučajeva.
Postoji Otkriće usluga i još dvije usluge: S1N1 i S2. Prva usluga (S1N1) obavještava Otkriće usluga kada se pokrene, a Otkriće usluga je pamti. Druga usluga s dva čvora (S2N1 i S2N2) također obavještava Otkriće usluga pri pokretanju.
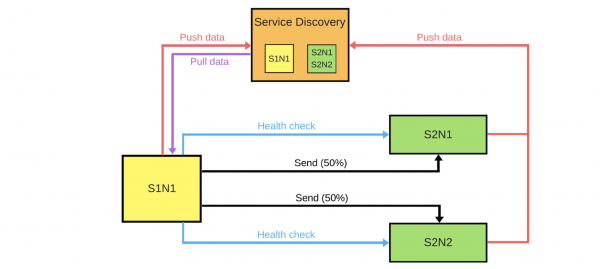
Druga usluga za prvu djeluje kao server. Prva traži od Otkrića usluga informacije o svojim serverima, a kada ih primi — traži i provjerava ih ("health check"). Kada ih provjeri, šalje im poruke.
Kada netko želi implementirati novu verziju druge usluge, obavještava Otkriće usluga da će drugi čvor biti canary čvor: na njega će se slati manje prometa jer će se sada provoditi implementacija. Uklanjamo canary čvor s balansiranja opterećenja i prva usluga mu ne šalje promet.
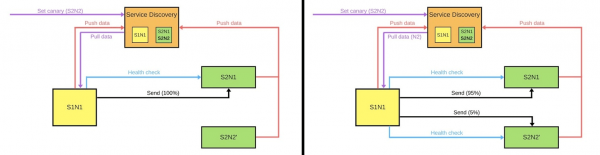
Mijenjamo verziju i Service Discovery zna da je druga čvor sada canary — možemo joj dati manju opterećenost (5%). Ako je sve dobro, mijenjamo verziju, vraćamo opterećenje i nastavljamo raditi.
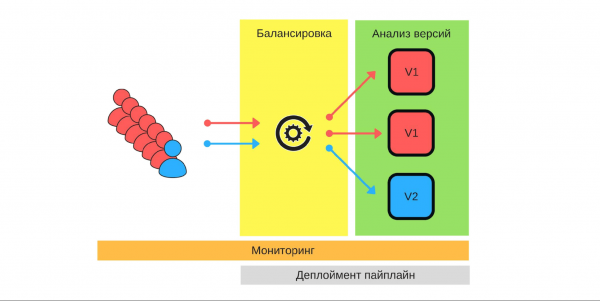
Da bismo to realizirali, potrebni su nam:
- ravnoteža;
- monitoring, jer je važno znati što očekuje svaki korisnik i kako naši servisi rade detaljno;
- analiza verzija, kako bismo razumjeli koliko će nova verzija dobro raditi u produkciji;
- automatizacija — pišemo redoslijed implementacije (deployment pipeline).
Uravnoteženje
To je prvo o čemu bismo trebali razmisliti. Postoje dvije strategije ravnoteže.
Najjednostavnija opcija, kada jedan čvor uvijek bude canary. Ovaj čvor uvijek dobiva manje prometa i započinjemo implementaciju s njim. U slučaju problema, usporedit ćemo njegov rad prije implementacije i tijekom nje. Na primjer, ako je broj grešaka povećan dvostruko, znači da je i šteta porasla dvostruko.
Canary čvor se postavlja tijekom implementacije. Kada je implementacija završena i skinemo status canary čvora, ravnoteža prometa će se obnoviti. S manjim brojem strojeva dobit ćemo poštenu distribuciju.
Monitoring
Temeljni kamen canary izdanja. Moramo točno razumjeti zašto to radimo i koje metrike želimo prikupljati.
Primjeri metrika koje prikupljamo s naših servisa.
- Broj grešaka, koji se bilježe u logovima. To je očigledan pokazatelj da sve funkcionira kako treba. U cjelini, to je dobra metrika.
- Vrijeme izvršenja zahtjeva (latencija). Ovu metriku prate svi, jer svi žele raditi brzo.
- Veličina reda (protok).
- Broj uspješnih odgovora u sekundi.
- Vrijeme izvršenja 95% svih zahtjeva.
- Poslovne metrike: koliko novca posao zarađuje u određenom vremenskom razdoblju ili odliv korisnika. Ove metrike za našu novu verziju mogu biti važnije od onih koje dodaju inženjeri.
Primjeri metrika u većini popularnih sustava za praćenje.
Brojač. To je neka rastuća veličina, na primjer, broj grešaka. Ovu metriku je lako interpolirati i proučavati grafikon: jučer je bilo 2 greške, a danas 500, znači da nešto nije u redu.
Broj grešaka u minuti ili sekundi, to je najvažniji pokazatelj koji se može izračunati korištenjem Brojača. Ovi podaci daju jasnu sliku o radu sustava na daljinu. Razmotrimo primjer grafikona broja grešaka u sekundi za dvije verzije produkcijskog sustava.
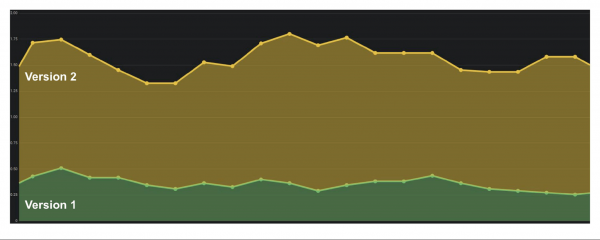
U prvoj verziji bilo je malo grešaka, možda nije radio audit. U drugoj verziji je sve puno gore. Može se sigurno reći da postoje problemi, pa moramo vratiti ovu verziju.
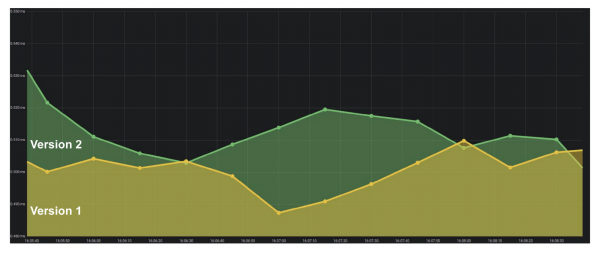
Gauge. Metrike su slične Counteru, ali zapisujemo vrijednosti koje se mogu povećavati i smanjivati. Na primjer, vrijeme izvršenja zahtjeva ili veličina reda.
Na grafikonu je primjer vremena odziva (latencija). Na grafiku se vidi da su verzije slične, s njima se može raditi. No, ako se bolje pogleda, primjetna su strujanja. Ako se vrijeme izvršenja zahtjeva povećava s dodavanjem korisnika, odmah je jasno da postoje problemi — ranije to nije bilo tako.
Sažetak. Jedan od najvažnijih pokazatelja za poslovanje — percentili. Metrika ukazuje da u 95% slučajeva naš sustav radi onako kako želimo. Možemo se pomiriti s tim da negdje postoje problemi, jer razumijemo općeniti trend, koliko je sve dobro ili loše.
Alati
ELK Stack. Canary se može implementirati koristeći Elasticsearch — zapisujemo u njega greške kada se događaju događaji. Najjednostavnijim pozivom API-ja možemo dobiti broj grešaka u bilo kojem trenutku i usporediti s prošlim razdobljima: GET /applg/_cunt?q=level:errr.
Prometheus. Dobro se pokazao u Infobipu. Omogućuje implementaciju višedimenzionalnih metrika jer se koriste oznake.
Možemo koristiti level, instance, usluga, kombinirati ih u jednom sustavu. Pomoću offset može se pogledati, na primjer, vrijednost magnitude prije tjedan dana samo jednim pozivom GET /api/v1/query?query={query}, gdje {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Analiza verzija
Postoji nekoliko strategija analize verzija.
Gledati metrike samo canary čvorova. Jedna od najjednostavnijih opcija: implementirali smo novu verziju i proučavamo samo rad. No, ako inženjer u to vrijeme počne proučavati logove, stalno nervozno osvježavajući stranice, tada je ovo rješenje ne razlikuje se od ostalih.
Canary čvor se uspoređuje s bilo kojim drugim čvorom. Ovo je usporedba s drugim instancama koje rade s punim prometom. Na primjer, ako s malim prometom situacija nije bolja, ili nije bolja od stvarnih instanci, onda nešto nije u redu.
Canary čvor se uspoređuje sa sobom iz prošlosti. Nodi dodijeljeni za canary mogu se usporediti s povijesnim podacima. Na primjer, ako je prije tjedan dana sve bilo u redu, možemo se osloniti na te podatke kako bismo razumjeli trenutnu situaciju.
Automatizacija
Želimo osloboditi inženjere ručnog uspoređivanja, stoga je važno implementirati automatizaciju. Proces isporuke (deployment pipeline) obično izgleda ovako:
- pokrećemo;
- uklanjamo nodu iz opterećenja balancera;
- postavljamo canary-nodu;
- uključujemo balancer s ograničenom količinom prometa;
- uspoređujemo.
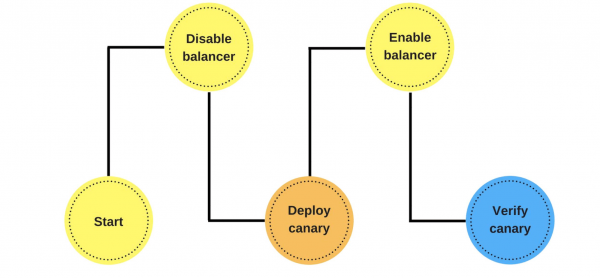
U ovoj fazi implementiramo automatsko uspoređivanje. Kako to može izgledati i zašto je bolje od provjere nakon implementacije, razmotrit ćemo na primjeru iz Jenkins-a.
Ovo je pipeline u Groovy-ju.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary nije uspio, treba se vratiti"
        return false
    }
}
Ovdje u petlji postavljamo da ćemo uspoređivati novu nodu tijekom sata. Ako canary proces još nije završio — pozivamo funkciju. Ona javlja je li sve u redu ili ne: def isOk = compare(srv, canary, time, base, offset, metrics).
Ako je sve u redu — sleep DEFAULT SLEEP, na primjer, sekundu, i nastavljamo. Ako nije, izlazimo — implementacija nije uspjela.
Opis metrike. Pogledajmo kako može izgledati funkcija compare na primjeru DSL-a.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Pretpostavimo da uspoređujemo broj grešaka i želimo znati broj grešaka u sekundi u posljednjih 5 minuta.
Imamo dvije vrijednosti: osnovnu i canary-nodu. Vrijednost za canary-nodu — aktualna. Osnovna — baseValue — je vrijednost bilo koje druge ne canary-node. Uspoređujemo vrijednosti međusobno prema formuli koju postavljamo na temelju svog iskustva i opažanja. Ako je vrijednost canaryValue loša, tada implementacija nije uspjela i vraćamo se.
Zašto je to sve potrebno?
Čovjek ne može provjeriti stotine i tisuće metrika, pogotovo ne brzo. Automatsko uspoređivanje pomaže provjeriti sve metrike i brzo obavijestiti o problemima. Vrijeme obavijesti je ključno: ako se nešto dogodilo u posljednje 2 sekunde, šteta će biti manja nego da se dogodilo prije 15 minuta. Dok netko primijeti problem, javi podršci, a podrška nama, da se vratimo, možemo izgubiti klijente.
Ako je proces prošao i sve je u redu, automatski postavljamo sve ostale čvorove. U tom trenutku inženjeri ne rade ništa. Samo kada pokrenu canary, odlučuju koje metrike uzeti, koliko dugo raditi usporedbu, koju strategiju koristiti.
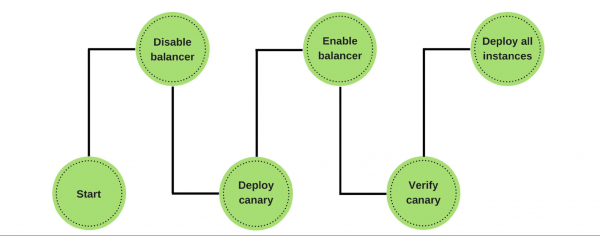
Ako se pojave problemi — automatski vraćamo canary-čvor, radimo na prethodnim verzijama i ispravljamo greške koje smo pronašli. Po metrikinama ih je lako naći i vidjeti štetu od nove verzije.
Prepreke
Ostvariti to naravno nije lako. Prvo je potrebna sveobuhvatna monitoring sustav. Inženjeri imaju svoje metrike, podrška i analitičari imaju druge, a poslovanje treće. Sveobuhvatni sustav je zajednički jezik kojim se razgovara između poslovanja i razvoja.
Treba provjeriti u praksi stabilnost metrika. Provjera pomaže shvatiti, koji minimalni skup metrika je potreban za osiguranje kvalitete.
Kako to postići? Koristiti canary-uslugu ne u trenutku implementacije. Dodajemo na staru verziju neku uslugu koja u bilo kojem trenutku može preuzeti bilo koji dodijeljeni čvor, smanjiti promet bez implementacije. Zatim uspoređujemo: proučavamo greške i tražimo onu granicu kada postižemo kvalitetu.
Kakvu korist imamo od canary-izdanja
Minimalizirali smo postotak štete od grešaka. Većina grešaka implementacije događa se zbog nesklada nekih podataka ili prioriteta. Takvih grešaka je značajno manje, jer možemo riješiti problem u prvim sekundama.
Optimizirali smo rad timova. Novaci imaju "pravo na grešku": mogu implementirati u produkciju bez straha da će pogriješiti, pojavljuje se dodatna inicijativa, poticaj za rad. Ako nešto pokvare, to neće biti kritično, a nećemo otpustiti onoga koji je pogriješio.
Automatizirali smo implementaciju. To više nije ručni proces kao ranije, već pravi automatizirani postupak. No, traje duže.
Izdvojili smo važne metrike. Cela kompanija, počevši od poslovanja do inženjera, razume što je zaista važno u našem proizvodu, koje metrike, na primer, odliv i priliv korisnika. Kontroliramo proces: testiramo metrike, uvodimo nove, gledamo kako rade stare, kako bismo izgradili sistem koji će efikasnije generirati prihod.
Imamo mnogo sjajnih praksi i sustava koji nam pomažu. Unatoč tome, težimo biti profesionalci i raditi svoj posao kvalitetno, bez obzira na to imamo li sustav koji nam pomaže ili ne.
Inženjerski pristupi i prakse — . Ako ste postigli uspjehe na putu ka tehničkoj izvrsnosti i spremni ste podijeliti što vam je u tome pomoglo — .
Planiramo održati 8. lipnja. Shvaćamo da je u ovom trenutku teško donijeti odluku o sudjelovanju na konferenciji. No u isto vrijeme vjerujemo da karantena nije razlog zaustavljanju profesionalne komunikacije i razvoja. Stoga ćemo svakako pronaći način da raspravimo izazove vođenja tima i pristupe njihovom rješavanju — ako bude potrebno, preći ćemo na online i razviti umrežavanje tamo!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish