

Prije nekoliko mjeseci — javnu za PostgreSQL.
U proteklom vremenu koristili ste je više od 6000 puta, ali jedna od korisnih funkcija mogla bi ostati neprimijećena — to su strukturne sugestije, koje izgledaju otprilike ovako:
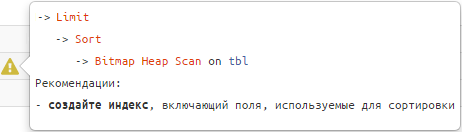
Slušajte ih, i vaši upiti „bit će glatki i svilenkasti“. 🙂
A ozbiljno, mnoge situacije koje čine upit sporim i „resource-hungry“ su tipične i mogu se prepoznati prema strukturi i podacima plana..
U ovom slučaju svakom pojedinačnom programeru neće biti potrebno da samostalno traži opciju optimizacije, oslanjajući se isključivo na vlastito iskustvo — možemo mu sugerirati što se ovdje događa, koja bi mogla biti uzrok, i kako se može pristupiti rješenju.. Što smo i učinili.
Pogledajmo malo detaljnije ove slučajeve — kako ih prepoznati i na koje preporuke dovode.
Za bolje uranjanje u temu, prvo možete poslušati odgovarajući djelić iz , a zatim preći na detaljnu analizu svake situacije:
#1: индексная «недосортировка»
Kada
Prikaži posljednji račun za klijenta „OOO Kolokolicik“.
Kako prepoznati
-> Limit
   -> Sort
      -> Index [Samo] Skeniranje [Unazad] | Bitmap Heap Skeniranje
Preporuke
Koristi se indeks proširiti poljima sortiranja.
Primjer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "faktora"
, (random() * 1000)::integer fk_cli; -- 1K raznih vanjskih ključeva

CREATE INDEX ON tbl(fk_cli); -- indeks za foreign key

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- odabir prema specifičnoj vezi
ORDER BY
  pk DESC -- želimo samo jedan "posljednji" zapis
LIMIT 1; 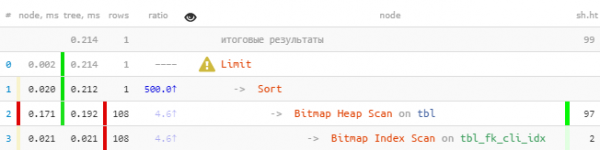
Odmah se može primijetiti da je po indeksu pročitano više od 100 zapisa, koji su se potom svi sortirali, a zatim je ostavljen samo jedan.
Ispravka:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- dodali smo ključ sortiranja
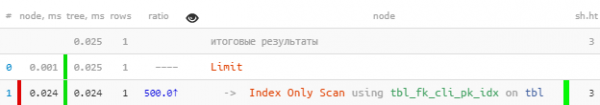
Čak i na tako primitivnom odabiru — 8.5 puta brže i 33 puta manje čitanja.Efekt će biti time jasniji, što više „faktora“ imate za svaku vrijednost fk..
Napominjem da će takav indeks raditi kao „prefiksni“ jednako dobro kao i prethodni i za druge upite s fk., gdje sortiranja prema pk nije bilo i nema (više o tome možete pročitati ). Uključujući, osigurat će i normalnu podršku za izričiti vanjski ključ prema ovom polju.
#2: пересечение индексов (BitmapAnd)
Kada
Prikaži sve ugovore za klijenta «OOO Kolokolčik», sklopljene u ime «NAO Ljutik».
Kako prepoznati
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Preporuke
Stvori kompozitni indeks po poljima iz oba izvorna ili proširiti jedan od postojećih polja iz drugog.
Primjer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "faktora"
, (random() *  100)::integer fk_org  -- 100 različitih stranih ključeva
, (random() * 1000)::integer fk_cli; -- 1K različitih stranih ključeva

CREATE INDEX ON tbl(fk_org); -- indeks za strani ključ
CREATE INDEX ON tbl(fk_cli); -- indeks za strani ključ

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- filtriranje po konkretnoj pari 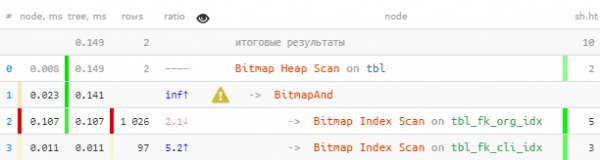
Ispravka:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
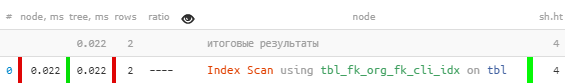
Ovde je dobitak manji, jer je Bitmap Heap Scan već dovoljno efikasan. Ali svejedno 7 puta brže i 2.5 puta manje čitanja.
#3: объединение индексов (BitmapOr)
Kada
Prikaži prvih 20 najstarijih "svojih" ili nenamenskih zahteva za obradu, pri čemu su svoji u prioritetu.
Kako prepoznati
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Preporuke
Koristiti UNION [ALL] za spajanje podupita po svakom od OR-blokova uslova.
Primjer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "faktora"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- sa verovatnoćom 1:16 zapis "niko"
    ELSE (random() * 100)::integer -- 100 različitih stranih ključeva
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- indeks sa "naizgled odgovarajućim" sortiranim

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- svoji
  fk_own IS NULL -- ... ili "niko"
ORDER BY
  pk
, (fk_own = 1) DESC -- prvo "svoji"
LIMIT 20;
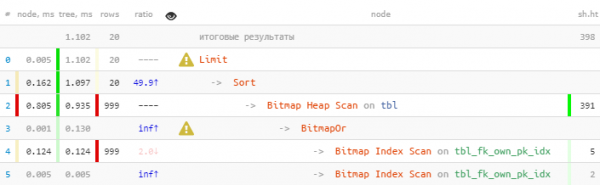
Ispravka:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- prvo "svoji" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- zatim "niko" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- ali ukupno - 20, više nije potrebno 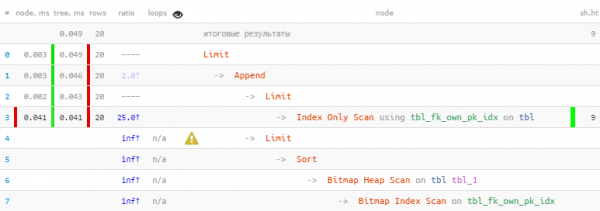
Iskoristili smo to što je svih 20 potrebnih zapisa odmah dobijeno u prvom bloku, pa drugi, sa skupljim Bitmap Heap Scan, čak nije ni izvršen — na kraju 22 puta brže, 44 puta manje čitanja!
Detaljniji opis ovog načina optimizacije na konkretnim primerima može se pročitati u člancima i .
Generalizovana varijanta rezultatskog izbora po više ključeva (a ne samo po paru const/NULL) obrađena je u članku .
#4: читаем много лишнего
Kada
Obično se javlja kada postoji želja da se "dodaje još jedan filter" postojećem upitu.
"A nemate li sličan, ali s bisernim dugmadima?» h/f "Brijantna ruka"
Na primer, modifikujući prethodni zadatak, prikazati prvih 20 najstarijih "kritičnih" zahteva za obradu, bez obzira na njihovu namenu.
Kako prepoznati
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rows 80% pročitanog
   && loops × RRbF > 100 -- i pritom više od 100 zapisa ukupno
Preporuke
Izraditi [više] specijalizirani indeks s WHERE-uvjetom ili uključiti dodatna polja u indeks.
Ako je uvjet filtriranja "statičan" za vaše zadatke — to jest ne očekuje proširenje popisa vrijednosti u budućnosti — bolje je koristiti WHERE-indeks. Ova kategorija dobro obuhvaća različite boolean/enum-status.
Ako uvjet filtriranja može primati različite vrijednosti, bolje je proširiti indeks tim poljima — kao u situaciji s BitmapAnd gore.
Primjer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "faktora"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 različitih vanjskih ključeva
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, da je zahtjev "kritičan"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 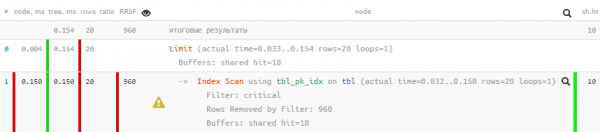
Ispravka:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- dodali smo "statičan" uvjet filtriranja
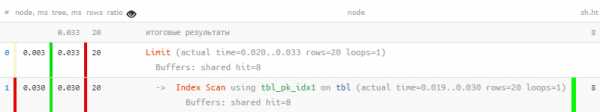
Kao što vidimo, filtracija iz plana potpuno je nestala, a upit je postao 5 puta brži.
#5: разреженная таблица
Kada
Različiti pokušaji izrade vlastitih redova za obradu zadataka, kada veliki broj ažuriranja/brisanja zapisa na tablici dovodi do situacije velikog broja "mrtvih" zapisa.
Kako prepoznati
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Preporuke
Redovito ručno provoditi VACUUM [FULL] ili postići adekvatnu učestalost obrade pomoću fine prilagodbe njegovih parametara, uključujući .
U većini slučajeva takvi problemi nastaju zbog lošeg sastava upita tijekom poziva iz poslovne logike poput onih koje su razmatrane u .
No treba razumjeti da čak ni VACUUM FULL ne može uvijek pomoći. Za takve slučajeve vrijedi proučiti algoritam iz članka .
#6: чтение с «середины» индекса
Kada
Kao da smo malo pročitali, i sve po indeksu, i nikoga viška ne filtrirali — a svejedno je pročitan značajno veći broj stranica nego što bismo htjeli.
Kako prepoznati
-> Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Preporuke
Pažljivo proučite strukturu korištenog indeksa i ključna polja zadana u upitu – najvjerojatnije, dio indeksa nije zadan. Vjerojatno ćete morati stvoriti sličan indeks, ali bez prefiksnih polja ili .
Primjer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "faktora"
, (random() *  100)::integer fk_org  -- 100 različitih vanjskih ključeva
, (random() * 1000)::integer fk_cli; -- 1K različitih vanjskih ključeva

CREATE INDEX ON tbl(fk_org, fk_cli); -- sve gotovo kao u #2
-- samo je odvojeni indeks po fk_cli već suvišan i uklonili smo ga

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- a fk_org nije zadan, iako je ranije bio u indeksu
LIMIT 20; 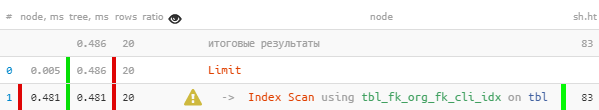
Izgleda da je sve u redu, čak i po indeksu, ali nekako sumnjivo – na svaku od 20 pročitanih zapisa trebali smo očitati 4 stranice podataka, 32KB po zapisu – nije li to previše? A i ime indeksa tbl_fk_org_fk_cli_idx potiče na razmišljanje.
Ispravka:
CREATE INDEX ON tbl(fk_cli); 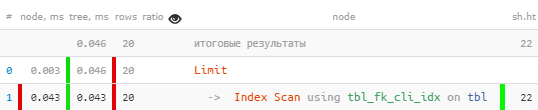
Iznenada – 10 puta brže, i 4 puta manje čitati!
Druge primjere situacija neučinkovitog korištenja indeksa možete vidjeti u članku .
#7: CTE × CTE
Kada
U upitu koristili smo „debeli“ CTE iz različitih tablica, a zatim smo odlučili stvoriti između njih JOIN.
Ovaj slučaj vrijedi za verzije niže od v12 ili upite s WITH MATERIALIZED.
Kako prepoznati
-> CTE Scan
   && petlje > 10
   && petlje × (redovi + RRbF) > 10000
      -- preveliki kartezijski proizvod CTE
Preporuke
Pažljivo analizirajte upit – a ? Если все-таки да, то primjeniti „označavanje“ u hstore/json prema modelu opisanom u .
#8: swap на диск (temp written)
Kada
Jednokratna obrada (sortiranje ili jedinstveno uklanjanje) velikog broja zapisa ne stane u dodijeljenu memoriju za to.
Kako prepoznati
-> *
   && temp written > 0
Preporuke
Ako korištena količina memorije ne prelazi značajno postavljenu vrijednost parametra , vrijedi ga prilagoditi. Možete odmah u konfiguraciji za sve ili putem SET [LOCAL] za određeni upit/transaction.
Primjer:
SHOW work_mem;
-- "16MB"

SELECT
  random()
FROM
  generate_series(1, 1000000)
ORDER BY
1; 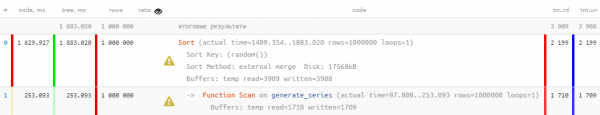
Ispravka:
SET work_mem = '128MB'; -- prije izvođenja upita 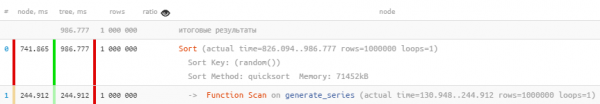
Iz razumljivih razloga, ako se koristi samo memorija, a ne disk, upit će biti izvršen mnogo brže. Ujedno, dio opterećenja s HDD-a također se smanjuje.
Ali treba razumjeti da nećemo uvijek moći dodijeliti puno memorije — nje jednostavno neće biti dovoljno za sve.
#9: неактуальная статистика
Kada
U bazu je odmah uneseno puno podataka, ali nisu imali vremena provesti ANALYZE.
Kako prepoznati
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && omjer >> 10
Preporuke
Ipak, provesti ANALYZE.
Više o ovoj situaciji opisano je u .
#10: «что-то пошло не так»
Kada
Došlo je do čekanja na zaključavanje koje je postavio konkurentski upit ili nije bilo dovoljno hardverskih resursa CPU/hipervizora.
Kako prepoznati
-> *
   && (shared hit / 8K) + (shared read / 1K) < time / 1000
      -- RAM hit = 64MB/s, HDD read = 8MB/s
   && time > 100ms -- malo smo čitali, ali predugo
Preporuke
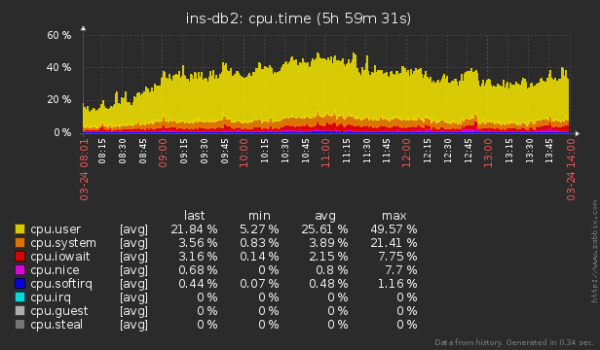
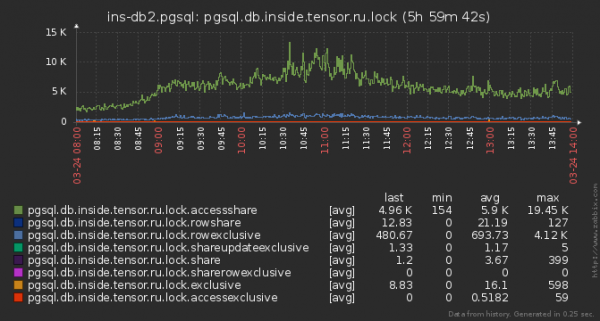
Koristite vanjski sustav za praćenje poslužitelja radi otkrivanja zaključavanja ili nenormalne potrošnje resursa. O našem načinu organizacije ovog procesa za stotine poslužitelja već smo govorili i .
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish