

Uoči početka tečaja pripremili smo za vas prijevod još jednog korisnog materijala.
Huffmanovo kodiranje je algoritam za kompresiju podataka koji formulira osnovnu ideju kompresije datoteka. U ovom članku ćemo govoriti o kodiranju fiksne i promjenjive duljine, jedinstveno dekodiranim kodovima, pravilima prefiksa i izgradnji Huffmanovog stabla.
Znamo da se svaki znak pohranjuje u obliku nizova 0 i 1 i zauzima 8 bita. To se naziva kodiranje fiksne duljine, budući da svaki znak koristi istu fiksnu količinu bitova za pohranu.
Pretpostavimo da imamo tekst. Kako možemo smanjiti količinu prostora potrebnog za pohranu jednog znaka?
Osnovna ideja leži u kodiranju promjenjive duljine. Možemo iskoristiti činjenicu da se neki znakovi u tekstu pojavljuju češće od drugih (), kako bismo razvili algoritam koji će predstavljati isti niz znakova manjim brojem bitova. Pri kodiranju promjenjive duljine dodjeljujemo znakovima promjenjiv broj bitova ovisno o učestalosti njihovog pojavljivanja u danom tekstu. Na kraju, neki znakovi mogu zauzimati samo 1 bit, dok drugi mogu zauzimati 2 bita, 3 ili više. Problem kod kodiranja promjenjive duljine leži samo u kasnijem dekodiranju niza.
Kako, znajući niz bitova, dekodirati ga jednoznačno?
Razmotrimo niz „aabacdab“. Sadrži 8 znakova, a pri kodiranju fiksne duljine za njegovu pohranu bit će potrebna 64 bita. Primijetimo da su učestalosti znakova „a“, „b“, „c“ i „d“ jednaki 4, 2, 1, 1, redom. Pokušajmo predstaviti „aabacdab“ manjim brojem bitova, koristeći činjenicu da „a“ se pojavljuje češće od „b“, već „b“ se pojavljuje češće od „c“ i „d“. Započet ćemo s time da kodiramo „a“ s pomoću jednog bita, koji je 0, „b“ dodijelit ćemo dvobitni kod 11, a pomoću tri bita 100 i 011 kodirat ćemo „c“ i „d“.
Na kraju dobijemo:
a
0
b
11
c
100
d
011
Tako ćemo niz „aabacdab“ kodirati kao 00110100011011 (0|0|11|0|100|011|0|11), koristeći kodove predstavljene iznad. Međutim, osnovni problem bit će u dekodiranju. Kada pokušamo dekodirati niz 00110100011011, dobit ćemo nejasan rezultat, budući da ga možemo predstaviti kao:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
itd.
Da bismo izbjegli ovu dvosmislenost, moramo osigurati da naše kodiranje zadovoljava koncept prefixnog pravila, što podrazumijeva da se šifre mogu dekodirati na samo jedan jedinstven način. Prefixno pravilo osigurava da nijedna šifra ne bude prefiks druge. Pod šifrom podrazumijevamo bitove koji se koriste za predstavljanje određenog simbola. U gornjem primjeru 0 – to je prefiks 011, što krši prefixno pravilo. Dakle, ako naše šifre zadovoljavaju prefixno pravilo, tada se dekodiranje može provesti jednoznačno (i obrnuto).
Pogledajmo ponovo gornji primjer. Ovaj put ćemo dodijeliti simbolima „a“, „b“, „c“ i „d“ šifre koje zadovoljavaju prefixno pravilo.
a
0
b
10
c
110
d
111
Korištenjem takvog kodiranja, niz „aabacdab“ će biti kodiran kao 00100100011010 (0|0|10|0|100|011|0|10). A ovdje 00100100011010 već ćemo moći jednoznačno dekodirati i vratiti se našoj izvornoj nizu „aabacdab“.
Huffmanovo kodiranje
Sada kada smo razjasnili kodiranje varijabilne dužine i prefixno pravilo, pričajmo o Huffmanovom kodiranju.
Metoda se temelji na stvaranju binarnih stabala. U njoj može biti ili završni ili unutarnji čvor. Isprva se svi čvorovi smatraju listovima (završnima), koji predstavljaju sam simbol i njegovu težinu (tj. učestalost pojavljivanja). Unutarnji čvorovi sadrže težinu simbola i upućuju na dva nasljedna čvora. Prema općem dogovoru, bit "0" predstavlja prolaz lijevom granom, a "1" – desnom. U potpunom stablu N listova i N-1 unutarnjih čvorova. Preporučuje se da se prilikom izrade Huffmanovog stabla odbace neiskorišteni simboli kako bi se dobili kodovi optimalne duljine.
Koristit ćemo red s prioritetima za izradu Huffmanovog stabla, gdje čvor s najmanjom učestalošću dobiva najviši prioritet. U nastavku su opisani koraci izrade:
- Kreirajte čvor-list za svaki simbol i dodajte ih u red s prioritetima.
- Dok u redu ima više od jednog lista, radimo sljedeće:
- Uklonite dva čvora s najvišim prioritetom (najmanja učestalost) iz reda;
- Kreirajte novi unutarnji čvor, gdje će ta dva čvora biti nasljednici, a učestalost pojavljivanja bit će jednaka zbiru učestalosti ta dva čvora.
- Dodajte novi čvor u red s prioritetima.
- Jedini preostali čvor bit će korijenski, na tome će se završiti izgradnja stabla.
Zamislimo da imamo neki tekst koji se sastoji samo od znakova „a“, „b“, „c“, „d“ i „e“, a učestalosti njihovog pojavljivanja su jednake 15, 7, 6, 6 i 5 respektivno. Ispod su ilustracije koje prikazuju korake algoritma.
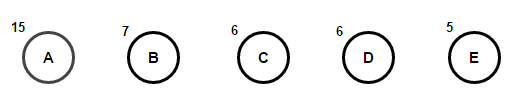
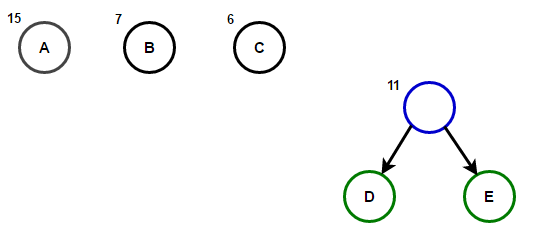
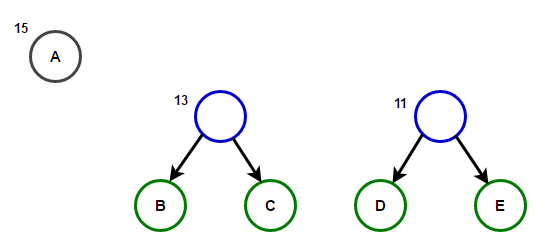
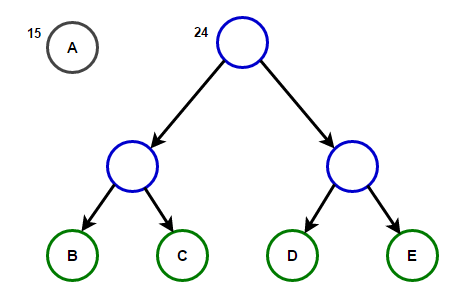
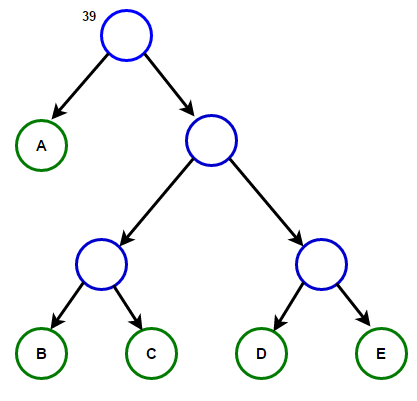
Put od korijena do bilo kojeg završnog čvora će pohranjivati optimalni prefiksni kod (također poznat kao Huffmanov kod), koji odgovara znaku povezanom s tim završnim čvorom.
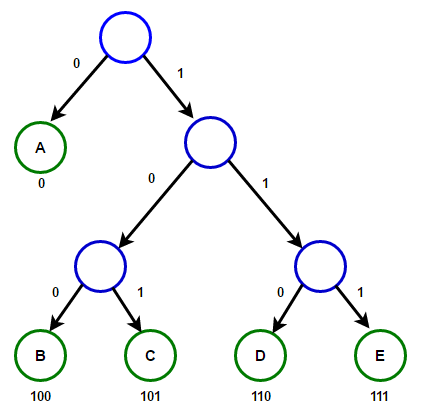
Huffmanovo stablo
Ispod ćete naći implementaciju Huffmanovog algoritma kompresije na jezicima C++ i Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Čvor stabla
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// prolaz kroz Huffman stablo i pohrana Huffman kodova
// u mapu.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// pronađen list čvor
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// prolaz kroz Huffman stablo i dekodiranje kodiranog niza
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// pronađen list čvor
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Gradi Huffman stablo i Huffman kod i dekodira zadani ulazni tekst
public static void buildHuffmanTree(String text)
{
// prebrojava učestalost pojavljivanja svakog znaka
// i pohranjuje je u mapu
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Kreira prioritetnu prijenosnu red da pohrani žive čvorove Huffman stabla
// Primijetite da stavka s najvišim prioritetom ima najnižu učestalost
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Kreira list čvor za svaki znak i dodaje ga
// prioritetnoj redu.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// radi dok u redu ne bude više od jednog čvora
while (pq.size() != 1)
{
// Uklanja dva čvora najvišeg prioriteta
// (najniže učestalosti) iz reda
Node left = pq.poll();
Node right = pq.poll();
// Kreira novu unutrašnju čvor s ova dva čvora kao djecu
// i s učestalosti jednakom zbroju učestalosti dva čvora
// dodaje novi čvor u prioritetnu red.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root pohranjuje pokazivač na korijen Huffman stabla
Node root = pq.peek();
// prolazi kroz Huffman stablo i pohranjuje Huffman kodove u mapu
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// ispisuje Huffman kodove
System.out.println("Huffman kodovi su :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nIzvorni niz je :\n" + text);
// ispisuje kodirani niz
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nKodirani niz je :\n" + sb);
// prolazi kroz Huffman stablo ponovo i ovoga puta
// dekodira kodirani niz
int index = -1;
System.out.println("\nDekodirani niz je: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Huffman kodiranje je algoritam za kompresiju podataka.";
buildHuffmanTree(text);
}
}Napomena: Memorija koju koristi ulazni niz je 47 * 8 = 376 bita, dok kodirani niz zauzima samo 194 bita, što znači da su podaci komprimirani otprilike 48%. U C++ programu iznad koristimo klasu string za pohranu kodiranog niza kako bismo učinili program čitljivim.
Budući da učinkovite strukture podataka redova prioriteta zahtijevaju O(log(N)) vrijeme za umetanje, a u potpuno binarnom stablu s N listovima ima 2N-1 čvorova, a Huffmanovo stablo je potpuno binarno stablo, algoritam radi za O(Nlog(N)) vrijeme, gdje N je broj simbola.
Izvori:
Izvor: habr.com
