

Predlažem da se upoznate s transkriptom izlaganja Nikolaja Samohvalova "Industrijski pristup tuning-u PostgreSQL: eksperimenti s bazama podataka"
Shared_buffers = 25% – je li to mnogo ili malo? Ili taman kako treba? Kako shvatiti je li ova – prilično zastarjela – preporuka prikladna za vaš konkretan slučaj?
Došlo je vrijeme da se ozbiljno suočimo s pitanjem odabira parametara postgresql.conf "kako spada". Ne putem slijepih "autotuner-a" ili zastarjelih savjeta iz članaka i blogova, već na temelju:
- strogo provedenih eksperimenata na bazama podataka, provedenih automatizirano, u velikim količinama i u uvjetima što bliže "borbenim",
- dubokog razumijevanja karakteristika rada SGBD-a i OS-a.
Koristeći Nancy CLI (), razmotrit ćemo konkretan primjer – poznate shared_buffers – u raznim situacijama, u raznim projektima i pokušati shvatiti kako odabrati optimalnu postavku za našu infrastrukturu, bazu podataka i opterećenje.
Riječ je o eksperimentima s bazama podataka. Ovo je priča koja traje nešto više od šest mjeseci.
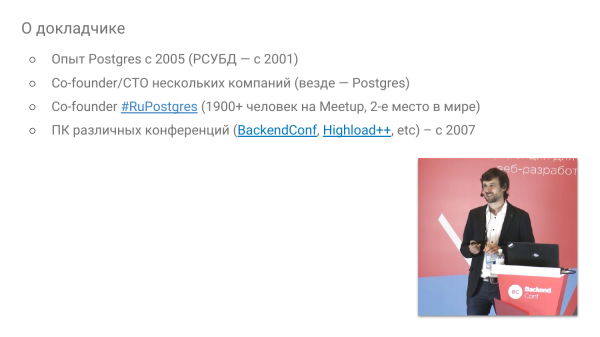
Malo o meni. Iskustvo s Postgresom traje više od 14 godina. Osnovao sam nekoliko kompanija koje se bave društvenim mrežama. Svuda je korišten Postgres i koristi se.
Također, grupa RuPostgres na Meetupu, 2. mjesto u svijetu. Polako se približavamo brojci od 2 000 članova. RuPostgres.org.
Na brojnim konferencijama, uključujući Highload, zadužen sam za baze podataka, posebno Postgres, od samog početka.
I posljednjih nekoliko godina ponovo sam pokrenuo svoju praksu vezanu uz Postgres konzultacije u 11 vremenskih zona odavde.
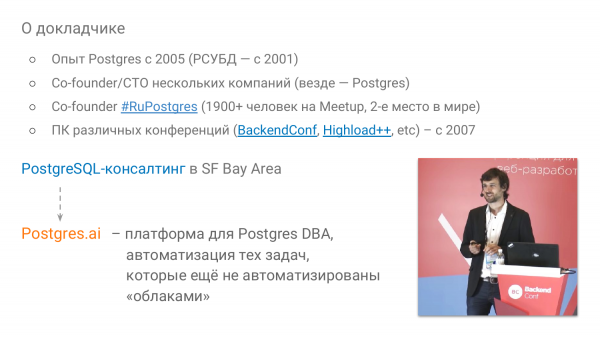
Kad sam to učinio prije nekoliko godina, imao sam određeni prekid aktivnog rada s Postgresom, vjerojatno od 2010. godine. Bio sam iznenađen koliko se malo promijenilo u svakodnevnom radu DBA, koliko je i dalje potrebno ручnog rada. Odmah sam pomislio da tu nešto nije u redu, da treba automatizirati više stvari.
I budući da je sve to bilo u udaljenosti, većina klijenata bila je u oblaku. I već je mnogo automatizirano, to je očigledno. O tome malo kasnije. Dakle, sve ovo je dovelo do ideje da bi trebao postojati niz alata, tj. neka platforma koja bi automatizirala gotovo sve radnje DBA, kako bi se moglo upravljati velikim brojem baza.
U ovom izlaganju neće biti:
- „Srebrnih metaka“ i izjava poput – stavite 8 GB ili 25 % shared_buffers i bit ćete zadovoljni. O shared_buffers-u neće biti previše riječi.
- Hardverski „unutarnji“ dijelovi.
Što će se dogoditi?
- Bit će principa optimizacije koje primjenjujemo i razvijamo. Bit će različitih ideja koje nam padaju na pamet na putu i raznih alata koje većinom stvaramo u Open Source-u, tj. osnovu radimo u Open Source-u. Štoviše, imamo tikete, gotovo sva komunikacija je u Open Source-u. Možete pratiti što radimo, što će biti u sljedećem izdanju itd.
- Bit će i nekih iskustava korištenja tih principa, tih alata u nizu tvrtki: od malih startupa do velikih poduzeća.
Kako se sve to razvija?
Prvo, osnovni zadatak DBA-a, osim osiguravanja stvaranja instanci, postavljanja sigurnosnih kopija itd., je traženje uskih grla i optimizacija performansi.
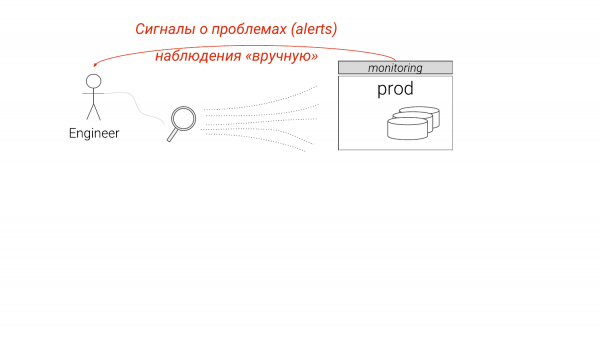
Trenutno je to organizirano na sljedeći način. Gledamo monitoring, vidimo nešto, nedostaje nam nekih detalja. Počinje detaljnije istraživanje, obično rukama, i shvaćamo što učiniti s tim.
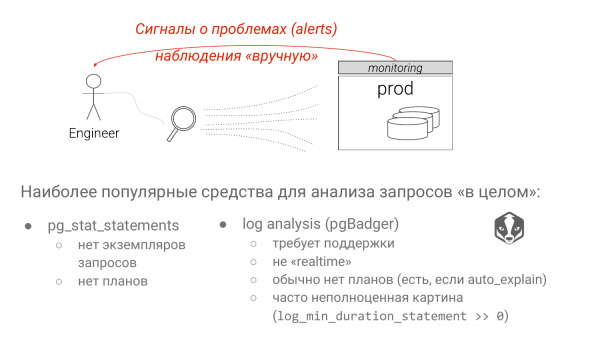
Postoje dva pristupa. Pg_stat_statements - standardno rješenje za otkrivanje sporih upita. I analiza logova Postgres-a uz pomoć pgBadger-a.
Svaki od pristupa ima ozbiljne nedostatke. Prvi pristup eliminira sve parametre. Ako vidimo grupe SELECT * FROM table where kolona je jednaka znaku „?“ ili „$“ počevši od verzije Postgres 10. Ne znamo - je li to index scan ili seq scan. Uvelike ovisi o parametru. Ako tamo stavite rijetko pojavljivanu vrijednost, bit će index scan. Ako stavite vrijednost koja čini 90% tablice, bit će seq scan očito, jer Postgres poznaje statistiku. I to je velika mana pg_stat_statements, premda se rade neki radovi.
Najveća mana analiza logova je ta što si obično ne možete priuštiti „log_min_duration_statement = 0“. O tome ćemo također razgovarati. Prema tome, ne vidite cijelu sliku. I neki upit koji je vrlo brz, može trošiti ogromnu količinu resursa, ali ga nećete vidjeti, jer je ispod vašeg praga.
Kako DBA rješavaju pronađene probleme?
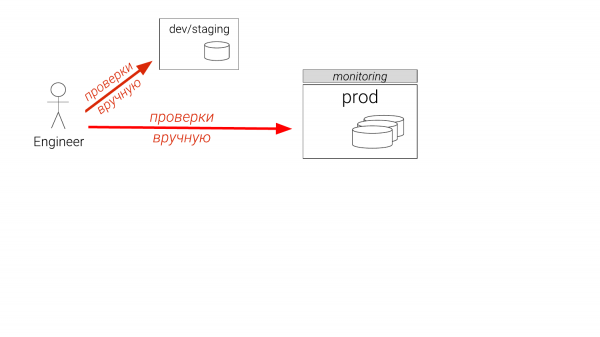
Na primjer, otkrili smo neku problematiku. Što se obično radi? Ako ste programer, radit ćete nešto na nekom instance koji nije te veličine. Ako ste DBA, imate staging. A on može biti samo jedan. I on kasni pola godine. I mislite da idete u produkciju. I čak i iskusni DBA provjeravaju kasnije u produkciji, na replici. Ponekad kreiraju privremeni indeks, uvjeravaju se da pomaže, brišu ga i predaju programerima da ga uključe u migracijske datoteke. Takve gluposti se sada događaju. I to je problem.
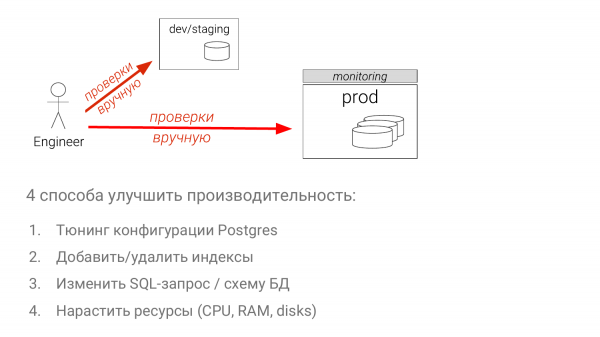
- Tuning konfiguracija.
- Optimizacija skupa indeksa.
- Promjena samog SQL upita (to je najteži način).
- Dodavanje resursa (najlakši način u većini slučajeva).
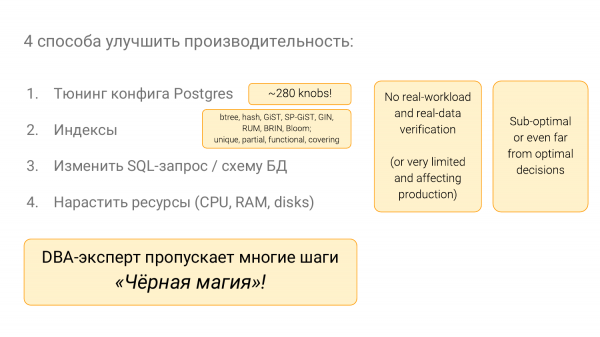
Ima tu puno stvari. Postoji puno opcija u Postgresu. Treba puno znati. Mnogo indeksa u Postgresu, zahvaljujući, između ostalog, organizatorima ove konferencije. Sve to treba znati, i to upravo izaziva osjećaj kod ne DBA da se DBA bave crnom magijom. To jest, potrebno je deset godina rada da biste sve to počeli normalno razumjeti.
A ja sam borac protiv te crne magije. Želim sve postaviti tako da imamo tehnologiju, a ne intuiciju u svemu tome.
Primjeri iz života
To sam primijetio najmanje na dva projekta, uključujući i svoj. Još jedan post na blogu javlja nam da je vrijednost 1 000 za default_statistict_target dobra. Dobro, hajde da probamo u produkciji.
I tu smo, koristeći naš alat dvije godine kasnije uz pomoć eksperimenata s bazama podataka o kojima se danas radi, možemo usporediti što je bilo i što je postalo.
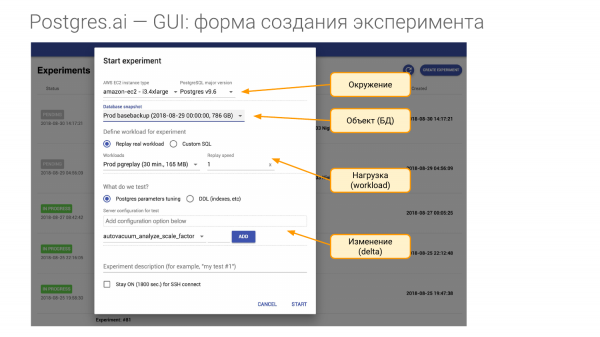
I za to trebamo stvoriti eksperiment. Sastoji se od četiri dijela.
- Prvi dio – okruženje. Trebaju nam hardverski resursi. Kada dolazim u neku kompaniju i zaključujem ugovor, kažem da mi daju isti hardver kakav je u produkciji. Za svakog od vaših majstora mi treba barem jedan takav hardver. Bilo to virtualna masina instance na Amazonu ili Googleu, ili mi treba identičan hardver. To jest, želim reprodukovati okruženje. U pojam okruženje uključujemo glavnu verziju Postgresa.
- Drugi dio – objekat našeg istraživanja. To je baza podataka. Može se stvoriti na nekoliko načina. Pokazat ću kako.
- Treći dio – opterećenje. To je najteži trenutak.
- A četvrti dio je ono što provjeravamo, tj. s čim ćemo uspoređivati. Recimo, možemo promijeniti jedan ili više parametara u konfiguraciji, ili možemo stvoriti indeks i sl.
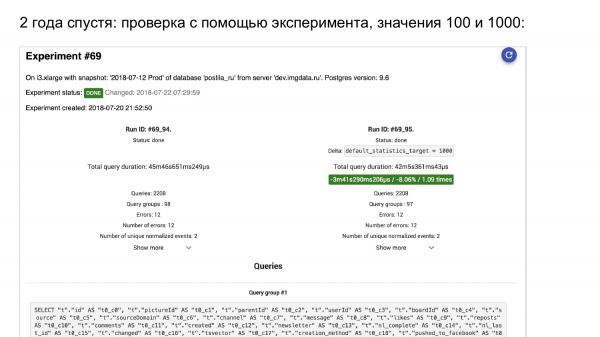
Pokrećemo eksperiment. Evo pg_stat_statements. Lijevo – ono što je bilo. Desno – što je postalo.
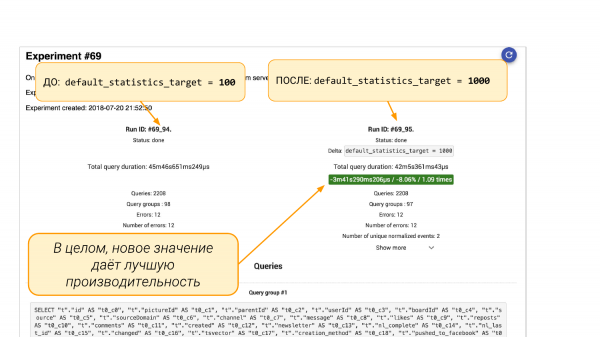
Lijevo default_statistics_target = 100, desno = 1 000. Vidimo da nam to pomaže. Sveukupno poboljšanje od 8%.
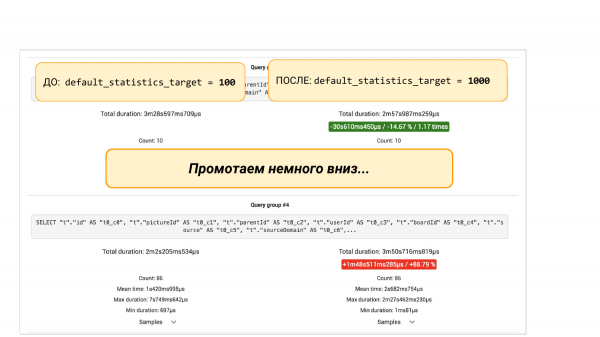
No, ako se spustimo dolje, vidjet ćemo grupe upita iz pgBadger ili iz pg_stat_statements. Tu imamo dvije opcije. Vidjet ćemo da je neki upit pao za 88%. I tu već dolazi inženjerski pristup. Možemo nastaviti s istraživanjem unutra, jer nas zanima zašto je pao. Moramo razumjeti što je bilo sa statistikama. Zašto više košara u statistikama dovodi do lošijih rezultata.
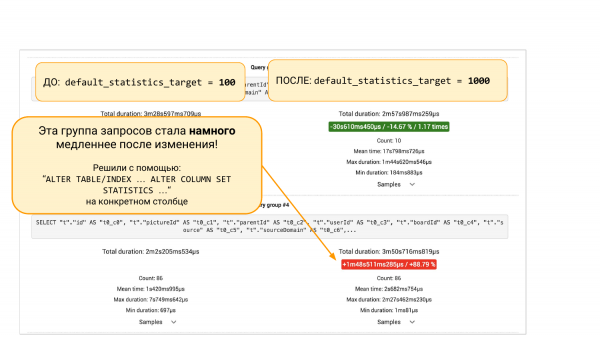
Možemo ne istraživati i napraviti "ALTER TABLE ... ALTER COLUMN" i vratiti mu natrag 100 košara u statistiku te kolone. I zatim, još jednim eksperimentom, možemo se uvjeriti da je ova ispravka pomogla. To je to. Ovo je inženjerski pristup koji nam pomaže vidjeti sliku i donositi odluke na temelju podataka, a ne na temelju intuicije.
Par primjera iz drugih područja. U testovima imamo CI testove već dugi niz godina. I nijedan projekt u zdravom razumu ne može postojati bez automatiziranih testova.
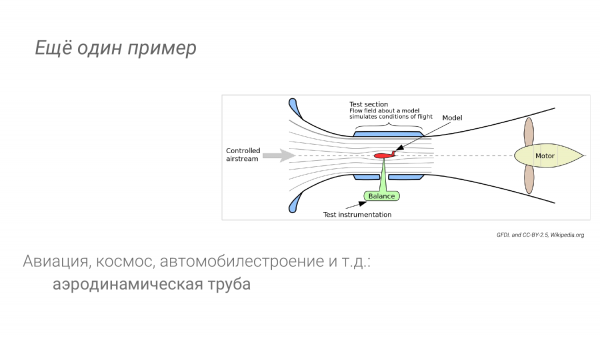
U drugim industrijama: u avijaciji, u automobilskoj industriji, kada testiramo aerodinamiku, također imamo mogućnost provoditi eksperimente. Nećemo odmah lansirati nešto iz crteža u svemir niti ćemo odmah staviti neki automobil na cestu. Na primjer, imamo aerodinamičku cijev.
Iz promatranja drugih industrija možemo donijeti zaključke.
Prvo, imamo posebno okruženje. Ono je blizu produkciji, ali nije isto. Njegova glavna karakteristika je ta da mora biti jeftino, ponovljivo i maksimalno automatizirano. Također, trebaju biti posebna sredstva za provođenje detaljne analize.
Vjerojatno imamo manje mogućnosti proučavati svaki milimetar površine krila kada avion leti nego što to možemo učiniti u aerodinamičkoj tunelu. Imamo više sredstava za dijagnostiku. Možemo si priuštiti da dodamo više teških stvari koje ne možemo imati na avionu dok je u zraku. Također je i s Postgresom. U nekim slučajevima možemo uključiti potpuno logiranje zahtjeva tijekom eksperimentiranja. I to ne želimo raditi na produkciji. Možda bismo to čak uključili s planovima pomoću auto_explain.
I kao što sam već spomenuo, visoka razina automatizacije znači da smo pritisnuli gumb i ponovili. Tako bi to trebalo biti, da imamo mnogo eksperimenata, da to bude u toku.
Nancy CLI – temelj "laboratorija baza podataka"
I evo, napravili smo takvu stvar. Odnosno, o tim idejama sam govorio u lipnju, gotovo prije godinu dana. Već imamo u otvorenom kodu takozvanu Nancy CLI. To je temelj za izgradnju laboratorija baza podataka.
— To je u otvorenom kodu, na Gitlabu. Možete reći, možete probati. Ostavio sam link u slajdovima. Možete kliknuti na njega i tamo će biti o svim parametrima.
Naravno, mnogo toga je još u fazi razvoja. Ima mnogo ideja. No, to je već ono što svakodnevno primjenjujemo. Kada imamo ideju – a što se događa kada brišemo 40 000 000 redaka, sve se zaustavlja na IO, možemo provesti eksperiment i bolje proučiti, kako bismo razumjeli što se događa i pokušali to ispraviti usput. Odnosno, provodimo eksperiment. Na primjer, nešto podešavamo i gledamo što na kraju dobivamo. A to ne radimo na produkciji. To je srž ideje.
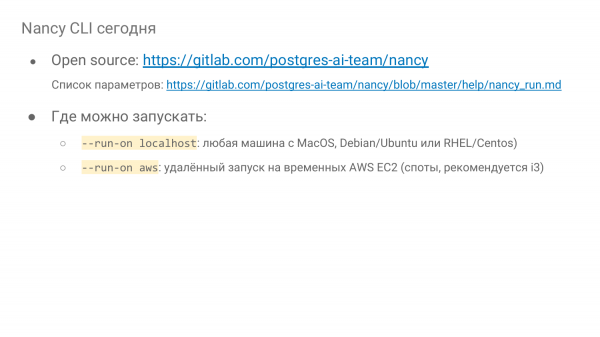
Gdje to može raditi? Može raditi lokalno, tj. može se to raditi bilo gdje, možete čak pokrenuti na MacBooku. Treba vam Docker, idemo. I to je to. Može se pokrenuti u nekom instance na hardveru, ili u virtualkoj mašini, bilo gdje.
Postoji i mogućnost pokretanja na daljinu u Amazonu putem EC2 Instance, na spot cijene. To je zaista sjajna prilika. Na primjer, jučer smo proveli više od 500 eksperimenata na i3 instanci, počevši od najmanje do i3-16-xlarge. I tih 500 eksperimenata nas je koštalo 64 dolara. Svaki je trajao 15 minuta. To znači da, zahvaljujući spot cijenama, to je vrlo jeftino – 70% popusta, plaćanje po sekundi kao kod Amazona. Možete raditi zaista puno. Možete provoditi stvarna istraživanja.
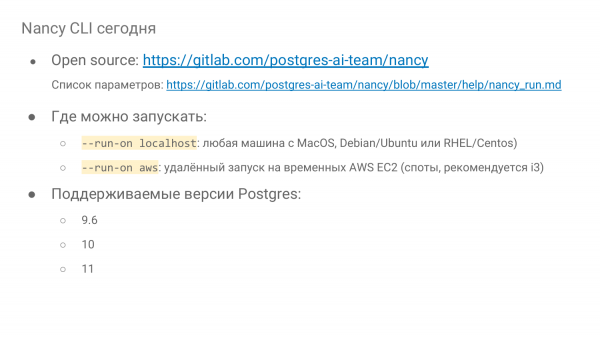
Podržane su tri glavne verzije Postgresa. Nije toliko teško doraditi neke stare, a i nova 12. verzija također.
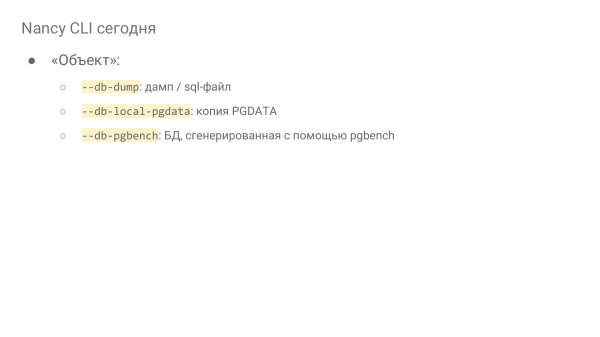
Objekt možemo definirati na tri načina. To su:
- Dump/sql datoteka.
- Glavni način je kloniranje PGDATA direktorija. Obično se uzima iz backup servera. Ako imate normalne binarne backupove, odande možete raditi klonove. Ako imate oblake, tada će vam to oblak kompanija poput Amazona ili Googlea raditi automatski. Ovo je najvažniji način za klonove stvarne produkcije. Na taj način ga razvijamo.
- A zadnji način je prikladan za istraživanje, kada želite pronaći kako u Postgresu nešto funkcionira. To je pgbench. Možete generirati s pomoću pgbencha. To je samo jedna opcija „db-pgbench“. Kažete mu koji je scale. I sve će biti generirano u oblaku, kako je navedeno.
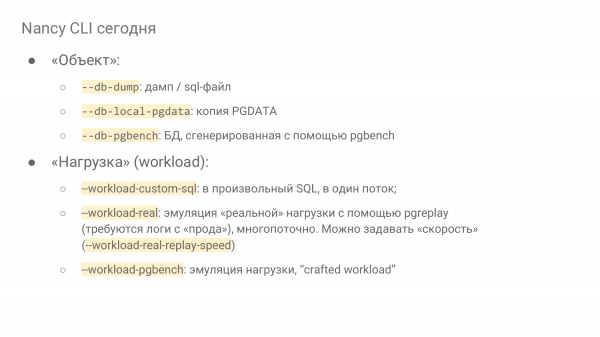
I opterećenje:
- Opterećenje možemo izvršavati u jednom SQL toku. To je najprimitivniji način.
- A možemo emulirati opterećenje. I emulirati ga možemo prvenstveno na sljedeći način. Moramo prikupiti sve logove. I to je bolno. Pokazat ću vam zašto. I s pomoću pgreplaya, koji je ugrađen u Nancy, reproduciramo.
- Ili druga opcija. Takozvano 'craft' opterećenje, koje radimo s određenom količinom truda. Analizirajući naše trenutno opterećenje na bojnoj stanici, izvučemo najbolje grupe upita. I s pomoću pgbencha možemo emulirati to opterećenje u laboratoriju.
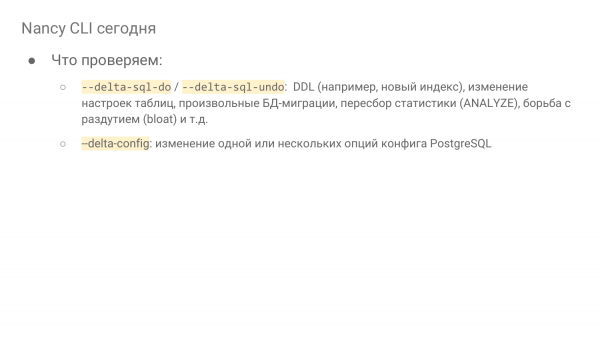
- Ili trebamo izvršiti neki SQL, tj. provjeravamo migraciju, stvaramo indeks, izvršavamo ANALAZE. I gledamo što je bilo prije vakuuma i nakon vakuuma. Ukratko, bilo koji SQL.
- Ili u konfiguraciji mijenjamo jednu ili više postavki. Možemo zatražiti da provjere, na primjer, 100 vrijednosti na Amazonu za naš terabajtni bazu. I za nekoliko sati imate rezultat. Kao pravilo, terabajtna baza će vam se razvijati nekoliko sati. No, u razvoju imamo zakrpu, moguće je serijsko korištenje, tj. možete kontinuirano koristiti istu pgdata na istom serveru i provjeravati. Postgres će se restartati, predmemorije će se brisati. I možete provoditi opterećenje.
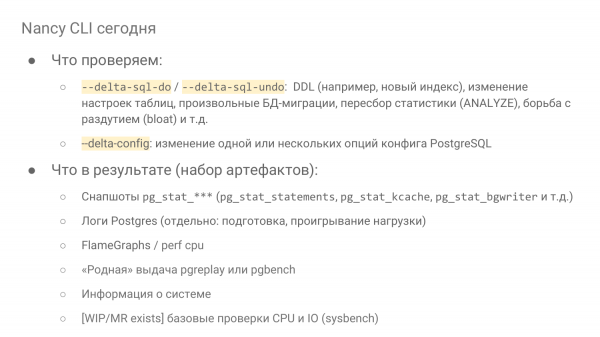
- Dolazi direktorij s brojnim datotekama, počevši od snimaka pg.stat***. A tu je najzanimljivije – pg_stat_statements, pg_stat_kcacke. To su dvije ekstenzije koje analiziraju upite. A pg_stat_bgwriter sadrži ne samo statistiku pgwriter-a, već i podatke o checkpoint-u i o tome kako sami backend-i istiskuju prljave baferi. I sve to je zanimljivo pogledati. Na primjer, kada podešavamo shared_buffers, vrlo je zanimljivo pogledati koliko je tko istisnuo.
- Također dolaze Postgres logovi. Dva loga – log pripreme i log reproduciranja opterećenja.
- Relativno nova funkcija – to su FlameGraphs.
- Također, ako ste koristili pgreplay ili pgbench opcije reproduciranja opterećenja, imate njihov izvorni prikaz. I vidjet ćete latenciju i TPS. Možete razumjeti kako su to vidjeli.
- Informacije o sustavu.
- Osnovne provjere CPU-a i IO-a. To je više za EC2 instance na Amazonu, kada želite pokrenuti 100 identičnih instanci u toku i izvesti po 100 različitih proba, onda imate 10.000 experimenata. I morate se uvjeriti da vam nije ispao loš instanca, koji je već nekoga potisnuo. Na toj opremi se drugi aktiviraju i ostaje vam malo resursa. Takve rezultate je bolje odbaciti. I baš uz pomoć sysbench-a od Alekseja Kopytova radimo nekoliko kratkih provjera koje dolaze i možete ih usporediti s drugima, tj. shvatit ćete kako se CPU ponaša i kako se IO ponaša.
Koje su tehničke složenosti na primjeru različitih kompanija?
Recimo, želimo ponavljati stvarno opterećenje uz pomoć logova. Izvrsna ideja, ako je to napisano na Open Source pgreplay-u. Koristimo ga. No, da bi dobro radio, morate uključiti potpuno logiranje upita s parametrima i vremenom.
Postoje određene poteškoće s duration i timestamp. Ovu temu ćemo potpuno izostaviti. Glavno pitanje je – možete li si to priuštiti ili ne?
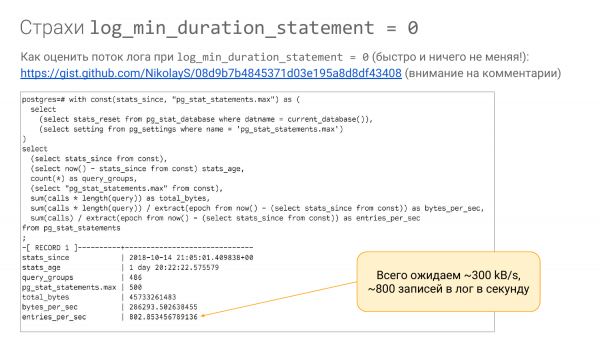
Problem je u tome što to možda neće biti dostupno. Prvo morate razumjeti koji će se tok zapisivati u log. Ako imate pg_stat_statements, možete s ovakvim upitom (link će biti dostupan u slajdovima) shvatiti koliko otprilike bajtova će se zapisivati u sekundi.
Gledamo na dužinu upita. Previđamo činjenicu da nema parametara, ali znamo dužinu upita i koliko puta se izvršavao u sekundi. Tako možemo procijeniti koliko približno bajtova u sekundi. Možda ćemo pogriješiti nekih dva puta, ali redoslijed ćemo sigurno razumjeti na ovaj način.
Možemo vidjeti da se ovaj upit izvršava 802 puta u sekundi. I vidimo da će se bytes_per sec – 300 kB/s zapisivati plus minus. I, obično, takav tok si možemo priuštiti.
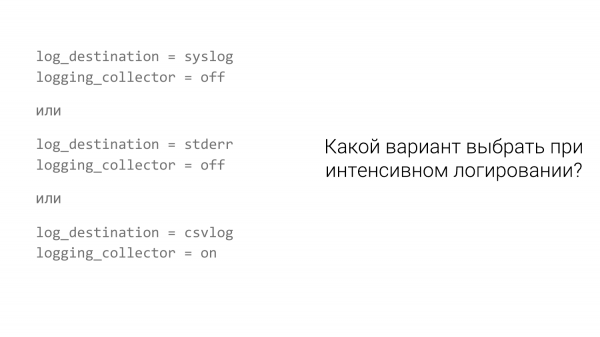
Ali! Postoje različiti sustavi za logiranje. I po defaultu, obično ljudi imaju 'syslog'.
I ako imate syslog, može izgledati ovako. Uzet ćemo pgbench, uključiti logiranje upita i vidjeti što se događa.
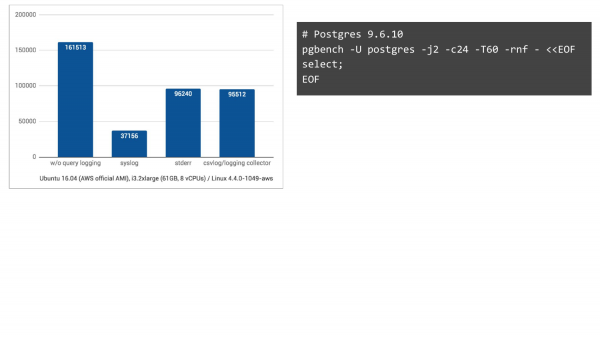
Bez logiranja – to je lijevi stupac. Imali smo 161 000 TPS. Sa syslog – na Ubuntu 16.04 na Amazonu dobijamo 37 000 TPS. A ako promijenimo na druge dva načina logiranja, situacija je daleko bolja. To jest, očekivali smo pad, ali ne toliko.
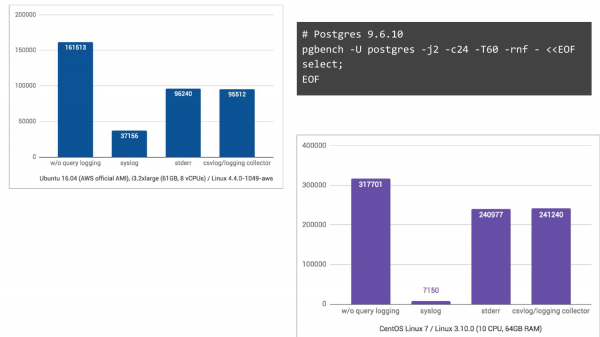
A na CentOS 7, gdje journald sudjeluje, pretvarajući logove u binarni format za lakše pretraživanje itd., situacija je užasna, doživljavamo 44 puta pada u TPS.
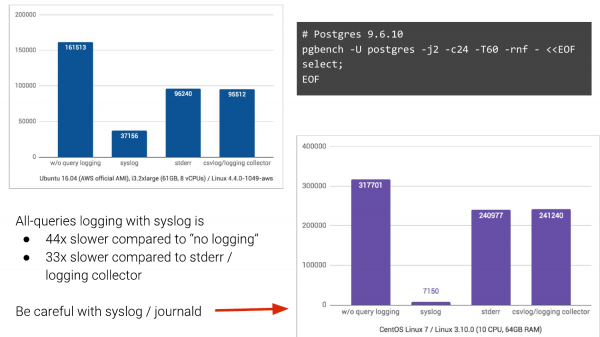
I to je ono s čime se ljudi suočavaju. A često u kompanijama, osobito u velikima, to je vrlo teško promijeniti. Ako možete otići od syslog, slobodno to učinite.
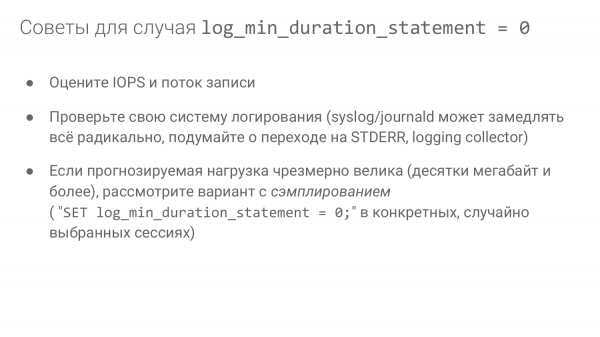
- Procijenite IOPS i zapisni tok.
- Provjerite svoj sustav logiranja.
- Ako je predviđeno opterećenje preveliko, razmislite o mogućnosti uzorkovanja.
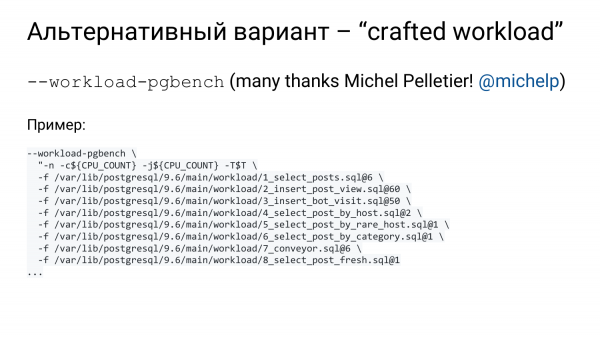
Imamo pg_stat_statements. Kao što sam rekao, on mora biti uključen. I možemo uzeti i svaku grupu upita posebno opisati u datoteci. Zatim možemo iskoristiti vrlo korisnu funkciju u pgbench – mogućnost učitavanja više datoteka uz pomoć opcije '-f'.
On razumije mnogo „-f“. I može se reći s pomoću „@“ na kraju, koja bi kvota trebala biti za svaku datoteku. Odnosno, možemo reći da ovo izvršava u 10% slučajeva, a ono u 20%. I to će nas približiti onome što vidimo na produkciji.
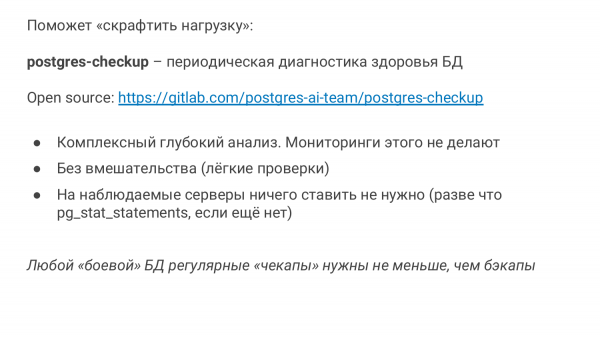
A kako ćemo znati što imamo na produkciji? Koja je kvota i čega kako? Ovdje malo odlazimo u stranu. Imamo još jedan proizvod. . Također baza u Open Source. I trenutno ga aktivno razvijamo.
Rođen je iz malo drugih razloga. Razloga da monitore nije dovoljno. Odnosno, dolazite, gledate bazu, gledate probleme koji postoje. I, obično, radite health_check. Ako ste iskusni DBA, tada radite health_check. Pogledali ste korištenje indeksa itd. Ako imate OKmeter, odlično. To je sjajan monitoring za Postgres. OKmeter.io – molimo, instalirajte ga, sve je jako dobro napravljeno. Plaćen je.
Ako ga nemate, obično imate vrlo malo. U monitoringu su obično dostupni CPU, IO i to sa ograničenjima, i sve. A nama treba više. Trebamo vidjeti kako radi avakovum, kako radi checkpoint, u io trebamo odvojiti checkpoint od bgwriter i od backendova itd.
Problem je u tome što, kada pomažete nekome velikom poduzeću, oni ne mogu brzo implementirati nešto. Ne mogu brzo kupiti OKmeter. Možda će ga kupiti za pola godine. Ne mogu brzo instalirati neke pakete.
I došli smo na ideju da nam treba poseban alat koji ne zahtijeva nikakvu instalaciju, tj. ne trebate ništa postavljati na produkciji. Instalirate ga na svoj laptop, ili na poslužitelj za promatranje, s kojeg ćete ga pokretati. I on će analizirati mnogo toga: i operativni sustav, i datotečni sustav, i sam Postgres, radeći neke lagane upite koje možete provoditi izravno na produkciji i ništa neće pasti.
Nazvali smo ga Postgres-checkup. Ako govorimo medicinski, to je redovita provjera zdravlja. Ako govorimo o automobilima, to je kao redovni servis. Redovni servis radite za auto svake pola godine ili godine, ovisno o marki. A radite li redovni servis za svoju bazu? Odnosno, radite li temeljito istraživanje redovito? Treba to raditi. Ako radite backup, radite i checkup, to nije manje važno.
I imamo takav alat. Počeo se aktivno razvijati tek prije tri mjeseca. Još je mlad, ali ima mnogo toga.
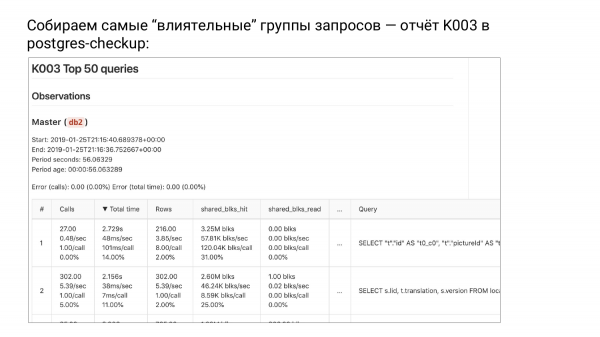
Prikupljamo najsnažnije grupe upita – izvješće K003 u Postgres-checkupu
I tamo postoji grupa izvješća K. Trenutno imamo tri izvješća. I postoji to izvješće K003. Tamo je vrh od pg_stat_statements, sortiran po total_time.
Kada sortiramo grupe upita prema total_time, vidimo grupu koja najviše opterećuje naš sustav, tj. troši više resursa. Zašto nazivam grupe upita? Zato što smo izbacili parametre. To više nisu upiti, već grupe upita, tj. one su apstraktne.
Ako optimiziramo od vrha prema dnu, olakšavamo naše resurse i odgađamo trenutak kada ćemo morati napraviti nadogradnju. To je vrlo dobar način da uštedimo novac.
Možda to nije najbolji način za brigu o korisnicima, jer možda ne primjećujemo rijetke, ali vrlo nezgodne slučajeve kada je osoba čekala 15 sekundi. U zbiru su to tako rijetki slučajevi da ih ne vidimo, ali se bavimo resursima.
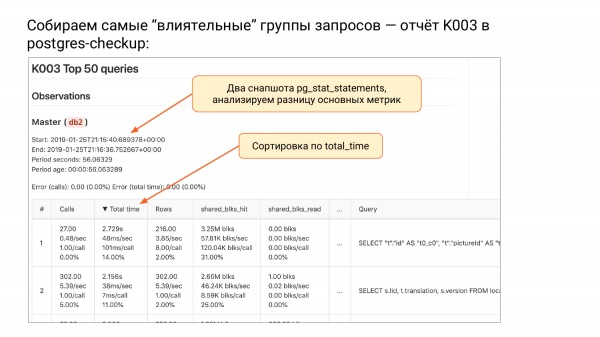
Što se dogodilo u ovoj tablici? Napravili smo dva snimka. Postgres_checkup će vam dati razliku za svaku metrikу: po total-time, calls, rows, shared_blks_read itd. Sve, razlika je izračunata. Veliki problem pg_stat_statements je taj što ne pamti kada je bio resetiran. Dok pg_stat_database pamti, pg_stat_statements ne pamti. Vidite broj 1.000.000, ali ne znamo odakle smo to izračunali.
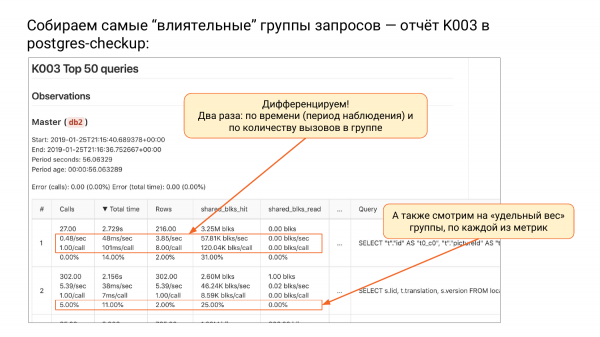
A ovdje znamo, ovdje imamo dva snimka. Znamo da je razlika u ovom slučaju bila 56 sekundi. Vrlo kratak period. Sortirali smo po total_time. I dalje možemo diferencirati, tj. sve metrike dijelimo s duration. Ako svaku metriku podijelimo s duration, dobit ćemo broj poziva u sekundi.
Zatim, total_time po sekundi – to je moja omiljena metrа. Mjeri se u sekundama, po sekundi, tj. koliko je sekundi naš sustav trebalo za izvršenje te grupe upita u sekundi. Ako vidite više od sekunde po sekundi, to znači da vam je potrebno više od jednog jezgra. To je vrlo dobra metrа. Možete shvatiti da tom tipu, na primjer, treba najmanje tri jezgra.
Eto, ovo je naše inovativno rješenje, nešto što nisam nigdje vidio. Obratite pažnju – to je vrlo jednostavna stvar – sekunda po sekundi. Ponekad, kada imate CPU na 100 %, to je pola sata po sekundi, tj. proveli ste pola sata samo na tim upitima.
Dalje, vidimo koliko redaka po sekundi. Znamo koliko je redaka po sekundi vraćeno.
I dalje postoji zanimljiva stvar. Koliko smo shared_buffers pročitali po sekundi iz samog shared_buffers. Hitovi su već bili tu, a redovi su uzeti iz keša operativnog sustava, ili s diska. Prva opcija je brza, dok druga može biti brza, ali i ne mora, ovisno o situaciji.
Drugi način diferencijacije je da dijelimo broj zahtjeva unutar ove grupe. U drugoj koloni uvijek će biti jedan zahtjev podijeljen s drugim zahtjevom. A zatim je zanimljivo – koliko je milisekundi bilo u ovom zahtjevu. Znamo kako se taj zahtjev ponaša u prosjeku. Trebalo je 101 milisekunda za svaki zahtjev. To je tradicionalna metrika koja nam je potrebna za razumijevanje.
Koliko je redaka svaki zahtjev vraćao u prosjeku. Vidimo da prva grupa vraća 8. Koliko prosječno uzeto i pročitano iz keša. Vidimo da je sve odlično keširano. Samo hitovi za prvu grupu.
Četvrta podstavek u svakoj liniji je koliko posto od ukupnog broja. Imamo pozive. Recimo, 1.000.000. I možemo shvatiti koji doprinos ova grupa daje. Vidimo da prva grupa doprinosi manje od 0,01 %. To jest, toliko je spora da je ne vidimo u cjelokupnom slikama. Druga grupa – 5 % po pozivima. To jest, 5 % od svih poziva je druga grupa.
Na total_time također je zanimljivo. Na prvu grupu zahtjeva potrošili smo 14 % ukupnog vremena rada. A na drugu – 11 % i tako dalje.
Neću se previše zadržavati na detaljima, ali postoje finese. Prikazujemo grešku na vrhu, jer kada uspoređujemo, snimci se mogu pomaknut, to jest, neki zahtjevi mogu ispasti i u drugom već ne moraju biti prisutni, dok neki mogu novi nastati. I tu izračunavamo grešku. Ako vidite 0, to je dobro. Nema grešaka. Ako je pokazatelj greške do 20 %, to je u redu.
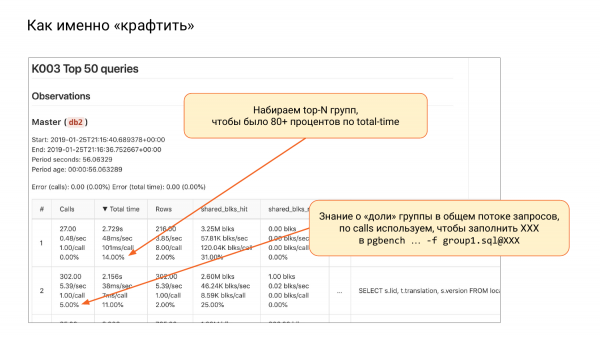
Dalje se vraćamo na našu temu. Moramo izraditi workload. Idemo odozgo prema dolje, dok ne skupimo 80 % ili 90 %. Obično je to 10-20 grupa. I pravimo datoteke za pgbench. Tamo koristimo random. Ponekad, nažalost, to ne uspije. A u Postgres 12 bit će više mogućnosti za korištenje ovog pristupa.
I tako dolazimo do 80-90 % ukupnog vremena. Što staviti nakon «@»? Gledamo na pozive, provjeravamo koliko posto i shvaćamo da ovdje trebamo imati toliko posto. Iz tih postotaka možemo razumjeti kako balansirati svaku od datoteka. Nakon toga koristimo pgbench i krećemo raditi.
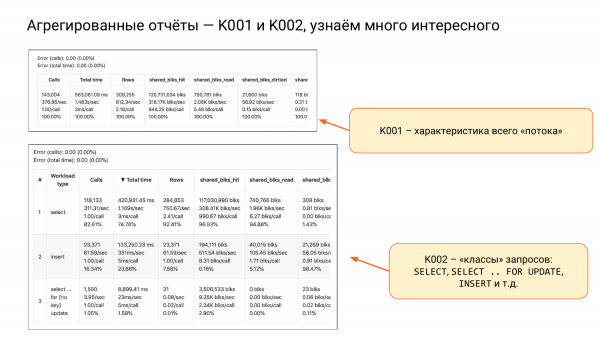
Imamo još K001 i K002.
K001 – to je jedan veliki red s četiri podniza. To je karakteristika cijelog našeg opterećenja. Pogledajte drugu kolumnu i drugi podniz. Vidimo da je to otprilike jedan i pol sekundi po sekundi, tj. ako imamo dva jezgra, bit će dobro. Bit će otprilike 75 % opterećenja. I to će tako raditi. Ako imamo 10 jezgri, bit ćemo potpuno smireni. Tako možemo procijeniti resurse.
K002 – to nazivam klasama upita, tj. SELECT, INSERT, UPDATE, DELETE. I odvojeno SELECT FOR UPDATE, jer on zaključava.
I ovdje možemo zaključiti da su obični čitajući SELECT – 82 % od svih poziva, ali pritom – 74 % ukupnog vremena. To jest, često se pozivaju, ali troše manje resursa.
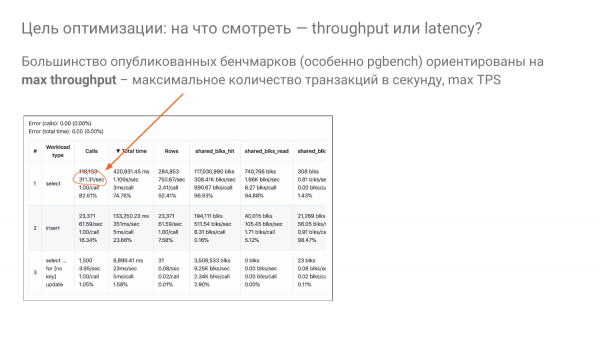
I vraćamo se na pitanje: «Kako pravilno odabrati shared_buffers?». Primijetio sam da se većina benchmarkova gradi na ideji – pogledajmo kakav će biti throughput, tj. kakva će biti propusnost. Obično se mjeri u TPS ili QPS.
I pokušavamo izvući od stroja maksimalan broj transakcija u sekundi kroz parametre tuning-a. Ovdje imamo 311 po sekundi za select.
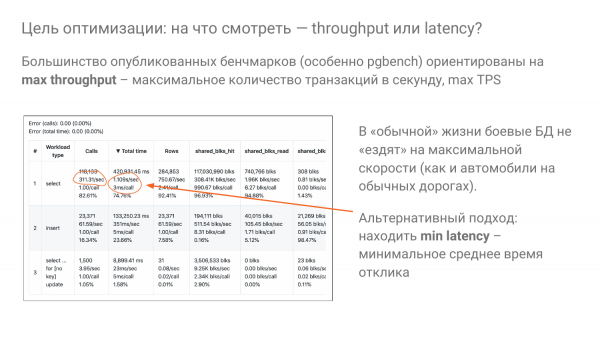
No nitko ne vozi na posao i natrag kući autom na punoj brzini. To je glupo. Tako je i s bazama podataka. Ne bismo trebali voziti na punoj brzini, nitko to i ne radi. Nitko ne živi u produkciji s 100 % CPU. Iako, možda netko i živi, ali to nije dobro.
Ideja je da obično vozimo oko 20 % od mogućnosti, poželjno ne više od 50 %. I trudimo se optimizirati vrijeme odziva za naše korisnike prije svega. To jest, naše ruke treba okretati tako da imamo minimalnu latenciju pri 20 % brzine, uvjetno. To je takva ideja koju također pokušavamo primijeniti u našim eksperimentima.
I na kraju preporuke:
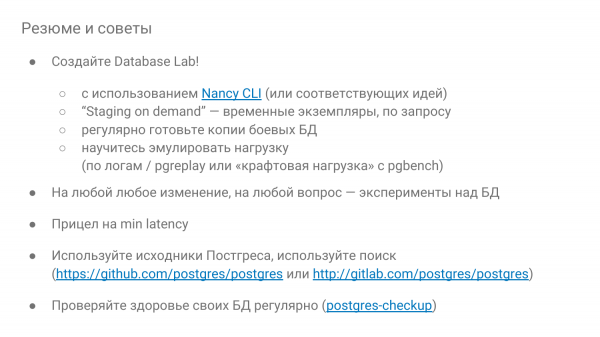
- Obavezno napravite Database Lab.
- Ako je moguće, napravite on demand, tako da se može razviti na neko vrijeme – igrate se i odbacite. Ako imate oblake, to je samo po sebi razumljivo, tj. imajte mnogo standing.
- Budite radoznali. Ako nešto nije u redu, testirajte eksperimentima kako se ponaša. Nancy se može koristiti za vlastito učenje, da provjerite kako baza radi.
- I ciljate na minimalno vrijeme odziva.
- I ne bojte se izvornih kodova Postgres. Kada radite s izvorima, morate znati engleski. Ima puno komentara, sve je objašnjeno.
- I redovito provjeravajte zdravlje baze, barem svaka tri mjeseca ručno ili koristeći Postgres-checkup.
Pitanja
Hvala puno! Vrlo zanimljiva stvar.
Dvije stvari.
Da, dvije stvari. Samo nisam baš shvatio. Kada radimo s Nancy, možemo prilagođavati samo jedan parametar ili cijelu grupu?
Imamo delta-config parametar. Možete odmah prilagođavati koliko god želite. Ali trebate razumjeti, kada mijenjate mnogo stvari, možete donijeti pogrešne zaključke.
Da. Zašto pitam? Zato što je teško provoditi eksperimente kada imate samo jedan parametar. Prilagodite ga, pogledate kako radi. Postavite ga. Onda počinjete s sljedećim.
Možete prilagođavati istovremeno, ali naravno ovisi o situaciji. Ali bolje je provjeriti jednu ideju. Jučer je kod nas nastala ideja. Imali smo vrlo sličnu situaciju. Bilo je dvije konfiguracije. I nismo mogli shvatiti zašto je razlika velika. I pojavila se ideja da koristi dihotomiju kako bismo postupno razumjeli i pronašli u čemu je razlika. Možete odmah učiniti polovicu parametara istima, zatim četvrtinu itd. Sve je fleksibilno.
I još jedno pitanje. Projekt je mlad, razvija se. Je li dokumentacija već spremna, postoji li detaljan opis?
Imao sam namjeru staviti link na opis parametara. To postoji. Ali još uvijek puno toga nema. Tražim istomišljenike. I nalazim ih kada nastupam. To je jako cool. Neki već rade sa mnom, neki su pomogli i nešto napravili. Ako vas zanima ova tema, javite mi – što nedostaje.
Kada napravimo laboratorij, možda će biti povratnih informacija. Vidjet ćemo. Hvala!
Pozdrav! Hvala na prezentaciji! Vidio sam da postoji podrška za Amazon. Planira li se podrška za GSP?
Dobar pitanje. Počeli smo raditi. I trenutno smo stali, jer želimo štedjeti. To jest, postoji podrška putem pokretanja na localhostu. Možete sami kreirati instancu i raditi lokalno. Inače, tako radimo. U Getlabu radim to, tamo na GSP-u. Ali ne vidimo smisao u takvoj orkestraciji, jer Google nema jeftinih spotova. Postoje ??? instance, ali imaju ograničenja. Prvo, uvijek imaju samo 70% popusta i ne možete igrati s cijenom. Spotovi povećavamo cijenu za 5-10% kako bismo smanjili vjerojatnost da vas isključe. To jest, štedite na spotovima, ali vas mogu u bilo kojem trenutku oduzeti. Ako malo povećate cijenu u odnosu na druge, bit ćete eliminirani kasnije. Google ima potpuno drugačiju specifikaciju. I postoji još jedno vrlo loše ograničenje – oni žive samo 24 sata. A ponekad želimo provoditi eksperiment 5 dana. Ali to se može raditi sa spotovima, spotovi ponekad žive mjesecima.
Pozdrav! Hvala na izlaganju! Spomenuli ste checkup. Kako izračunavate greške stat_statements?
Vrlo dobro pitanje. Mogu vrlo detaljno pokazati i ispričati. Ukratko – gledamo kako su se promijenile grupe upita: koliko ih je otpalo i koliko je novih pojavilo. I dalje gledamo dvije metrike: total_time i calls, pa imamo dvije greške. I gledamo koji je doprinos grupa koje su se promijenile. Imaju dvije podgrupe: one koje su otpale i one koje su se pojavile. Gledamo njihov doprinos ukupnoj slici.
Ne bojite li se da će se ponovno pojaviti dva do tri puta između snimanja?
To jest, ponovno su se registrirali ili kako?
Na primjer, taj upit je jednom već bio izbačen, zatim se vratio i ponovno bio izbačen, a zatim se opet vratio i ponovno bio izbačen. I nešto ste ovdje izračunali, gdje je to sve?
Dobar pitanje, potrebno je pogledati.
Radio sam sličnu stvar. Naravno, radio sam to jednostavnije, sam. Ali morao sam resetirati stat_statements i orijentirati se u trenutku snimanja, gdje je bio ispod određene razine, da nije postigao plafon koliko može akumulirati stat_statements. I orijentiram se da, najvjerojatnije, ništa nije izbačeno.
Da-da.
Ali ne razumijem kako to drugačije učiniti pouzdano.
Nažalost, ne sjećam se točno – koristimo li tekst upita ili queryid s pg_stat_statements i na temelju toga se orijentiramo. Ako se orijentiramo na queryid, tada uspoređujemo usporedive stvari.
Ne, može se nekoliko puta zamijeniti između snapshotova i opet se vratiti.
S istim id-om?
Da.
Istražit ćemo to. Dobro pitanje. Trebamo se pozabaviti time. Ali trenutno, ono što vidimo je da imamo ili 0 zapisa...
To je, naravno, rijetka situacija, ali bio sam iznenađen kada sam saznao da stat_statements može zamijeniti nešto.
U Pg_stat_statements može biti mnogo toga. Susreli smo se s tim da ako imate track_utility = on, onda se i setovi prate.
Da, naravno.
I ako imate Java Hibernate, koji je nasumičan, tada počinje zaključavanje hash-tablice. Čim isključite jako opterećenu aplikaciju, imate 50-100 grupica. I sve je tamo više-manje stabilno. Jedan od načina da se to riješi je povećati pg_stat_statements.max.
Da, ali trebate znati koliko. I kako to pratiti. Tako radim. To jest, imam pg_stat_statements.max. I gledam, u trenutku snapshot-a nisam dostigao 70%. Dobro, znači nismo ništa izgubili. Radimo reset. I ponovo skupljamo. Ako u sljedećem snapshot-u bude manje od 70%, to znači da vjerojatno opet nismo ništa izgubili.
Da. Prema zadanom, sada je 5000. I mnogima je to dovoljno.
Obično - da.
Video:
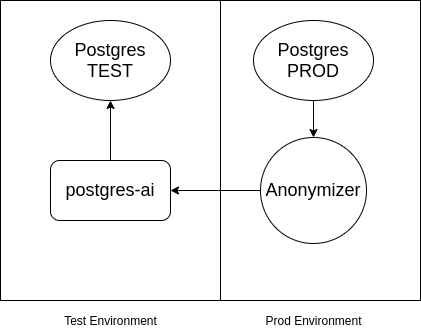
P.S. Dodajem da ako u Postgresu postoje povjerljivi podaci koje ne smiju dospjeti u testno okruženje, možete iskoristiti . Ovdje je približno shema:
Izvor: habr.com
