

Efekt širenja tablica i indeksa (bloat) široko je poznat i prisutan ne samo u Postgresu. Postoje načini za borbu protiv njega “iz kutije”, poput VACUUM FULL ili CLUSTER, ali oni blokiraju tablice tijekom rada i stoga se ne mogu uvijek koristiti.
U članku će biti malo teorije o tome kako nastaje bloat, kako se s njim može boriti, o deferred constraints i o problemima koje oni donose u korištenju proširenja pg_repack.
Ovaj članak je napisan na osnovi na PgConf.Russia 2020.
Zašto nastaje bloat
Osnova Postgresa leži u modelu višestrukih verzija (). Njegova suština je da svaka ili red u tablici može imati nekoliko verzija, pri čemu transakcije vide najviše jednu od tih verzija, ali ne nužno istu. To omogućuje rad nekoliko transakcija istovremeno bez znatnog utjecaja jedne na drugu.
Očigledno je da sve te verzije treba pohraniti. Postgres radi s memorijom po stranicama, a stranica je minimalna količina podataka koja se može čitati s diska ili zapisivati. Pogledajmo mali primjer kako se to događa.
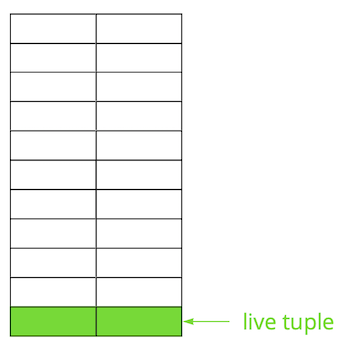
Pretpostavimo da imamo tablicu u koju smo dodali nekoliko zapisa. Na prvoj stranici datoteke u kojoj se pohranjuje tablica pojavili su se novi podaci. To su aktivne verzije redaka koje su dostupne drugim transakcijama nakon potvrde (za jednostavnost ćemo pretpostaviti da je nivo izolacije Read Committed).
Zatim smo ažurirali jedan od zapisa i time označili staru verziju kao neaktualnu.
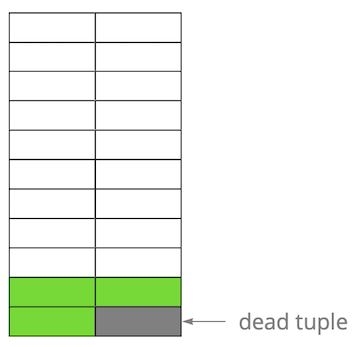
Korak po korak, ažurirajući i brišući verzije redaka, dobili smo stranicu u kojoj je otprilike polovica podataka “smeće”. Ovi podaci nisu vidljivi nijednoj transakciji.
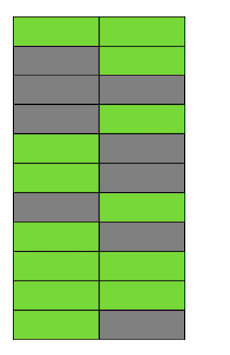
U Postgresu postoji mehanizam , koji uklanja neaktualne verzije i oslobađa prostor za nove podatke. Ali ako nije postavljen dovoljno agresivno ili je zauzet radom na drugim tablicama, “smešni podaci” ostaju, i moramo koristiti dodatne stranice za nove podatke.
Tako, u našem primjeru, u nekom trenutku tablica će se sastojati od četiri stranice, ali samo će polovica podataka biti aktivna. Kao rezultat, kada pristupamo tablici, čitat ćemo mnogo više podataka nego što je potrebno.
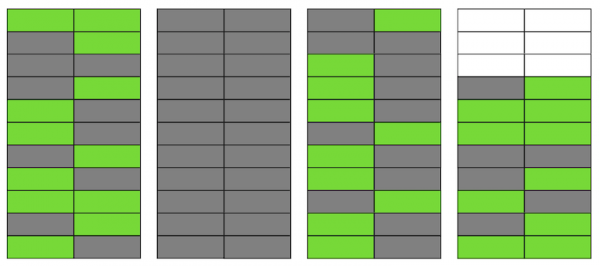
Čak i ako VACUUM sada ukloni sve zastarjele verzije redaka, situacija se neće drastično poboljšati. Imat ćemo slobodnog prostora na stranicama ili čak cijele stranice za nove retke, ali ćemo i dalje čitati više podataka nego što je potrebno.
Usput, da je potpuno prazna stranica (druga u našem primjeru) bila na kraju datoteke, VACUUM bi je mogao ukloniti. No, sada se nalazi usred, pa se s njom ne može ništa učiniti.
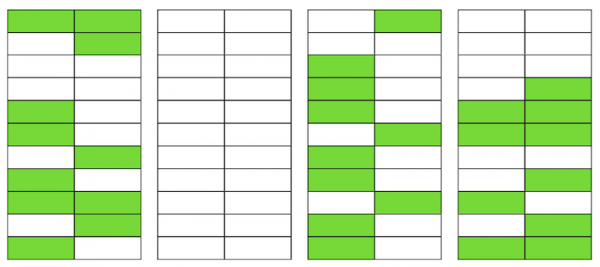
Kada broj takvih praznih ili jako rascijepljenih stranica postane velik, što se naziva bloat, to počinje utjecati na performanse.
Sve što je gore navedeno je mehanika nastanka bloat-a u tablicama. U indeksima se to događa otprilike na isti način.
Imam li bloat?
Postoji nekoliko načina da utvrdite imate li bloat. Ideja prvog je korištenje interne statistike Postgresa koja sadrži približne informacije o broju redaka u tablicama, broju 'živih' redaka itd. Na internetu možete pronaći mnoštvo varijacija već gotovih skripti. Mi smo se oslonili na iz PostgreSQL Experts-a, koja može procijeniti bloat tablica zajedno s toast-om i bloat btree-indeksima. Prema našem iskustvu, njegova pogreška iznosi 10-20%.
Drugi način je korištenje ekstenzije , koja omogućuje gledanje unutar stranica i dobivanje kako procijenjenih, tako i točnih vrijednosti bloat-a. No u drugom slučaju bit će potrebno skenirati cijelu tablicu.
Malu vrijednost bloat-a, do 20%, smatramo prihvatljivom. Može se smatrati kao analog fillfactora za i . Pri 50% i više mogu početi problemi s performansama.
Načini borbe protiv bloat-a
U Postgresu postoji nekoliko načina za borbu protiv bloat-a 'iz kutije', međutim, oni nisu uvijek i ne pristaju svima.
Postavite AUTOVACUUM da se bloat ne javlja. Ako budemo precizniji, kako bi se održao na razini koja vam odgovara. Izgleda kao 'kapetanski' savjet, ali u stvarnosti to nije uvijek lako postići. Na primjer, ako imate aktivan razvoj s redovitim promjenama sheme podataka ili se odvija neka migracija podataka. Kao posljedica, vaš profil opterećenja može se često mijenjati i, kao pravilo, može biti različit za različite tablice. Dakle, morate stalno raditi malo ispred i prilagođavati AUTOVACUUM promjenjivom profilu svake tablice. No, očito je da to nije jednostavno.
Drugi uobičajeni razlog zašto AUTOVACUUM ne uspijeva obraditi tablice je prisutnost dugotrajnih transakcija koje mu ne dopuštaju da očisti podatke jer su ti podaci dostupni tim transakcijama. Preporuka ovdje je također očita – riješite se 'visokih' transakcija i minimizirajte vrijeme aktivnih transakcija. No, ako je opterećenje vašeg aplikacije hibrid OLAP i OLTP, tada možete imati istovremeno mnogo čestih ažuriranja i kratkih upita, kao i dugotrajne operacije – na primjer, izradu izvještaja. U takvoj situaciji trebalo bi razmisliti o podjeli opterećenja na različite baze, što će omogućiti finiju konfiguraciju svake od njih.
Još jedan primjer – čak i ako je profil homogena, ali je BDA pod vrlo visokim opterećenjem, tada čak i maksimalno agresivni AUTOVACUUM može imati problema, i bloat će se pojaviti. Skaliranje (vertikalno ili horizontalno) – jedino je rješenje.
Što učiniti u situaciji kada ste postavili AUTOVACUUM, ali bloat i dalje raste.
Komanda VACUUM FULL rekonstruiše sadržaj tablica i indeksa i ostavlja u njima samo aktualne podatke. Za uklanjanje bloat-a radi savršeno, ali tijekom izvođenja preuzima ekskluzivnu blokadu na tablici (AccessExclusiveLock), koja ne dopušta izvođenje upita na ovoj tablici, čak ni select-a. Ako si možete priuštiti zaustavljanje vašeg servisa ili njegovog dijela na neko vrijeme (od desetaka minuta do nekoliko sati, ovisno o veličini BDA i vašoj opremi), tada je ova opcija najbolja. Nažalost, ne uspijevamo proći kroz VACUUM FULL unutar vremena planiranog održavanja, tako da nam ova metoda ne odgovara.
Komanda CLUSTER takođe restrukturira sadržaj tabela, kao i VACUUM FULL, pri čemu omogućava da se odredi indeks prema kojem će podaci biti fizički raspoređeni na disku (ali u budućnosti redosled za nove redove nije garantovan). U određenim situacijama ovo je dobra optimizacija za niz upita – za čitanje više zapisa po indeksu. Nedostatak komande je isti kao kod VACUUM FULL – blokira tabelu tokom rada.
Komanda REINDEX slična je dvema prethodnim, ali vrši rekonstrukciju određenog indeksa ili svih indeksa tabele. Blokade su nešto slabije: ShareLock na tabelu (ometa modifikacije, ali omogućava izvršavanje select) i AccessExclusiveLock na rekonstrukcioni indeks (blokira upite koji koriste taj indeks). Međutim, u 12. verziji Postgresa pojavio se parametar , koji omogućava rekonstrukciju indeksa bez blokiranja paralelnog dodavanja, menjanja ili brisanja zapisa.
U ranijim verzijama Postgresa rezultat sličan REINDEX CONCURRENTLY-u može se postići pomoću . On omogućava kreiranje indeksa bez stroge blokade (ShareUpdateExclusiveLock, koji ne ometa paralelne upite), zatim zamenu starog indeksa novim i brisanje starog indeksa. Ovo omogućava eliminaciju bloat-a indeksa, ne ometajući rad vaše aplikacije. Važno je napomenuti da će tokom rekonstrukcije indeksa biti dodatno opterećenje na diskovnoj podsystemi.
Dakle, ako za indekse postoje načini za uklanjanje bloat-a "u hodu", za tabele ih nema. Tu dolaze razna eksterna proširenja: (ranije pg_reorg), , i drugi. U okviru ovog članka neću ih upoređivati i reći ću samo o pg_repack-u, koji nakon nekih dorada koristimo kod nas.
Kako radi pg_repack
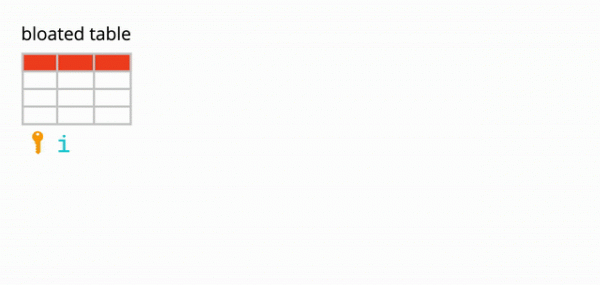
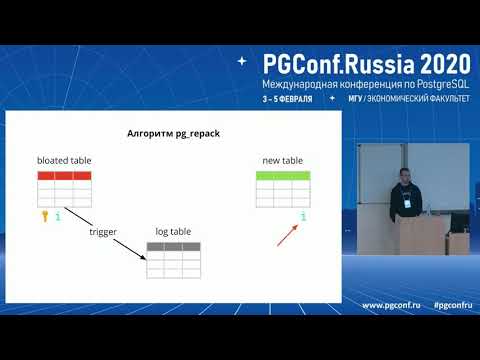
Recimo da imamo sasvim običnu tabelu – sa indeksima, ograničenjima i, nažalost, sa bloat-om. Prvi korak pg_repack-a je kreiranje log-tabele, kako bi se čuvali podaci o svim izmenama tokom rada. Okidač će replicirati te promene pri svakom insertu, update-u i delete-u. Zatim se kreira tabela slična izvornoj po strukturi, ali bez indeksa i ograničenja, kako ne bi usporavala proces umetanja podataka.
Zatim pg_repack prebacuje podatke iz stare tablice u novu, automatski filtrirajući sve neaktualne retke, a zatim stvara indekse za novu tablicu. Tijekom izvršenja svih ovih operacija u log-tablici se akumuliraju promjene.
Sljedeći korak je prebaciti promjene u novu tablicu. Prebacivanje se izvršava u nekoliko iteracija, a kada u log-tablici ostane manje od 20 zapisa, pg_repack preuzima strogu blokadu, prebacuje posljednje podatke i zamjenjuje staru tablicu novom u sistemskim tablicama Postgres. To je jedini i vrlo kratak trenutak kada nećete moći raditi s tablicom. Nakon toga, stara tablica i tablica s logovima se brišu i u datotečnom sustavu se oslobađa mjesto. Proces je završen.
U teoriji to izgleda odlično, što je s praktičnom primjenom? Testirali smo pg_repack bez opterećenja i pod opterećenjem, provjerili njegovu funkcionalnost u slučaju preranog zaustavljanja (jednostavno rečeno, pritiskom na Ctrl+C). Svi testovi su bili pozitivni.
Obrađivali smo uživo — a tada je sve krenulo kako nismo očekivali.
Prvi put uživo
Na prvom klasteru dobili smo pogrešku o kršenju jedinstvenog ograničenja:
$ ./pg_repack -t tablename -o id
INFO: prepakiranje tablice "tablename"
ERROR: upit je neuspješan:
    ERROR: vrijednost duplikata ključa krši jedinstveno ograničenje "index_16508"
DETAIL: Ključ (id, index)=(100500, 42) već postoji.
Ovo je ograničenje imalo automatski generirano ime index_16508 – stvorio ga je pg_repack. Prema atributima koji su uključeni, identificirali smo "naše" ograničenje koje mu odgovara. Problem je bio u tome što to nije sasvim uobičajeno ograničenje, već odgođeno (), tj. njegova se provjera izvršava kasnije od sql naredbe, što dovodi do neočekivanih posljedica.
Odgođena ograničenja: zašto su potrebna i kako rade
Malo teorije o odgođenim ograničenjima.
Razmotrimo jednostavan primjer: imamo tablicu-izvor automobila s dva atributa – nazivom i redoslijedom automobila u izvoru.
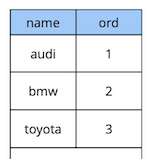
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Pretpostavimo da smo trebali promijeniti prva i druga automobila mjesta. Rješenje „na pamet“ – ažurirati prvo vrijednost na drugu, a drugu na prvu:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
No, prilikom izvršenja ovog koda očekivano ćemo dobiti kršenje ograničenja, jer je redoslijed vrijednosti u tablici jedinstven:
[23305] GREŠKA: duplicirani ključ krši jedinstveno ograničenje "uk_cars"
Detalji: Ključ (ord)=(2) već postoji.
Kako drugačije napraviti? Prva opcija: dodati dodatnu zamjenu vrijednosti za redoslijed koji se sigurno ne nalazi u tablici, na primjer “-1”. U programiranju se to naziva “zamjena vrijednosti dviju varijabli putem treće”. Jedini nedostatak ove metode je dodatno ažuriranje.
Druga opcija: redekorirati tablicu tako da za vrijednost reda koristite tip podataka s pomičnom decimalom umjesto cijelih brojeva. Tada će se pri ažuriranju vrijednosti s 1, na primjer, na 2,5 prvi zapis automatski „postaviti“ između drugog i trećeg. Ovo rješenje funkcionira, ali ima dva ograničenja. Prvo, nije primjenjivo ako se vrijednost koristi negdje u sučelju. Drugo, ovisno o preciznosti tipa podataka imat ćete ograničen broj mogućih umetanja prije nego što se izvrši ponovno izračunavanje svih vrijednosti.
Treća opcija: postaviti ograničenje na odgađanje, tako da se provjerava samo u trenutku izvršenja:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Budući da logika našeg prvotnog upita jamči da su do trenutka izvršenja sve vrijednosti jedinstvene, upit će se izvršiti uspješno.
Gore razmatrani primjer naravno da je vrlo sintetičan, ali otkriva ideju. U našoj aplikaciji koristimo odložena ograničenja za implementaciju logike koja upravlja sukobima kada korisnici istovremeno rade sa zajedničkim objektima-widgetima na ploči. Korištenje takvih ograničenja omogućava nam da učinimo aplikacijski kod malo jednostavnijim.
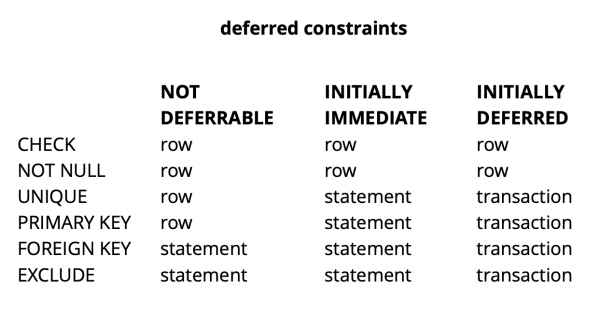
Općenito, ovisno o vrsti ograničenja u Postgresu postoji tri razine granularnosti provjere: razina reda, transakcije i izraza.
Izvor:
CHECK i NOT NULL uvijek se provjeravaju na razini reda, dok za ostala ograničenja, kao što je vidljivo iz tablice, postoje različite varijante. Više informacija možete pročitati. .
Ukratko, odgođena ograničenja u određenim situacijama daju čitljiviji kod i manje naredbi. Međutim, to dolazi s cijenom kompliciranja procesa debagiranja, jer je trenutak nastanka greške i trenutak kada saznate za nju razdvojen vremenom. Još jedan mogući problem je što planer ne može uvijek izraditi optimalni plan ako upit uključuje odgođeno ograničenje.
Dorada pg_repack
Razjasnili smo što su odgođena ograničenja, ali kako su povezana s našim problemom? Podsjetimo se greške koju smo ranije dobili:
$ ./pg_repack -t tablename -o id
INFO: prepakiranje tablice "tablename"
ERROR: upit je neuspješan:
    ERROR: vrijednost duplikata ključa krši jedinstveno ograničenje "index_16508"
DETAIL: Ključ (id, index)=(100500, 42) već postoji.
Ona se javlja u trenutku kopiranja podataka iz log-tablice u novu tablicu. To izgleda čudno, jer se podaci u log-tablici komitaju zajedno s podacima izvorne tablice. Ako zadovoljavaju ograničenja izvorne tablice, kako mogu kršiti ista ta ograničenja u novoj?
Kako se ispostavilo, korijen problema leži u prethodnom koraku rada pg_repack, gdje se stvaraju samo indeksi, ali ne i ograničenja: u staroj tablici bilo je jedinstveno ograničenje, a u novoj je umjesto njega stvoren jedinstveni indeks.
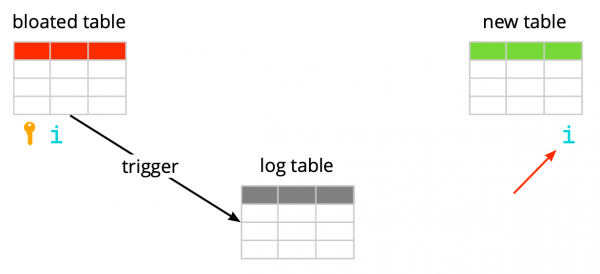
Važno je napomenuti da, ako je ograničenje obično, a ne odgođeno, tada je stvoreni jedinstveni indeks ekvivalentan tom ograničenju, jer se jedinstvena ograničenja u Postgresu ostvaruju stvaranjem jedinstvenog indeksa. Ali u slučaju odgođenog ograničenja, ponašanje nije isto, jer indeks ne može biti odgođen i uvijek se provjerava u trenutku izvršavanja sql-naredbe.
Dakle, suština problema leži u "odgođenosti" provjere: u izvornoj tablici ona se događa u trenutku komita, a u novoj – u trenutku izvršavanja sql-naredbe. To znači da trebamo osigurati da se provjere izvršavaju jednako u oba slučaja: ili uvijek odgođeno ili uvijek odmah.
Dakle, koje su ideje imale.
Kreirati indeks, sličan deferred
Prva ideja je provesti obje provjere u trenutnom režimu. To može dovesti do nekoliko lažno pozitivnih aktivacija ograničenja, ali ako ih bude malo, to ne bi trebalo utjecati na korisnike, jer su takvi konflikti za njih normalna situacija. Javljaju se, na primjer, kada dva korisnika istovremeno počinju uređivati isti widget, a klijent drugog korisnika ne uspijeva dobiti informaciju da je widget već blokiran za uređivanje od strane prvog korisnika. U takvoj situaciji server odbija drugog korisnika, a njegov klijent vraća promjene i blokira widget. Malo kasnije, kada prvi korisnik završi s uređivanjem, drugi će dobiti informaciju da widget više nije blokiran i moći će ponoviti svoju radnju.
Kako bi provjere uvijek bile u hitnom režimu, stvorili smo novi indeks, sličan originalnom odgađanju ograničenja:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- pokrenite pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
U testnom okruženju dobili smo samo nekoliko očekivanih grešaka. Uspjeh! Ponovno smo pokrenuli pg_repack na produkciji i dobili 5 grešaka na prvom klasteru tijekom satu rada. To je prihvatljiv rezultat. Međutim, već na drugom klasteru broj grešaka se povećao nekoliko puta i morali smo zaustaviti pg_repack.
Zašto se to dogodilo? Vjerojatnost pojave greške ovisi o tome koliko puno korisnika istovremeno radi s istim widgetima. Čini se da je u tom trenutku s podacima pohranjenim na prvom klasteru bilo znatno manje konkurentnih promjena nego na ostalim, tj. jednostavno smo imali 'sreće'.
Ideja nije uspjela. U tom trenutku smo imali dva druga moguća rješenja: prepisati naš aplikacijski kod kako bismo odustali od odgađanih ograničenja ili 'naučiti' pg_repack da radi s njima. Odabrali smo drugi.
Zamijeniti indekse u novoj tablici s odgađanim ograničenjima iz izvorne tablice.
Cilj dorade bio je očit - ako izvorna tablica ima odgađeno ograničenje, onda za novu treba stvoriti takvo ograničenje, a ne indeks.
Kako bismo provjerili naše promjene, napisali smo jednostavan test:
- tablica s odgađanim ograničenjem i jednim zapisom;
- umetamo podatke u petlji koji se sukobljavaju s postojećim zapisom;
- radimo update – podaci više ne konflitiraju;
- komitiramo promjene.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
Izvorna verzija pg_repack uvijek je padala na prvom insertu, doradjena verzija radila je bez grešaka. Odlično.
Idemo na produkciju i opet dobijamo grešku u istoj fazi kopiranja podataka iz log-tabele u novu:
$ ./pg_repack -t tablename -o id
INFO: prepakiranje tablice "tablename"
ERROR: upit je neuspješan:
    ERROR: vrijednost duplikata ključa krši jedinstveno ograničenje "index_16508"
DETAIL: Ključ (id, index)=(100500, 42) već postoji.
Klasična situacija: na testnim okruženjima sve radi, a na produkciji — ne?!
APPLY_COUNT i spoj dva batcha
Počeli smo analizirati kod doslovno liniju po liniju i otkrili važnu stvar: prebacivanje podataka iz log-tabele u novu događa se u batch-evima, konstanta APPLY_COUNT određivala je veličinu batcha:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* There might be still some tuples, repeat. */
...
}
Problem je u tome što podaci izvorne transakcije, u kojoj nekoliko operacija može potencijalno prekršiti ograničenje, pri prijenosu mogu upasti u spoj dva batcha – pola komandi bit će zakomitirano u prvom batchu, a druga polovica — u drugom. I ovdje kako bude: ako komande u prvom batchu ne krše ništa, onda je sve u redu, a ako krše — događa se greška.
APPLY_COUNT je jednak 1000 zapisa, što objašnjava zašto su naši testovi prolazili uspješno – nisu pokrivali slučaj “spoj batcha”. Koristili smo dvije komande – insert i update, tako da je točno 500 transakcija po dvije komande uvijek bilo u batchu i nismo imali problema. Nakon dodavanja drugog update-a naša izmjena je prestala raditi:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- još jedan update
    COMMIT;
  END;
END LOOP;
Dakle, sljedeći zadatak – učiniti da podaci iz izvorne tabele, koji su se mijenjali u jednoj transakciji, upadnu u novu tabelu također unutar jedne transakcije.
Odustajanje od batchinga
Imamo opet dva rješenja. Prvo: odustajanje od podijele na pakete i prijenos podataka u jednoj transakciji. Prednost ovog rješenja je njegova jednostavnost – potrebne promjene u kodu su minimalne (usput, u starijim verzijama pg_reorg radio je upravo na taj način). No postoji problem — stvaramo dugu transakciju, a to, kao što je ranije rečeno, predstavlja prijetnju za pojavu novog bloat-a.
Drugo rješenje — složenije, ali vjerojatno pravilnije: u log-tablici stvoriti stupac s identifikatorom transakcije koja je dodala podatke u tablicu. Tada ćemo prilikom kopiranja podataka moći grupirati ih prema ovom atributu i garantirati da će povezane promjene biti premještene zajedno. Paket će se formirati iz nekoliko transakcija (ili jedne velike) i njegova veličina će varirati ovisno o tome koliko je podataka promijenjeno u tim transakcijama. Važno je napomenuti da, budući da podaci različitih transakcija dolaze u log-tablicu nasumično, više neće biti moguće čitati je sekvencijalno kao što je to bilo prije. seqscan pri svakom upitu s filtriranjem po tx_id – preskupo je, potreban je indeks, ali on će također usporiti rad metode zbog troškova ažuriranja. Ukratko, kao i uvijek, nešto se mora žrtvovati.
Dakle, odlučili smo započeti s prvom opcijom, kao jednostavnijom. Prvo je trebalo shvatiti hoće li duga transakcija biti stvarni problem. Budući da se glavni prijenos podataka iz stare tablice u novu također odvija u jednoj dugoj transakciji, pitanje se pretvorilo u “koliko ćemo povećati ovu transakciju?” Trajanje prve transakcije uvelike ovisi o veličini tablice. Trajanje nove – o tome koliko promjena će se nakupiti u tablici tijekom prijenosa podataka, tj. o intenzitetu opterećenja. Provođenje pg_repack-a odvijalo se tijekom minimalnog opterećenja na uslugu, a volumen promjena bio je nesrazmjerno mali u usporedbi s izvornih volumenom tablice. Odlučili smo da možemo zanemariti vrijeme nove transakcije (za usporedbu, prosječno je to 1 sat i 2-3 minute).
Eksperimenti su bili pozitivni. Pokretanje na produkciji također. Za ilustraciju – slika s veličinom jedne od baza nakon pokretanja:
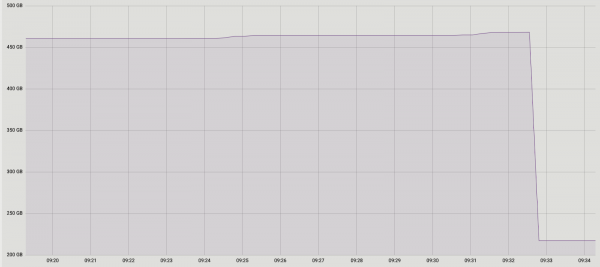
Budući da nas je ovo rješenje potpuno zadovoljilo, nismo pokušavali implementirati drugo, ali razmatramo mogućnost rasprave o tome s razvojnim timom proširenja. Naša trenutna nadogradnja, nažalost, još uvijek nije spremna za objavu, budući da smo riješili problem samo s jedinstvenim odgođenim ograničenjima, a za potpuni ispravak potrebno je osigurati podršku i za druge tipove. Nadamo se da ćemo to uspjeti učiniti u budućnosti.
Možda se pitate zašto smo se uopće upustili u ovu priču s nadogradnjom pg_repack, umjesto da smo, na primjer, koristili njegove analoge? U nekom trenutku smo i mi o tome razmišljali, ali pozitivno iskustvo korištenja ranije, na tablicama bez odgođenih ograničenja, motiviralo nas je da pokušamo razumjeti bit problema i riješiti ga. Osim toga, za korištenje drugih rješenja također je potrebno vrijeme za provođenje testiranja, stoga smo odlučili da prvo pokušamo ispraviti problem u njemu, a ako shvatimo da to ne možemo učiniti u razumnom vremenskom okviru, tada ćemo početi razmatrati analoge.
Zaključci
Što možemo preporučiti na temelju vlastitog iskustva:
- Pratite svoj bloat. Na temelju podataka o praćenju moći ćete shvatiti koliko je dobro podešen autovacuum.
- Podesite AUTOVACUUM kako biste održavali bloat na prihvatljivoj razini.
- Ako bloat i dalje raste i ne možete ga se riješiti pomoću sredstava "iz kutije", ne bojte se koristiti vanjska proširenja. Glavno je dobro testirati sve.
- Ne bojte se doraditi vanjska rješenja prema svojim potrebama – ponekad može biti učinkovitije i čak jednostavnije nego mijenjanje vlastitog koda.
Izvor: habr.com
