

U ovom članku ću govoriti o situaciji koja se nedavno dogodila s jednim od servera našeg VPS oblaka, koja me je dovela u čudu na nekoliko sati. Više od 15 godina se bavim konfiguracijom i rješavanjem problema s Linux serverima, ali ovaj slučaj potpuno izlazi iz mog iskustva — napravio sam nekoliko pogrešnih pretpostavki i bio pomalo očajan prije nego što sam mogao pravilno odrediti uzrok problema i riješiti ga.
Preamvula
Imamo oblak srednje veličine, koji gradimo na standardnim serverima sljedeće konfiguracije — 32 jezgre, 256 GB RAM-a i NVMe pohranu PCI-E Intel P4500 kapaciteta 4TB. Ova konfiguracija nam zaista odgovara, jer omogućuje da ne brinemo o nedostatku IO-a, pružajući ispravno ograničenje na razini tipova instanci VM. Budući da NVMe Intel ima zapanjujuće performanse, možemo istovremeno osigurati potpuno pružanje IOPS mašinama, kao i sigurnosne kopije podataka na serveru za sigurnosne kopije s nulom IOWAIT-a.
Pripadamo onim starovima koji ne koriste hiperkonvergentna SDN i druge moderne, stylish, mlade stvari za pohranu VM volumena, smatrajući da što je sistem jednostavniji, to je lakše rješavati probleme u situacijama kada "glavni guru ode u planine". Na kraju, pohranjujemo VM volume u QCOW2 formatu u XFS ili EXT4, koji je implementiran preko LVM2.
Upotrebu QCOW2 nam nameće i proizvod koji koristimo za orkestraciju — Apache CloudStack.
Za izradu sigurnosnih kopija uzimamo potpunu sliku volumena, kao snapshot LVM2 (da, znamo da su LVM2 snimci spori, ali Intel P4500 nas ovdje spašava). Radimo lvmcreate -s .. i putem dd šaljemo sigurnosnu kopiju na udaljeni server s ZFS pohranom. Ovdje smo ipak malo napredniji — ZFS može pohranjivati podatke u komprimiranom obliku, a mi ih možemo brzo obnavljati pomoću DD ili dobivati pojedinačne VM volumene pomoću mount -o loop ....
Naravno, možemo uzeti i ne potpunu sliku LVM2 volumena, već montirati datotečni sustav u
ROi kopirati same QCOW2 slike, no susretali smo se s time da XFS zbog toga postaje loš, i to ne odmah, nego nepredvidivo. Jako ne volimo kada hostovi-hipervizori "zapnu" iznenada tijekom vikenda, noću ili na praznike zbog pogrešaka koje se ne zna kada će se dogoditi. Stoga za XFS ne koristimo montiranje snimaka u načinuROza vađenje volumena, već jednostavno kopiramo cijeli LVM2 volumen.
Brzina izrade sigurnosne kopije na serveru sigurnosnih kopija određena je u našem slučaju performansama servera za izradu sigurnosnih kopija, koja iznosi oko 600-800 MB/s za nekomprimirane podatke, a daljnji ograničavajući faktor je 10Gbit/s veza kojom je server sigurnosnih kopija spojen na klaster.
Pri tome na jedan server sigurnosnih kopija istovremeno se učitava sigurnosna kopija 8 poslužitelja hipervizora. Na taj način, diskovni i mrežni sustavi servera sigurnosnih kopija, koji su sporiji, ne opterećuju diskovne sustave hostova-hipervizora, jer jednostavno nisu u stanju obraditi, recimo, 8 GB/s koje hostovi-hipervizori mogu lako ostvariti.
Gore opisani proces kopiranja izuzetno je važan za daljnje pripovijedanje, uključujući i detalje — korištenje brzi skladišta Intel P4500, korištenje NFS-a i vjerojatno korištenje ZFS-a.
Priča o sigurnosnoj kopiji
Na svakom čvoru-hipervizoru imamo mali SWAP odjeljak veličine 8 GB, a sam čvor-hipervizor "postavljamo" pomoću DD iz referentne slike. Za sustavni volumen na serverima koristimo 2xSATA SSD RAID1 ili 2xSAS HDD RAID1 na hardverskom kontroleru LSI ili HP. U osnovi, nije nam bitno što je unutra, budući da radimo na načinu "gotovo readonly" za sustavni volumen, osim SWAP-a. A s obzirom na to da imamo jako puno RAM-a na serveru i da je 30-40% slobodno, ne razmišljamo o SWAP-u.
Proces izrade sigurnosne kopije. Ova zadaća izgleda otprilike ovako:
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Obratite pažnju na ionice -c3, u stvari, ova stvar je potpuno beskorisna za NVMe uređaje, budući da je IO planer za njih postavljen kao:
cat /sys/block/nvme0n1/queue/scheduler
[none]
Međutim, imamo nekoliko legacy-čvorova s običnim SSD RAID-ima, za njih je to relevantno, pa tako ide AS IS. U osnovi, ovo je samo zanimljivi komad koda koji objašnjava uzaludnost ionice u slučaju takve konfiguracije.
Obratite pažnju na oznaku iflag=direct za DD. Koristimo direct IO mimo predmemorivanja da ne bismo pravili suvišne zamjene IO bafera pri čitanju. Međutim, oflag=direct to ne radimo jer smo naišli na probleme s performansama ZFS prilikom njegove upotrebe.
Ova shema se srećom koristi već nekoliko godina bez problema.
I tad je počelo… Otkrili smo da backup za jedan od čvorova više ne radi, dok je prethodni završen s monstruoznim IOWAIT-om od 50%. Pokušavajući razumjeti zašto backup ne funkcioniše, suočili smo se s fenomenom:
Grupa volumena "images" nije pronađenaPočeli smo razmišljati o "kraj Intel P4500", međutim, pre nego što smo isključili server radi zamene diska, bilo je potrebno ipak izvršiti backup. Popravili smo LVM2 pomoću vraćanja metapodataka iz LVM2 backup-a:
vgcfgrestore imagesPokrenuli smo backup i videli ovu sliku:
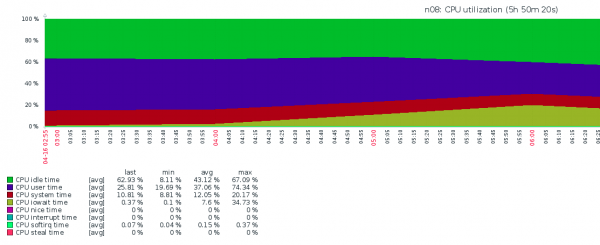
Ponovo smo se veoma razočarali — bilo je jasno da tako ne možemo živeti, jer će svi VPS-ovi patiti, a time ćemo patiti i mi. Šta se dešavalo, potpuno je nejasno — iostat je pokazivao bednih IOPS-a i ekstremno visok IOWAIT. Ideje, osim "ajde da zamenimo NVMe", nisu postojale, ali se ubrzo desilo prosvetljenje.
Analiza situacije korak po korak
Istorijski dnevnik. Nekoliko dana ranije na ovom serveru je bilo potrebno napraviti veliki VPS s 128 GB RAM-a. Memorije je, činilo se, bilo dovoljno, ali za svaki slučaj smo dodali još 32 GB za swap particiju. VPS je napravljen, uspešno je obavljao svoju svrhu i incident je zaboravljen, a SWAP particija je ostala.
Značajke konfiguracije. Za sve servere oblaka parameter vm.swappiness je postavljen na podrazumevanu vrednost 60. A SWAP je kreiran na SAS HDD RAID1.
Šta se dešavalo (prema mišljenju redakcije). Tokom backupa DD je izdavalo mnogo podataka za pisanje, koji su se stavljali u RAM baferima pre nego što su zapisani na NFS. Jezgro sistema, vodeći se politikom swappiness, premestilo je mnogo stranica memorije VPS-a u swap prostor, koji se nalazio na sporom HDD RAID1 volumenu. To je dovelo do značajnog porasta IOWAIT-a, ali ne zbog IO NVMe, već zbog IO HDD RAID1.
Kako je problem rešen. Swap particija od 32 GB je isključena. To je trajalo 16 sati, o tome kako i zašto se SWAP isključuje tako sporo možete pročitati posebno. Parametri su promenjeni swappiness na vrednost jednaku 5 u celoj oblaku.
Kako to nije moglo da se desi. Prvo, da je SWAP bio na SSD RAID-u ili NVMe uređaju, a drugo, da nije bilo NVMe uređaja, već sporijeg uređaja koji ne bi mogao isporučiti takav obujam podataka — ironija je da je problem nastao jer je NVMe prebrz.
Nakon toga sve je počelo raditi kao i prije — s nultim IOWAIT-om.
Izvor: habr.com
