

U složenim ERP sustavima mnoge entitete imaju hijerarhijsku prirodu, kada se homogeni objekti organiziraju u stablo odnosa "roditelj — dijete" — to su i organizacijska struktura poduzeća (svi ti područni uredi, odjeli i radne grupe), kao i katalog proizvoda, dijelovi radova i geografija prodajnih mjesta,…
U stvari, ne postoji ni jedno , gdje ne bi postojala neka hijerarhija kao rezultat. No, čak i ako ne radite "na poslu", i dalje se možete lako susresti s hijerarhijskim vezama. Na primjer, čak je i vaše obiteljsko stablo ili katna shema prostora u trgovačkom centru isto takva struktura.
Postoji mnogo načina za pohranu takvog stabla u DBMS-u, ali danas ćemo se zaustaviti samo na jednom varijanti:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- ne zaboravite, da FK ne podrazumijeva automatsko kreiranje indeksa, za razliku od PK
I dok proučavate dubinu hijerarhije, ona strpljivo čeka koliko će [ne]učinkovitima biti vaši "naivni" načini rada s takvom strukturom.
Hajde da razmotrimo tipične zadatke koji se javljaju, njihovu realizaciju na SQL-u i pokušajmo poboljšati njihovu učinkovitost.
#1. Насколько глубока кроличья нора?
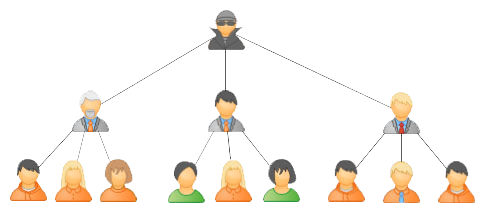
Da bismo bili jasni, smatrajmo da će ova struktura odražavati podređenost odjela u strukturi organizacije: odjeli, divizije, sektori, područni uredi, radne grupe,… — kako god ih nazvali.
Prvo ćemo generirati naše 'stablo' od 10K elemenata
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Počnimo s najjednostavnijim zadatkom — pronaći sve zaposlenike koji rade unutar određenog sektora, ili u terminima hijerarhije — pronaći sve potomke čvora. A bilo bi dobro dobiti i "dubinu" potomka… Sve to može biti potrebno, na primjer, za izradu nekog .
Sve bi bilo u redu ako su ti potomci samo nekoliko razina i u broju ispod deset, ali ako ima više od 5 razina, a potomaka već deseci — mogu postojati problemi. Pogledajmo kako se tradicionalno pišu (i rade) opcije pretraživanja „dolje kroz stablo“. No prvo, definirajmo koji su čvorovi najzanimljiviji za naše istraživanje.
Najdublji podstablo: WITH RECURSIVE T AS ( SELECT id , pid , ARRAY[id] path FROM hier WHERE pid IS NULL UNION ALL SELECT hier.id , hier.pid , T.path || hier.id FROM T JOIN hier ON hier.pid = T.id ) TABLE T ORDER BY array_length(path, 1) DESC;
id  | pid  | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
... ŠirokaNajdublji ... SELECT path[1] id , count(*) FROM T GROUP BY 1 ORDER BY 2 DESC; WITH RECURSIVE T AS ( SELECT id , pid , ARRAY[id] path FROM hier WHERE pid IS NULL UNION ALL SELECT hier.id , hier.pid , T.path || hier.id FROM T JOIN hier ON hier.pid = T.id ) TABLE T ORDER BY array_length(path, 1) DESC;
id   | count
------------
5300 |   30
 450 |   28
1239 |   27
1573 |   25
Za ove upite koristili smo tipični
rekurzivni JOIN Očigledno, s ovakvom strukturom upita:
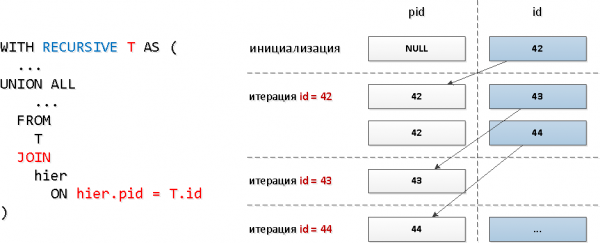
broj iteracija biće jednak ukupnom broju potomaka (a njih je nekoliko desetaka), i to može značajno trošiti resurse, i, kao posledica, vreme. Proverimo na najširem podstablju:
WITH RECURSIVE T AS ( SELECT id FROM hier WHERE id = 5300 UNION ALL SELECT hier.id FROM T JOIN hier ON hier.pid = T.id ) TABLE T;
Kao što smo pretpostavljali, pronašli smo svih 30 zapisa. No, potrošili smo 60% ukupnog vremena — zato što smo u tom procesu napravili i 30 pretraga po indeksu. Može li se učiniti manje? 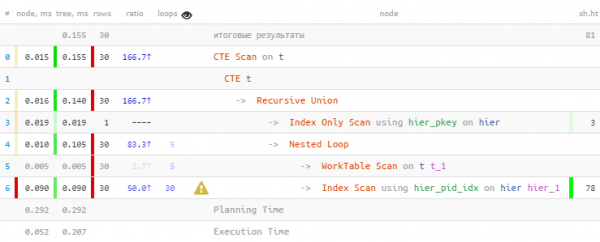
Masovna provjera putem indeksa
A treba li nam za svaki čvor napraviti poseban upit za indeks? Ispostavlja se da ne — možemo čitati iz indeksa
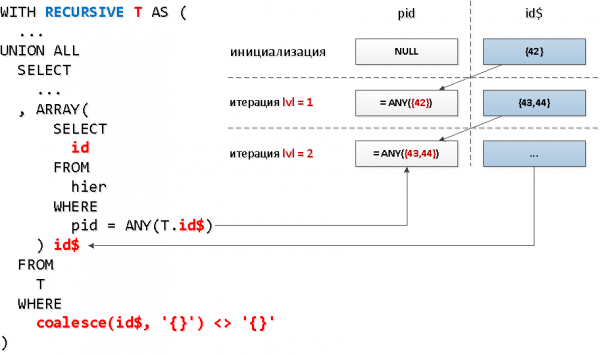
odjednom po nekoliko ključeva s jednim pozivom = ANY(array) pomoću A u svaku takvu grupu identifikatora možemo uzeti sve pronađene ID-ove po 'čvorovima'. To znači da ćemo na svakom sledećem koraku.
tražiti odmah sve potomke određenog nivoa. Samo, postoji problem,.
u rekurzivnom odabiru ne možemo se obratiti sami sebi u unutrašnjem upitu , a moramo se nekako ograničiti samo na ono što je pronađeno na prethodnom nivou... Ispostavlja se da se ne može napraviti unutarnji upit za celu selekciju — ali je moguće za njeno konkretno polje. A to polje može biti i niz — što nam je i potrebno za korišćenjeANY Zvuči pomalo bizarno, ali na dijagramu — sve je jednostavno..
Zvuči pomalo suludo, ali na dijagramu je sve jednostavno.
SA REKURZIVNO T KAO (
  ODABERI
    ARRAY[id] id$
  IZ
    hier
  GDJE
    id = 5300
UNION ALL
  ODABERI
    ARRAY(
      ODABERI
        id
      IZ
        hier
      GDJE
        pid = ANY(T.id$)
    ) id$
  IZ
    T
  GDJE
    coalesce(id$, '{}')  '{}' -- uvjet za izlazak iz petlje - prazni niz
)
ODABERI
  unnest(id$) id
IZ
T; 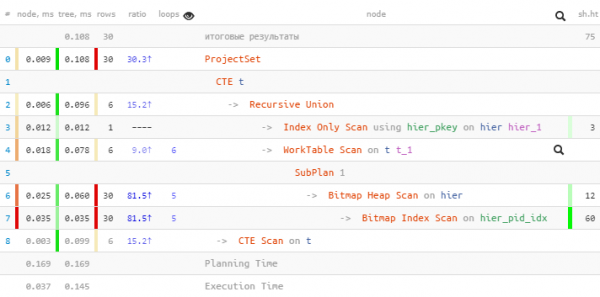
A najvažnije je zapravo ne dobitak od 1.5 puta u vremenu, nego to što smo smanjili broj poziva na indeks na ukupno 5 umjesto 30!
Dodatna pogodnost je taj što će identifikatori nakon završnog unnest ostati razvrstani po "razinama".
Znak čvora
Sljedeća razmatranja koja će pomoći poboljšanju performansi su da "listovi" ne mogu imati djecu, što znači da za njih ne treba tražiti "dolje" uopće. U okviru našeg zadatka to znači da ako smo išli niz lanac odjela i stigli do zaposlenika, više nije potrebno tražiti dalje po toj grani.
Uvedimo u našu tablicu dodatno boolean-polje, koje će nam odmah reći je li ova konkretna stavka u našem stablu "čvor" - to jest, mogu li uopće imati potomke.
ALTER TABLE hier
  DODAJ KOLONU branch boolean;

UPDATE
  hier T
SET
  branch = TRUE
GDJE
  EXISTS(
    ODABERI
      NULL
    IZ
      hier
    GDJE
      pid = T.id
    LIMIT 1
);
-- Upit uspješno izvršen: 3033 redaka promijenjeno za 42 ms.
Odlično! Ispostavlja se da samo nešto više od 30% svih elemenata stabla ima potomke.
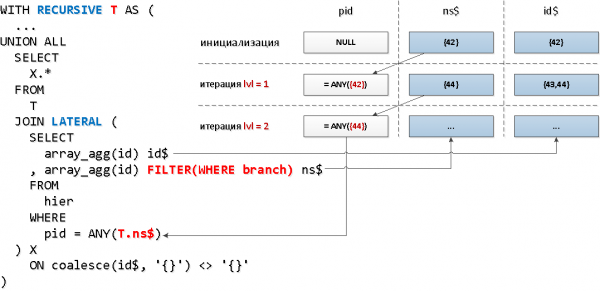
Sada ćemo primijeniti nešto drugačiju mehaniku - spoj s rekurzivnim dijelom preko generate_series, što će nam omogućiti da se odmah obratimo poljima rekurzivne "tablice", a agregatnu funkciju s uvjetom filtriranja po znaku čvora koristit ćemo za smanjenje skupa ključeva:
SA REKURZIVNO T KAO (
  ODABERI
    array_agg(id) id$
  , array_agg(id) FILTER(GDJE branch) ns$
  IZ
    hier
  GDJE
    id = 5300
UNION ALL
  ODABERI
    X.*
  IZ
    T
  JOIN LATERAL (
    ODABERI
      array_agg(id) id$
    , array_agg(id) FILTER(GDJE branch) ns$
    IZ
      hier
    GDJE
      pid = ANY(T.ns$)
  ) X
    NA coalesce(T.ns$, '{}')  '{}'
)
ODABERI
  unnest(id$) id
IZ
T; 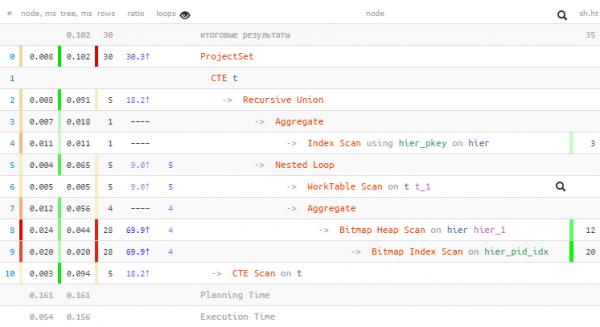
Uspjeli smo smanjiti još jedno obraćanje indeksu i dobiti više od 2 puta po volumenu pročitanog.
#2. Вернемся к корням
Ovaj algoritam će biti koristan ako trebate skupiti zapise za sve elemente "natrag po stablu", zadržavajući pritom informacije o tome koji je izvorni list (i s kojim pokazateljima) pokrenuo njegovo uključivanje u izbor - na primjer, za formiranje sažetka izvještaja s agregacijom na čvorovima.
Daljnje je najbolje shvatiti kao proof-of-concept, budući da upit postaje prilično složen. No, ako dominira vašom bazom podataka — vrijedi razmisliti o primjeni sličnih metoda.
Započnimo s nekoliko jednostavnih tvrdnji:
- Isti zapis iz baze najbolje je čitati samo jednom.
- Zapisi iz baze efikasnije je čitati u "paketu", nego pojedinačno.
Sada ćemo pokušati konstruirati potreban upit.
Korak 1
Očito je da ćemo na inicijalizaciji rekurzije (kamo bez toga!) morati očitati zapise samih listova prema skupu ulaznih identifikatora:
WITH RECURSIVE tree AS (
  SELECT
    rec -- ovo je cjelovit zapis tablice
  , id::text chld -- to je "skup" koji je doveo ovamo ulazne listove
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Ako se nekome činilo čudnim da se "skup" pohranjuje kao string, a ne kao niz, postoji jednostavno objašnjenje. Za stringove postoji ugrađena agregatna funkcija za "spajanje" string_agg, a za nizove — ne. Iako ju je .
Korak 2
Sada trebamo dobiti skup ID-ova sekcija koje ćemo dalje očitati. Ovakvi ID-ovi često će se duplicirati u različitim zapisima iz izvornog skupa — stoga bismo ih trebali grupirati, čuvajući pri tome informacije o izvorima listova.
No, ovdje nas čekaju tri neugodnosti:
- "Podrekurzivna" komponenta upita ne može sadržavati agregatne funkcije s
GROUP BY. - Poziv na rekurzivnu "tablicu" ne može se nalaziti u ugniježdenom podupitu.
- Upit u rekurzivnoj komponenti ne može sadržavati CTE.
Srećom, sve te probleme prilično lako možemo zaobići. Započnimo s kraja.
CTE u rekurzivnoj komponenti
Ovako ne to funkcionira:
WITH RECURSIVE tree AS (
  ...
UNION ALL
  WITH T (...)
  SELECT ...
)
A ovako — radi, zagrade rešavaju!
WITH RECURSIVE tree AS (
  ...
UNION ALL
  (
    WITH T (...)
    SELECT ...
  )
)
Ugniježdeni upit na rekurzivnu "tablicu"
Hm… Pozivanje na rekurzivni CTE ne može biti u ugniježdenom upitu. Ali može biti unutar CTE! A ugniježdeni upit može se obraćati ovoj CTE!
GROUP BY unutar rekurzije
Neugodno, ali… Imamo jednostavan način kako možemo simulirati GROUP BY pomoću DISTINCT ON i prozorskih funkcija!
SELECT
  (rec).pid id
, string_agg(chld::text, ',') chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
GROUP BY 1 -- ne radi!
A ovako — radi!
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
Sad vidimo zašto se numerički ID pretvorio u tekst — kako bi ih mogli spojiti zarezima!
Korak 3
Za finale nam preostaje samo malo:
- provjeravamo zapise "odjeljaka" prema skupu grupiranih ID-ova
- uspoređujemo pročitane odjeljke s "skupovima" izvornih listi
- "širimo" niz-skup koristeći
unnest(string_to_array(chld, ',')::integer[])
WITH RECURSIVE tree AS (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    WITH prnt AS (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes AS (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 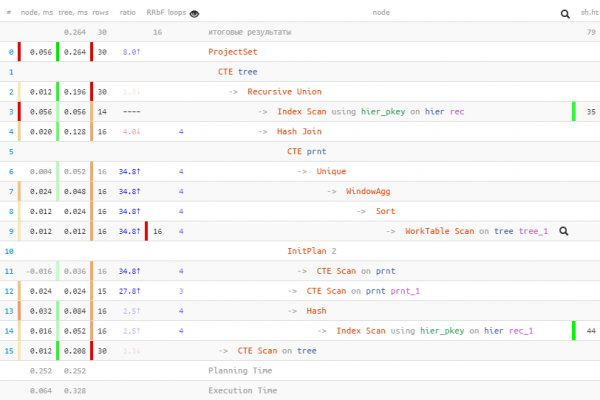
Izvor: habr.com
