

Bok, Habr! Predstavljam vam prijevod članka autora Burak Yavuz, Brenner Heintz i Denny Lee, koja je pripremljena uoči početka tečaja od OTUS-a.
Podaci, kao i naše iskustvo, neprestano se akumuliraju i razvijaju. Da bismo ostali u korak, naši mentalni modeli svijeta moraju se prilagoditi novim podacima, od kojih neki donose nove dimenzije — nove načine posmatranja stvari o kojima ranije nismo imali pojma. Ovi mentalni modeli malo se razlikuju od shema tablica koje definiraju kako klasificiramo i obrađujemo nove informacije.
To nas dovodi do pitanja upravljanja shemama. Kako se poslovni zadaci i zahtjevi mijenjaju tokom vremena, struktura vaših podataka se također mijenja. Delta Lake omogućava lako uvođenje novih dimenzija kada se podaci mijenjaju. Korisnici imaju pristup jednostavnoj semantici za upravljanje shemama svojih tablica. Ovi alati uključuju prisilnu primjenu sheme (Schema Enforcement), koja štiti korisnike od neželjenog zagađenja svojih tablica greškama ili suvišnim podacima, kao i evoluciju sheme (Schema Evolution), koja automatski omogućava dodavanje novih stupaca s vrijednim podacima na odgovarajuća mjesta. U ovom članku ćemo se dublje posvetiti korištenju ovih alata.
Razumijevanje shema tablica
Svaki DataFrame u Apache Spark sadrži shemu koja određuje oblik podataka, kao što su tipovi podataka, stupci i metapodaci. Pomoću Delta Lake, shema tablice se čuva u JSON formatu unutar dnevnika transakcija.
Što je prisilna primjena sheme?
Prisilna primjena sheme (Schema Enforcement), također poznata kao provjera sheme (Schema Validation), je zaštitni mehanizam u Delta Lake koji osigurava kvalitetu podataka odbacujući zapise koji ne odgovaraju shemi tablice. Kao hostess na recepciji popularnog restorana koji prima samo po prethodnoj rezervaciji, ona provjerava jesu li svi stupci podataka koji se unose u tablicu na odgovarajućem popisu očekivanih stupaca (drugim riječima, imaju li svi „rezervacije”), i odbacuje sve zapise sa stupcima koji nisu na tom popisu.
Kako funkcioniše prisilna primjena sheme?
Delta Lake koristi provjeru sheme prilikom zapisivanja, što znači da se svi novi unosi u tablicu provjeravaju na usklađenost sa shemom ciljne tablice tijekom zapisivanja. Ako shema nije usklađena, Delta Lake potpuno poništava transakciju (podatci se ne zapisuju) i generira iznimku kako bi obavijestio korisnika o nesukladnosti.
Za određivanje usklađenosti unosa Delta Lake koristi sljedeća pravila. Zapisani DataFrame:
- ne može sadržavati dodatne stupce koji nisu u shemi ciljne tablice. I obrnuto, sve je u redu ako ulazni podaci ne sadrže sve stupce iz tablice — tim će stupcima jednostavno biti dodijeljene null vrijednosti.
- ne može imati tipove podataka stupaca koji se razlikuju od tipova podataka stupaca u ciljnoj tablici. Ako stupac ciljne tablice sadrži podatke tipa StringType, ali odgovarajući stupac u DataFrame sadrži podatke tipa IntegerType, prisilno primjenjivanje sheme izazvat će iznimku i spriječiti izvršenje operacije zapisivanja.
- ne može sadržavati imena stupaca koja se razlikuju samo po registru. To znači da ne možete imati stupce s nazivima ‘Foo’ i ‘foo’ definirane u istoj tablici. Iako se Spark može koristiti u senzitivnom ili nesenzitivnom (po defaultu) režimu prema registru, Delta Lake čuva registar, ali je nesenzitivan u okviru pohrane sheme. Parquet je senzitivna prema registru pri pohrani i vraćanju informacija o stupcu. Kako bismo izbjegli moguće greške, oštećenja podataka ili njihovu gubitak (s čime smo se osobno susreli u Databricks), odlučili smo dodati ovo ograničenje.
Da bismo to ilustrirali, pogledajmo što se događa u donjem kodu prilikom pokušaja dodavanja nekih nedavno generiranih stupaca u Delta Lake tablicu koja još nije postavljena za njihovo prihvaćanje.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
Umjesto automatskog dodavanja novih stupaca, Delta Lake nameće shemu i zaustavlja zapisivanje. Kako bi pomogao odrediti koji stupac (ili njihova mnoštvo) uzrokuje nesukladnost, Spark ispisuje obje sheme iz stack tračeva za usporedbu.
Koja je korist od prisilnog primjenjivanja sheme?
Budući da je prisilna primjena sheme stroga provjera, ona je izvrstan alat za korištenje kao čuvar čistog, potpuno transformiranog skupa podataka spremnog za proizvodnju ili potrošnju. Obično se primjenjuje na tablice koje izravno pružaju podatke:
- Algoritmi strojног učenja
- BI nadzornim pločama
- Analitici podataka i alatima za vizualizaciju
- Svakom proizvodnom sustavu koji zahtijeva strogo strukturirane, strogo tipizirane semantičke sheme.
Kako biste pripremili svoje podatke za ovu konačnu barijeru, mnogi korisnici koriste jednostavnu 'multi-hop' arhitekturu koja postupno unosi strukturu u njihove tablice. Da biste saznali više o tome, možete pročitati članak
Naravno, prisilnu primjenu sheme možete koristiti bilo gdje u svom pipeline-u, ali imajte na umu da bi zapisivanje podataka u tablicu u tom slučaju moglo biti frustrirajuće, zbog toga što ste, na primjer, zaboravili dodati još jedan stupac u ulazne podatke.
Sprječavanje razrjeđivanja podataka
U ovom trenutku se možda pitate, zašto tolika pompa? Na kraju krajeva, ponekad neočekivana pogreška 'neslaganja sheme' može vas saplesti u vašem radnom procesu, posebno ako ste početnik u Delta Lake. Zašto jednostavno ne dopustiti shemi da se promijeni kako treba da mogu zapisati svoj DataFrame, bez obzira na sve?
Kao što stara poslovica kaže, 'unca prevencije vrijedi kilograma liječenja'. U nekom trenutku, ako se ne pobrinete za primjenu svoje sheme, problemi s kompatibilnošću tipova podataka izbiti će na vidjelo - naizgled homogeni izvori sirovih podataka mogu sadržavati rubne slučajeve, oštećene stupce, pogrešno oblikovane prikaze ili druge zastrašujuće stvari koje vas proganjaju u noćnim morama. Najbolji pristup je zaustaviti te neprijatelje na vratima - pomoću prisilne primjene sheme - i suočiti se s njima na svjetlu, a ne kasnije, kada počnu premetati u mračnim dubinama vašeg radnog koda.
Obavezna primjena sheme osigurava da se shema vaše tablice ne mijenja, osim ako sami ne potvrdite da želite promjenu. Ovo sprječava 'razvodnjavanje' podataka koje se može dogoditi kada se novi stupci dodaju tako često da ranije vrijedne, sažete tablice gube svoju važnost i korisnost uslijed preplavljivanja podacima. Poticanjem vas na namjernost, postavljanje visoki standarda i očekivanje visoke kvalitete, obavezna primjena sheme radi ono čemu je namijenjena — pomaže vam ostati savjestan, a vašim tablicama znači čiste.
Ako nakon daljnjeg razmatranja odlučite da zapravo treba dodate novi stupac — nema problema, u nastavku je jedinstveni ispravak. Rješenje — evolucija sheme!
Što je evolucija sheme?
Evolucija sheme je funkcija koja omogućuje korisnicima da lako mijenjaju trenutnu shemu tablice u skladu s podacima koji se mijenjaju tijekom vremena. Najčešće se koristi prilikom obavljanja operacije dodavanja ili prepisivanja kako bi se automatski prilagodila shema za uključivanje jednog ili više novih stupaca.
Kako funkcioniše evolucija sheme?
Slijedeći primjer iz prethodnog odjeljka, programeri mogu lako koristiti evoluciju sheme za dodavanje novih stupaca koji su prethodno odbijeni zbog nesukladnosti sa shemom. Evolucija sheme se aktivira dodavanjem .option('mergeSchema', 'true') u vašem Spark timu .write ili .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
Za pregled grafikona izvršite sljedeći Spark SQL upit
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 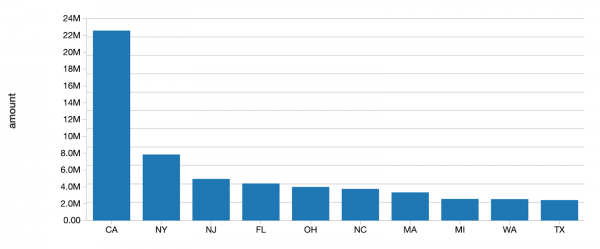
Kao alternativu, ovu opciju možete postaviti za cijelu Spark sesiju dodavanjem spark.databricks.delta.schema.autoMerge = True u konfiguraciju Sparka. Ali budite oprezni što se tiče toga, jer obavezna primjena sheme neće vas više upozoravati na nepredviđene nesukladnosti sa shemom.
Uključivanjem u upit parametra mergeSchema, svi stupci koji su prisutni u DataFrame-u, ali odsutni u ciljnoj tablici, automatski se dodaju na kraj sheme u okviru transakcije zapisivanja. Također se mogu dodati ugniježdene podatke, a oni će također biti dodani na kraj odgovarajućih stupaca strukture.
Inženjeri i znanstvenici mogu koristiti ovu opciju za dodavanje novih stupaca (moguće nedavno praćene metrike ili stupca prodajnih pokazatelja za ovaj mjesec) u svoje postojeće tablice za strojarstvo bez narušavanja postojećih modela temeljenih na starim stupcima.
Sljedeće vrste promjena sheme su dopuštene u okviru evolucije sheme tijekom dodavanja ili prepisivanja tablice:
- Dodavanje novih stupaca (ovo je najčešći scenarij)
- Promjena tipova podataka iz NullType -> bilo koju drugu vrstu ili unapređenje iz ByteType -> ShortType -> IntegerType
Ostale promjene, koje nisu dopuštene u okviru evolucije sheme, zahtijevaju da shema i podaci budu ponovno napisani dodavanjem .option("overwriteSchema", "true"). Na primjer, u slučaju da je stupac "Foo" izvorno bio integer, a nova shema bi bila tipa string, tada bi svi Parquet datoteke (podaci) morali biti ponovno zapisani. Takve promjene uključuju:
- uklanjanje stupca
- promjenu tipa podataka postojećeg stupca (na mjestu)
- preimenovanje stupaca koji se razlikuju samo po velikim i malim slovima (primjerice, "Foo" i "foo")
Na kraju, s sljedećim izdanjem Spark 3.0 bit će potpuno podržan eksplicitan DDL (koristeći ALTER TABLE), što će korisnicima omogućiti sljedeće radnje nad shemama tablica:
- dodavanje stupaca
- promjena komentara za stupce
- podešavanje svojstava tablice koja definiraju ponašanje tablice, na primjer, postavljanje trajanja skladištenja dnevnika transakcija.
Koja je korist evolucije sheme?
Evoluciju sheme možete koristiti uvijek kada namjeravate promijeniti shemu svoje tablice (za razliku od situacija kada ste slučajno dodali stupce u svoj DataFrame koji ne bi trebali biti tamo). Ovo je najlakši način za migraciju vaše sheme, jer automatski dodaje ispravna imena stupaca i tipove podataka bez potrebe za njihovim eksplicitnim izjavama.
Zaključak
Obvezno primjenjivanje sheme odbacuje sve nove stupce ili druge promjene sheme koje nisu kompatibilne s vašom tablicom. Postavljajući i održavajući ove visoke standarde, analitičari i inženjeri mogu se osloniti na to da njihovi podaci imaju najviši nivo integriteta, raspravljajući o tome jasno i precizno, što im omogućuje donošenje učinkovitijih poslovnih odluka.
S druge strane, evolucija sheme dopunjuje obvezno primjenjivanje, pojednostavljujući pretpostavljene automatske promjene sheme. Na kraju, to ne bi trebao biti složen proces — dodati stupac.
Obvezno primjenjivanje sheme je yang, dok je evolucija sheme yin. U kombinaciji, ove funkcije nikada nisu bile jednostavnije za suzbijanje šuma i podešavanje signala.
Također bismo željeli zahvaliti Mukulu Murti i Pranavu Anandu na njihovom doprinosu ovom članku.
Drugi članci iz ove serije:
Članci na temu
Izvor: habr.com
