

U Citymobilu koristimo MySQL bazu podataka kao glavno spremište trajnih podataka. Imamo nekoliko klastera baza podataka za različite usluge i ciljeve.
Stalna dostupnost glavnog čvora je kritična mjera funkcionalnosti cijelog sustava i njegovih dijelova. Automatsko obnavljanje klastera u slučaju kvara glavnog čvora značajno smanjuje vrijeme reakcije na incidente i vrijeme zastoja sustava. U ovom članku ću razmotriti shemu osiguravanja visoke dostupnosti (HA) MySQL klastera temeljenog na i virtualnim IP adresama (VIP).
HA-rješenje temeljeno na VIP
Prvo ću ukratko objasniti što predstavlja naš sustav pohrane podataka.
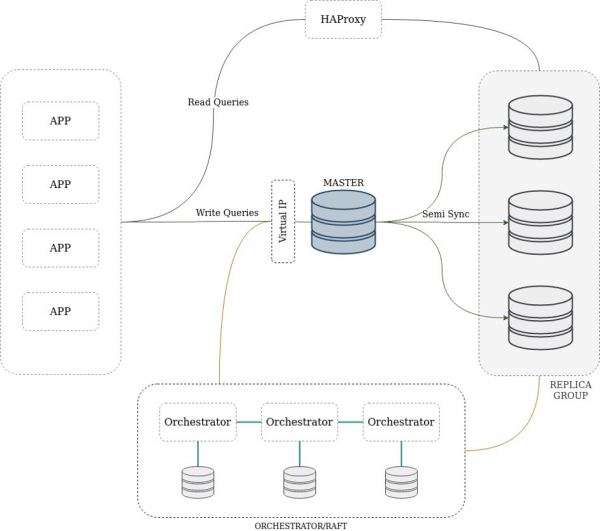
Koristimo klasičnu shemu replikacije s jednim glavnim čvorom koji ima pravo pisanja i brojnim replikama koje se koriste isključivo za čitanje. Klaster može sadržavati međunavodni glavni čvor — čvor koji je istovremeno i replika i glavni za druge. Klijenti se obraćaju replikama putem HAProxy-a, što omogućava ravnomjerno raspoređivanje opterećenja i lako skaliranje. Korištenje HAProxy-a ima povijesne razloga i trenutno smo u procesu migracije na ProxySQL.
Replikacija se izvodi u polusinkronom režimu na temelju GTID. To znači da najmanje jedna replika mora zabilježiti transakciju u dnevnik prije nego što bude priznata kao uspješna. Ovaj režim replikacije osigurava optimalnu ravnotežu između performansi i očuvanja podataka u slučaju kvara glavnog čvora. Uglavnom, sve promjene se prenose od glavnog čvora do replika pomoću Row Based Replication (RBR), ali dio čvorova može imati mixed binlog format.
Orkestrator povremeno ažurira stanje topologije klastera, analizira dobivene informacije i u slučaju problema može pokrenuti proceduru automatskog obnavljanja. Samu proceduru provodi developer, budući da se može provesti na različite načine: na temelju VIP, DNS-a, korištenjem usluga otkrivanja servisa (service discovery) ili vlastitih mehanizama.
Jedan od jednostavnih načina obnavljanja glavnog čvora u slučaju kvara je korištenje plovnih VIP-adresa.
Što trebate znati o ovom rješenju prije nego što nastavite:
- VIP je IP adresa koja nije vezana za određeni fizički mrežni sučelje. Kada dođe do kvara čvora ili planiranih radova, možemo prebaciti VIP na drugi resurs s minimalnim vremenom zastoja.
- Oslobađanje i dodjela virtualne IP adrese su jeftine i brze operacije.
- Za rad s VIP-om potrebna je SSH veza s poslužiteljem ili korištenje posebnih alata, na primjer,
keepalived.
Pogledajmo moguće probleme s našim voditeljem i predstavimo kako bi trebao raditi mehanizam automatskog oporavka.
Izgubljena je mrežna povezanost s voditeljem ili je došlo do problema na razini 'hardvera', i poslužitelj je nedostupan.
- Orkestrator ažurira topologiju klastera, svaki replikant javlja o nedostupnosti voditelja. Orkestrator pokreće proces izbora replikanta koji će postati novi voditelj i započinje oporavak.
- Pokušavamo skinuti VIP s starog voditelja — bezuspješno.
- Replikant prelazi u ulogu voditelja. Topologija se rekonstruiše.
- Dodajemo novo mrežno sučelje s VIP-om. Budući da nismo mogli skinuti VIP, u pozadini pokrećemo periodično slanje zahtjeva gratuitous ARP. Ova vrsta zahtjeva/odgovora omogućava ažuriranje tablice mapiranja IP i MAC adresa na povezanim prelaznicima, čime obavještavamo o preseljenju našeg VIP-a. To minimizira vjerojatnost
split brainprilikom vraćanja starog voditelja. - Sve nove veze odmah se preusmjeravaju na novog voditelja. Stare veze završavaju neuspjehom, ponovni zahtjevi se šalju na razini aplikacije prema bazi podataka.
Poslužitelj radi u normalnom režimu, došlo je do kvara na razini DBMS-a.
Algoritam je sličan prethodnom slučaju: ažuriranje topologije i pokretanje procesa oporavka. Budući da je poslužitelj dostupan, uspješno oslobađamo VIP na starom voditelju, premještamo ga na novi i šaljemo nekoliko ARP zahtjeva. Mogući povratak starog voditelja ne bi trebao utjecati na rekonstrukciju klastera i rad aplikacije.
Ostali problemi
Kvar replikanta ili međupredajnika ne dovodi do automatskih radnji i zahtijeva ručnu intervenciju.
Virtualno mrežno sučelje se uvijek dodaje privremeno, tj. nakon ponovnog pokretanja servera, VIP se automatski ne dodjeljuje. Svaki primjerak DB se prema zadanim postavkama pokreće u načinu samo za čitanje, orkestrator automatski prebacuje novog majstora na zapis i pokušava uspostaviti samo za čitanje na starom majstoru. Ove radnje su usmjerene na smanjenje vjerojatnosti split brain.
Tijekom procesa obnavljanja mogu se pojaviti problemi koji se također trebaju prijaviti putem UI orkestratora, pored standardnih alata za praćenje. Proširili smo REST API dodajući tu mogućnost ( trenutno je na razmatranju).
Opća shema HA rješenja prikazana je u nastavku.
Odabir novog majstora
Orkestrator je dovoljno pametan i pokušava odabrati kao novog majstora prema sljedećim kriterijima:
- zaostatak replikacije od majstora;
- verzija MySQL majstora i replike;
- vrsta replikacije (RBR, SBR ili mixed);
- lokalitet u jednom ili različitim podatkovnim centrima;
- postojanje
errant GTID— transakcije koje su izvršene na replici, a nedostaju na majstoru; - također se uzimaju u obzir korisnička pravila odabira.
Svaka replikacija nije idealan kandidat za ulogu majstora. Na primjer, repliciranje se može koristiti za sigurnosno kopiranje podataka, ili server ima slabiju konfiguraciju 'hardvera'. Orkestrator ručna pravila putem kojih možete postaviti svoje preferencije za odabir kandidata od najpoželjnijih do ignoriranih.
Vrijeme reakcije i obnavljanja
U slučaju incidenta važno je minimizirati vrijeme zastoja sustava, stoga razmatramo parametre MySQL-a koji utječu na izgradnju i ažuriranje topologije klastera od strane orkestratora:
- — broj sekundi, tijekom kojih replikacija čeka dolazak novih podataka ili heartbeat signala od majstora, prije nego što se veza smatra izgubljenom i izvrši se ponovna veza. Što je manja vrijednost, to će brže replikacija moći odrediti da je veza s majstorom prekinuta. Postavljamo ovu vrijednost na 5 sekundi.
- — broj sekundi između pokušaja ponovnog povezivanja. U slučaju mrežnih problema, niska vrijednost ovog parametra omogućit će brzo ponovno povezivanje i spriječiti pokretanje procesa oporavka klastera. Preporučena vrijednost je 1 sekunda.
MASTER_RETRY_COUNT— maksimalni broj pokušaja ponovnog povezivanja.MASTER_HEARTBEAT_PERIOD— interval u sekundama nakon kojeg majstor šalje heartbeat signal. Po defaultu je polovica vrijednostislave_net_timeout.
Parametri orkestratora:
DelayMasterPromotionIfSQLThreadNotUpToDate— ako je postavljeno natrue, uloga majstora neće biti primijenjena na kandidatu za replikaciju dok SQL tok replike ne izvrši sve neprimijenjene transakcije iz Relay Log-a. Ovu opciju koristimo kako bismo spriječili gubitak transakcija u slučaju zastoja svih kandidata za replikaciju.InstancePollSeconds— učestalost izgradnje i ažuriranja topologije.RecoveryPollSeconds— učestalost analize topologije. U slučaju otkrivanja problema pokreće se oporavak topologije. To je, jednaka 1 sekundi.
Svaki čvor klastera se ispituje od strane orkestratora jednom u InstancePollSeconds sekundi. Kada se otkrije problem, stanje klastera se prisilno, a zatim se donosi konačna odluka o provođenju oporavka. Eksperimentiranjem s različitim parametrima Baze podataka i orkestratora, uspjeli smo smanjiti trajanje reagiranja i oporavka na 30 sekundi.
Testni sto
Testiranje HA sheme započeli smo razvojem lokalnog i daljnjim implementacijama u testno i produkcijsko okruženje. Lokalno okruženje je potpuno automatizirano na temelju Dockera i omogućuje eksperimentiranje s konfiguracijom orkestratora i mreže, skaliranje klastera od 2-3 servera do nekoliko desetaka i provođenje vježbi u sigurnom okruženju.
Tijekom vježbi odabiremo jednu od metoda simulacije problema: odmah zaustaviti majstora pomoću kill -9, nježno završiti proces i zaustaviti server (docker-compose stop), simulirati mrežne probleme pomoću iptables -j REJECT ili iptables -j DROP. Očekujemo sljedeće rezultate:
- orkestrator će otkriti probleme s majstorom i ažurirati topologiju u najviše 10 sekundi;
- procedura oporavka automatski će se pokrenuti: promijenit će se mrežna konfiguracija, uloga majstora preći će na replikaciju, topologija će se preurediti;
- novi master bit će dostupan za pisanje, a aktivne replike neće biti izgubljene tijekom rekonstrukcije;
- podaci će početi biti zapisivani u novi master i replicirani;
- ukupno vrijeme oporavka neće prelaziti 30 sekundi.
Kao što znate, sustav se može ponašati različito u testnom i produkcijskom okruženju zbog različite konfiguracije 'hardvera' i mreže, razlika u sintetičkom i stvarnom opterećenju itd. Stoga povremeno provodimo vježbe u stvarnim uvjetima, provjeravajući kako sustav reagira na gubitak mrežne povezanosti ili degradaciju njegovih pojedinačnih dijelova. U budućnosti želimo izgraditi potpuno identičnu infrastrukturu za oba okruženja i automatizirati njezino testiranje.
Zaključci
Funkcionalnost glavnog čvora sustava za pohranu podataka jedan je od glavnih zadataka SRE i operativnog tima. Implementacija orkestratora i HA rješenja temeljenog na VIP-u omogućila je postizanje sljedećih rezultata:
- pouzdano otkrivanje problema s topologijom klastera baze podataka;
- automatsko i brzo reagiranje na incidente vezane uz master, što smanjuje vrijeme zastoja sustava.
Međutim, rješenje ima svoja ograničenja i nedostatke:
- skaliranje HA sheme na nekoliko DC-ova zahtijevat će jedinstvenu L2 mrežu između njih;
- prije nego što dodijelimo VIP na novom masteru, trebamo ga osloboditi na starom. Proces je sekvencijalan, što povećava vrijeme oporavka;
- oslobađanje VIP-a zahtijeva SSH pristup poslužitelju, ili neki drugi način pozivanja udaljenih proceduralnih poziva. Budući da poslužitelj ili baza podataka imaju problema, uzrokovanih procesom oporavka, ne možemo biti sigurni da će otpuštanje VIP-a biti uspješno. To može dovesti do pojave dva poslužitelja s istim virtualnim IP adresom i problema.
split brain.
Da bismo izbjegli split brain, možemo koristiti metodu ('Shoot The Other Node In The Head'), koja potpuno izolira ili isključuje problematični čvor. Postoje i drugi načini implementacije visoke dostupnosti klastera: kombinacija VIP-a i DNS-a, otkrivanje usluga i proxy usluge, sinkrona replikacija i drugi načini, koji imaju svoje nedostatke i prednosti.
Govorio sam o našem pristupu izgradnji otpornog MySQL klastera. On je jednostavan za implementaciju i osigurava odgovarajući nivo pouzdanosti u trenutnim okolnostima. Kako se sistem u cjelini i infrastruktura posebno razvijaju, ovaj pristup će se nesumnjivo razvijati.
Izvor: habr.com
