

Pozdrav, nedavno sam naišao na zanimljiv izazov postaviti skladište za sigurnosnu kopiju velikog broja blokovnih uređaja.
Svake nedjelje izvršavamo sigurnosno kopiranje svih virtualnih strojeva u našoj oblaku, stoga je važno moći upravljati tisućama sigurnosnih kopija i to raditi što brže i učinkovitije.
Nažalost, standardne konfiguracije RAID5, RAID6 u ovom slučaju nam ne odgovaraju zbog toga što će proces oporavka na tako velikim diskovima kao što su naši biti izuzetno dugotrajan i vjerojatno nikada neće završiti.
Razmotrimo koje su alternative:
— Sličan RAID5, RAID6, ali s podesivim razinama paritete. U ovom slučaju, redundancija se ne vrši po blokovima nego za svaki objekt posebno. Najjednostavniji način isprobati erasure coding je rasporediti .
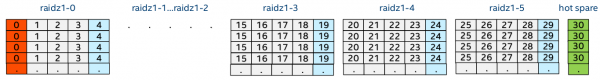
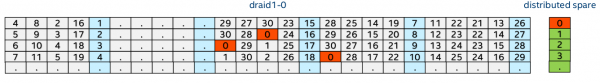
— to je trenutno još uvijek neobjavljena usluga ZFS-a. Za razliku od RAIDZ, DRAID ima distribuirani paritet blok i pri oporavku koristi sve diskove u nizu, čime bolje podnosi kvarove diskova i brže se obnavlja nakon problema.
Imamo poslužitelj Fujitsu Primergy RX300 S7 s procesorom Intel Xeon CPU E5-2650L 0 @ 1.80GHz, devet modula radne memorije Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), diskovni okvir Supermicro SuperChassis 847E26-RJBOD1, povezan putem Dual LSI SAS2X36 Expander i 45 diskova Seagage ST6000NM0115-1YZ110 o 6TB svaki.
Prije nego što donesemo odluku, prvo moramo sve pravilno testirati.
Za to sam se pripremio i proveo testiranje raznih konfiguracija. Koristio sam minio, koji je služio kao S3-backend i pokretao ga u raznim režimima s različitim brojem ciljeva.
Uglavnom se testirao slučaj minio u erasure coding protiv softverskog raida s istim brojem diskova i paritetnih diskova, to jest: RAID6, RAIDZ2 i DRAID2.
Za informaciju: kada pokrenete minio s jednim ciljem, minio funkcioniše u režimu S3-gateway-a, pružajući vaš lokalni datotečni sustav kao S3-skladište. Međutim, ako pokrenete minio s više ciljeva, automatski će se uključiti način Erasure Coding, koji će rasporediti podatke između vaših ciljeva i pružiti otpornost na greške.
Zadano, minio dijeli ciljeve u grupe od 16 diskova, pri čemu svaka grupa ima 2 pariteta. To znači da mogu biti van funkcije dva diska istovremeno bez gubitka podataka.
Za testiranje performansi koristio sam 16 diskova od 6 TB svaki i pisao na njih male objekte veličine 1 MB, što je maksimalno precizno opisivalo naše buduće opterećenje, budući da svi moderni alati za rezervne kopije dijele podatke na blokove od nekoliko megabajta i tako ih pišu.
Za provođenje benchmarka korišten je alat s3bench pokretan na udaljenom serveru koji je slao desetke tisuća takvih objekata minio u stotinu niti. Nakon toga, pokušavao je na isti način zatražiti ih natrag.
Rezultati benchmarka prikazani su u sljedećoj tablici:
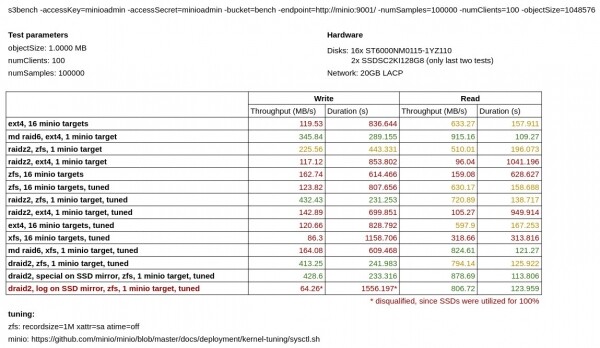
Kao što vidimo, minio u režimu vlastitog erasure codinga radi znatno lošije pri zapisivanju nego minio pokrenut iznad softverskog RAID6, RAIDZ2 i DRAID2 u istoj konfiguraciji.
Odvojeno su me da testiram minio na ext4 vs XFS. Zapanjujuće, ali za moju vrstu opterećenja XFS se pokazao znatno sporijim od ext4.
U prvom krugu testova, Mdadm je pokazao prednost nad ZFS-om, ali kasnije , da se performanse ZFS-a mogu poboljšati postavljanjem sljedećih opcija:
xattr=sa atime=off recordsize=1Mi nakon toga su testovi s ZFS-om postali puno bolji.
Također se može primijetiti da DRAID ne donosi posebnu prednost u performansama u odnosu na RAIDZ, ali bi teoretski trebao biti mnogo sigurniji.
U posljednja dva testa također sam pokušao premjestiti metapodatke (special) i ZIL (log) na ogledalo iz SSD-a. Međutim, premještanje metapodataka nije donijelo posebnu korist u brzini zapisivanja, a kada sam premjestio ZIL, moje su udarili u plafon s 100% iskorištenjem, tako da smatram da je ovaj test neuspješan. Ne isključujem mogućnost da bi, da sam imao brže SSD diskove, to moglo značajno poboljšati moje rezultate, ali, nažalost, nisam ih imao.
Na kraju sam odlučio stati na korištenju DRAID-a, i unatoč svom beta statusu, on je najbrže i najučinkovitije rješenje za pohranu u našem slučaju.
Stvorio sam jednostavan DRAID2 u konfiguraciji s tri grupe i dva distribuirana rezervnog dijela:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Dobro, rješili smo pohranu, sad o tome čime ćemo raditi rezervne kopije. Ovdje odmah želim pričati o tri rješenja koja sam uspio isprobati, a to su:
— fork , specijalizirano rješenje za izradu rezervnih kopija blokovnih uređaja, ima usku integraciju s Ceph-om. Može preuzimati diff-ove između snimaka i formirati iz njih inkrementalnu rezervnu kopiju. Podržava veliki broj backendova za pohranu, uključujući lokalno i S3. Potrebna je posebna baza podataka za pohranu hash-tablice deduplifikacije. Od nedostataka: napisan je na pythonu, ima malo neodgovarajući cli.
— fork , dugo poznato i provjereno sredstvo za izradu rezervnih kopija, može raditi rezervne kopije podataka i dobro ih deduplificirati. Može pohranjivati rezervne kopije i lokalno i na udaljenom poslužitelju putem scp. Može raditi rezervne kopije blokovnih uređaja ako se pokrene s flagom --special, od nedostataka: prilikom izrade rezervne kopije, repozitorij se potpuno blokira, stoga se preporučuje stvaranje odvojenog repozitorija za svaku virtualnu mašinu, što zapravo nije problem, s obzirom na to da se vrlo lako stvaraju.
— aktivno razvijajući projekt, napisan na go, dovoljno brz i podržava velik broj backendova za pohranu, uključujući lokalnu pohranu, scp, S3 i mnoge druge. Posebno valja istaknuti da postoji posebno kreirani za restic, koji omogućuje najbrže izvođenje pohrane za korištenje na daljinu. Od svih navedenih, najviše mi se svidio. Može raditi rezervne kopije iz stdin. Gotovo da nema značajnih nedostataka, ali postoje neke karakteristike:
Prvo, pokušao sam ga koristiti u režimu zajedničkog repozitorija za sve virtualne mašine (poput Benjija) i to je čak dobro funkcioniralo, ali operacije obnavljanja su trajale prilično dugo, jer svaki put, prije obnove, restic pokušava pročitati metapodatke svih rezervnih kopija. Ovaj problem se lako riješio, kao i s borgom, stvaranjem odvojenog repozitorija za svaku virtualnu mašinu. Ovaj pristup se također pokazao vrlo učinkovitim za upravljanje rezervnim kopijama. Odvojeni repozitoriji mogu imati posebnu lozinku za pristup podacima i ne moramo se bojati da bi globalni repo mogao nekako pokvariti. Nova repozitorija može se stvoriti također lako kao i u borg backupu.
U svakom slučaju, deduplikacija se vrši isključivo u odnosu na prethodnu verziju sigurnosne kopije. Prethodna sigurnosna kopija određuje se prema putanji za određenu sigurnosnu kopiju, pa ako pravite sigurnosne kopije različitih objekata iz stdin u zajednički repozitorij, ne zaboravite navesti opciju
--stdin-filename, ili izričito svaki put navesti opciju--parent.
Osim toga, vraćanje u stdout traje znatno duže nego vraćanje na datotečni sustav zbog svoje paralelnosti. U budućnosti je planirano dodati bližu podršku za sigurnosne kopije za blok uređaje.
Treće, trenutno se preporučuje korištenje , budući da verzija 0.9.6 ima grešku sa dugim vraćanjem velikih datoteka.
Kako bismo testirali učinkovitost sigurnosne kopije i brzinu pisanja/vraćanja iz sigurnosne kopije, stvorio sam poseban repozitorij i pokušao napraviti sigurnosnu kopiju male slike virtualne mašine (21 GB). Obavljena su dva sigurnosna kopiranja bez promjena originala, koristeći svako od navedenih rješenja, kako bismo provjerili koliko brže/sporije se kopiraju deduplikovani podaci.
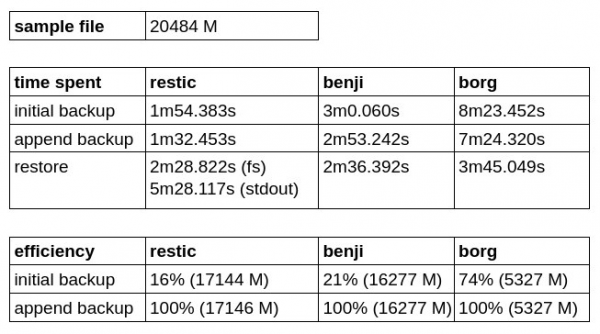
Kao što možemo primijetiti, Borg Backup ima najbolji koeficijent učinkovitosti početne sigurnosne kopije, ali gubi po brzini i pisanja i vraćanja.
Restic se pokazao bržim od Benji Backup, ali duže obnavlja u stdout, a nažalost još ne može pisati izravno u blok uređaj.
Odlučivši sve za i protiv, odlučio sam se za restic s rest-server kao na najprikladnije i perspektivno rješenje za sigurnosnu kopiju.
U ovom screencastu možete vidjeti kako se 10-gigabitna veza potpuno iskorištava prilikom više istovremeno pokrenutih operacija sigurnosne kopije. Važno je napomenuti da opterećenje diskova pritom ne prelazi 30%.
Rezultatom sam više nego zadovoljan!
Izvor: habr.com
