

Prije pola godine — javnu za PostgreSQL.
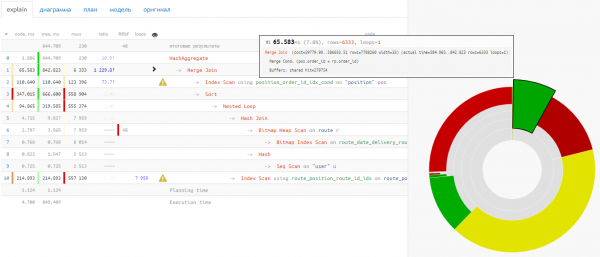
Tijekom proteklih mjeseci napravili smo izvještaj o njemu , pripremili sažetak na temelju preporuka koje on pruža... ali najvažnije je da smo prikupili vaše povratne informacije i pratili stvarne primjere korištenja.
I sada smo spremni pričati o novim mogućnostima koje možete iskoristiti.
Podrška za različite formate planova
Plan iz loga, zajedno s upitom
Iz konzole odabiremo cijeli blok, počinjući s redkom koji sadrži Query Text, s svim vodećim razmacima:
        Query Text: INSERT INTO dicquery_20200604 VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604 (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          -> Result (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
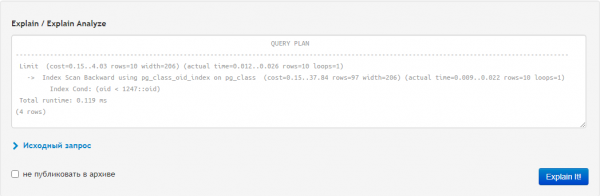
… i zalijemo sve kopirano izravno u polje za plan, ne dijeleći ništa:
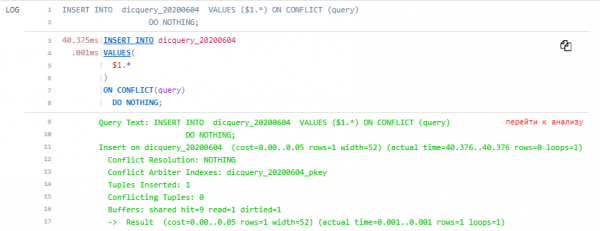
Na izlazu dobivamo bonus uz analizirani plan još i karticu «kontekst», gdje je naš upit predstavljen u svoj svojoj ljepoti:
JSON i YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
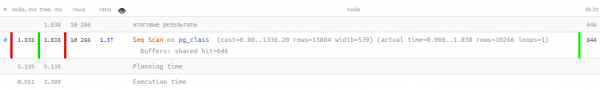
]"Bilo s vanjskim navodnicima, kao što kopira pgAdmin, ili bez njih — sve stavljamo u to isto polje, na izlazu — ljepota:
Proširena vizualizacija
Planning Time / Execution Time
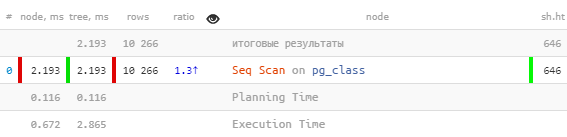
Sada je bolje vidljivo gdje je vrijeme otišlo na dodatne troškove prilikom izvršenja upita:
I/O Timing
Ponekad se dogodi situacija kada na planu izgledom nije bilo previše čitanja i pisanja resursa, a vrijeme izvođenja se čini nerazmjerno velikim.
Tada se mora reći: "Oh, vjerojatno je u tom trenutku disk na serveru bio preopterećen, zato se toliko dugo čitalo!" No, to nije previše točno...
Ali to se može odrediti potpuno pouzdano. Naime, među opcijama konfiguracije PG servera postoji :
Uključuje mjerenje vremena operacija ulaza/izlaza. Ova opcija je prema zadanim postavkama isključena jer zahtijeva stalno traženje trenutnog vremena od operativnog sustava, što može značajno usporiti rad na nekim platformama. Za procjenu troškova mjerenja vremena na vašoj platformi možete koristiti alat pg_test_timing. Statistiku ulaza/izlaza možete dobiti putem prikaza pg_stat_database, u izlazu EXPLAIN (kada se koristi opcija BUFFERS) i putem prikaza pg_stat_statements.
Ova opcija se može uključiti i u okviru lokalne sesije:
SET track_io_timing = TRUE;Sad, najugodnija stvar — naučili smo razumjeti i prikazivati ove podatke uzimajući u obzir sve transformacije stabla izvršenja:
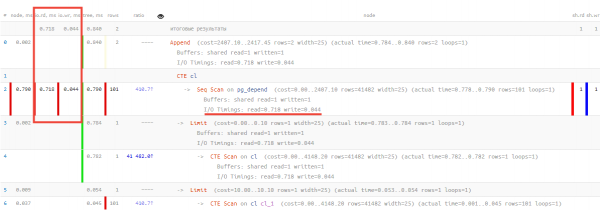
Može se primijetiti da je od 0.790ms ukupnog vremena izvršenja, 0.718ms potrošeno na čitanje jedne stranice podataka, 0.044ms na zapis iste, a svega 0.028ms na cjelokupnu preostalu korisnu aktivnost!
Budućnost s PostgreSQL 13
Potpuni pregled noviteta možete pronaći , a mi se konkretno bavimo promjenama u planovima.
Planiranje bafera
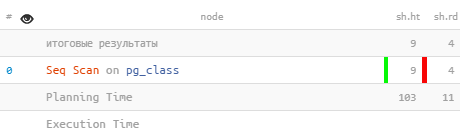
Uzimanje u obzir resursa dodijeljenih planeru, također je odraženo u još jednom patchu, koji nije povezan s pg_stat_statements. EXPLAIN s opcijom BUFFERS izvijestit će o broju bafera koji su korišteni u fazi planiranja:
 Seq Scan on pg_class (actual rows=386 loops=1)
   Buffers: shared hit=9 read=4
 Planning Time: 0.782 ms
   Buffers: shared hit=103 read=11
 Execution Time: 0.219 ms
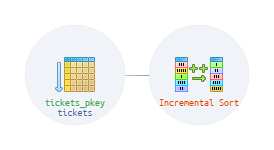
Inkrementalno sortiranje
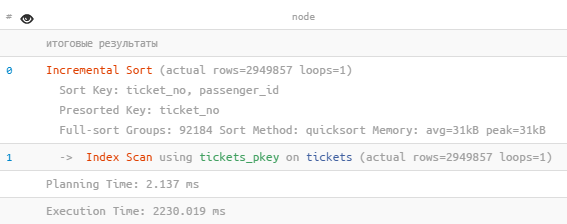
U slučajevima kada je potrebna sortiranost po više ključeva (k1, k2, k3…), planer sada može iskoristiti saznanje da su podaci već sortirani prema nekoliko od prvih ključeva (npr. k1 i k2). U tom slučaju nije potrebno ponovo sortirati sve podatke, već ih je moguće podijeliti u uzastopne grupe s istim vrijednostima k1 i k2 i "dosporedati" prema ključnoj k3.
Na taj način, cjelokupno sortiranje se razlaže na nekoliko uzastopnih sortiranja manjih veličina. To smanjuje potreban kapacitet memorije, a omogućuje i isporuku prvih podataka ranije nego što cjelokupno sortiranje bude u potpunosti završeno.
 Incremental Sort (actual rows=2949857 loops=1)
   Sort Key: ticket_no, passenger_id
   Presorted Key: ticket_no
   Full-sort Groups: 92184 Sort Method: quicksort Memory: avg=31kB peak=31kB
   ->  Index Scan using tickets_pkey on tickets (actual rows=2949857 loops=1)
 Planning Time: 2.137 ms
 Execution Time: 2230.019 ms
Unapređenja UI/UX
Snimke zaslona, svugdje su!
Sada je na svakoj kartici dostupna brza funkcija za uzimanje snimka zaslona kartice u međuspremnik u punoj širini i dubini kartice — „cilj“ desno-gore:
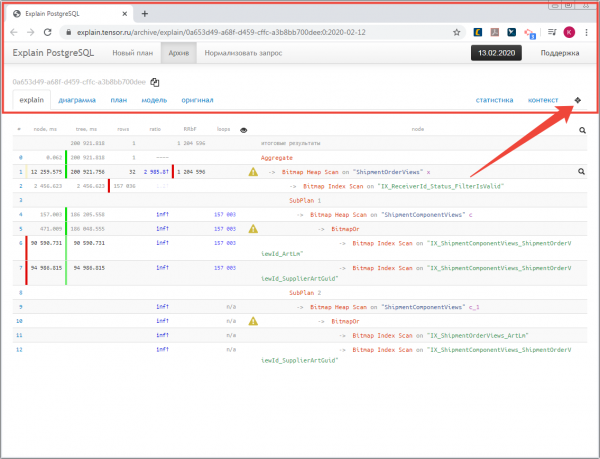
Ustvari, većina slika za ovu objavu dobijena je upravo tako.
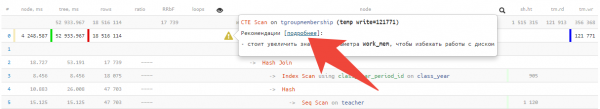
Preporuke na čvorovima
Njih ne samo da je više, već o svakoj možete , prelaskom na link:
Brisanje iz arhiva
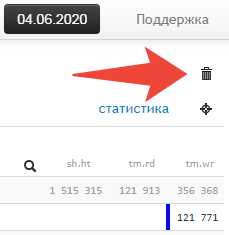
Neki su jako tražili da dodamo mogućnost da se „potpuno“ uklone čak i neobjavljeni planovi u arhivu — molimo, dovoljno je pritisnuti odgovarajuću ikonu:
I, naravno, ne zaboravimo da imamo , gdje možete slati svoja zapažanja i prijedloge.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish