

Godine 2018. u profesionalnim krugovima i na tematskim konferencijama posvećenim AI-u, pojam MLOps je postao popularan, brzo se ustalio u industriji i sada se razvija kao samostalna disciplina. U perspektivi, MLOps bi mogao postati jedno od najtraženijih polja u IT-u. Što je to zapravo i kako ga koristiti, saznajte u nastavku.
Što je MLOps
MLOps (spoj tehnologija i procesa strojnog učenja te pristupa implementaciji razvijenih modela u poslovne procese) predstavlja novi način suradnje između poslovnih predstavnika, znanstvenika, matematičara, stručnjaka za strojno učenje i IT inženjera pri stvaranju sustava umjetne inteligencije.
Drugim riječima, to je način pretvaranja metoda i tehnologija strojnog učenja u korisni alat za rješavanje poslovnih zadataka.
Važno je razumjeti da lanac produktivizacije počinje mnogo prije razvoja modela. Prvi korak se sastoji u definiranju poslovnog zadatka, hipoteze o vrijednosti koju se može izvući iz podataka i poslovne ideje o njenoj primjeni.
Sam pojam MLOps nastao je kao analogija konceptu DevOps primijenjenom na modele i tehnologije strojnog učenja. DevOps je pristup razvoju softvera koji omogućava povećanje brzine implementacije pojedinačnih promjena uz očuvanje fleksibilnosti i pouzdanosti kroz niz metoda, uključujući kontinuirani razvoj, podjelu funkcija na neovisne mikroslužbe, automatizirano testiranje i uvođenje promjena, globalno praćenje operativnosti, sustav brzog reagiranja na otkrivene kvarove i drugo.
DevOps je definirao životni ciklus softvera, a u zajednici stručnjaka pojavila se ideja o korištenju iste metodologije u kontekstu velikih podataka. DataOps je pokušaj prilagodbe i proširenja metodologije uzimajući u obzir karakteristike pohrane, prijenosa i obrade velikih skupova podataka na raznim i međusobno povezanih platformama.
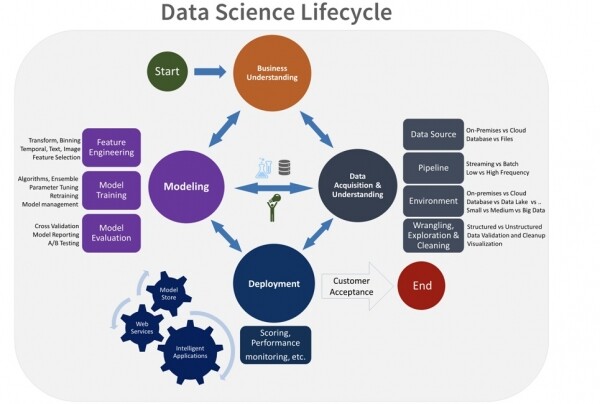
S pojavom određene kritične mase modela strojnog učenja integriranih u poslovne procese poduzeća, primjećeno je snažno sličnost životnog ciklusa matematičkih modela strojnog učenja i životnog ciklusa softvera. Razlika je samo u tome što se algoritmi modela kreiraju pomoću alata i metoda strojnog učenja. Stoga se prirodno pojavila ideja primijeniti i prilagoditi poznate pristupe razvoju softvera za modele strojnog učenja. Tako se u životnom ciklusu modela strojnog učenja mogu izdvojiti sljedeće ključne faze:
- definiranje poslovne ideje;
- obuka modela;
- testiranje i implementacija modela u poslovni proces;
- upotreba modela.
Kada tijekom upotrebe nastane potreba za promjenom ili dodatnom obukom modela na novim podacima, ciklus se ponovno pokreće — model se doradjuje, testira, i deploya nova verzija.
Odstupanje. Zašto dodatno obučiti, a ne ponovo obučiti? Termin „ponovno obučavanje modela“ ima dvostruko značenje: među stručnjacima označava defekt modela, kada model dobro predviđa, zapravo ponavlja predviđeni parametar na obučavajućem skupu, ali mnogo lošije radi na vanjskom skupu podataka. Prirodno, takav model je neispravan, budući da taj defekt ne dopušta njegovu primjenu.
U ovom životnom ciklusu izgleda logičnim koristiti DevOps alate: automatizirano testiranje, implementacija i praćenje, oblikovanje izračuna modela u obliku zasebnih mikroslužbi. No postoje i određene osobitosti koje sprječavaju izravnu primjenu tih alata bez dodatne ML omotnice.
Kako natjerati modele da rade i donose profit
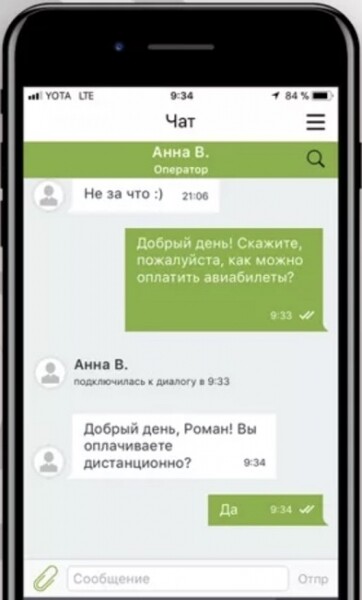
Kao primjer na kojem ćemo demonstrirati primjenu pristupa MLOps, uzet ćemo klasičan zadatak automatizacije chata podrške za bankovni (ili bilo koji drugi) proizvod. Obično, poslovni proces podrške putem chata izgleda ovako: klijent unosi u chat poruku s pitanjem i dobiva odgovor stručnjaka unutar unaprijed definiranog stabla dijaloga. Zadatak automatizacije takvog chata obično se rješava putem skupova pravila koje definira ekspert, što je vrlo zahtjevno za razvoj i održavanje. Učinkovitost takve automatizacije, ovisno o složenosti zadatka, može iznositi 20-30%. Naravno, javlja se ideja da je isplativije uvesti modul umjetne inteligencije — model razvijen uz pomoć strojnog učenja, koji:
- može obraditi veću količinu zahtjeva bez sudjelovanja operatera (ovisno o temi, u nekim slučajevima učinkovitost može doseći 70-80%);
- bolje se prilagođava nekonvencionalnim formulacijama u dijalogu — zna odrediti namjeru, stvarnu želju korisnika prema nejasno oblikovanom zahtjevu;
- može odrediti kada je odgovor modela adekvatan, a kada postoji dvojba o 'svijesti' tog odgovora i treba postaviti dodatno pojašnjenje ili prebaciti se na operatera;
- može se automatizirano dodatno obučiti (umjesto grupe razvijača koja neprekidno prilagođava i ispravlja scenarije odgovora, model dodatno obučava stručnjak za podatke, primjenjujući odgovarajuće biblioteke strojnog učenja).
Kako natjerati takav napredni model da radi?
Kao i pri rješavanju bilo kojeg drugog zadatka, prije nego što započnemo razvoj takvog modula, potrebno je definirati poslovni proces i formalno opisati konkretan problem koji ćemo rješavati primjenom metode strojnog učenja. Na ovoj točki započinje proces operacionalizacije, označen akronimom Ops.
Sljedeći korak je da stručnjak za Data science u suradnji s inženjerom za podatke provjeri dostupnost i dovoljnost podataka te poslovnu hipotezu o izvedivosti poslovne ideje, razvijajući prototip modela i testirajući njegovu stvarnu učinkovitost. Tek nakon potvrde od strane poslovanja može započeti prijelaz od razvoja modela do njegovog integriranja u sustave koji izvršavaju određeni poslovni proces. Sveobuhvatno planiranje implementacije, duboko razumijevanje na svakom koraku kako će se model koristiti i kakav ekonomski učinak će donijeti, predstavlja temeljnu točku u procesima implementacije MLOps u tehnološki pejzaž tvrtke.
S razvojem tehnologije AI, broj i raznolikost zadataka koje je moguće riješiti pomoću strojno učenje rapidno raste. Svaki takav poslovni proces podrazumijeva uštedu za tvrtku kroz automatizaciju rada zaposlenika u masovnim pozicijama (call centri, provjera i sortiranjem dokumenata itd.), proširenje baze klijenata dodavanjem novih privlačnih i praktičnih funkcija, uštedu sredstava kroz optimalnu upotrebu i preraspodjelu resursa i mnogo više. Na kraju, svaki proces usmjeren je na stvaranje vrijednosti i, kao rezultat, trebao bi donijeti određeni ekonomski učinak. Ovdje je vrlo važno jasno formulirati poslovnu ideju i izračunati predviđeni profit od implementacije modela u ukupnom okviru stvaranja vrijednosti tvrtke. Dogoditi će se situacije kada implementacija modela ne opravdava samu sebe, a vrijeme koje su potrošili stručnjaci za strojno učenje puno je skuplje od radnog mjesta operatera koji izvršava taj zadatak. Zato je važno nastojati prepoznati takve slučajeve u ranim fazama izrade AI sustava.
Stoga, profit od modela počinju donositi samo kada je u procesu MLOps pravilno definirana poslovna zadaća, postavljeni prioriteti i u ranim fazama razvoja formuliran proces implementacije modela u sustav.
Novi proces - novi izazovi
Sveobuhvatan odgovor na ključno poslovno pitanje koliko su ML modeli primjenjivi za rješavanje problema, općenito pitanje povjerenja u AI — jedno je od glavnih izazova u razvoju i implementaciji MLOps pristupa. Prvotno, poduzeća skeptično gledaju na implementaciju strojnog učenja u procese — teško je osloniti se na modele na mjestima gdje su ranije obično radili ljudi. Za poduzeće programi se prikazuju kao „crna kutija”, čija relevantnost odgovora još treba biti dokazana. Osim toga, u bankarstvu i u poslovanju telekomunikacijskih operatera postoje strogi zahtjevi državnih regulativa. Sve sustave i algoritme koji su implementirani u bankarske procese podvrgavaju reviziji. Da bi se riješio ovaj problem, dokazao poduzećima i regulatorima opravdanost i ispravnost odgovora umjetne inteligencije, uz model se implementiraju alati za nadzor. Također, postoji postupak neovisne validacije, obavezan za regulatorne modele, koji zadovoljava zahtjeve CB-a. Neovisna stručna skupina provodi reviziju rezultata koje je model generirao uzimajući u obzir ulazne podatke.
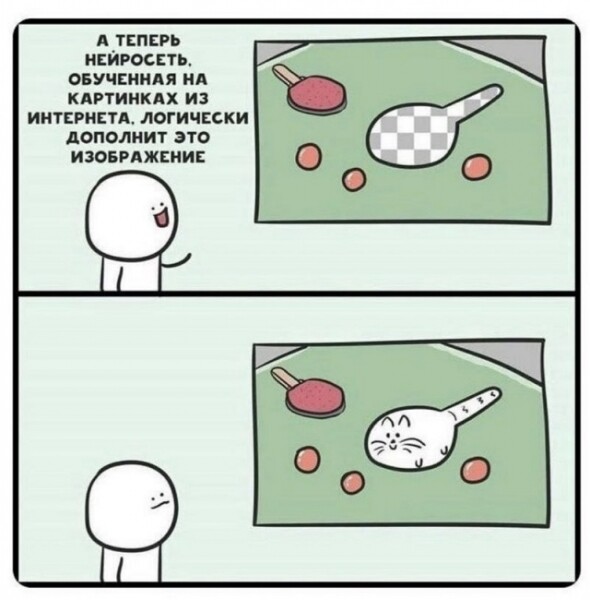
Drugi izazov — procjena i uzimanje u obzir rizika modele prilikom implementacije modela strojnog učenja. Ako čak ni čovjek ne može s potpunom sigurnošću odgovoriti na pitanje je li haljina bila bijela ili plava, tada umjetna inteligencija također ima pravo na pogrešku. Također, treba uzeti u obzir da se podaci tijekom vremena mogu mijenjati, te modeli zahtijevaju dodatno učenje kako bi davali dovoljno točne rezultate. Da poslovni proces ne bi bio ugrožen, potrebno je upravljati rizicima modela i pratiti rad modela, redovito ga dodatno učeći na novim podacima.
No nakon prve faze nepovjerenja, počinje se manifestirati obratni učinak. Što više modela uspješno se implementira u procese, to više poduzećima raste apetiti za korištenjem umjetne inteligencije — pojavljuju se nove i nove zadaće koje se mogu riješiti metodama strojnog učenja. Svaka zadaća pokreće čitav proces, koji zahtijeva različite kompetencije:
- data inženjeri pripremaju i obrađuju podatke;
- data znanstvenici primjenjuju alate strojnog učenja i razvijaju model;
- IT implementira model u sustav;
- ML inženjer određuje kako ispravno integrirati taj model u proces, koji IT alati koristiti ovisno o zahtjevima za načinom primjene modela, uzimajući u obzir tok zahtjeva, vrijeme odgovora itd.
- ML arhitekt dizajnira kako fizički realizirati softverski proizvod u industrijskom sustavu.
Cijeli ciklus zahtijeva veliki broj visoko kvalificiranih stručnjaka. U određenoj točki razvoja i stupnja penetracije ML modela u poslovne procese pokazuje se da linearno skaliranje broja stručnjaka proporcionalno rastu broja zadataka postaje skupo i neučinkovito. Stoga se postavlja pitanje automatizacije procesa MLOps – definiranje nekoliko standardnih klasa zadataka strojog učenja, razvoj tipičnih pipelineova za obradu podataka i nadogradnju modela. U idealnoj slika za rješavanje takvih zadataka potrebni su profesionalci koji jednako dobro ovladavaju kompetencijama na sjecištu BigData, Data Science, DevOps i IT. Stoga je najveći problem u industriji Data Science i najveći izazov u organizaciji procesa MLOps – nedostatak takve kompetencije na postojećem tržištu rada. Stručnjaci koji ispunjavaju takve zahtjeve trenutno su rijetki na tržištu rada i cijene se kao zlato.
Pitanje kompetencija
U teoriji se svi MLOps zadaci mogu rješavati klasičnim DevOps alatima bez pribjegavanja specijaliziranom proširenju uloge modela. No, kao što smo već spomenuli, data scientist mora biti ne samo matematičar i stručnjak za analizu podataka, već i guru cijelog pipelinea – na njegovim je leđima razvoj arhitekture, programiranje modela na nekoliko jezika ovisno o arhitekturi, priprema prednje strane podataka i implementacija same aplikacije. Međutim, stvaranje tehnološke poveznice koja se ostvaruje u vremenskom procesu MLOps oduzima do 80% radnog vremena, a to znači da kvalificirani matematičar, koji je kvalitetan Data Scientist, provodi samo 20% svog vremena u svojoj struci. Stoga razdvajanje uloga stručnjaka koji provode proces implementacije modela strojog učenja postaje od vitalne važnosti.
Koliko detaljno treba razdvojiti uloge, ovisi o veličini poduzeća. Jedna je stvar kada u startupu radi jedan stručnjak, radnik na energiju, koji je sam sebi inženjer, arhitekt i DevOps. Sasvim je druga stvar kada je u velikom poduzeću sve procese razvoja modela koncentrirano na nekoliko visoko kvalificiranih Data Science stručnjaka, dok programer ili stručnjak za baze podataka — više je rasprostranjena i manje skupa kompetencija na tržištu rada — može preuzeti veći dio rutinskih zadataka.
Dakle, od toga gdje prolazi granica u izboru stručnjaka za osiguranje procesa MLOps i kako je organiziran proces operacionalizacije razvijenih modela, izravno ovisi brzina i kvaliteta razvijenih modela, produktivnost tima i mikroklima unutar njega.
Što je već sada učinjeno od naše strane
Nedavno smo počeli graditi strukturu kompetencija i procese MLOps. No već sada su u fazi testiranja MVP naši projekti za upravljanje životnim ciklusom modela i primjenom modela kao usluga.
Također smo odredili optimalnu strukturu kompetencija za velika poduzeća i organizacijsku strukturu suradnje među svim sudionicima procesa. Organizirani su Agile timovi koji rješavaju zadatke za cijeli spektar poslovnih naručitelja, a uspostavljen je i proces suradnje s projektnim timovima za izradu platformi, infrastrukture koja je temelj rastezanja MLOps.
Pitanja za budućnost
MLOps — razvijajuća se disciplina koja pati od nedostatka kompetencija i u budućnosti će dobiti zamah. A za sada je najbolje osloniti se na dosadašnje radove i prakse DevOps-a. Glavni cilj MLOps-a je učinkovitije korištenje ML modela za rješavanje poslovnih zadataka. No, pritom se postavlja niz pitanja:
- Kako skratiti vrijeme potrebno za puštanje modela u proizvodnju?
- Kako smanjiti birokratske trenje između timova različitih kompetencija i povećati usmjerenost na suradnju?
- Kako pratiti modele, upravljati verzijama i organizirati učinkovito praćenje?
- Kako stvoriti zaista ciklični životni ciklus za suvremeni ML model?
- Kako standardizirati proces strojno učenje?
Od odgovora na ova pitanja u velikoj mjeri će ovisiti koliko brzo će MLOps otkriti svoj puni potencijal.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish