

Poštovani čitatelji, dobar dan!
Izgradnja IT platformi za prikupljanje i analizu podataka рано ili поздно postaje izazov za svaku kompaniju čiji je poslovni model zasnovan na intelektualno zahtjevnim uslugama ili stvaranju tehnički složenih proizvoda. Izgradnja analitičkih platformi je složen i radno intenzivan zadatak. Međutim, svaki problem se može pojednostaviti. U ovom članku želim podijeliti iskustvo korištenja low-code alata koji pomažu u stvaranju analitičkih rješenja. Ovo iskustvo stečeno je realizacijom niza projekata unutar Big Data Solutions odjela kompanije „Neoflex“. Big Data Solutions odjel kompanije „Neoflex” se od 2005. godine bavi pitanjima izgradnje skladišta i jezera podataka, rješava probleme optimizacije brzine obrade informacija i radi na metodologiji upravljanja kvalitetom podataka.
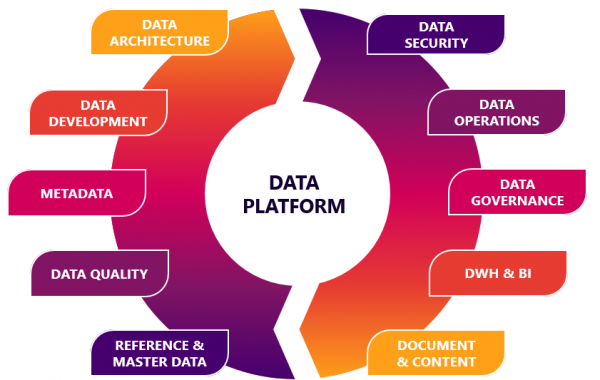
Niko ne može izbjeći svjesno prikupljanje slabih i/ili jakih strukturiranih podataka. Čak ni mali biznis. Kada dođe do skaliranja biznisa, perspektivni poduzetnik će se suočiti s pitanjima razvoja programa lojalnosti, željet će proanalizirati učinkovitost prodajnih mjesta, razmišljat će o ciljanom oglašavanju i razmišljat će o potražnji za pratećim proizvodima. U prvom pristupu problem se može riješiti „na koljenima“. No, s rastom biznisa, dolazak na analitičku platformu postaje neizbježan.
Ali kada se problemi analize podataka mogu pretvoriti u zadatke klase „Rocket Science”? Možda u trenutku kada se radi o stvarno velikim podacima.
Da biste pojednostavili zadatak „Rocket Science”, možete jesti slona po dijelovima.
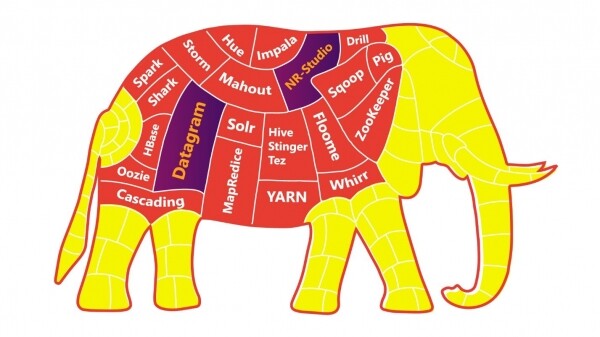
Što su veća diskretnost i autonomnost vaših aplikacija/usluga/mikroservisa, to će vama, vašim kolegama i cijelom biznisu biti lakše probaviti slona.
Do ovog su postulata došli gotovo svi naši klijenti, preoblikovajući krajolik na temelju inženjerskih praksi DevOps timova.
Ali čak i uz „odvojenu, slonovsku” dijetu imamo dobre šanse za „preopterećenje” IT krajolika. U ovom trenutku vrijedi stati, duboko udahnuti i pogledati prema low-code engineering platform.
Mnogi developeri se boje mogućnosti da zapadnu u karijerni zastoj kada pređu s direktnog kodiranja na "prevlačenje" elemenata u UI sučeljima low-code sistema. Međutim, pojava mašina nije dovela do nestanka inženjera, već je podigla njihov rad na novi nivo!
Hajde da istražimo zašto.
Analiza podataka u oblasti logistike, telekomunikacijske industrije, u medijskim istraživanjima, u finansijskom sektoru, uvek je povezana sa sledećim pitanjima:
- Brzina sprovođenja automatizovane analize;
- Mogućnost sprovođenja eksperimenata bez uticaja na osnovni tok proizvodnje podataka;
- Poverljivost pripremljenih podataka;
- Praćenje promena i verzionisanje;
- Data provenance, Data lineage, CDC;
- Brzina isporuke novih funkcionalnosti na produkciono okruženje;
- I prokleta: cena razvoja i podrške.
To jest, inženjeri imaju ogroman broj visok nivoa zadataka, koje je moguće ispuniti sa dovoljno efikasnosti samo ako oslobode svoju svest od nisko nivo razvojnih zadataka.
Osnovni uzroci prelaska developera na novi nivo su evolucija i digitalizacija poslovanja. Vrednost developera se takođe menja: postoji značajan nedostatak developera koji mogu zaroniti u suštinu koncepta automatizovanog poslovanja.
Hajde da napravimo analoški sa nisko i visok nivo programskim jezicima. Prelazak s nisko nivo jezika ka visok nivo je prelazak od pisanja "direktiva na jeziku hardvera" ka "direktivama na jeziku ljudi". To jest, dodavanje nekog sloja apstrakcije. U tom slučaju, prelazak na low-code platforme sa visok nivo programskih jezika je prelazak od "direktiva na jeziku ljudi" ka "direktivama na jeziku poslovanja". Ako se nađu developeri kojih će ovaj čin rastužiti, tada su možda tužniji još od trenutka kada je JavaScript postao popularan, gde se koriste funkcije za sortiranje nizova. I te funkcije, naravno, imaju pod haubom softversku implementaciju drugim sredstvima tog istog visokog nivo programiranja.
Stoga, low-code je samo pojava još jednog nivoa apstrakcije.
Praktično iskustvo korišćenja low-code
Tema low-code je dovoljno široka, ali bih sada želeo govoriti o praktičnoj primeni 'malokodnih koncepata' na primeru jednog od naših projekata.
Odjeljenje Big Data Solutions kompanije 'Neoflex' se u najvećoj meri specijalizuje za finansijski sektor, gradeći skladišta i jezera podataka i automatizujući razne izveštaje. U ovoj niši primena low-code-a odavno je postala standard. Među drugim low-code alatima može se pomenuti sredstva za organizaciju ETL procesa: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Takođe, Oracle Apex, koji služi kao okruženje za brzu izradu interfejsa za pristup i uređivanje podataka. Međutim, primena malokodnih alata za razvoj nije uvek povezana sa izgradnjom specifičnih aplikacija na komercijalnom tehnološkom skupu sa jasno izraženom zavisnošću od dobavljača.
Uz pomoć low-code platformi također se mogu organizovati orkestracije tokova podataka, kreirati data-science platforme ili, na primer, moduli za proveru kvaliteta podataka.
Jedan od praktičnih primera korišćenja malokodnih alata za razvoj je saradnja 'Neoflex-a' sa kompanijom Mediascope, jednim od lidera na ruskom tržištu istraživanja medija. Jedan od poslovnih ciljeva ove kompanije je proizvodnja podataka, na osnovu kojih oglašivači, internet platforme, televizijske mreže, radio stanice, reklamne agencije i brendovi donose odluke o kupovini reklame i planiraju svoje marketinške komunikacije.
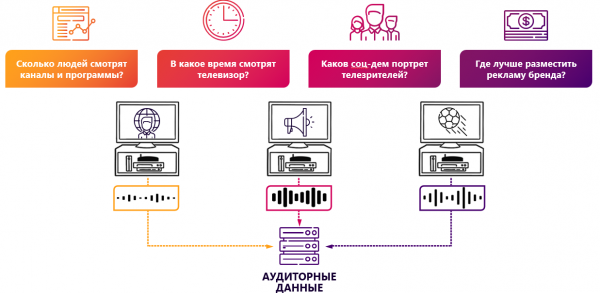
Medijska istraživanja su tehnološki zahtevna oblast poslovanja. Prepoznavanje video sadržaja, prikupljanje podataka sa uređaja koji analiziraju gledanost, merenje aktivnosti na veb resursima - sve to podrazumeva da kompanija ima veliki IT tim i kolosalno iskustvo u izgradnji analitičkih rešenja. Međutim, eksponencijalni rast količine informacija, broja i raznolikosti izvora tera IT industriju podataka na stalni napredak. Najjednostavnije rešenje za skaliranje već funkcionalne analitičke platforme Mediascope moglo bi biti povećanje IT osoblja. No, daleko efikasnije rešenje je ubrzanje procesa razvoja. Jedan od koraka ka ovom cilju može biti primena low-code platformi.
U trenutku pokretanja projekta, tvrtka je već imala funkcionalno proizvodno rješenje. Međutim, implementacija rješenja na MSSQL nije mogla u potpunosti zadovoljiti očekivanja u pogledu skalabilnosti funkcionalnosti uz održavanje prihvatljive cijene dorade.
Zadatak pred nama bio je zaista ambiciozan – 'Neoflex' i Mediascope trebali su stvoriti industrijsko rješenje za manje od godine dana, uz uvjet da MVP izlazi već tijekom prvog kvartala od datuma početka rada.
Kao temelj za izgradnju nove platforme podataka, temeljene na low-code računalstvu, odabran je Hadoop tehnološki skup. Standard za pohranu podataka postao je HDFS uz korištenje datoteka formata parquet. Za pristup podacima unutar platforme korišten je Hive, u kojem su svi dostupni izlozi predstavljeni kao vanjski trenuci. Učitavanje podataka u skladište realizirano je uz pomoć Kafke i Apache NiFi.
Low-code alat u ovoj koncepciji korišten je za optimizaciju najradno intenzivnijeg zadatka u izgradnji analitičke platforme – zadatka izračuna podataka.
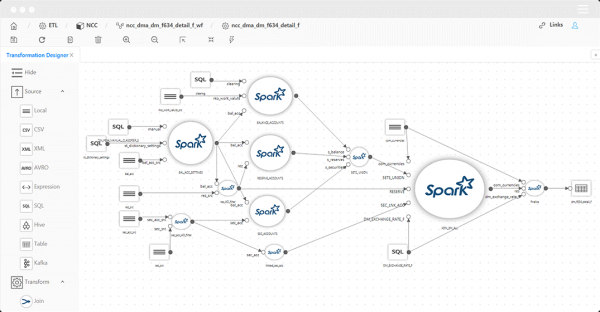
Glavni mehanizam za mapiranje podataka bio je odabran kao low-code alat Datagram. Neoflex Datagram je sredstvo za razvoj transformacija i tokova podataka.
Primjenom ovog alata, moguće je zaobići ručno pisanje koda na Scali. Scala kod se automatski generira korištenjem pristupa Model Driven Architecture.
Očigledna prednost ovakvog pristupa je ubrzanje procesa razvoja. Međutim, osim brzine, postoje i sljedeće prednosti:
- Pregled sadržaja i strukture izvora/prijemnika;
- Praćenje podrijetla objekata toka podataka do pojedinih polja (lineage);
- Djelomično izvršavanje transformacija s pregledom međurezultata;
- Pregled izvorne koda i njegova korekcija prije izvršenja;
- Automatska validacija transformacija;
- Automatsko učitavanje podataka 1 na 1.
Prag ulaska u low-code rješenja za generiranje transformacija je prilično nizak: programer treba znati SQL i imati iskustva s ETL alatima. Treba napomenuti da generatori transformacija vođeni kodom nisu ETL alati u širokom smislu te riječi. Low-code alati možda nemaju vlastito okruženje za izvršavanje koda. To znači da će generirani kod biti izvršen u onom okruženju koje je već postojalo na klasteru prije instalacije low-code rješenja. I to je, možda, još jedna prednost za low-code. Naime, paralelno s low-code timom može raditi „klasični“ tim koji implementira funkcionalnost, na primjer, u čistom Scala kodu. Uvođenje izmjena od strane oba tima u produkciju će biti jednostavno i „besprijekorno“.
Možda bi trebalo napomenuti da uz low-code postoje i no-code rješenja. I suštinski, to su različite stvari. Low-code u većoj mjeri omogućava programeru da intervenira u generirani kod. U slučaju Datagram može se pregledati i uređivati generirani Scala kod, dok no-code možda neće pružiti tu mogućnost. Ova razlika je značajna ne samo u pogledu fleksibilnosti rješenja, već i u pogledu udobnosti i motivacije rada data inženjera.
Arhitektura rješenja
Pokušajmo razumjeti kako točno low-code alat pomaže u rješavanju problema optimizacije brzine razvoja funkcionalnosti za izračun podataka. Prvo ćemo razmotriti funkcionalnu arhitekturu sustava. U ovom slučaju, primjer predstavlja model proizvodnje podataka za medijska istraživanja.
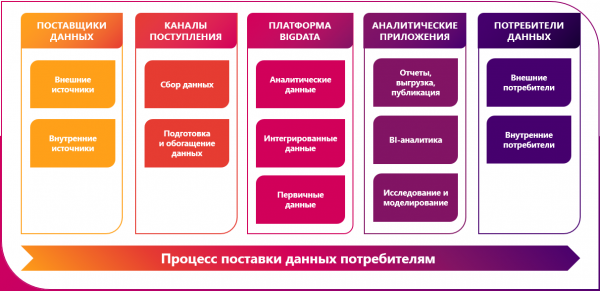
Izvori podataka u našem slučaju su prilično raznoliki i raznovrsni:
- Peoplemeters (TV meters) are software and hardware devices that read user behavior from respondents of a television panel - who, when, and which TV channel was watched in the household participating in the study. The information provided is a stream of viewing intervals linked to the media package and media product. The data at the stage of loading into the Data Lake can be enriched with demographic attributes, geographical ties, time zones, and other information necessary for analyzing the viewership of a specific media product. The measurements taken can be used for analysis or planning of advertising campaigns, assessing audience activity and preferences, and creating broadcast schedules.
- Data can come from monitoring systems of streaming television and measuring content viewership on online video resources.
- Measuring tools in the web environment, including both site-centric and user-centric counters. A research bar browser extension and a mobile application with built-in features can serve as data providers for the Data Lake. VPN.
- Data can also be sourced from platforms that consolidate the results of online surveys and outcomes of telephone interviews in the company's survey research.
- Additional enrichment of the data lake can occur by uploading information from the logs of partner companies.
The implementation of as-is loading from source systems into the primary staging of raw data can be organized in various ways. When using low-code for this purpose, automatic generation of loading scripts based on metadata is possible. In this case, it is not necessary to delve into the development of source-to-target mappings. To implement automatic loading, we need to establish a connection with the source, after which we determine in the loading interface the list of entities to be loaded. The creation of directory structures in HDFS will occur automatically and correspond to the data storage structure in the source system.
However, in the context of this project, we decided not to use this low-code platform capability because the company Mediascope has already independently begun working on creating a similar service using the Nifi + Kafka combination.
Odmah je potrebno naglasiti da su ovi alati ne međusobno zamjenjivi, već su više komplementarni. Nifi i Kafka mogu raditi kako u izravnoj (Nifi -> Kafka), tako i u obrnutoj (Kafka -> Nifi) vezi. Za platformu medijskih istraživanja korištena je prva varijanta veze.
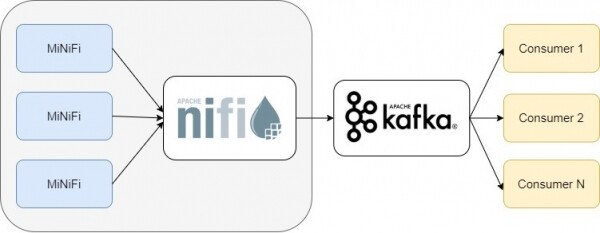
U našem slučaju, Nifi je trebao obrađivati različite vrste podataka iz izvora i slati ih brokeru Kafka. U tom procesu usmjeravanje poruka u određenu Kafka temu vrši se korištenjem Nifi procesora PublishKafka. Orkestracija i održavanje ovih pipelineova odvijaju se u vizualnom sučelju. Alat Nifi i korištenje kombinacije Nifi + Kafka također se može nazvati low-code pristupom razvoju, s niskim pragom ulaska u tehnologije Big Data i ubrzavajući proces razvoja aplikacija.
Sljedeća faza u realizaciji projekta bila je usklađivanje sa formatom jedinstvenog semantičkog sloja detaljnih podataka. U slučaju da entitet ima povijesne atribute, izračun se izvodi u kontekstu razmatrane particije. Ako entitet nije povijesni, opcionalno je moguć ili ponovni izračun cijelog sadržaja objekta, ili potpuno odbijanje ponovnog izračuna tog objekta (uslijed nedostatka promjena). U ovoj fazi generiraju se ključevi za sve entitete. Ključevi se pohranjuju u odgovarajuće master-objekte referentne HBase, koje sadrže usklađenost između ključeva u analitičkoj platformi i ključeva iz izvora. Konsolidacija atomarnih entiteta prati se obogaćivanjem rezultatima preliminarnog izračuna analitičkih podataka. Framework za izračun podataka bio je Spark. Opisani funkcionalnost usklađivanja podataka na jedinstvenu semantiku također je implementirana na temelju mapiranja low-code alata Datagram.
U ciljnoj arhitekturi bilo je potrebno osigurati SQL pristup podacima za poslovne korisnike. Za ovu opciju korišten je Hive. Registracija objekata u Hive vrši se automatski prilikom uključivanja opcije 'Registr Hive Table' u low-code alatu.
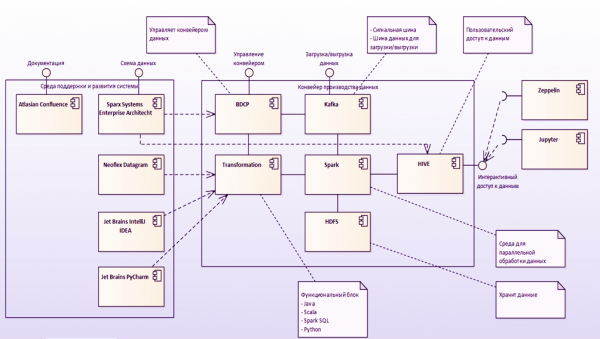
Upravljanje tokom izračuna
Datagram ima sučelje za izradu dizajna radnih tokova. Pokretanje mapiranja može se obaviti pomoću Oozie planera. U sučelju programera radnih tokova moguće je kreirati sheme paralelnog, sekvencijalnog ili uvjetno zavisnog izvršavanja transformacija podataka. Podrška za shell skripte i java programe je dostupna. Također je moguće koristiti poslužitelja Apache Livy. Apache Livy se koristi za pokretanje aplikacija izravno iz razvojnog okruženja.
U slučaju da tvrtka već ima vlastiti orkestrator procesa, moguće je koristiti REST API za ugradnju mapiranja u već postojeći tok. Na primjer, imali smo prilično uspješno iskustvo ugrađivanja mapiranja na Scala-u u orkestratore napisane u PLSQL-u i Kotlinu. REST API low-code alata podrazumijeva prisutnost operacija kao što su generiranje izvršnog objekta na temelju dizajna mapiranja, pozivanje mapiranja, pozivanje sekvencije mapiranja i, naravno, prijenos parametara putem URL-a za pokretanje mapiranja.
Uz Oozie, moguće je organizirati tok izračuna pomoću Airflow-a. Neću se dugo zadržavati na usporedbi Oozie i Airflow-a, već ću reći da je u kontekstu rada na projektu medijskih istraživanja izbor pao na Airflow. Glavni argumenti za ovaj izbor su aktivnija zajednica koja razvija proizvod i naprednije sučelje + API.
Airflow je također dobar jer se za opisivanje procesa izračuna koristi mnogima omiljeni Python. Uopće, platformi za upravljanje radnim tokovima s otvorenim izvorom nema mnogo. Pokretanje i praćenje izvršenja procesa (uključujući Ganttove dijagrame) samo dodaje bodove u korist Airflow-a.
Format konfiguracijske datoteke za pokretanje mapiranja low-code rješenja postao je spark-submit. Do toga je došlo iz dva razloga. Prvo, spark-submit omogućuje izravno pokretanje jar datoteke iz konzole. Drugo, može sadržavati sve potrebne informacije za konfiguraciju radnog toka (što olakšava pisanje skripti koje formiraju Dag).
Najčešće korišteni element radnog toka Airflow u našem slučaju postao je SparkSubmitOperator.
SparkSubmitOperator omogućuje pokretanje jar datoteka — pakiranih mapiranja Datagram s prethodno definiranim ulaznim parametrima.
Važno je napomenuti da se svaki zadatak Airflowa izvršava u posebnoj niti i ništa ne zna o drugim zadacima. Zbog toga se međusobna interakcija između zadataka ostvaruje pomoću kontrolnih operatora, kao što su DummyOperator ili BranchPythonOperator.
Kombinacija korištenja low-code rješenja Datagram uz univerzalizaciju konfiguracijskih datoteka (koje oblikuju Dag) dovela je do značajnog ubrzanja i pojednostavljenja procesa razvoja tokova za učitavanje podataka.
Izračun vitrina
Bez sumnje, najinteligentnije opterećenje u proizvodnji analitičkih podataka je korak u izgradnji vitrina. U kontekstu jednog od tokova izračuna podataka istraživačke tvrtke, u ovoj fazi dolazi do dovodđenja u referentnu transkripciju uzimajući u obzir korekciju vremenskih zona vezano uz mrežu emitiranja. Također je moguće prilagoditi lokalnu etersku mrežu (lokalne vijesti i oglasi). Osim toga, u ovom koraku vrši se analiza intervala neprekidnog gledanja medijskih proizvoda temeljem analize intervala gledanja. Tu se također vrši
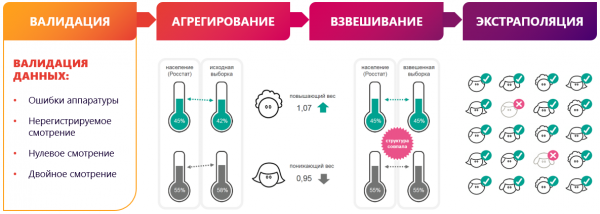
Odvojeni korak pripreme vitrina je validacija podataka. Algoritam validacije povezan je s primjenom niza matematičkih znanstvenih modela. Međutim, korištenje low-code platforme omogućava razbijanje složenog algoritma na niz odvojenih vizualno čitljivih mapiranja. Svako od mapiranja izvršava usku zadaću. Tako se omogućava posredna debagiranje, logiranje i vizualizacija faza pripreme podataka.
Odlučeno je da se algoritam validacije diskretizira na sljedeće podfaze:
- Izgradnja regresija zavisnosti gledanja televizijskih mreža u regiji sa gledanjem svih mreža u regiji u proteklih 60 dana.
- Izračun stjulziranih ostataka (odstupanja stvarnih vrijednosti od predviđenih regresijskim modelom) za sve točke regresije i za proračunski dan.
- Odabir anomalnih parova regija-televizijska mreža, gdje stjulzirani ostatak proračunskog dana premašuje normu (dohvaćenu podešavanjem operacije).
- Prebrojavanje prilagođenog studentiziranog ostatka po anomalnim parovima regija-televizija za svakog ispitanika koji je gledao mrežu u regiji s određenjem doprinosa tog ispitanika (promjena u studentiziranom ostatku) uz isključenje gledanja tog ispitanika iz uzorka.
- Traženje kandidata čije isključenje dovodi studentizirani ostatak obračunskog dana u normu.
Gore navedeni primjer potvrđuje hipotezu da data inženjer uistinu ima previše toga u glavi… I, ako je to zaista "inženjer", a ne "koder", strah od profesionalne degradacije pri korištenju low-code alata trebao bi konačno nestati.
Što još može low-code?
Područje primjene low-code alata za serijsku i streaming obradu podataka bez potrebe za ručnim pisanjem koda na Scali se ne završava ovdje.
Upotreba low-code u razvoju datalakeova za nas je već postala neka vrsta standarda. Vjerojatno se može reći da rješenja na Hadoop stogu ponavljaju put razvoja klasičnih DWH-ova temeljenih na RDBMS-u. Low-code alati na Hadoop stogu mogu rješavati zadatke obrade podataka kao i zadatke izgradnje završnih BI sučelja. Osim toga, treba napomenuti da pod BI može podrazumijevati ne samo prikaz podataka, već i njihovo uređivanje od strane poslovnih korisnika. Ova funkcionalnost se često koristi u izgradnji analitičkih platformi za financijski sektor.
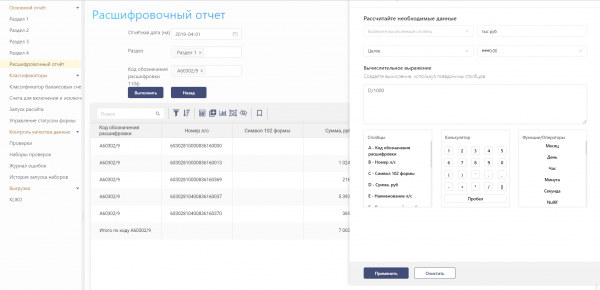
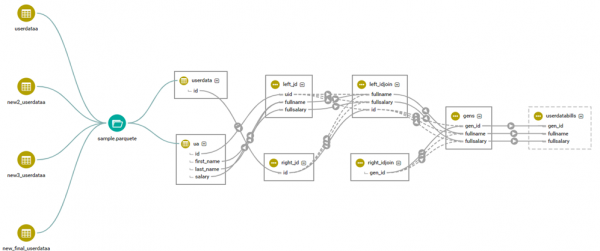
Između ostalog, pomoću low-code-a i, posebno, Datagrama, moguće je riješiti problem praćenja podrijetla objekata toka podataka s atomskom preciznošću do pojedinih polja (lineage). Za to je u alatu za low-code implementirano povezivanje s Apache Atlasom i Cloudera Navigatorom. U suštini, programer mora registrirati skup objekata u rječnicima Atlasa i referencirati registrirane objekte prilikom izrade mapiranja. Mehanizam praćenja podrijetla podataka ili analiza zavisnosti objekata štedi mnogo vremena prilikom potrebnih izmjena u algoritmima kalkulacije. Na primjer, prilikom izrade financijskog izvještavanja, ova značajka omogućava lakše proći kroz razdoblja promjena zakonodavstva. Što bolje razumijemo međufunkcionalne zavisnosti u kontekstu objekata detaljnog sloja, manje ćemo se suočiti s „iznenadnim“ greškama i smanjiti broj revorkova.
Kvaliteta podataka & Low-code
Još jedan zadatak, realiziran low-code alatom na projektu tvrtke Mediascope, bio je zadatak klase Kvaliteta podataka. Osobina realizacije cjevovoda provjere podataka za projekt istraživačke tvrtke bila je odsutnost utjecaja na funkcionalnost i brzinu rada glavnog toka kalkulacije podataka. Za orkestraciju neovisnim tokovima provjere podataka korišten je već poznati Apache Airflow. Dok je svaki korak proizvodnje podataka bio spreman, paralelno se pokretao odvojeni dio DQ cjevovoda.
Dobra praksa je praćenje kvalitete podataka od trenutka njihova nastanka u analitičkoj platformi. Imajući informacije o metapodacima, već od trenutka kada informacije uđu u izvorni sloj možemo provjeriti poštovanje osnovnih uvjeta — not null, constraints, foreign keys. Ova funkcionalnost realizirana je na temelju automatski generiranih mapiranja porodice kvalitete podataka u Datagrama. Kodna generacija u ovom slučaju također se temelji na metapodacima modela. Na projektu tvrtke Mediascope povezivanje se događalo s metapodacima proizvoda Enterprise Architect.
Zbog povezivanja low-code alata i Enterprise Architecta automatski su generirane sljedeće provjere:
- Provjera prisutnosti vrijednosti „null“ na poljima s modifikatorom „not null“;
- Provjera prisutnosti duplikata primarnog ključa;
- Provjera vanjskog ključa entiteta;
- Provjera jedinstvenosti retka prema skupu polja.
Za složenije provjere dostupnosti i vjerodostojnosti podataka stvoren je mapping s Scala Expression, koji prihvaća vanjski Spark SQL kod provjere, pripremljen od strane analitičara u Zeppelin.
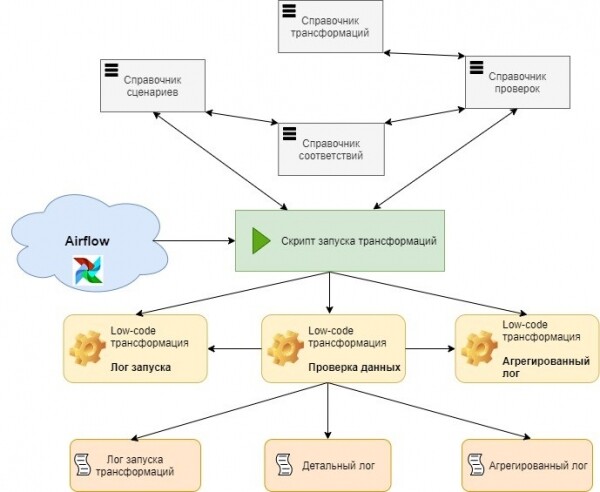
Naravno, automatskoj generaciji provjera treba pristupiti postupno. U okviru opisanog projekta prethodili su sljedeći koraci:
- DQ, realizirani u bilježnicama Zeppelin;
- DQ, ugrađeni u mapping;
- DQ u obliku odvojenih masivnih mappinga, koji sadrže cijeli set provjera za pojedini entitet;
- Univerzalni parametrizirani DQ mappingi, koji prihvaćaju informacije o metapodacima i poslovnim provjerama.
Možda je najveća prednost stvaranja servisa parametriziranih provjera skraćivanje vremena isporuke funkcionalnosti u produkcijsko okruženje. Nove provjere kvalitete mogu zaobići klasični obrazac isporuke koda posredno kroz razvojne i testne okruženja:
- Sve provjere metapodataka automatski se generiraju prilikom promjene modela u EA;
- Provjere dostupnosti podataka (određivanje prisutnosti bilo kakvih podataka u određenom trenutku) mogu se generirati na temelju vodiča koji pohranjuje očekivano vrijeme dolaska sljedeće serije podataka prema objektima;
- Poslovne provjere vjerodostojnosti podataka stvaraju se od strane analitičara u bilježnicama Zeppelin. Odakle se izravno usmjeravaju u konfigiracijske tablice modula DQ u produkcijskom okruženju.
Rizici izravnog otpremanja skripti na produkciju ne postoje. Čak i u slučaju sintaktičke greške, maksimum što nam prijeti je neizvršenje jedne provjere, jer su tokovi izračuna podataka i tokovi pokretanja provjera kvalitete odvojeni.
U suštini, DQ servis stalno je pokrenut u produkcijskom okruženju i spreman je započeti svoj rad u trenutku dolaska sljedeće serije podataka.
Umjesto zaključka
Prednost primjene low-codea je očita. Programerima nije potrebno razvijati aplikaciju «s nule». A oslobođeni dodatnih zadataka programer donosi rezultate brže. Brzina, pak, oslobađa dodatne resurse vremena za rješavanje pitanja optimizacije. Stoga, u ovom slučaju se može očekivati prisutnost kvalitetnijeg i bržeg rješenja.
Naravno, low-code nije panaceja, i čarolija sama po sebi se neće dogoditi:
- Industrija low-codea prolazi kroz fazu „jačanja”, a za sada u njoj nema ujednačenih industrijskih standarda;
- Mnoge low-code solucije nisu besplatne i njihova nabava treba biti promišljen korak, koji bi se trebao poduzeti uz punu sigurnost o financijskoj koristi od njihove primjene;
- Mnoge low-code solucije ne uvijek dobro surađuju s GIT / SVN. Ili su neugodne za korištenje u slučaju skrivanja generiranog koda;
- Pri proširenju arhitekture može biti potrebna dorada low-code rješenja – što, zauzvrat, provodi efekat „vezanosti i ovisnosti” o dobavljaču low-code rješenja.
- Prikladna razina osiguranja sigurnosti je moguća, ali je vrlo radno intenzivna i složena u implementaciji pokretača low-code sustava. Low-code platforme ne bi trebale biti birane samo prema principu traženja koristi od njihove primjene. Prilikom odabira valja postaviti pitanja o postojanju funkcionalnosti upravljanja pristupom i delegiranjem/escalacijom identifikacijskih podataka na razinu cjelokupnog IT pejzaža organizacije.
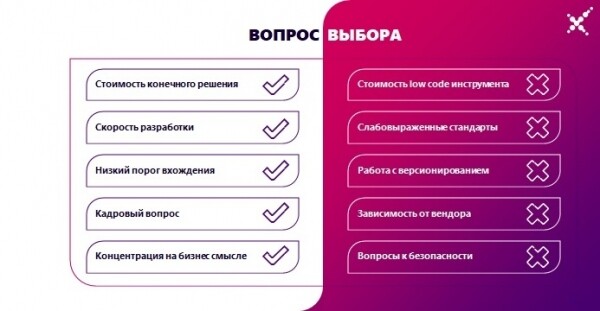
Međutim, ako su vam svi nedostaci odabrane sustava poznati, a koristi od njezina korištenja, unatoč svemu, su dominantne, tada možete prijeći na low-code bez straha. Tim više što je prijelaz na njega neizbježan – kao što je neizbježna svaka evolucija.
Ako jedan programer na low-code platformi može brže obaviti svoj posao nego dva programera bez low-codea, to daje kompaniji prednost u svim aspektima. Prag ulaska u low-code rešenja je niži nego u "tradicionalne" tehnologije, što pozitivno utiče na pitanje nedostatka radne snage. Upotrebom low-code alata može se ubrzati interakcija među funkcionalnim timovima i brže donositi odluke o tačnosti izabranog puta istraživanja u oblasti data-sciencea. Niskokodna platforma može biti uzrok digitalne transformacije organizacije, jer rešenja koja se proizvode mogu biti razumljiva netehničkim stručnjacima (posebno poslovnim korisnicima).
Ako imate skučene rokove, opterećenu poslovnu logiku, nedostatak tehnološke stručnosti, i potrebno vam je ubrzanje vremena za izlazak na tržište, low-code je jedan od načina da zadovoljite svoje potrebe.
Ne treba zanemariti značaj tradicionalnih razvojnih alata, ali u mnogim slučajevima upotreba low-code rešenja je najbolji način da se poveća efikasnost rešenih zadataka.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish