

Tokom godina korištenja Kubernetesa u produkciji, nakupili smo zanimljive priče o tome kako greške u različitim sistemskim komponentama mogu dovesti do neugodnih i/ili nejasnih posljedica koje utječu na rad kontejnera i podova. U ovom članku smo sakupili neke od najčešćih ili zanimljivih slučajeva. Čak i ako se nikada ne susretnete s takvim situacijama, uvijek je zabavno čitati o sličnim kratkim detektivskim pričama, pogotovo "iz prve ruke", zar ne?
Priča 1. Supercronic i zamrznuti Docker
Na jednom od klastera povremeno smo dobijali "zamrznuti" Docker, što je ometalo normalno funkcioniranje klastera. U logovima Dockera primijetili smo sljedeće
level=error msg="containerd: start init process" error="exit status 2: "runtime/cgo: pthread_create failed: No space left on device
SIGABRT: abort
PC=0x7f31b811a428 m=0

goroutine 0 [idle]:

goroutine 1 [running]:
runtime.systemstack_switch() /usr/local/go/src/runtime/asm_amd64.s:252 fp=0xc420026768 sp=0xc420026760
runtime.main() /usr/local/go/src/runtime/proc.go:127 +0x6c fp=0xc4200267c0 sp=0xc420026768
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1 fp=0xc4200267c8 sp=0xc4200267c0

goroutine 17 [syscall, locked to thread]:
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1

…
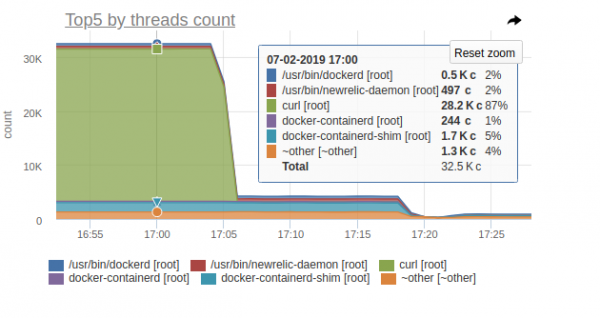
U ovoj grešci najviše nas zanima poruka: pthread_create failed: No space left on device. Površno istraživanje objasnilo je da Docker ne može forkati proces, zbog čega je povremeno "zamrzavao".
U praćenju događaja odgovara takva slika:
Slična situacija može se primijetiti i na drugim čvorovima:
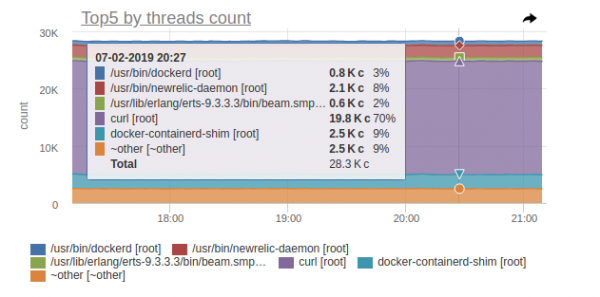
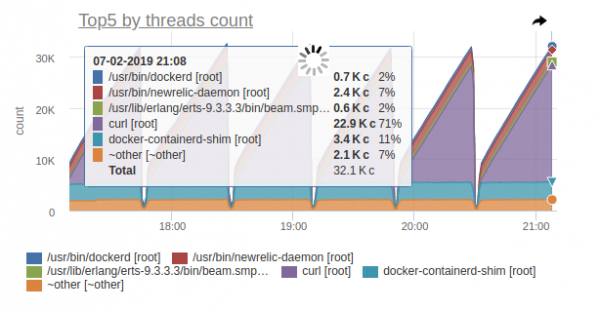
Na tim istim čvorovima vidimo:
root@kube-node-1 ~ # ps auxfww | grep curl -c
19782
root@kube-node-1 ~ # ps auxfww | grep curl | head
root     16688  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     17398  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16852  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      9473  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      4664  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     30571  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     24113  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16475  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      7176  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      1090  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
Ispostavilo se je da je takvo ponašanje posljedica rada poda s (alat na Go-u koji koristimo za pokretanje cron zadataka u podovima):
 _ docker-containerd-shim 833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 /var/run/docker/libcontainerd/833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 docker-runc
|   _ /usr/local/bin/supercronic -json /crontabs/cron
|       _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true
|       |   _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true -no-pidfile
|       _ [newrelic-daemon]
|       _ [curl]
|       _ [curl]
|       _ [curl]
…
Problem je u sljedećem: kada se zadatak pokrene u supercronicu, proces koji on pokreće ne može se ispravno završiti, postajući .
Napomena: Točnije, procesi se stvaraju od cron zadataka, ali supercronic nije init sustav i ne može "posvojiti" procese koje su stvorili njegovi potomci. Kada dođu signali SIGHUP ili SIGTERM, oni se ne prenose kreiranim procesima, zbog čega potomci ne završavaju, ostajući u statusu zombija. O svemu ovome možete pročitati, na primjer, u .
Postoji nekoliko načina za rješavanje problema:
- Kao privremeno rješenje — povećati broj PID-ova u sustavu u jednom trenutku:
/proc/sys/kernel/pid_max (since Linux 2.5.34) This file specifies the value at which PIDs wrap around (i.e., the value in this file is one greater than the maximum PID). PIDs greater than this value are not allo‐ cated; thus, the value in this file also acts as a system-wide limit on the total number of processes and threads. The default value for this file, 32768, results in the same range of PIDs as on earlier kernels - Ili pokrenuti zadatke u supercronicu ne izravno, već pomoću istog , koji može ispravno završiti procese i ne stvarati zombi.
Priča 2. 'Zombiji' prilikom brisanja cgroup
Kubelet je počeo trošiti veliku količinu CPU-a:
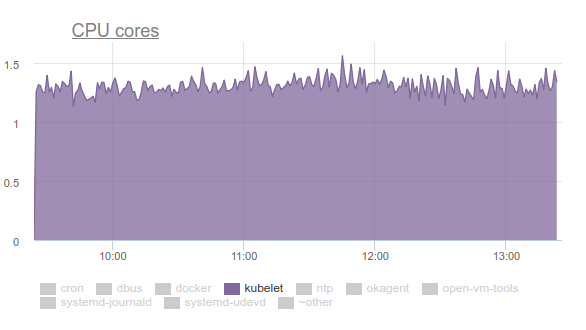
To se nikome neće svidjeti, pa smo se opremili i počeli istraživati problem. Istražna saznanja su pokazala sljedeće:
- Kubelet troši više od trećine procesorskog vremena na dobivanje podataka o memoriji iz svih cgroupova:

- U mailing listi programera jezgre možete pronaći . Ukratko, suština je u tome da razni tmpfs datoteke i slične stvari ne nestaju potpuno iz sustava prilikom brisanja cgroupa — ostaju takozvani zombi. S vremenom će se oni i dalje ukloniti iz page cache-a, međutim, na serveru ima dovoljno memorije i jezgro ne vidi smisao trošenja vremena na njihovo uklanjanje. Stoga se nastavljaju nakupljati. Zašto se to uopće događa? To je server s cron zadacima koji stalno stvara nove job-ove, a s njima — nove pod-ove. Tako se za kontejnere u njima stvaraju nove cgroup, koje ubrzo se brišu.
- Zašto cAdvisor u kubeletu troši toliko vremena? To se lako može vidjeti najjednostavnijim izvršenjem
time cat /sys/fs/cgroup/memory/memory.stat. Ako na zdravom stroju operacija traje 0,01 sekunde, onda na problematičnom cron02 — 1,2 sekunde. Cijela stvar je u tome što cAdvisor, koji vrlo sporo čita podatke iz sysfs, pokušava uzeti u obzir iskorištenu memoriju i u zombie cgroups. - Kako bismo prisilno uklonili zombije, pokušali smo očistiti keševe, kako je preporučeno na LKML-u:
sync; echo 3 > /proc/sys/vm/drop_caches, — ali jezgro se pokazalo složenijim i zamrzlo je stroj.
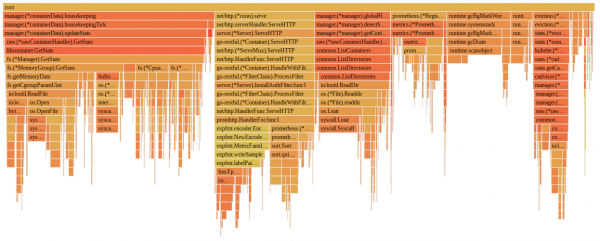
Što učiniti? Problem se ispravlja (, a opis se može naći u ) ažuriranjem Linux jezgra na verziju 4.16.
Povijest 3. Systemd i njegov mount
Ponovno kubelet troši previše resursa na nekim čvorovima, ali ovaj put — već memorije:
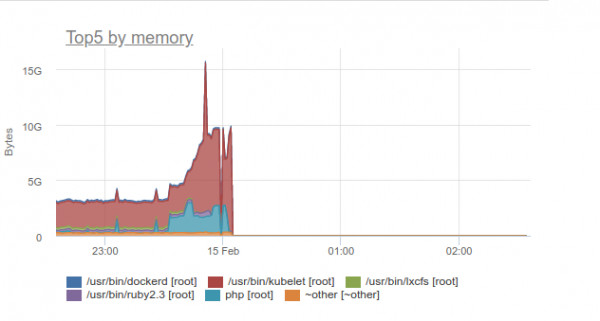
Ispostavilo se da postoji problem u systemd-u koji se koristi u Ubuntu 16.04, a nastaje pri upravljanju mount-ovima koji se stvaraju za povezivanje subPath iz ConfigMap-ova ili secret-a. Nakon završetka rada pod-a servis systemd i njegov servisni mount ostaju u sustavu. Tijekom vremena nakuplja se ogromna količina. O ovoj temi postoje čak i problemi:
- ;
- .
… u posljednjem od njih se poziva na PR u systemd-u: (problem u systemd-u — ).
Problema više nema u Ubuntu 18.04, ali ako želite i dalje koristiti Ubuntu 16.04, može vam koristiti naše rješenje za ovo pitanje.
Dakle, napravili smo sljedeći DaemonSet:
---
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  labels:
    app: systemd-slices-cleaner
  name: systemd-slices-cleaner
  namespace: kube-system
spec:
  updateStrategy:
    type: RollingUpdate
  selector:
    matchLabels:
      app: systemd-slices-cleaner
  template:
    metadata:
      labels:
        app: systemd-slices-cleaner
    spec:
      containers:
      - command:
        - /usr/local/bin/supercronic
        - -json
        - /app/crontab
        Image: private-registry.org/systemd-slices-cleaner/systemd-slices-cleaner:v0.1.0
        imagePullPolicy: Always
        name: systemd-slices-cleaner
        resources: {}
        securityContext:
          privileged: true
        volumeMounts:
        - name: systemd
          mountPath: /run/systemd/private
        - name: docker
          mountPath: /run/docker.sock
        - name: systemd-etc
          mountPath: /etc/systemd
        - name: systemd-run
          mountPath: /run/systemd/system/
        - name: lsb-release
          mountPath: /etc/lsb-release-host
      imagePullSecrets:
      - name: antiopa-registry
      priorityClassName: cluster-low
      tolerations:
      - operator: Exists
      volumes:
      - name: systemd
        hostPath:
          path: /run/systemd/private
      - name: docker
        hostPath:
          path: /run/docker.sock
      - name: systemd-etc
        hostPath:
          path: /etc/systemd
      - name: systemd-run
        hostPath:
          path: /run/systemd/system/
      - name: lsb-release
        hostPath:
          path: /etc/lsb-release
… a u njemu se koristi takav skript:
#!/bin/bash

# we will work only on xenial
hostrelease="/etc/lsb-release-host"
test -f ${hostrelease} && grep xenial ${hostrelease} > /dev/null || exit 0

# sleeping max 30 minutes to dispense load on kube-nodes
sleep $((RANDOM % 1800))

stoppedCount=0
# counting actual subpath units in systemd
countBefore=$(systemctl list-units | grep subpath | grep "run-" | wc -l)
# let's go check each unit
for unit in $(systemctl list-units | grep subpath | grep "run-" | awk '{print $1}'); do
  # finding description file for unit (to find out docker container, who born this unit)
  DropFile=$(systemctl status ${unit} | grep Drop | awk -F': ' '{print $2}')
  # reading uuid for docker container from description file
  DockerContainerId=$(cat ${DropFile}/50-Description.conf | awk '{print $5}' | cut -d/ -f6)
  # checking container status (running or not)
  checkFlag=$(docker ps | grep -c ${DockerContainerId})
  # if container not running, we will stop unit
  if [[ ${checkFlag} -eq 0 ]]; then
    echo "Stopping unit ${unit}"
    # stoping unit in action
    systemctl stop $unit
    # just counter for logs
    ((stoppedCount++))
    # logging current progress
    echo "Stopped ${stoppedCount} systemd units out of ${countBefore}"
  fi
done
… i pokreće se svakih 5 minuta pomoću već spomenutog supercronica. Njegov Dockerfile izgleda ovako:
FROM ubuntu:16.04
COPY rootfs /
WORKDIR /app
RUN apt-get update &&
    apt-get upgrade -y &&
    apt-get install -y gnupg curl apt-transport-https software-properties-common wget
RUN add-apt-repository "deb [arch=amd64] https://download.docker.com/linux/ubuntu xenial stable" &&
    curl -fsSL https://download.docker.com/linux/ubuntu/gpg | apt-key add - &&
    apt-get update &&
    apt-get install -y docker-ce=17.03.0*
RUN wget https://github.com/aptible/supercronic/releases/download/v0.1.6/supercronic-linux-amd64 -O
    /usr/local/bin/supercronic && chmod +x /usr/local/bin/supercronic
ENTRYPOINT ["/bin/bash", "-c", "/usr/local/bin/supercronic -json /app/crontab"]
Povijest 4. Konkurentnost pri planiranju podova
Primijećeno je da: ako se pod postavi na čvor i njegov se imidž preuzima vrlo dugo, tada drugi pod koji "zavri" na istom čvoru jednostavno ne počinje preuzimati imidž novog poda. Umjesto toga, čeka dok se preuzme imidž prethodnog poda. Kao rezultat, pod koji je već bio planiran i čiji bi se imidž mogao preuzeti u samo minuti, bit će dugo vremena u statusu containerCreating.
U događajima će biti otprilike sljedeće:
Normal Pulling 8m kubelet, ip-10-241-44-128.ap-northeast-1.compute.internal preuzimanje imidža "registry.example.com/infra/openvpn/openvpn:master"Ispada da jedan jedini imidž iz sporog registra može blokirati deploy na čvoru.
Nažalost, mogućnosti za rješenje nisu previše:
- Pokušajte koristiti svoj Docker Registry izravno unutar klastera ili izravno s klasterom (na primjer, GitLab Registry, Nexus itd.);
- Iskoristite alate kao što su .
Povijest 5. Zamrzavanje čvorova pri nedostatku memorije
Tijekom rada s raznim aplikacijama također smo naišli na situaciju kada čvor potpuno prestane biti dostupan: ne odgovara na SSH, svi nadzorni demoni se ruše, a u logovima nakon toga nema (ili gotovo nema) anomalija.
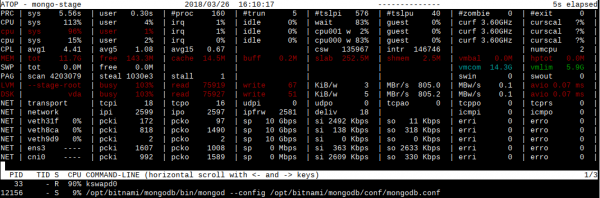
O tome ću pričati slikama koristeći primjer jednog čvora na kojem je radila MongoDB.
Ovako atop izgleda do incidencije:
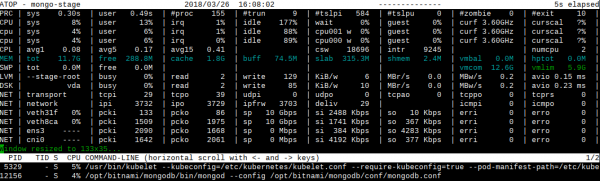
A ovako — nakon incidencije:
U nadzoru se također primjećuje nagli skok, pri čemu čvor prestaje biti dostupan:
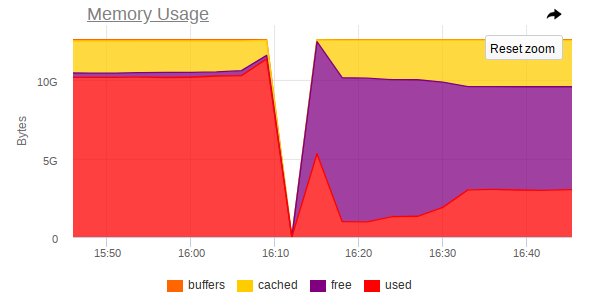
Tako da iz snimaka zaslona može se vidjeti da:
- RAM na računalu blizu je nule;
- Primjećuje se nagli skok potrošnje RAM-a, nakon čega se naglo gubi pristup cijelom računalu;
- Na Mongo dolazi veliki zadatak koji uzrokuje da proces DBMS-a koristi više memorije i aktivno čita s diska.
Ispostavilo se, ako u Linuxu nestane slobodne memorije (nastupi memory pressure) i nema swap-a, tada do dolazak OOM killera može doći do ekvilibrija između ubacivanja stranica u page cache i writeback-a njihovog vraćanja na disk. Time se bavi kswapd, koji hrabro oslobađa što više stranica memorije za daljnju distribuciju.
Nažalost, uz veliku opterećenost na ulazu/izlazu zajedno s malom količinom slobodne memorije, kswapd postaje usko grlo cijelog sustava, jer se na njega vežu svi rezervacije (page faults) stranica memorije u sustavu. To može trajati jako dugo, ako procesi ne žele više koristiti memoriju i zablokiraju se na samom rubu OOM-killer ponora.
S pravom se postavlja pitanje: zašto OOM killer dolazi tako kasno? U svojoj trenutnoj iteraciji OOM killer je ekstremno glup: ubija proces tek kada ne uspije pokušaj dodjele stranice memorije, tj. kada page fault završi s greškom. To se dovoljno dugo ne događa, jer kswapd hrabro oslobađa stranice memorije, brišući page cache (sva diskovna I/O u sustavu, zapravo) natrag na disk. Detaljnije, s opisom koraka potrebnih za rješavanje sličnih problema u jezgru, može se pročitati .
Ovo ponašanje s jezgrom Linux 4.6+.
Povijest 6. Pod’ovi vise u statusu Pending
U nekim klasterima gdje se zapravo mnogo pod'ova koristi, primijetili smo da većina njih dugo 'visi' u stanju Pending, iako su Docker kontejneri već pokrenuti na čvorovima i s njima se može ručno raditi.
U tom describe nema ništa loše:
  Vrsta    Razlog                  Dob                Izvor                     Poruka
  ----    ------                  ----               ----                     -------
  Normalno  Raspoređeno               1m                 default-scheduler        Uspješno dodijeljeno sphinx-0 na ss-dev-kub07
  Normalno  Uspješno spajanje volumena  1m                 attachdetach-controller  AttachVolume.Attach uspjelo za volumen "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normalno  Uspješno montiranje volumena   1m                 kubelet, ss-dev-kub07    MountVolume.SetUp uspjelo za volumen "sphinx-config"
  Normalno  Uspješno montiranje volumena   1m                 kubelet, ss-dev-kub07    MountVolume.SetUp uspjelo za volumen "default-token-fzcsf"
  Normalno  Uspješno montiranje volumena   49s (x2 tijekom 51s)  kubelet, ss-dev-kub07    MountVolume.SetUp uspjelo za volumen "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normalno  Preuzeto                  43s                kubelet, ss-dev-kub07    Slika kontejnera "registry.example.com/infrastructure/sphinx-exporter/sphinx-indexer:v1" već je prisutna na mašini
  Normalno  Kreirano                 43s                kubelet, ss-dev-kub07    Kontejner je kreiran
  Normalno  Pokrenuto                 43s                kubelet, ss-dev-kub07    Kontejner je pokrenut
  Normalno  Preuzeto                  43s                kubelet, ss-dev-kub07    Slika kontejnera "registry.example.com/infrastructure/sphinx/sphinx:v1" već je prisutna na mašini
  Normalno  Kreirano                 42s                kubelet, ss-dev-kub07    Kontejner je kreiran
  Normalno  Pokrenuto                 42s                kubelet, ss-dev-kub07    Kontejner je pokrenut
Istražujući, pretpostavili smo da kubelet jednostavno ne stigne poslati sve informacije o stanju pod'ova, liveness/readiness probama, API serveru.
I proučivši pomoć, pronašli smo sljedeće parametre:
--kube-api-qps - QPS koji se koristi prilikom komunikacije s kubernetes apiserverom (zadano 5)
--kube-api-burst  - Burst koji se koristi prilikom komunikacije s kubernetes apiserverom (zadano 10)
--event-qps - Ako > 0, ograničava kreiranje događaja po sekundi na ovu vrijednost. Ako 0, neograničeno. (zadano 5)
--event-burst - Maksimalna veličina bursto događaja, privremeno omogućava događajima da porastu na ovu brojku, dok i dalje ne premašuje event-qps. Koristi se samo ako --event-qps > 0 (zadano 10)
--registry-qps - Ako > 0, ograničava registraciju povlačenja QPS na ovu vrijednost.
--registry-burst - Maksimalna veličina bursto povlačenja, privremeno omogućava povlačenjima da porastu na ovu brojku, dok i dalje ne premašuje registry-qps. Koristi se samo ako --registry-qps > 0 (zadano 10)
Kao što se vidi, zadane vrijednosti — prilično male, i u 90 % pokrivaju sve potrebe… Međutim, u našem slučaju to se pokazalo nedovoljnim. Stoga smo postavili sljedeće vrijednosti:
--event-qps=30 --event-burst=40 --kube-api-burst=40 --kube-api-qps=30 --registry-qps=30 --registry-burst=40… i ponovo pokrenuli kubelet’e, nakon čega smo na grafikonima pristupa API serveru vidjeli sljedeću sliku:
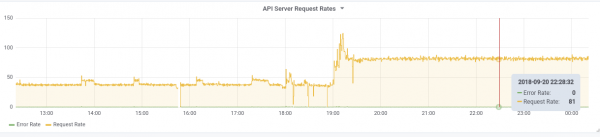
… i da, sve je počelo raditi savršeno!
P.S.
Za pomoć u prikupljanju grešaka i pripremi članka izražavam veliku zahvalnost brojnim inženjerima naše kompanije, a posebno kolegi iz našeg R&D tima Andreju Klimentjevu ().
P.S.
Pročitajte i na našem blogu:
- «».
- Kubernetes savjeti i trikovi:
- «»;
- «»;
- «»;
- «».
Izvor: habr.com
