

Napomena za prijevod.: Autori ovog članka su inženjeri iz male češke tvrtke pipetail. Uspjeli su prikupiti impresivan popis [djelomično trivijalnih, ali još uvijek] vrlo relevantnih problema i zabluda vezanih uz korištenje Kubernetes klastera.
Kroz godine korištenja Kubernetes-a radili smo s brojnim klasterima (i upravljanim i neuređeni — na GCP, AWS i Azure). Vremenom smo počeli primjećivati da se neke pogreške neprestano ponavljaju. Međutim, u tome nema ništa sramotno: većinu smo ih napravili i sami!
U članku su prikazane najčešće pogreške, kao i kako ih ispraviti.
1. Resursi: zahtjevi i ograničenja
Ova stavka zasigurno zaslužuje najviše pažnje i prvo mjesto na popisu.
Zahtjev za CPU obično ili nije uopće postavljen, ili ima vrlo nisku vrijednost (kako bi se smjestilo što više podova na svaki čvor). Na taj način, čvorovi postaju preopterećeni. Tijekom visoke opterećenosti, procesorska snaga čvora je potpuno iskorištena i konkretni radni zadatak dobiva samo ono što je "zahtijevao" putem CPU throttling. To dovodi do povećanja latencije u aplikacijama, vremenskih ograničenja i drugih neugodnih posljedica. (Više o tome pročitajte u našem drugom nedavnom prijevodu: "” — napomena prev.)
BestEffort (izuzetno ne preporučljivo):
resources: {}Ekstremno niska zahtjev za CPU (izuzetno ne preporučljivo):
   resources:
      Requests:
        cpu: "1m"
S druge strane, postavljanje ograničenja CPU-a može dovesti do neopravdanog propuštanja ciklusa podova, čak i kada procesor čvora nije potpuno opterećen. Opet, to može dovesti do povećanja latencije. Rasprave o atributu CPU CFS quota u Linux kernelu i CPU throttling-u prema postavljenim ograničenjima, kao i isključivanju CFS kvote... Nažalost, ograničenja CPU-a mogu izazvati više problema nego što mogu riješiti. Više informacija možete pronaći na donjem linku.
Prekomjerno alociranje (overcommitting) memorije može dovesti do većih problema. Dosezanje limita CPU-a uzrokuje propuštanje ciklusa, dok dosezanje limita memorije dovodi do "ubijanja" poda. Jeste li ikada vidjeli OOMkill? Да, речь идет именно о нем.
Želite smanjiti vjerojatnost ovog događaja? Ne raspoređujte prekomjerne količine memorije i koristite Guaranteed QoS (Quality of Service), postavljajući zahtjev za memoriju jednak limita (kao u primjeru u nastavku). Više o tome pročitajte u (glavni inženjer Zalando).
Burstable (veća vjerojatnost da će doći do OOMkilled):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Guaranteed:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
Što vam potencijalno može pomoći pri podešavanju resursa?
Pomoću metrics-server možete provjeriti trenutno korištenje CPU resursa i korištenje memorije od strane podova (i kontejnera unutar njih). Vjerojatno ga već koristite. Samo izvršite sljedeće naredbe:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Međutim, oni pokazuju samo trenutno korištenje. S njima možete dobiti približnu predstavu o redoslijedu veličina, ali na kraju će vam trebati povijest promjene metrika tijekom vremena (da biste odgovorili na pitanja poput: „Koje je bilo maksimalno opterećenje CPU-a?“, „Koje je opterećenje bilo jučer ujutro?“ — itd.). Za to možete koristiti Prometheus, DataDog i druge alate. Oni jednostavno dobivaju metrike s metrics-servera i pohranjuju ih, a korisnik ih može pozvati i izraditi odgovarajuće grafove.
omogućava automatizirati ovaj proces. On prati povijest korištenja procesora i memorije i podešava nove zahtjeve i limite na temelju tih informacija.
Učinkovito korištenje računalnih kapaciteta nije jednostavan zadatak. To je poput stalnog igranja tetris-a. Ako previše plaćate za računalne kapacitete pri niskoj prosječnoj potrošnji (recimo, ~10 %), preporučujemo da obratite pozornost na proizvode bazirane na AWS Fargate ili Virtual Kubelet. Oni su izgrađeni na modelu naplate bez poslužitelja/plaćanja prema korištenju, što može biti jeftinije u takvim uvjetima.
2. Liveness i readiness probes
Prema zadanim postavkama, provjere stanja liveness i readiness u Kubernetesu nisu uključene. I ponekad ih zaborave uključiti…
Ali kako još možete inicirati ponovno pokretanje usluge u slučaju neizbježne pogreške? I kako load balancer saznaje da je neki pod spreman primati promet? Ili da je sposoban obraditi veći promet?
Često se ove probe međusobno miješaju:
- Živost — provjera „života“ koja ponovno pokreće pod u slučaju neuspješnog završetka;
- Spremnost — provjera spremnosti, koja, u slučaju neuspjeha, isključuje pod iz Kubernetes servisa (to se može provjeriti uz pomoć
kubectl get endpoints) i promet prema njemu ne dolazi sve dok sljedeća provjera ne završi uspješno.
Obje ove provjere IZVODE SE TIJEKOM CIJELOG ŽIVOTNOG CIKLUSA POD’A. To je jako važno.
Uobičajena zabluda je da se readiness probe pokreću samo na početku kako bi ravnotežitelj mogao znati da je pod spreman (Spremno) i može započeti s obradom prometa. Međutim, to je samo jedan od mogućih scenarija njihove primjene.
Druga opcija je saznati da je promet prema podu prevelik i preopterećuje ga (ili da pod izvodi resursno zahtjevne proračune). U tom slučaju, readiness provjera pomaže smanjiti opterećenje na podu i „ohladi“ ga. Uspješan završetak readiness provjere u budućnosti omogućava ponovno povećanje opterećenja na podu. U tom slučaju (ako se readiness provjera ne uspije) neuspjeh liveness provjere bio bi vrlo kontraproduktivan. Zašto ponovno pokretati pod koji je zdrav i radi punom snagom?
Stoga je u nekim slučajevima potpuno odsustvo provjera bolje od uključivanja s pogrešno postavljenim parametrima. Kao što je rečeno ranije, ako liveness provjera kopira readiness provjeru, onda ste u velikim problemima. Moguća opcija je postaviti , već ostaviti sa strane.
Oba tipa provjera ne bi trebala neuspjeti prilikom pada zajedničkih ovisnosti, inače će to dovesti do kaskadnog (lavinskog) otkaza svih podova. Drugim riječima, .
3. LoadBalancer za svaku HTTP uslugu
Vjerojatno imate HTTP usluge u klasteru koje biste željeli izložiti vanjskom svijetu.
Ako otvorite uslugu kao type: LoadBalancer, njegov kontroler (ovisno o pružatelju usluga) će osigurati i usuglasiti vanjski LoadBalancer (ne nužno funkcionira na L7, vjerojatnije na L4), a to može imati utjecaj na troškove (vanjska statička IPv4 adresa, računalna snaga, tarifiranje po sekundi) zbog potrebe za stvaranjem velikog broja sličnih resursa.
U ovom slučaju, mnogo je logičnije koristiti jedan vanjski ravnotežitelj opterećenja, otvarajući usluge kao type: NodePort. Ili, što je još bolje, implementirati nešto poput nginx-ingress-controller (ili traefik), koji će biti jedini NodePort ‘endpoint’ povezan s vanjskim ravnotežom opterećenja i usmjeravat će promet unutar klastera pomoću ingress-resursa Kubernetes.
Ostale intra-klaster (mikro)usluge, koje međusobno surađuju, mogu „komunicirati“ putem usluga tipa ClusterIP i ugrađenog mehanizma za otkrivanje usluga putem DNS-a. Samo nemojte koristiti njihove javne DNS/IP adrese, jer to može utjecati na latenciju i povećati troškove oblaka.
4. Automatsko skaliranje klastera bez uzimanja u obzir njegovih karakteristika
Pri dodavanju čvorova u klaster i njihovom uklanjanju, ne treba se oslanjati na neke osnovne metrike poput korištenja CPU-a na tim čvorovima. Planiranje pod-a treba se provoditi uzimajući u obzir mnoge ograničenja, poput pod/čvor affiniteta, taints i tolerations, zahtjeve resursa, QoS itd. Korištenje vanjskog autoscalera koji ne uzima u obzir ove nijanse može dovesti do problema.
Zamislite da neki pod treba biti planiran, ali su sve dostupne CPU resurse zatražene/raspoređene i pod zapne u stanju Pending. Vanjski autoscaler vidi prosječno trenutno opterećenje CPU-a (a ne traženo) i ne inicira proširenje (scale-out) — ne dodaje još jedan čvor. Kao rezultat, ovaj pod neće biti planiran.
Istodobno, obrnuto skaliranje (scale-in) — uklanjanje čvora iz klastera — uvijek je teže ostvariti. Zamislite da imate stateful pod (s priključenim trajnim skladištem). Persistent-Volume obično pripada određenoj dostupnoj zoni i ne replicira se u regiji. Dakle, ako vanjski autoscaler ukloni čvor s ovim pod-om, planiralac neće moći planirati ovaj pod na drugi čvor jer to može učiniti samo u onoj dostupnoj zoni gdje se nalazi trajno skladište. Pod će zapečati u stanju Pending.
U zajednici Kubernetes, vrlo je popularan . On radi unutar klastera, podržava API od glavnih pružatelja usluga oblaka, uzima u obzir sve ograničenja i može se skalirati u navedenim slučajevima. Također može izvršiti scale-in uz očuvanje svih postavljenih ograničenja, čime se štede novci (koji bi inače bili potrošeni na neiskorištene resurse).
5. Zanemarivanje mogućnosti IAM/RBAC
Pazite na korištenje IAM korisnika s trajnim tajnama za strojeve i aplikacije. Organizirajte privremeni pristup koristeći uloge i račune usluga (service accounts).
Često se susrećemo s tim da su pristupni ključevi (i tajne) ‘hardcodani’ u konfiguraciji aplikacije, kao i da se zanemaruje rotacija tajni unatoč pristupu Cloud IAM-u. Koristite IAM uloge i račune usluga umjesto korisnika kada je to prikladno.
Zaboravite na kube2iam i odmah se prebacite na IAM uloge za račune usluga (kako je opisano u Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
Jedna anotacija. Nije tako teško, zar ne?
Osim toga, ne dodjeljujte računima usluga i profilima instanci privilegije admin i cluster-admin, ako to ne trebaju. Ovo je malo složenije realizirati, posebno u RBAC K8s, ali svakako vrijedi truda.
6. Ne oslanjajte se na automatsku anti-affinity za podove
Zamislite da imate tri replike nekog deploymenata na čvoru. Čvor se ruši, a s njim i sve replike. Neugodna situacija, zar ne? Ali zašto su sve replike bile na jednom čvoru? Zar Kubernetes ne bi trebao osigurati visoku dostupnost (HA)?!
Nažalost, Kubernetesov planer ne pridržava pravila o odvojenom postojanju (anti-affinity) za podove. Potrebno ih je izričito definirati:
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
To je to. Sada će se podovi planirati na različite čvorove (ovo se pravilo provjerava samo tijekom planiranja, ali ne i kada su već aktivni — otuda i requiredDuringSchedulingIgnoredDuringExecution).
Ovdje govorimo o podAntiAffinity na različitim čvorovima: topologyKey: "kubernetes.io/hostname", — a ne o različitim dostupnostnim zonama. Da biste ostvarili punu HA, trebate malo dublje istražiti ovu temu.
7. Zanemarivanje PodDisruptionBudgetova
Zamislite da imate produkcijsko opterećenje u Kubernetes klasteru. Povremeno je potrebno ažurirati (ili decommissionirati) čvorove i sam klaster. PodDisruptionBudget (PDB) je nešto poput garancijskog ugovora o održavanju između administratora klastera i korisnika.
PDB omogućava izbjegavanje prekida u radu servisa uzrokovanih nedostatkom čvorova:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
U ovom primjeru, kao korisnik klastera, obavještavate administratore: „Hej, imam uslugu zookeeper i bez obzira na to što radite, želio bih da barem 2 replike te usluge uvijek budu dostupne.“
Više o tome možete pročitati .
8. Više korisnika ili okruženja u zajedničkom klasteru
Prostor imena Kubernetes (namespaces) ne osiguravaju jaku izolaciju.
Uobičajena je zabluda da, ako se ne-prod opterećenje implementira u jednom prostoru imena, a prod opterećenje u drugom, da se neće nikako utjecati jedno na drugo… Ipak, određeni nivo izolacije može se postići putem zahtjeva/ograničenja resursa, postavljanjem kvota, dodjeljivanjem priorityClass’ova. Neku "fizičku" izolaciju u data plane pružaju affinities, tolerations, taints (ili nodeselectors), međutim, takva podjela je prilično teška za implementaciju.
Onima koji trebaju kombinirati oba tipa radnih opterećenja u jednom klasteru će morati biti dopušteno nositi se sa složenošću. Ako pak takve potrebe nema, i možete priuštiti još jedan klaster (recimo, u javnom oblaku), bolje je tako učiniti. To će omogućiti postizanje mnogo višeg nivoa izolacije.
9. externalTrafficPolicy: Cluster
Vrlo često primjećujemo da sav promet unutar klastera dolazi kroz uslugu tipa NodePort, za koju je po defaultu postavljena politika externalTrafficPolicy: Cluster. To znači da NodePort je otvoren na svakom čvoru u klasteru, i mogu se koristiti bilo koji od njih za interakciju s potrebnom uslugom (skupom pod’ova).
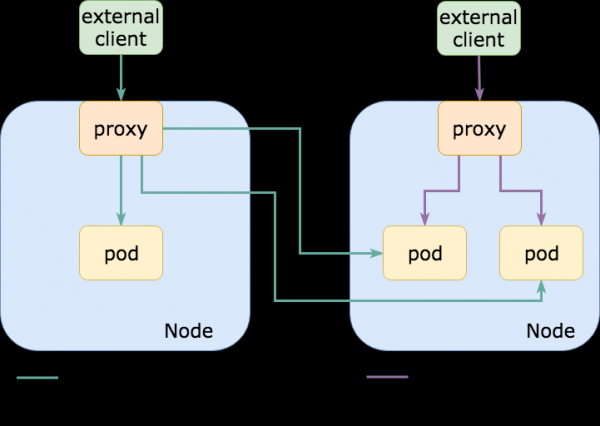
U tom trenutku, stvarni pod’ovi povezani s gore spomenutom NodePort uslugom, obično se nalaze samo na nekom podskupu tih čvorova.. Drugim riječima, ako se povežem s čvorom na kojem nema potrebnog pod’а, on će preusmjeriti promet na drugi čvor, dodajući tranzitnu fazu (hop) i povećavajući latenciju (ako se čvorovi nalaze u različitim zonama dostupnosti/data centrima, latencija može biti prilično visoka; pored toga, troškovi za egress promet će rasti).
S druge strane, ako je za neku Kubernetes uslugu određena politika externalTrafficPolicy: Local, tada se NodePort otvara samo na onim čvorovima gdje su zapravo pokrenuti potrebni pod’ovi. Pri korištenju vanjskog ravnoteživača opterećenja koji provjerava stanje (healthchecking) endpointa (kao što radi AWS ELB), on će slati promet samo na potrebne čvorove., što će pozitivno utjecati na kašnjenja, računalne potrebe, račune za egress (i zdrav razum također to nalaže).
Postoji velika vjerojatnost da već koristite nešto poput traefik ili nginx-ingress-controller kao krajnju NodePort točku (ili LoadBalancer koja također koristi NodePort) za usmjeravanje HTTP ingress prometa, a postavljanje ove opcije može značajno smanjiti kašnjenje kod takvih upita.
U možete saznati više o externalTrafficPolicy, njenim prednostima i nedostacima.
10. Ne vežite se za klastere i ne zlorabite kontrolnu ravninu
Nekada su serveri imali osobna imena: , HAL9000 i Colossus... Danas su ih zamijenili nasumično generirani identifikatori. Ipak, navika je ostala, a sada se osobna imena dodjeljuju klasterima.
Tipična priča (temeljena na pravim događajima): sve je počelo s dokazom koncepta, pa je klaster nosio ponosno ime testing... Prošle su godine, a još se UPORABLJAVA u produkciji, i svi se boje dotaknuti ga.
Nema ništa smiješno u tome što klasteri postaju kućni ljubimci, zato preporučujemo povremeno njihovo brisanje, uz vježbanje u oporavku od grešaka (u tome će pomoći — napomena prev.)). Osim toga, ne bi bilo loše pozabaviti se ni upravljačkom sloju (kontrolna ravnina). Strah od doticaja s njom – nije baš dobar znak. Etcd mrtav? Momci, stvarno ste zabrljali!
S druge strane, nemojte se previše zanositi manipulacijama s njim. S vremenom upravljajući sloj može postati spor.. Vjerojatno je to zbog velikog broja stvorenih objekata bez rotacije (obična situacija kada se koristi Helm s zadanim postavkama, zbog čega se njegovo stanje ne ažurira u configmap-ima/secretima – kao rezultat, u upravljačkom sloju se nakupljaju tisuće objekata) ili zbog stalnog uređivanja objekata kube-api (za automatsko skaliranje, za CI/CD, za praćenje, zapise događaja, kontrolere itd.).
Osim toga, preporučujemo da provjerite SLA/SLO dogovore s pružateljem managed Kubernetes-a i obratite pažnju na jamstva. Dobavljač može jamčiti dostupnost upravljačkog sloja (ili njegovih podkomponenti), ali ne i p99-kašnjenje upita koje mu šaljete. Drugim riječima, možete uvesti kubectl get nodes, a odgovor će stići za 10 minuta, što neće predstavljati kršenje uvjeta ugovora o održavanju.
11. Bonus: korištenje taga latest
A ovo je već klasika. U posljednje vrijeme se sve rjeđe susrećemo s ovom tehnikom, budući da su mnogi, naučeni gorkim iskustvom, prestali koristiti tag :latest i počeli fiksirati (pin) verzije. Ura!
ECR ; preporučujemo da se upoznate s ovom značajnom značajkom.
Sažetak
Ne očekujte da će sve proraditi kao čarolijom: Kubernetes nije panaceja. Loša aplikacija (i, možda, postane još lošija). Neodgovornost će dovesti do složenosti, sporog i napetog rada upravljačkog sloja. Osim toga, riskirate da ostanete bez strategije oporavka od katastrofa. Ne računajte na to da će Kubernetes "iz kutije" preuzeti odgovornost za osiguranje izolacije i visoke dostupnosti. Uložite malo vremena da svoju aplikaciju učinite doista cloud native.
Upoznati se s lošim iskustvima raznih timova možete u od Henninga Jacoba.
Oni koji žele dodati listu grešaka navedenu u ovom članku mogu nas kontaktirati na Twitteru (, ).
P.S. od prevodioca
Pročitajte i na našem blogu:
- «»;
- «»;
- «» (pregled i video predavanja);
- «».
Izvor: habr.com
