

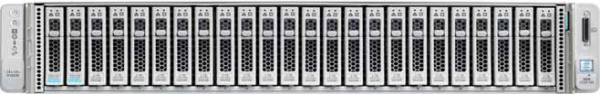
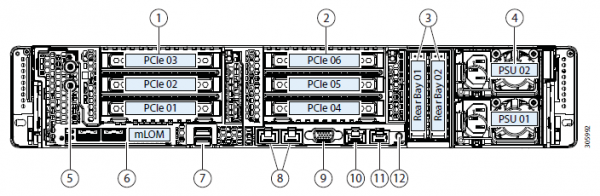
To je mit, dovoljno rasprostranjen u području serverskog hardvera. U praksi, međutim, hiper-štepanju rješenja (kada je sve u jednom) potrebna su za mnogo toga. Povijesno, prve arhitekture razvile su Amazon i Google za svoje usluge. Tada je ideja bila stvoriti računalnu farmu od identičnih čvorova, od kojih svaki ima vlastite diskove. Sve se to povezivalo nekim sustavnom softverom (hipervizorom) i dijelilo se na virtualne mašine. Glavni zadatak je minimalno napora za održavanje jednog čvora i minimalni problemi pri skaliranju: jednostavno kupite još tisuću-dvije takvih servera i spojite ih uz. U praksi, to su pojedinačni slučajevi, a mnogo češće se radi o manjem broju čvorova i malo drugačijoj arhitekturi.
Ali prednost ostaje ista — nevjerojatna jednostavnost skaliranja i upravljanja. Mana — različiti zadaci drugačije troše resurse, i negdje će lokalnih diskova biti mnogo, negdje malo RAM-a i tako dalje, što znači da će kod različitih tipova zadataka padati iskorištenje resursa.
Ispalo je da plaćate 10–15% više za jednostavnost postavljanja. To je izazvalo mit iz naslova. Dugo smo tražili gdje će se tehnologija optimalno primijeniti, i pronašli. Naime, Cisco nije imao svoje SAN-ove, ali su željeli cjelokupno tržište servera. I napravili su Cisco Hyperflex — rješenje s lokalnim skladištima na čvorovima.
I od toga je iznenada nastalo vrlo dobro rješenje za rezervne podatkovne centre (Disaster Recovery). Zašto i kako — sada ću objasniti. I pokazati testove klastera.
Gdje je potrebno
Hiper-štepanju je:
- Premještanje diskova u računalne čvorove.
- Potpuna integracija pod sustava za pohranu podataka s pod sustavom virtualizacije.
- Premještanje/integracija s mrežnim sustavom.
Ova povezanost omogućuje implementaciju mnogih funkcija SAN-a na razini virtualizacije i sve iz jednog prozora za upravljanje.
U našoj kompaniji vrlo su traženi projekti za projektiranje rezervnih DC-ova i često se bira upravo hiper-štepanju rješenje zbog čitavog niza opcija za replikaciju (do metroklastera) iz kutije.
U slučaju rezervnih podatkovnih centara obično se radi o udaljenom objektu na lokaciji na drugom kraju grada ili čak u drugom gradu. On omogućuje oporavak kritičnih sustava u slučaju djelomične ili potpune neispravnosti glavnog podatkovnog centra. Podaci se neprekidno repliciraju s produkcijske okoline, a ta replikacija može biti na razini aplikacije ili na razini blok uređaja (SAN).
Stoga ću sada govoriti o strukturi sustava i testovima, a zatim o nekoliko scenarija stvarne primjene s podacima o uštedama.
Testovi
Naš primjer se sastoji od četiri poslužitelja, od kojih svaki sadrži 10 SSD diskova od 960 GB. Postoji odvojeni disk za keširanje operacija pisanja i pohranu servisne virtualne mašine. Samo rješenje je četvrta verzija. Prva je bila izrazito siromašna (sudeći prema recenzijama), druga je bila siromašna, treća je već bila dovoljno stabilna, a ovu možemo nazvati izdanjem nakon završetka beta testiranja za širu javnost. Tijekom testiranja nisam uočio probleme, sve radi kao sat.
Promjene u v4Ispravljeno je mnoštvo bugova.
Isprva, platforma je mogla raditi samo s hipervizorom VMware ESXi i podržavala je mali broj čvorova. Također, proces implementacije nije uvijek uspješno završavao, bilo je potrebno ponovo pokrenuti neke korake, postojali su problemi s ažuriranjem sa starijih verzija, podaci u GUI-u nisu uvijek ispravno prikazivani (iako ni sada nisam oduševljen prikazom grafikona performansi), povremeno su se javljali problemi na granici s virtualizacijom.
Sada su svi dječji problemi ispravljeni, HyperFlex podržava i ESXi i Hyper-V, plus je moguće:
- Stvaranje proširenog klastera.
- Stvaranje klastera za urede bez korištenja Fabric Interconnect, s dva do četiri čvora (kupujemo samo poslužitelje).
- Mogućnost rada s vanjskim SAN-ima.
- Podrška za kontejnere i Kubernetes.
- Stvaranje zona dostupnosti.
- Integracija s VMware SRM-om, ako ugrađena funkcionalnost ne zadovoljava.
Arhitektura se ne razlikuje znatno od rješenja glavnih konkurenata, nisu se trudili izumiti bicikl. Sve ovo radi na VMware ili Hyper-V virtualizacijskoj platformi. Hardverski se smještava na servere vlastitog razvoja Cisco UCS. Ima onih koji mrze platformu zbog relativne složenosti prve konfiguracije, mnoštva gumba, netrivijalnog sustava predložaka i zavisnosti, ali ima i onih koji su dokučili zen, zaronili u ideju i više ne žele raditi s drugim serverima.
Razmotrit ćemo rješenje za VMware, budući da je rješenje izvorno stvoreno za njega i ima veću funkcionalnost, dok je Hyper-V dodatno dorađen tijekom vremena kako bi držao korak s konkurencijom i ispunio očekivanja tržišta.
Postoji klaster servera napunjenih diskovima. Ima diskove za pohranu podataka (SSD ili HDD — prema vašem ukusu i potrebama), te jedan SSD-disk za keširanje. Kada se podaci upisuju na datastor, podaci se spremaju na keširanju sloja (određeni SSD-disk i RAM servisne VM). Paralelno, blok podataka se šalje na čvorove u klasteru (broj čvorova ovisi o faktoru replikacije klastera). Nakon potvrde od svih čvorova o uspješnom upisu, potvrda se šalje hipervizoru i zatim — VM-u. Upisani podaci se u pozadini dedupliciraju, komprimiraju i zapisuju na diske za pohranu. Pri tome se na diskove za pohranu uvijek piše veliki blok i sekvencijalno, što smanjuje opterećenje na diskove za pohranu.
Deduplicitacija i kompresija su stalno uključene i ne mogu se isključiti. Čitanje podataka odvija se izravno s diskova za pohranu ili iz RAM keša. Ako se koristi hibridna konfiguracija, tada se čitanje također kešira na SSD-disku.
Podaci nisu vezani uz trenutnu lokaciju virtualne mašine i ravnomjerno se raspoređuju među čvorovima. Takav pristup omogućuje jednako opterećenje svih diskova i mrežnih sučelja. Postoji očigledan minus: ne možemo maksimalno smanjiti latenciju čitanja, jer nema garancije da su podaci lokalno prisutni. No smatram da je to neznatan gubitak u usporedbi s dobivenim prednostima. Tim više što su latencije u mreži dosegle takve vrijednosti da praktički ne utječu na konačni rezultat.
Za cjelokupnu logiku rada diskovne podsustave odgovara posebna servisna VM Cisco HyperFlex Data Platform controller, koja se stvara na svakoj nodi pohrane. U našoj konfiguraciji servisnoj VM dodijeljeno je osam vCPU i 72 GB RAM-a, što nije malo. Podsjećam da sam host ima 28 fizičkih jezgri i 512 GB RAM-a.
Servisna VM ima pristup fizičkim diskovima izravno putem proksiranja SAS-kontrolera unutar VM-a. Komunikacija s hipervizorom odvija se putem posebnog modula IOVisor, koji presreće operacije ulaz-izlaz, i uz pomoć agenta koji omogućava slanje komandi u API hipervizora. Agent je zadužen za rad s HyperFlex snimkama i klonovima.
U hipervizoru diskovni resursi se montiraju kao NFS- ili SMB-share (ovisno o vrsti hipervizora, pogodite koja gdje). A ispod haube je distribuirani datotečni sustav koji omogućava dodavanje funkcija punokrvne SAN: tanko dodjeljivanje volumena, kompresija i deduplifikacija, snimke putem tehnologije Redirect-on-Write, sinkrona/asinkrona replikacija.
Servisna VM pruža pristup WEB sučelju za upravljanje sustavom HyperFlex. Postoji integracija s vCenterom, a veći dio svakodnevnih zadataka može se obaviti iz njega, no datastori je, na primjer, lakše podijeliti iz odvojenog web sučelja, ako ste već prešli na brzo HTML5 sučelje, ili koristiti potpuni Flash klijent s punom integracijom. U servisnoj web aplikaciji možete pregledati performanse i detaljan status sustava.
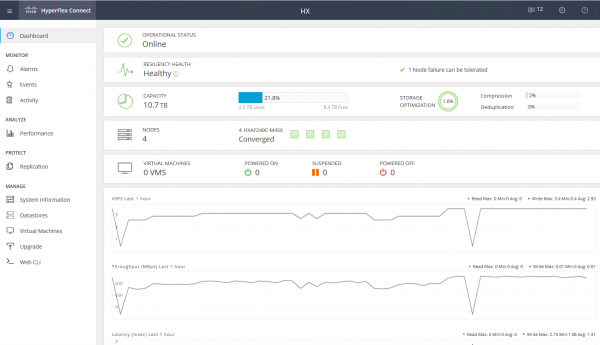
Postoji i drugi tip nodi u klasteru - računalne nodi. To mogu biti rack ili blade poslužitelji bez ugrađenih diskova. Na tim poslužiteljima možete pokretati VM-ove čiji se podaci pohranjuju na poslužiteljima s diskovima. U smislu pristupa podacima, nema razlike između tipova nodi, jer arhitektura podrazumijeva apstrakciju od fizičkog položaja podataka. Maksimalni omjer računalnih nodi i nodi pohrane je 2:1.
Korištenje računalnih nodi povećava fleksibilnost pri skaliranju resursa klastera: ne moramo nužno kupovati nodi s diskovima ako imamo potrebu samo za CPU/RAM-om. Osim toga, možemo dodati blade košaru i time uštedjeti na smještaju poslužitelja u ormariću.
Kao rezultat imamo hiperconvergentnu platformu s sljedećim karakteristikama:
- Do 64 čvora u klasteru (do 32 čvora za pohranu).
- Minimalan broj čvorova u klasteru je tri (dva za Edge klaster).
- Mehanizam redundancije podataka: zrcaljenje s faktorom replikacije 2 i 3.
- Metro klaster.
- Asinhrona replikacija VM-a na drugi HyperFlex klaster.
- Orkestracija prebacivanja VM-a u udaljeni DC.
- Nativni snimci tehnologije Redirect-on-Write.
- Do 1 PB korisnog prostora s faktorom replikacije 3 i bez uzimanja u obzir deduplifikacije. Faktor replikacije 2 ne uzimamo u obzir, jer nije opcija za ozbiljnu prodaju.
Još jedna velika prednost je jednostavnost upravljanja i implementacije. Sve složenosti postavljanja UCS servera preuzima specijalizirana VM koju su pripremili inženjeri Cisco-a.
Konfiguracija testnog okruženja:
- 2 x Cisco UCS Fabric Interconnect 6248UP kao upravljački klaster i mrežne komponente (48 portova koji rade u Ethernet 10G/FC 16G modu).
- Četiri servera Cisco UCS HXAF240 M4.
Specifikacije servera:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Mreža
UCSC-MLOM-CSC-02 (VIC 1227). 2 porta 10G Ethernet
Storage HBA
Cisco 12G Modular SAS Pass through Controller
Storage Disks
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Više opcija konfiguracijaOsim odabranog hardvera, u ovom trenutku dostupne su sljedeće opcije:
- HXAF240c M5.
- Jedan ili dva CPU počevši od Intel Silver 4110 do Intel Platinum I8260Y. Dostupna je druga generacija.
- 24 utora za memoriju, moduli od 16 GB RDIMM 2600 do 128 GB LRDIMM 2933.
- Od 6 do 23 diskova za podatke, jedan keš disk, jedan sistemski i jedan boot disk.
Capacity Drives
- HX-SD960G61X-EV 960GB 2.5 inčni Enterprise Value 6G SATA SSD (1X izdržljivost) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 inčni Enterprise Value 6G SATA SSD (1X izdržljivost) SAS 3.8 TB.
- Caching Drives
- HX-NVMEXPB-I375 375GB 2.5 inčni Intel Optane Drive, Extreme Perf & Endurance.
- HX-NVMEHW-H1600* 1.6TB 2.5 inčni Ent. Perf. NVMe SSD (3X izdržljivost) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 inčni Ent. Perf. 12G SAS SSD (10X izdržljivost) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 inčni Ent. Perf. 12G SAS SED SSD (10X izdržljivost) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 inčni Enterprise performance 12G SAS SSD (3X izdržljivost).
System / Log Drives
- HX-SD240GM1X-EV 240GB 2.5 inčni Enterprise Value 6G SATA SSD (requires upgrade).
Boot Drives
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Povezivanje na mrežu putem 40G, 25G ili 10G portova Ethernet.
Kao FI mogu biti HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Sam test
Za testiranje diskovne podskupine koristio sam HCIBench 2.2.1. To je besplatna aplikacija koja omogućuje automatizaciju generiranja opterećenja iz nekoliko virtualnih mašina. Samo opterećenje generira običan fio.
Naš klaster se sastoji od četiri čvora, faktor replikacije 3, svi diskovi Flash.
Za testiranje sam stvorio četiri skladišta podataka i osam virtualnih mašina. Za testove pisanja predviđa se opcija kada cache disk nije prepunjen.
Rezultati testova su sljedeći:
100 % Čitanje 100 % Nasumično
0 % Čitanje 100% Nasumično
Blok / Dubina reda
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Polažene vrijednosti su označene podebljanim slovima, nakon kojih više nema rasta performansi, ponekad se čak može primijetiti degradacija. To je povezano s time da se suočavamo s performansama mreže/kontrolera/diskova.
- Sekvencijalno čitanje 4432 MB/s.
- Sekvencijalno pisanje 804 MB/s.
- U slučaju otkaza jednog kontrolera (otkaz virtualne mašine ili domaćina) doživljavamo smanjenje performansi – do dva puta.
- U slučaju otkaza skladišnog diska – smanjenje za 1/3. Rebuild diska troši 5% resursa svakog kontrolera.
Na malom bloku dosežemo performanse kontrolera (virtualna mašina), njen CPU je 100% opterećen, a povećanjem bloka suočavamo se s propusnošću portova. 10 Gbps nije dovoljno za ostvarenje potencijala AllFlash sistema. Nažalost, testirati rad na 40 Gbps ne dopuštaju parametri pruženog demostenda.
Prema mom iskustvu iz testova i proučavanja arhitekture, zbog algoritma koji raspoređuje podatke između svih domaćina, dobivamo skalabilne predvidljive performanse, ali to je i ograničenje prilikom čitanja, jer bi s lokalnih diskova mogli izvući i više, ovdje može pomoći bolja mreža, na primjer, dostupni su FI na 40 Gbps.
Također, jedan disk za cache i deduplikaciju može predstavljati ograničenje, zapravo u ovom stendu možemo pisati na četiri SSD diska. Bilo bi odlično imati mogućnost povećanja broja cache diskova i vidjeti razliku.
Stvarna upotreba
Za organizaciju rezervnog centra podataka mogu se koristiti dva pristupa (ne razmatramo postavljanje backup-a na udaljenoj lokaciji):
- Aktivno-Pasivno. Sve aplikacije se nalaze u glavnom data centru. Replikacija može biti sinhrona ili asinhrona. U slučaju pada glavnog data centra, potrebno je aktivirati rezervni. To može biti učinjeno ručno/skliptima/aplikacijama za orkestraciju. Ovdje ćemo dobiti RPO koji odgovara frekvenciji replikacije, a RTO zavisi od reakcije i sposobnosti administratora te kvalitete osmišljenog/razrađenog plana prebacivanja.
- Aktivno-Aktivno. U ovom slučaju postoji samo sinhrona replikacija, dostupnost data centara određuje kvorum/arbitražno telo koje se strogo postavlja na trećoj lokaciji. RPO = 0, a RTO može dostići 0 (ako aplikacija to omogućava) ili je jednak vremenu potrebnom za obradu otkaza čvora u virtuelizacijskom klasteru. Na nivou virtuelizacije kreira se prošireni (Metro) klaster koji zahteva Active-Active SAN.
Obično vidimo da klijenti već imaju implementiranu arhitekturu s klasičnim SAN-om u glavnom data centru, pa projektujemo još jedan za replikaciju. Kao što sam spomenuo, Cisco HyperFlex nudi asinhronu replikaciju i kreiranje proširenog virtuelizacijskog klastera. U tom slučaju nam nije potreban namenski SAN nivoa Midrange i više s skupljim funkcijama replikacije i Active-Active pristupom podacima na dva SAN-a.
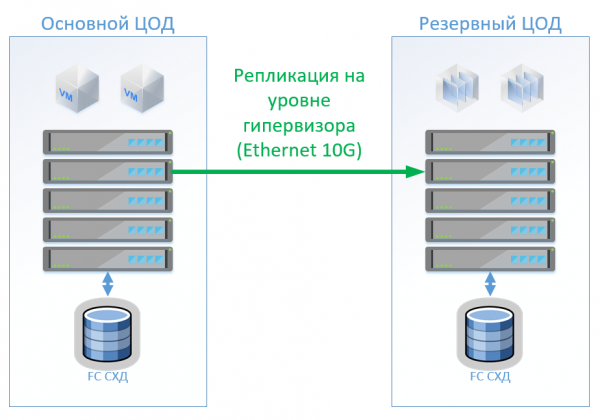
Scenarij 1: Imamo glavni i rezervni data centar, platforma za virtuelizaciju je VMware vSphere. Svi produktivni sistemi se nalaze u glavnom data centru, a replikacija virtuelnih mašina se vrši na nivou hipervizora, što će omogućiti da VM ne budu uključeni u rezervnom data centru. Baze podataka i specijalne aplikacije repliciramo ugrađenim sredstvima i držimo VM uključene. U slučaju otkaza glavnog data centra, pokrećemo sisteme u rezervnom data centru. Smatramo da imamo oko 100 virtuelnih mašina. Dok je glavni data centar aktivan, u rezervnom data centru mogu se pokretati testni okruženja i drugi sistemi koje je moguće isključiti u slučaju prebacivanja glavnog data centra. Također je moguć i scenario kada se koristi dvostruka replikacija. Što se tiče opreme, ništa se neće promeniti.
U klasičnoj arhitekturi postavićemo hibridni storage u svaki podatkovni centar s pristupom putem FibreChannel, tieringom, deduplikacijom i kompresijom (ali ne online), 8 servera na svakom mjestu, po 2 FibreChannel i Ethernet 10G preklopnika. Za replikaciju i upravljanje prebacivanjem u klasičnoj arhitekturi možemo koristiti alate VMware (Replication + SRM) ili alternativne alate koji će biti malo jeftiniji i ponekad povoljniji.
Na slici je prikazana shema.
U slučaju korištenja Cisco HyperFlex dobivamo sljedeću arhitekturu:
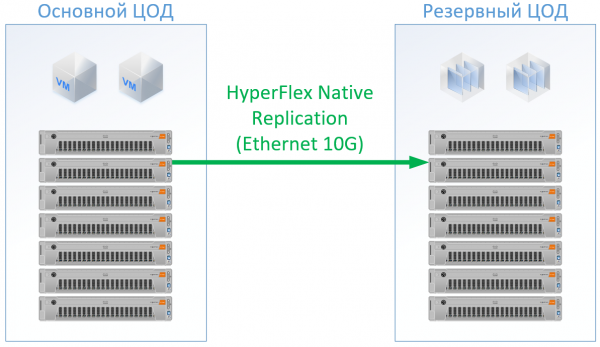
Za HyperFlex koristio sam poslužitelje s velikim resursima CPU/RAM, jer će dio resursa ići na VM kontroler HyperFlex, po CPU-u i RAM-u čak sam malo prešao u konfiguraciji HyperFlex, da ne bih favorizirao Cisco i osigurao resurse za ostale VM. Također, možemo odustati od FibreChannel preklopnika, i neće nam trebati Ethernet portovi za svaki server, lokalni promet se prebacuje unutar FI.
Na kraju smo dobili sljedeću konfiguraciju za svaki podatkovni centar:
Serveri
8 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Pohrana podataka
Hibridni storage s FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x Ethernet preklopnik 10G 12 portova
—
SAN
2 x FC preklopnik 32/16Gb 24 portova
2 x Cisco UCS FI 6332
Licence
VMware Ent Plus
Replikacija i/ili orkestracija prebacivanja VM
VMware Ent Plus
Za Hyperflex nisam planirao licence za softver replikacije, jer nam je to dostupno iz kutije.
Za klasičnu arhitekturu odabrao sam dobavljača koji se pokazao kao kvalitetan i jeftin proizvođač. Za obje varijante primjenio sam standardne popuste za konkretna rješenja, na izlazu dobio stvarne cijene.
Rješenje na Cisco HyperFlex bilo je 13% jeftinije.
Scenarij 2: izrada dva aktivna podatkovna centra. U ovom scenariju projektiramo prošireni klaster na VMware.
Klasična arhitektura se sastoji od virtualizacijskih poslužitelja, SAN (FC protokol) i dva storage-a koja mogu čitati i pisati na međusobnoj povezanosti. Na svakom storage-u planiramo korisni kapacitet za lokaciju.
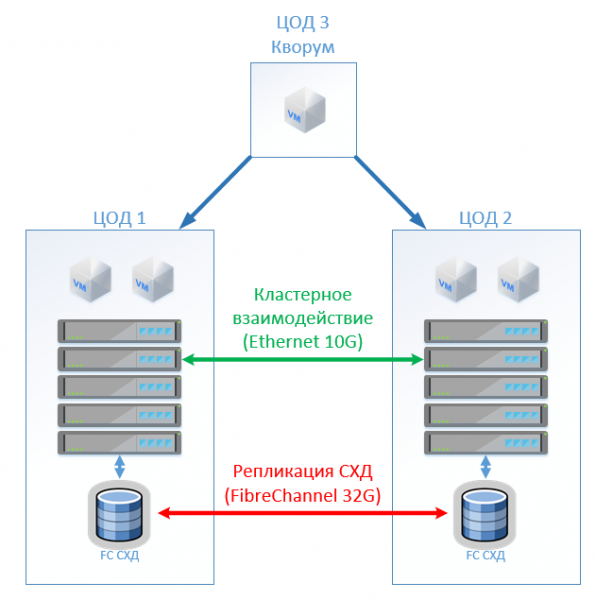
Na HyperFlex-u jednostavno kreiramo Stretch Cluster s istim brojem nodova na oba mjesta. U ovom slučaju koristi se faktor replikacije 2+2.
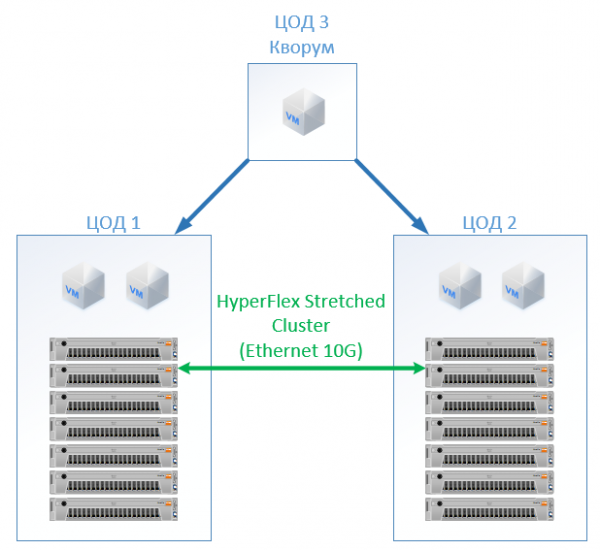
Dobivamo sljedeću konfiguraciju:
Klasična arhitektura
HyperFlex
Serveri
16 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Pohrana podataka
2 x AllFlash storage (150 TB SSD)
—
LAN
4 x Ethernet preklopnik 10G 24 portova
—
SAN
4 x FC preklopnik 32/16Gb 24 portova
4 x Cisco UCS FI 6332
Licence
VMware Ent Plus
VMware Ent Plus
U svim izračunima nisam uzimao u obzir mrežnu infrastrukturu, troškove podatkovnog centra itd.: oni će biti isti za klasičnu arhitekturu i za rešenje na HyperFlex.
Po ceni, HyperFlex je bio 5% skuplji. Ovde treba napomenuti da sam imao nerazmerje u resursima CPU/RAM za Cisco, jer sam u konfiguraciji ravnomerno popunjavao kanale kontrolera memorije. Cena je malo viša, ali ne dramatično, što jasno ukazuje na to da hiperkonvergencija nije nužno "igračka za bogate", već može konkurisati standardnom pristupu izgradnji podatkovnih centara. Takođe, ovo može biti zanimljivo onima koji već imaju Cisco UCS servere i odgovarajuću infrastrukturu.
Od prednosti dobijamo odsustvo troškova za administraciju SAN i SSK, online kompresiju i deduplikaciju, jedinstvenu tačku pristupa za podršku (virtualizacija, serveri, oni su takođe - SSK), uštedu prostora (ali ne u svim scenarijima), pojednostavljenu eksploataciju.
Što se tiče podrške, to dobijate od jednog dobavljača — Cisco. Ako sudim prema iskustvu sa Cisco UCS serverima, meni se sviđa, na HyperFlexu nisam imao problema, sve je radilo. Inženjeri brzo odgovaraju i mogu rešavati ne samo standardne probleme, već i složene granične slučajeve. Ponekad im se obratim s pitanjima: "Može li se to ovo tako uraditi, prilagoditi to?" ili "Ovde sam nešto konfigurisao i neće da radi. Pomoć!" — oni strpljivo pronađu potrebni vodič i ukažu na ispravne korake, ne odgovaraju: "Rešavamo samo hardverske probleme".
Linkovi
- Moja e-pošta je StGeneralov@croc.ru
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish