

Obično se za nadzor i analizu rada Nginx-a koriste komercijalni proizvodi ili gotove open-source alternative, poput Prometheus + Grafana. Ovo je dobar izbor za nadzor ili analitiku u stvarnom vremenu, ali nije baš pogodno za historijsku analizu. Na bilo kojem popularnom resursu, količina podataka iz nginx logova brzo raste, a za analizu velikog obima podataka logično je koristiti nešto specijaliziranije.
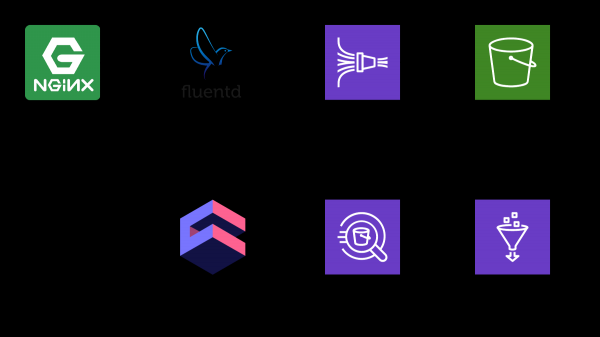
U ovom članku ću objasniti kako koristiti za analizu logova, koristeći Nginx kao primjer, i pokazati kako iz tih podataka sastaviti analitičku nadzornu ploču koristeći open-source okvir cube.js. Evo pune arhitekture rješenja:
TL:DR;
.
Za prikupljanje informacija koristimo , za obradu — i , za pohranu — . Ova kombinacija omogućava pohranu ne samo nginx logova, već i drugih događaja, kao i logova drugih servisa. Možete zamijeniti neke dijelove sličnima za vaš stak, na primjer, možete slati logove u Kinesis direktno iz Nginx-a, zaobilazeći Fluentd, ili koristiti Logstash za to.
Prikupiti logove Nginx-a
Po defaultu, logovi Nginx-a izgledaju ovako:
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-up HTTP/2.0" 200 9168 "https://example.com/sign-in" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-in HTTP/2.0" 200 9168 "https://example.com/sign-up" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
Mogu se obraditi, ali puno je lakše prilagoditi konfiguraciju Nginx-a da logovi budu u JSON formatu:
log_format json_combined escape=json '{ "created_at": "$msec", '
            '"remote_addr": "$remote_addr", '
            '"remote_user": "$remote_user", '
            '"request": "$request", '
            '"status": $status, '
            '"bytes_sent": $bytes_sent, '
            '"request_length": $request_length, '
            '"request_time": $request_time, '
            '"http_referrer": "$http_referer", '
            '"http_x_forwarded_for": "$http_x_forwarded_for", '
            '"http_user_agent": "$http_user_agent" }';

access_log  /var/log/nginx/access.log  json_combined;
S3 za pohranu
Da bismo pohranili logove, koristit ćemo S3. Ovo omogućava pohranu i analizu logova na jednom mjestu, jer Athena može raditi s podacima u S3 direktno. U nastavku članka ću objasniti kako ispravno organizirati i obraditi logove, ali za početak nam treba čisti bucket u S3-u, u kojem neće biti ništa više pohranjeno. Trebalo bi unaprijed razmisliti o regiji u kojoj ćete kreirati bucket, jer Athena nije dostupna u svim regijama.
Kreiramo shemu u konzoli Athena
Kreirat ćemo tablicu u Atheni za logove. Ona je potrebna i za zapisivanje i za čitanje, ako planirate koristiti Kinesis Firehose. Otvorite konzolu Athena i kreirajte tablicu:
SQL za kreiranje tablice
CREATE EXTERNAL TABLE `kinesis_logs_nginx`(
  `created_at` double,
  `remote_addr` string,
  `remote_user` string,
  `request` string,
  `status` int,
  `bytes_sent` int,
  `request_length` int,
  `request_time` double,
  `http_referrer` string,
  `http_x_forwarded_for` string,
  `http_user_agent` string)
ROW FORMAT SERDE
  'org.apache.hadoop.hive.ql.io.orc.OrcSerde'
STORED AS INPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcInputFormat'
OUTPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcOutputFormat'
LOCATION
  's3://'
TBLPROPERTIES ('has_encrypted_data'='false');
Kreiramo Kinesis Firehose Stream
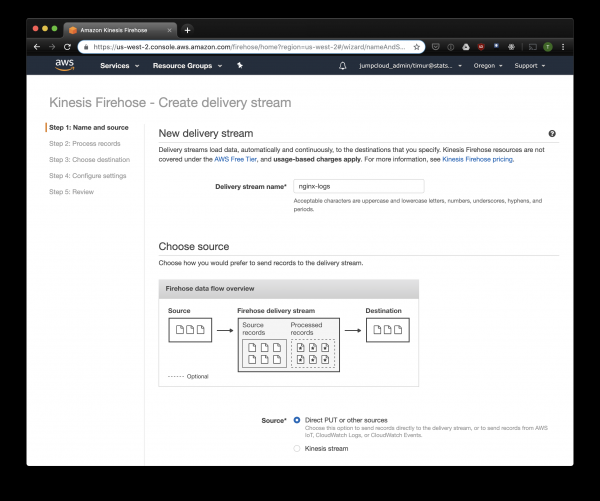
Kinesis Firehose će zapisivati podatke dobivene od Nginxa u S3 u odabranom formatu, razdijelivši ih prema direktorijima u formatu GGGG/MM/DD/HH. Ovo će biti korisno prilikom čitanja podataka. Naravno, možete zapisivati izravno u S3 iz fluentd, ali u tom slučaju ćete morati pisati JSON, što nije učinkovito zbog velike veličine datoteka. Osim toga, kada koristite PrestoDB ili Athenu, JSON je najsporiji format podataka. Otvorite konzolu Kinesis Firehose, kliknite „Create delivery stream“, odaberite „direct PUT“ u polju „delivery“:
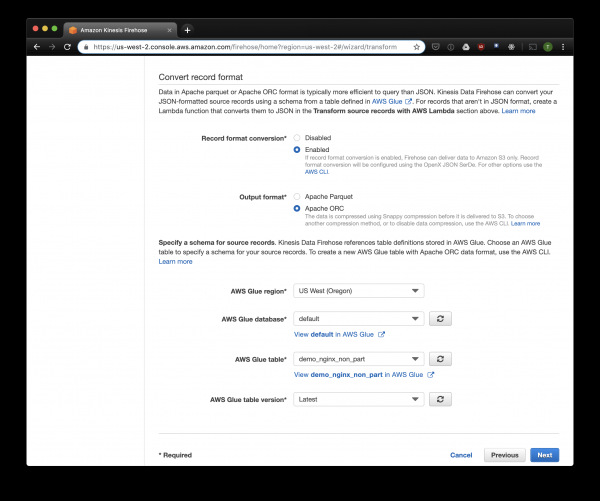
Na sljedećoj kartici odaberite „Record format conversion“ — „Enabled“ i odaberite „Apache ORC“ kao format za zapisivanje. Prema istraživanjima nekih , to je optimalan format za PrestoDB i Athenu. Kao shemu navedite tablicu koju smo kreirali ranije. Imajte na umu da se S3 lokacija u Kinesis može navesti bilo koja, tablica koristi samo shemu. No, ako navedete drugu S3 lokaciju, neće biti moguće pročitati te zapise iz te tablice.
Odabiremo S3 za pohranu i bazen koji smo ranije kreirali. Aws Glue Crawler, o kojem ću govoriti kasnije, ne može raditi s prefiksima u S3 bazenu, stoga je važno ostaviti ga praznim.
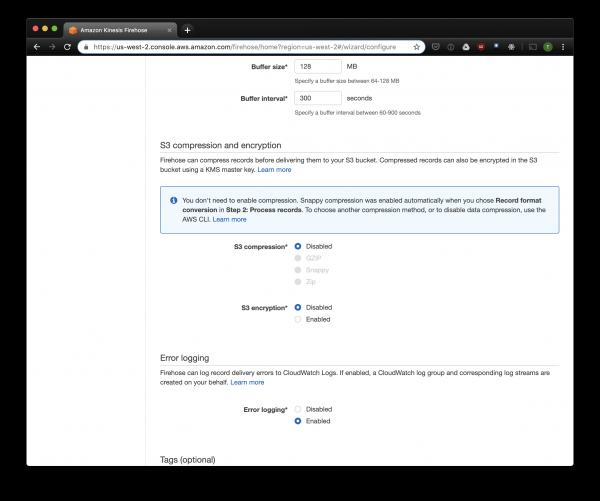
Ostale opcije mogu se mijenjati ovisno o vašem opterećenju, obično koristim zadane postavke. Imajte na umu da kompresija S3 nije dostupna, ali ORC koristi vlastitu kompresiju prema zadanim postavkama.
Fluentd
Sada kada smo postavili pohranu i primanje logova, trebamo postaviti slanje. Koristit ćemo , jer volim Ruby, ali možete koristiti Logstash ili izravno slati logove u Kinesis. Fluentd server može se pokrenuti na nekoliko načina; pričat ću o dockeru jer je to jednostavno i praktično.
Za početak, potreban nam je konfiguracijski datoteka fluent.conf. Kreirajte je i dodajte source:
forward
port 24224
bind 0.0.0.0
Sada možete pokrenuti Fluentd poslužitelj. Ako vam je potrebna naprednija konfiguracija, na dostupan je detaljan vodič, uključujući i informacije o tome kako sastaviti vlastitu sliku.
$ docker run
  -d
  -p 24224:24224
  -p 24224:24224/udp
  -v /data:/fluentd/log
  -v :/fluentd/etc fluentd
  -c /fluentd/etc/fluent.conf
  fluent/fluentd:stable
Ova konfiguracija koristi putanju /fluentd/log za keširanje logova prije slanja. Možete to izbjeći, ali tada možete izgubiti sve teško uhvaćene podatke prilikom ponovnog pokretanja. Također možete koristiti bilo koji port, 24224 je zadani port za Fluentd.
Sada, kada imamo pokrenut Fluentd, možemo slati logove Nginx-a tamo. Obično pokrećemo Nginx u Docker kontejneru, a u tom slučaju Docker ima nativni log drajver za Fluentd:
$ docker run
--log-driver=fluentd
--log-opt fluentd-address=
--log-opt tag="{{.Name}}"
-v /some/content:/usr/share/nginx/html:ro
-d
nginx
Ako pokrećete Nginx na drugi način, možete koristiti log datoteke, u Fluentd postoji .
Dodajmo u Fluent konfiguraciju parsiranje logova, postavljenu prije:
@type parser
  key_name log
  emit_invalid_record_to_error false

    @type json
I slanje logova u Kinesis, koristeći :
@type kinesis_firehose
    region region
    delivery_stream_name
    aws_key_id
    aws_sec_key
Athena
Ako ste sve ispravno postavili, tada biste nakon nekog vremena (kinesis po defaultu bilježi primljene podatke svake 10 minuta) trebali vidjeti log datoteke u S3. U izborniku „monitoring” Kinesis Firehose možete vidjeti koliko je podataka zapisano u S3, kao i greške. Ne zaboravite dati pristup za pisanje u S3 bucket za Kinesis ulogu. Ako Kinesis ne može nešto obraditi, zabilježit će greške u istom bucketu.
Sada možemo pregledati podatke u Atheni. Pronađimo najnovije upite na koje smo zabilježili greške:
SELECT * FROM "db_name"."table_name" WHERE status > 499 ORDER BY created_at DESC limit 10;Skener svih zapisa na svaki upit
Sada su наши logovi obrađeni i pohranjeni u S3 u ORC formatu, komprimirani i spremni za analizu. Kinesis Firehose ih je čak razdijelio po direktorijima na svaki sat. Međutim, dok tablica nije partitirana, Athena će učitavati podatke za cijelo vrijeme na svaki upit, uz rijetke iznimke. To je veliki problem iz dva razloga:
- Obim podataka kontinuirano raste, usporavajući upite;
- Račun za Athena se naplaćuje na temelju količine skeniranih podataka, s minimalno 10 MB za svaki upit.
Da bismo to ispravili, koristimo AWS Glue Crawler koji će skenirati podatke u S3 i zabilježiti informacije o particijama u Glue Metastoreu. To će nam omogućiti korištenje particija kao filtra prilikom upita u Atheni, te će ona skenirati samo direktorije navedene u upitu.
Postavljanje Amazon Glue Crawlera
Amazon Glue Crawler skenira sve podatke u S3 bucketu i stvara tablice s particijama. Kreirajte Glue Crawler iz AWS Glue konzole i dodajte bucket u kojem pohranjujete podatke. Možete koristiti jedan crawler za više bucketa, u tom slučaju će stvoriti tablice u navedenoj bazi podataka s nazivima koji odgovaraju nazivima bucketa. Ako planirate stalno koristiti ove podatke, ne zaboravite postaviti raspored pokretanja Crawlera prema vašim potrebama. Koristimo jedan Crawler za sve tablice, koji se pokreće svaki sat.
Particionirane tablice
Nakon prvog pokretanja crawlera, u bazi podataka navedene u postavkama, trebale bi se pojaviti tablice za svaki skenirani bucket. Otvorite Athena konzolu i pronađite tablicu s Nginx logovima. Pokušajmo nešto pročitati:
SELECT * FROM "default"."part_demo_kinesis_bucket"
WHERE(
  partition_0 = '2019' AND
  partition_1 = '04' AND
  partition_2 = '08' AND
  partition_3 = '06'
  );
Ovaj upit će izabrati sve zapise primljene od 6 do 7 ujutro 8. travnja 2019. godine. No, koliko je to učinkovitije nego jednostavno čitanje iz ne-particionirane tablice? Pokušajmo to saznati i izabrati iste zapise filtrirajući ih prema vremenskom oznaku:
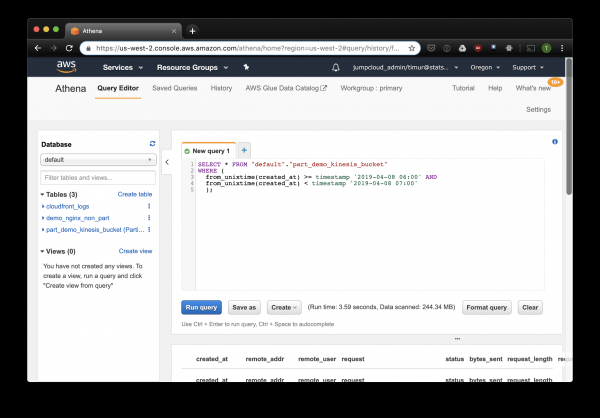
3.59 sekundi i 244.34 megabajta podataka na skupu podataka koji sadrži tjedan dana logova. Pokušajmo filtrirati po particijama:
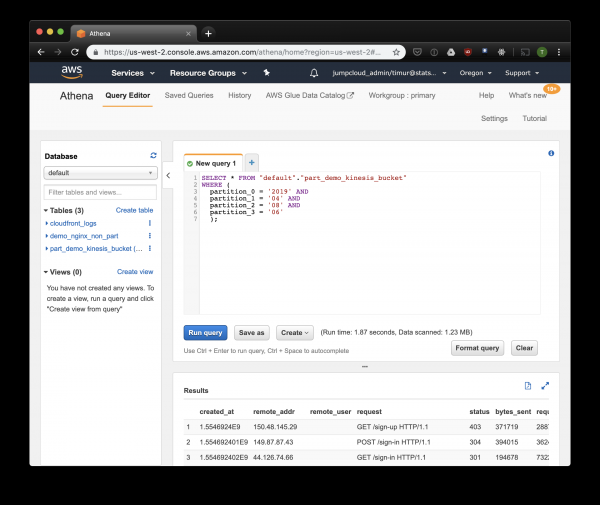
Malo brže, ali najvažnije — samo 1.23 megabajta podataka! To bi bilo znatno jeftinije da nije minimalnih 10 megabajta po zahtjevu u cijenama. No, i dalje je puno bolje, a razlika će na velikim skupovima podataka biti mnogo impresivnija.
Собираем дэшборд с помощью Cube.js
Da bismo sastavili nadzornu ploču, koristimo analitički okvir Cube.js. Ima prilično puno funkcija, ali nas zanimaju dvije: mogućnost automatskog korištenja filtara po particijama i pre-agregacije podataka. Koristi shemu podataka , napisanu na JavaScriptu, kako bi generirao SQL i izvršio upit prema bazi podataka. Od nas se traži samo da navedemo kako koristiti filtar po particijama u shemi podataka.
Kreirajmo novu aplikaciju Cube.js. Budući da već koristimo AWS stack, logično je koristiti Lambda za implementaciju. Možete koristiti express šablon za generaciju, ako planirate hostovati Cube.js backend na Heroku ili Dockeru. U dokumentaciji su opisani drugi .
$ npm install -g cubejs-cli
$ cubejs create nginx-log-analytics -t serverless -d athena
Za podešavanje pristupa bazi podataka u cube.js koriste se promenljive okruženja. Generator će kreirati datoteku .env u kojoj možete navesti svoje ključeve za .
Sada će nam biti potrebna , u kojoj ćemo navesti kako se tačno čuvaju naši logovi. Takođe možemo navesti kako računati metrike za nadzorne table.
U direktorijumu schema, kreirajte datoteku Logs.js. Evo primera modela podataka za nginx:
Kod modela
const partitionFilter = (from, to) => `
    date(from_iso8601_timestamp(${from})) = date_parse(partition_0 || partition_1 || partition_2, '%Y%m%d')
    `

cube(`Logs`, {
  sql: `
  select * from part_demo_kinesis_bucket
  WHERE ${FILTER_PARAMS.Logs.createdAt.filter(partitionFilter)}
  `,

  measures: {
    count: {
      type: `count`,
    },

    errorCount: {
      type: `count`,
      filters: [
        { sql: `${CUBE.isError} = 'Yes'` }
      ]
    },

    errorRate: {
      type: `number`,
      sql: `100.0 * ${errorCount} / ${count}`,
      format: `percent`
    }
  },

  dimensions: {
    status: {
      sql: `status`,
      type: `number`
    },

    isError: {
      type: `string`,
      case: {
        when: [{
          sql: `${CUBE}.status >= 400`, label: `Yes`
        }],
        else: { label: `No` }
      }
    },

    createdAt: {
      sql: `from_unixtime(created_at)`,
      type: `time`
    }
  }
});
Ovde koristimo promenljivu , da generišemo SQL upit sa filterom po particijama.
Takođe definišemo metrike i parametre koje želimo da prikažemo na nadzornoj tabli, i navodimo pre-agregacije. Cube.js će kreirati dodatne tabele sa pre-agregiranim podacima i automatski će ažurirati podatke kako pristižu. Ovo omogućava ne samo ubrzanje upita, već i smanjenje troškova korišćenja Athenе.
Dodajmo ove informacije u datoteku šeme podataka:
preAggregations: {
  main: {
    type: `rollup`,
    measureReferences: [count, errorCount],
    dimensionReferences: [isError, status],
    timeDimensionReference: createdAt,
    granularity: `day`,
    partitionGranularity: `month`,
    refreshKey: {
      sql: FILTER_PARAMS.Logs.createdAt.filter((from, to) =>
        `select
           CASE WHEN from_iso8601_timestamp(${to}) + interval '3' day > now()
           THEN date_trunc('hour', now()) END`
      )
    }
  }
}
U ovom modelu navodimo da je potrebno pre-agregirati podatke za sve korišćene metrike, i koristiti particionisanje po mesecima. može značajno ubrzati prikupljanje i ažuriranje podataka.
Sada možemo sastaviti nadzornu ploču!
Backend Cube.js pruža i skup klijentskih biblioteka za popularne frontend okvire. Iskoristit ćemo React verziju klijenta za izradu nadzorne ploče. Cube.js samo pruža podatke, tako da će nam trebati biblioteka za vizualizacije — sviđa mi se , ali možete koristiti bilo koju.
Server Cube.js prima zahtjev u , u kojem su navedene potrebne metrike. Na primjer, da bismo izračunali koliko grešaka Nginx šalje po danima, potrebno je poslati takav zahtjev:
{
  "measures": ["Logs.errorCount"],
  "timeDimensions": [
    {
      "dimension": "Logs.createdAt",
      "dateRange": ["2019-01-01", "2019-01-07"],
      "granularity": "day"
    }
  ]
}
Instalirajmo Cube.js klijent i React komponentu putem NPM-a:
$ npm i --save @cubejs-client/core @cubejs-client/reactImportamo komponente cubejs i QueryRenderer, kako bismo izvadili podatke i sastavili nadzornu ploču:
Kod nadzorne ploče
import React from 'react';
import { LineChart, Line, XAxis, YAxis } from 'recharts';
import cubejs from '@cubejs-client/core';
import { QueryRenderer } from '@cubejs-client/react';

const cubejsApi = cubejs(
  'YOUR-CUBEJS-API-TOKEN',
  { apiUrl: 'http://localhost:4000/cubejs-api/v1' },
);

export default () => {
  return (
     {
        if (!resultSet) {
          return 'Učitavanje...';
        }

        return (


        );
      }}
    />
  )
}
Izvori nadzorne ploče su dostupni na .
Izvor: habr.com
