

Ako upravljate virtualnom infrastrukturom temeljenom na VMware vSphere (ili bilo kojem drugom tehnologijskom stogu), sigurno često čujete od korisnika pritužbe: «Virtualna mašina radi sporo!». U ovom ciklusu članaka razmotrit ću metrike performansi i objasniti što i zašto « usporava » te kako učiniti da ne « usporava ».
Razmotrit ću sljedeće aspekte performansi virtualnih mašina:
- CPU,
- RAM,
- DISK,
- Mreža.
Počnem s CPU-om.
Za analizu performansi trebat će nam:
- vCenter Performance Counters – metričke pokazatelje performansi čije grafikone možete pogledati putem vSphere Clienta. Informacije o ovim pokazateljima dostupne su u bilo kojoj verziji klijenta (tvrdi klijent na C#, web-klijent na Flex i web-klijent na HTML5). U ovim člancima koristit ćemo snimke zaslona iz C# klijenta, samo zbog toga što izgledaju bolje u miniaturom :)
- ESXTOP – alat koji se pokreće iz naredbenog retka ESXi. Pomoću njega možete dobiti vrijednosti pokazatelja performansi u stvarnom vremenu ili izvesti te vrijednosti za određeno razdoblje u .csv datoteku za daljnju analizu. Kasnije ću detaljnije objasniti ovaj alat i navesti nekoliko korisnih poveznica na dokumentaciju i članke o ovoj temi.
Malo teorije
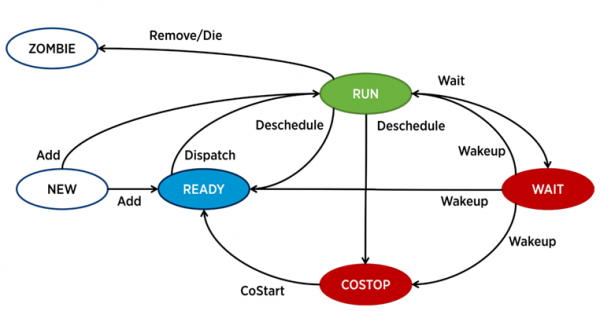
U ESXi za rad svakog vCPU (jezgre virtualne mašine) odgovara poseban proces – world u terminologiji VMware-a. Također postoje i pomoćni procesi, ali s gledišta analize performansi VM-a oni su manje zanimljivi.
Proces u ESXi može biti u jednom od četiri stanja:
- Run – proces obavlja neku korisnu aktivnost.
- Čekanje – proces ne obavlja nikakvu aktivnost (idle) ili čeka unos/izlaz.
- Costop – stanje koje se javlja u višekernelskim virtualnim mašinama. Dogodi se kada hipervizorov CPU planer (ESXi CPU Scheduler) ne može planirati istovremeno izvršenje na fizičkim jezgrama servera svih aktivnih jezgri virtualne mašine. U fizičkom svijetu sva jezgra procesora rade paralelno, gostujući OS unutar VM-a očekuje sličnu izvedbu, tako da hipervizoru preostaje usporiti jezgre VM-a koje imaju mogućnost bržeg završetka ciklusa. U modernim verzijama ESXi, CPU planer koristi mehanizam nazvan relaxed co-scheduling: hipervizor mjeri razliku između najbržeg i najsporijeg jezgra virtualne mašine (skew). Ako razlika premašuje određeni prag, „brzo“ jezgro prelazi u stanje costop. Ako jezgre VM-a provode previše vremena u ovom stanju, to može izazvati probleme s performansama.
- Spremno – proces prelazi u ovo stanje kada hipervizor nema mogućnost dodijeliti resurse za njegovo izvršavanje. Visoke vrijednosti ready mogu izazvati probleme s performansama VM-a.
Glavni pokazatelji performansi CPU-a virtualne mašine
CPU Usage, % Prikazuje postotak iskorištenosti CPU-a u određenom vremenskom razdoblju.
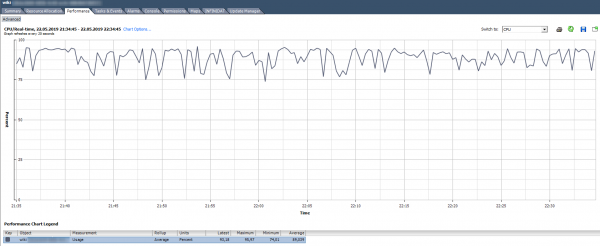
Kako analizirati? Ako VM stabilno koristi CPU na 90% ili postoje vrhovi do 100%, to znači da imamo problema. Problemi se mogu manifestirati ne samo u 'sporoj' izvedbi aplikacije unutar VM-a, već i u nedostupnosti VM-a putem mreže. Ako sustav nadzora pokazuje da VM povremeno gubi vezu, obratite pažnju na vrhove na grafu CPU Usage.
Postoji standardni alarm koji pokazuje opterećenje CPU-a virtualne mašine:
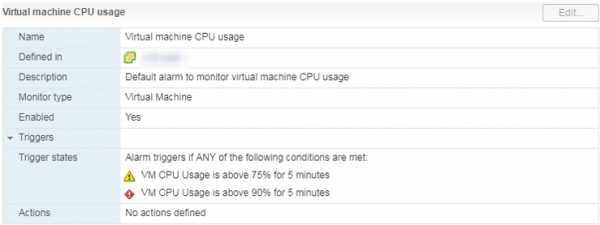
Što učiniti? Ako VM stalno premašuje CPU Usage, vrijedi razmisliti o povećanju broja vCPU-a (nažalost, to ne pomaže uvijek) ili o preseljenju VM-a na server s moćnijim procesorima.
CPU Usage in Mhz
Na grafikonima u vCenter Usage u % može se pogledati samo na cijeloj virtualnoj mašini, grafikon po pojedinačnim jezgri ne postoji (u Esxtop-u postoje postotci po jezgrama). Po svakom jezgru može se pogledati Usage in MHz.
Kako analizirati? Dogodi se da aplikacija nije optimizirana za višekratnu arhitekturu: koristi 100% samo jednu jezgru, dok ostale ostaju neiskorištene. Na primjer, pri zadanim postavkama MS SQL pokreće proces samo na jednoj jezgri. U konačnici, proces rezervnog kopiranja usporava se ne zbog spore brzine diska (na što se korisnik prvotno požalio), već zbog nedovoljnih performansi procesora. Problem je riješen podešavanjem postavki: rezervno kopiranje počelo se pokretati paralelno u nekoliko datoteka (odnosno, u nekoliko procesa).
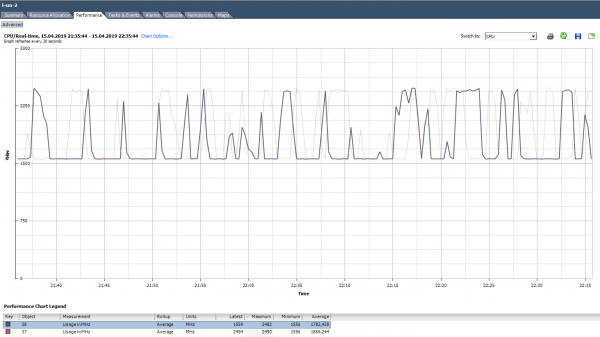
Primjer neujednačenog opterećenja jezgri.
Također može doći do situacije (kao na grafikonu iznad) kada su jezgre opterećene nejednako, a na nekima od njih postoje vrhovi od 100%. Kao i pri opterećenju samo jedne jezgre, alarm po CPU Usage neće se aktivirati (primjenjuje se na cijelu VM), ali problemi s performansama će biti prisutni.
Što učiniti? Ako softver u virtualnoj mašini opterećuje jezgre neujednačeno (koristi samo jednu jezgru ili dio jezgri), nema smisla povećavati njihov broj. U tom slučaju, bolje je premjestiti VM na server s moćnijim procesorima.
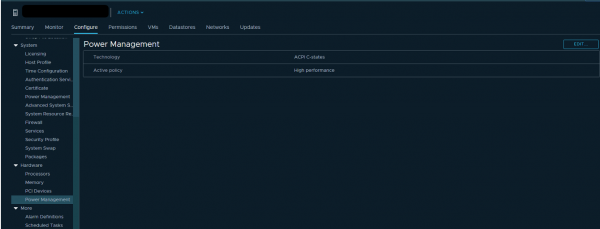
Također, možete pokušati provjeriti postavke potrošnje energije u BIOS-u servera. Mnogi administratori aktiviraju način rada Visoka izvedba u BIOS-u i na taj način isključuju tehnologije uštede energije C-states i P-states. U suvremenim Intel procesorima koristi se tehnologija Turbo Boost, koja povećava frekvenciju pojedinačnih jezgri procesora na račun drugih jezgri. Međutim, ona radi samo kada su tehnologije uštede energije uključene. Ako ih isključimo, procesor ne može smanjiti potrošnju energije jezgri koje nisu opterećene.
VMware preporučuje ne isključivati tehnologije uštede energije na serverima, već odabrati načine koji maksimum daju kontrolu potrošnje energije hipervizoru. Pritom u postavkama potrošnje energije hipervizora treba odabrati Visoku izvedbu.
Ako imate u infrastrukturi odvojene VM-ove (ili jezgre VM-a) koje zahtijevaju povećanu frekvenciju CPU-a, ispravna postavka potrošnje energije značajno može poboljšati njihovu izvedbu.
CPU Ready (Pripremljenost)
Ako je jezgra VM (vCPU) u stanju Ready, ne obavlja korisni rad. To stanje se javlja kada hipervizor ne može pronaći slobodnu fizičku jezgru kojoj bi mogao dodijeliti vCPU proces virtualne mašine.
Kako analizirati? Obično, ako jezgre virtualne mašine provode više od 10% vremena u stanju Ready, primijetit ćete probleme s performansama. Drugim riječima, više od 10% vremena VM čeka dostupnost fizičkih resursa.
U vCenteru možete vidjeti 2 mjerača povezana s CPU Ready:
- Readiness,
- Ready.
Vrijednosti oba mjerača možete pogledati kako za cijelu VM, tako i za pojedine jezgre.
Readiness prikazuje vrijednost odmah u postocima, ali samo u Real-time (podaci za posljednji sat, interval mjerenja 20 sekundi). Ovaj mjerač je bolje koristiti samo za pronalaženje problema 'na vrućem tragu'.
Vrijednosti mjerača Ready također se mogu pregledati u povijesnoj perspektivi. To je korisno za utvrđivanje obrazaca i za dublju analizu problema. Na primjer, ako virtualnoj mašini počnu problemi s performansama u određenom trenutku, možete usporediti intervale povišenih vrijednosti CPU Ready s opterećenjem na serveru na kojem ta VM radi i poduzeti mjere za smanjenje opterećenja (ako DRS ne uspije).
Ready, za razliku od Readiness, ne prikazuje se u postocima, već u milisekundama. To je mjerač tipa Summation, tj. pokazuje koliko je vremena tijekom mjernog razdoblja jezgra VM provela u stanju Ready. Ovu vrijednost možete pretvoriti u postotke prema jednostavnoj formuli:
(vrijednost summacije CPU ready / (definirani interval ažuriranja grafikona u sekundama * 1000)) * 100 = CPU ready %
Na primjer, za VM na grafu ispod, maksimalna vrijednost Ready za cijelu virtualnu mašinu bit će sljedeća:

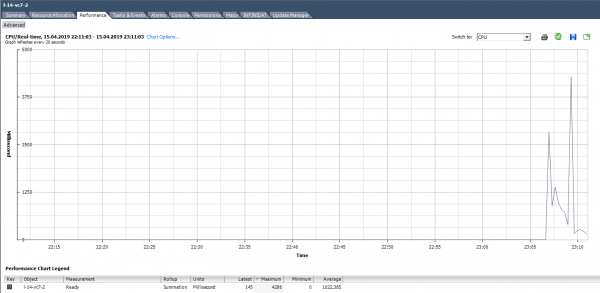
Prilikom izračunavanja vrijednosti Ready u postocima, važno je obratiti pažnju na dva aspekta:
- Vrijednost Ready za cijelu VM je zbroj Ready po jezgrama.
- Interval mjerenja. Za Real-time – to je 20 sekundi, a, na primjer, na dnevnim grafikonima – to je 300 sekundi.
Prilikom aktivnog rješavanja problema, ove jednostavne stvari lako se mogu propustiti, a vi možete potrošiti dragocjeno vrijeme na rješavanje nepostojećih problema.
Izračunamo Ready na osnovu podataka iz grafikona ispod. (324474/(20*1000))*100 = 1622% za cijeli VM. Ako se gleda po jezgrama, situacija nije tako strašna: 1622/64 = 25% po jezgri. U ovom slučaju, otkriti zamku nije teško: vrijednost Ready je nerealistična. No, kada je riječ o 10–20% za cijeli VM s više jezgri, svaka jezgara može biti unutar normi.
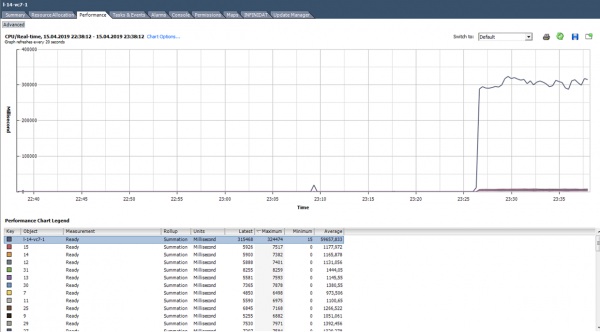
Što učiniti? Visoka vrijednost Ready ukazuje na to da serveru nedostaju CPU resursi za normalan rad virtualnih mašina. U takvoj situaciji ostaje samo smanjiti prekladanje po procesoru (vCPU:pCPU). Očigledno, to se može postići smanjenjem parametara postojećih VM-ova ili migracijom dijela VM-ova na druge servere.
Co-stop
Kako analizirati? Ovaj brojač također ima tip Summation i prevodi se u postotke slično kao Ready:
(CPU co-stop summation value / (chart default update interval in seconds * 1000)) * 100 = CPU co-stop %
Ovdje također treba obratiti pažnju na broj jezgri na VM-u i na interval mjerenja.
U stanju co-stop jezgra ne obavlja korisni rad. Pri pravilnom odabiru veličine VM-a i normalnom opterećenju na serveru, brojčanik co-stop trebao bi biti blizu nule.
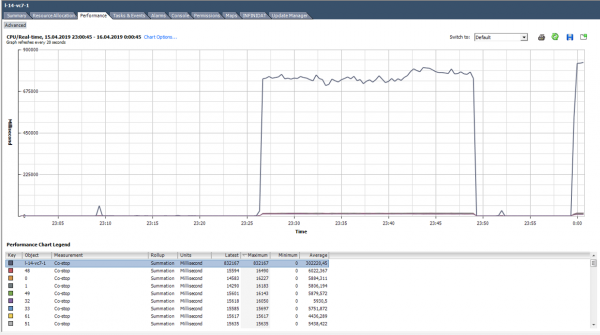
U ovom slučaju, opterećenje je očigledno nenormalno :)
Što učiniti? Ako na jednom hipervizoru radi više VM-ova s velikim brojem jezgri i postoji prekladanje po CPU-u, tada se brojač co-stop može povećati, što će dovesti do problema s performansama tih VM-ova.
Također, co-stop će rasti ako se za aktivne jezgre jedne VM koriste niti na jednom fizičkom jegru servera s uključenim hyper-threadingom. Ova situacija može nastati, na primjer, ako VM ima više jezgri nego što fizički postoji na serveru na kojem radi, ili ako je za VM uključena opcija 'preferHT'. O ovoj postavci možete pročitati .
Kako biste izbjegli probleme s performansama VM-a zbog visokog co-stop-a, odaberite veličinu VM-a prema preporukama proizvođača softvera koji radi na toj VM-u, kao i prema mogućnostima fizičkog servera na kojem se VM nalazi.
Ne dodajte jezgre na rezervu, to može izazvati probleme s performansama ne samo same VM-a, već i njenih susjeda na serveru.
Ostale korisne metrike CPU-a
Run – koliko je vremena (ms) u razdoblju mjerenja vCPU bio u stanju RUN, odnosno izvorno obavljao korisni rad.
Idle – koliko je vremena (ms) vCPU bio u stanju neaktivnosti tijekom mjerenja. Visoke vrijednosti Idle nisu problem, jednostavno vCPU nije imao "što raditi".
Čekanje – koliko je vremena (ms) vCPU bio u stanju Wait tijekom mjerenja. Budući da ovaj brojač uključuje IDLE, visoke vrijednosti Wait također ne govore o problemu. Međutim, ako je IDLE nizak dok je Wait visok, to znači da je VM čekao završetak operacija ulaza/izlaza, što može ukazivati na probleme s performansama tvrdog diska ili nekih virtualnih uređaja VM-a.
Max limited – koliko je vremena (ms) vCPU bio u stanju Ready zbog postavljenih resursnih limita. Ako je performansa neobjašnjivo niska, korisno je provjeriti vrijednost ovog brojača i limit CPU-a u postavkama VM-a. VM-ovi mogu imati postavljene limite za koje niste ni svjesni. Na primjer, to se događa kada je VM kloniran iz predloška na kojem su postavljeni limiti za CPU.
Swap wait – koliko je vremena tijekom mjerenja vCPU čekao operacije s VMkernel Swap. Ako su vrijednosti ovog brojača iznad nule, sigurno postoje problemi s performansama VM-a. Detaljnije o SWAP-u razgovarat ćemo u članku o brojačima radne memorije.
ESXTOP
Ako su brojači performansi u vCenteru dobri za analizu povijesnih podataka, bržu analizu problema najbolje je provesti u ESXTOP-u. Ovdje su sve vrijednosti predstavljene u gotovom obliku (nije potrebno ništa prevoditi), a minimalno razdoblje mjerenja je 2 sekunde.
Ekran ESXTOP-a za CPU poziva se tipkom „c” i izgleda ovako:

Za prakticnost možete ostaviti samo procese virtualnih mašina pritiskom na Shift-V.
Da biste pogledali metrike za pojedinačne jezgre VM-a, pritisnite „e” i unesite GID zanimljive VM (30919 na snimci ispod):
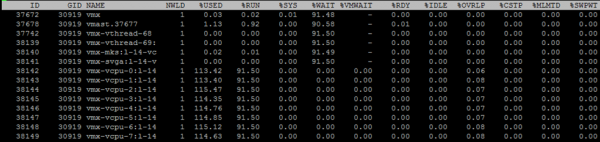
Kratko ću proći kroz stupce koji su navedeni po defaultu. Dodatne stupce možete dodati pritiskom na „f”.
NWLD (Number of Worlds) – broj procesa u grupi. Da biste otkrili grupu i vidjeli metrike za svaki proces (na primjer, za svaku jezgru višekernog VM-a), pritisnite „e”. Ako u grupi ima više od jednog procesa, vrijednosti metrika za grupu jednake su zbroju metrika za pojedine procese.
%USED – koliko ciklusa CPU server koristi proces ili grupa procesa.
%RUN – koliko je vremena tijekom mjerenja proces bio u stanju RUN, tj. obavljao je korisni rad. Razlikuje se od %USED po tome što ne uzima u obzir hiper-threading, promjenu frekvencije i vrijeme provedeno na sistemskim zadacima (%SYS).
%SYS – vrijeme provedeno na sistemskim zadacima, primjerice: obrada prekida, ulaz/izlaz, rad mreže itd. Vrijednost može biti visoka ako VM ima veliki ulaz/izlaz.
%OVRLP – koliko je vremena fizičko jezgro, na kojem se izvodi VM proces, provelo na zadacima drugih procesa.
Ove metrike su međusobno povezane na sljedeći način:
%USED = %RUN + %SYS — %OVRLP.
Obično je metrike %USED informativnije.
%WAIT – koliko je vremena tijekom mjerenja proces bio u stanju Wait. Uključuje IDLE.
%IDLE – koliko je vremena tijekom mjerenja proces bio u stanju IDLE.
%SWPWT – koliko je vremena tijekom mjerenja vCPU čekao na operaciju s VMkernel Swap.
%VMWAIT – koliko je vremena tijekom mjerenja vCPU bio u stanju čekanja na događaj (obično ulaz/izlaz). Takav brojač ne postoji u vCenter. Visoke vrijednosti ukazuju na probleme s ulazom/izlazom na VM.
%WAIT = %VMWAIT + %IDLE + %SWPWT.
Ako VM ne koristi VMkernel Swap, prilikom analize problema s performansama, smisleno je gledati na %VMWAIT, jer ova metrike ne uzima u obzir vrijeme kada VM nije radila (%IDLE).
%RDY – koliko je vremena tijekom mjerenja proces bio u stanju Ready.
%CSTP – koliko je vremena tijekom mjerenja proces bio u stanju costop.
%MLMTD – koliko je vremena tijekom mjerenja vCPU bio u stanju Ready zbog postavljenog limita resursa.
%WAIT + %RDY + %CSTP + %RUN = 100% – jezgro VM-a je uvijek u jednom od ta četiri stanja.
CPU na hipervizoru
U vCenter također postoje mjerni podaci o performansama CPU-a za hipervizor, ali nisu zanimljivi – to je samo zbroj mjernih podataka svih VM-ova na serveru.
Najlakše je gledati stanje CPU-a na serveru na kartici Sažetak:
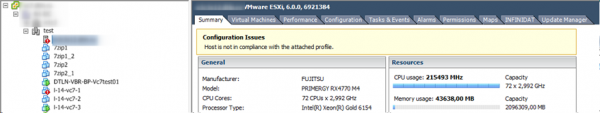
Za server, kao i za virtualnu mašinu, postoji standardno upozorenje:
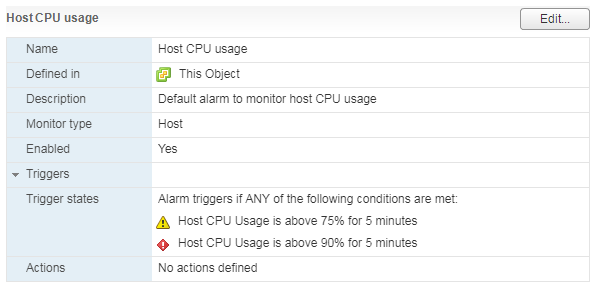
Pri visokom opterećenju CPU-a servera, VM-ovi koji rade na njemu počinju imati problema s performansama.
Na ESXTOP-u, podaci o opterećenju CPU-a servera prikazani su u gornjem dijelu ekrana. Osim standardnog CPU load-a, koji je malo informativan za hipervizore, postoje još tri metrike:
CORE UTIL(%) – opterećenje jezgre fizičkog servera. Ovaj brojač pokazuje koliko je vremena tijekom mjernog razdoblja jezgra obavljala posao.
PCPU UTIL(%) – ako je uključen hyper-threading, na svaku fizičku jezgru dolaze dva toka (PCPU). Ova metrika pokazuje koliko je vremena svaki tok obavljao posao.
PCPU USED(%) – isto što i PCPU UTIL(%), ali uzima u obzir frequency scaling (smanjenje ili povećanje frekvencije jezgre u cilju uštede energije) i hyper-threading.
PCPU_USED% = PCPU_UTIL% * efikasnu frekvenciju jezgre / nominalnu frekvenciju jezgre.
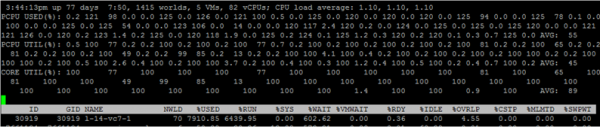
Na ovom screenshot-u, zbog rada Turbo Boost-a, vrijednost USED za neka jezgra je veća od 100%, jer je frekvencija jezgre iznad nominalne.
Nekoliko riječi o tome kako se uzima u obzir hyper-threading. Ako procesi rade 100% vremena na oba toka fizičkog jezgra servera, dok jezgra radi na nominalnoj frekvenciji, tada:
- CORE UTIL za jezgru će biti 100%,
- PCPU UTIL za oba toka će biti 100%,
- PCPU USED za oba toka će biti 50%.
Ako oba toka nisu radila 100% vremena tijekom mjernog razdoblja, onda se u razdobljima kada su tokovi radili paralelno, PCPU USED za jezgre dijeli s polovicom.
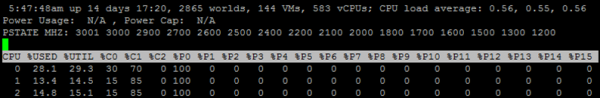
Na ESXTOP-u postoji i ekran s parametrima potrošnje energije CPU-a servera. Ovdje možete vidjeti koristi li server tehnologije uštede energije: C-states i P-states. Poziva se tipkom ‘p’:
Standardni problemi performansi CPU-a
Na kraju, spomenut ću tipične uzroke problema s performansama CPU-a VM-a i dati kratke savjete za njihovo rješavanje:
Nedovoljna taktjna frekvencija jezgre. Ako nije moguće prevesti VM na produktivnije jezgre, možete pokušati promijeniti postavke potrošnje energije kako bi Turbo Boost funkcionirao učinkovitije.
Pogrešno dimenzioniranje VM-a (previše/malo jezgri). Ako se postavi premalo jezgri, dobit ćete visoko opterećenje CPU-a VM-a. Ako ih postavite previše, naići ćete na visok co-stop.
Velika prekomjerna dodjela CPU-a na serveru. Ako je na VM-u visok Ready, smanjite prekomjernu dodjelu CPU-a.
Pogrešna NUMA topologija na velikim VM-ima. NUMA topologija koju vidi VM (vNUMA) mora odgovarati NUMA topologiji servera (pNUMA). O dijagnostici i mogućim rješenjima ovog problema pisano je, na primjer, u knjizi . Ako se ne želite produbljivati i nemate licencne ograničenja vezano uz OS instaliran na VM-u, napravite na VM-u mnogo virtualnih utičnica po jedno jezgro. Nećete puno izgubiti 🙂
Na tome o CPU-ima završavam. Postavite pitanja. U sljedećem dijelu pričat ću o radnoj memoriji.
Koristitne veze
Izvor: habr.com
