

Danas ćemo razmotriti metrike diskovnog sustava u vSphere-u. Problemi sa pohranom su najčešći uzrok sporog rada virtualne mašine. Dok se u slučajevima s CPU-om i RAM-om rješavanje problema završava na razini hipervizora, kod problema s diskom, možda će biti potrebno istražiti mrežu prijenosa podataka i SAN.
Tema će biti razmatrana na primjeru blokovskog pristupa SAN-u, iako su brojila otprilike ista i kod datotečnog pristupa.
Malo teorije
Kada se govori o performansama diskovnog sustava virtualnih mašina, obično se obraća pažnja na tri međusobno povezana parametra:
- broj operacija ulaza/izlaza (Input/Output Operations Per Second, IOPS);
- propusnost (Throughput);
- kašnjenje operacija ulaza/izlaza (Latency).
Broj IOPS-a obično je važan za naslove proizvoljnog karaktera (random): pristup blokovima na disku koji su smješteni na različitim mjestima. Primjer takvog opterećenja mogu biti baze podataka, poslovne aplikacije (ERP, CRM) itd.
Propusnost važan je za naslove sekvencijalnog karaktera: pristup blokovima koji su smješteni jedan iza drugog. Na primjer, takvo opterećenje mogu generirati datotečni poslužitelji (ali ne uvijek) i sustavi videonadzora.
Propusnost je povezana s brojem operacija ulaza/izlaza na sljedeći način:
Throughput = IOPS * Veličina bloka, gdje je Veličina bloka zapravo veličina bloka.
Veličina bloka je prilično važna karakteristika. Moderne verzije ESXi-a propuštaju blokove veličine do 32 767 KB. Ako je blok još veći, dijeli se na više. Ne svi SAN-ovi mogu učinkovito raditi s tako velikim blokovima, pa u Advanced Settings ESXi postoji parametar DiskMaxIOSize. Uz njegovu pomoć možete smanjiti maksimalnu veličinu bloka koja se propušta kroz hipervizor (više o tome ). Preporučujem da se prije promjene ovog parametra konzultirate s proizvođačem SAN-a ili barem testirate promjene na laboratorijskom postavu.
Velika veličina bloka može nepovoljno utjecati na performanse SAN-a. Čak i ako je broj IOPS-a i throughput relativno mali, pri velikoj veličini bloka mogu se primijetiti visoka kašnjenja. Zato obratite pažnju na ovaj parametar.
Kašnjenje – najzanimljiviji parametar performansi. Kašnjenje operacija ulaza/izlaza za virtualnu mašinu sastoji se od:
- kašnjenja unutar hipervizora (KAVG, Prosječno vrijeme izvršavanja jezgre - Milisekunde/Čitanje);
- kašnjenja koja uzrokuju mreža za prijenos podataka i SAN (DAVG, Prosječno vrijeme vozača - Milisekunde/Komanda).
Ukupno kašnjenje koje se vidi u gostujućem OS-u (GAVG, Prosječno gostujuće vrijeme - Milisekunde/Komanda) je zbroj KAVG i DAVG.
GAVG i DAVG se mjere, a KAVG se izračunava: GAVG–DAVG.
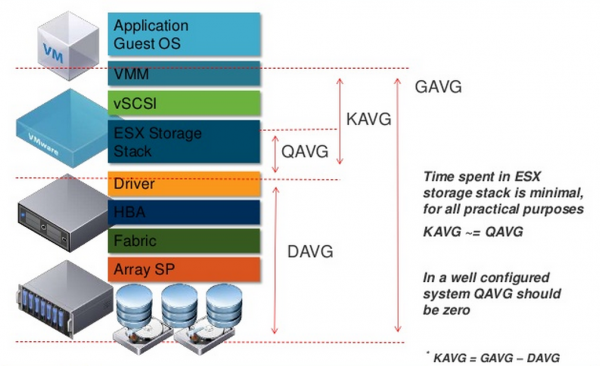
Detaljnije o KAVG. U normalnim uvjetima KAVG bi trebao biti blizu nule ili, barem, znatno manji od DAVG. Jedini poznati slučaj kada je KAVG očekivano visok je ograničenje IOPS na disku VM-a. U tom slučaju, kada se pokuša premašiti limit, KAVG će rasti.
Najznačajnija komponenta KAVG-a je QAVG – vrijeme provedeno u redu za obradu unutar hipervizora. Ostale komponente KAVG-a su zanemarive.
Red u upravljačkom vozaču diska i redovi prema lunama imaju fiksnu veličinu. Za visoko opterećena okruženja, korisno je povećati ovu veličinu. opisano je kako povećati redove u vozaču adaptera (istovremeno će se povećati i red prema lunama). Ova postavka radi kada jedna VM radi s lunama, što je rijetko. Ako na luni radi više VM-ova, potrebno je također povećati parametar Disk.SchedNumReqOutstanding (uputstvo ). Povećanjem reda smanjujete QAVG i KAVG prema tome.
No, opet, prvo se upoznajte s dokumentacijom dobavljača HBA i testirajte promjene na laboratorijskoj postavci.
Na veličinu reda prema luni može utjecati uključivanje mehanizma SIOC (Storage I/O Control). On osigurava ravnomjeran pristup lunama sa strane svih servera u klasteru dinamičkim promjenama reda prema lunama na serverima. Drugim riječima, ako na nekom od hostova radi VM koja zahtijeva nesrazmjerno mnogo performansi (noisy neighbor VM), SIOC smanjuje duljinu reda prema lunama na tom hostu (DQLEN). Više informacija .
O KAVG-u smo razjasnili, sada malo o DAVG. Ovdje je sve jednostavno: DAVG je kašnjenje koje unosi vanjsko okruženje (mreža za prijenos podataka i SAN). U bilo kojoj suvremenoj i nezamjenjivoj SAN-u postoje vlastiti pokazatelji performansi. Za analizu problema s DAVG-om ima smisla pogledati ih. Ako je s ESXi i SAN-om sve u redu, provjerite mrežu za prijenos podataka.
Kako biste izbjegli probleme s performansama, odaberite pravu Politiku odabira puta (PSP) za vaš SAN. Gotovo svi moderni SAN-ovi podržavaju PSP Round-Robin (s ALUA, Asimetrični pristup logičkim jedinicama, ili bez). Ova politika omogućava korištenje svih dostupnih puteva do SAN-a. U slučaju ALUA koriste se samo putevi do kontrolera koji posjeduje LUN. Nisu svi SAN-ovi na ESXi-u unaprijed definirani s pravilima koja postavljaju politiku Round-Robin. Ako za vaš SAN nema pravila, koristite dodatak od proizvođača SAN-a, koji će stvoriti odgovarajuće pravilo na svim hostovima klastera, ili izradite pravilo sami. Detalji .
Također, neki proizvođači SAN-a preporučuju da se broj IOPS-a na putu promijeni s standardne vrijednosti 1000 na 1. U našoj praksi to je omogućavalo 'izvlačenje' veće performanse iz SAN-a i znatno smanjenje vremena potrebnog za prebacivanje u slučaju kvara ili nadogradnje kontrolera. Provjerite preporuke dobavljača, i ako nema kontraindikacija, pokušajte promijeniti ovu postavku. Detalji .
Glavni pokazatelji performansi diskovnog podsustava virtualne mašine
Pokazatelji performansi diskovnog podsustava u vCenteru prikupljeni su u odjeljcima Datastore, Disk, Virtual Disk:
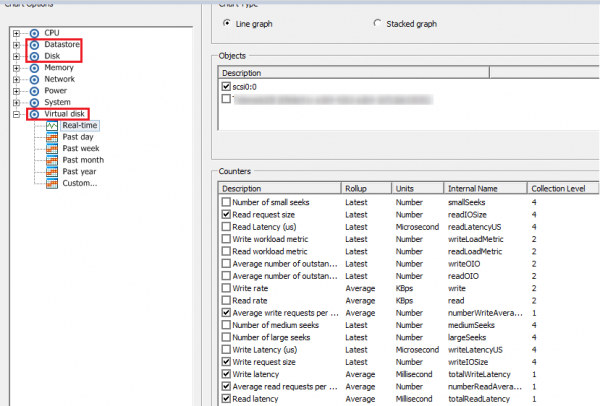
U odjeljku Datastore nalaze se metrike za diskovne pohrane vSphere (datastore) na kojima su pohranjeni diskovi VM-a. Ovdje ćete pronaći standardne pokazatelje za:
- IOPS (prosječni zahtjevi za čitanjem/pisanjem po sekundi),
- propusnost (stopa čitanja/pisanja),
- kašnjenja (najveće kašnjenje čitanja/pisanja).
Iz naziva pokazatelja sve je prilično jasno. Ponovno naglašavam da ovdje statistika nije specifična za određenu VM (ili disk VM-a), već je opća prema cijelom datastoreu. Po mom mišljenju, ovu statistiku je lakše pregledati u ESXTOP-u, barem izvodeći iz toga da je minimalni period mjerenja tamo 2 sekunde.
U odjeljku Disk nalaze se metrike za blok uređaje koji se koriste u VM-ima. Tu su pokazatelji za IOPS tipa summation (broj ulazno/izlaznih operacija tijekom mjernog razdoblja) i nekoliko pokazatelja koji se odnose na blokovni pristup (Commands aborted, Bus resets). Ove informacije, po mom mišljenju, također je lakše pregledati u ESXTOP-u.
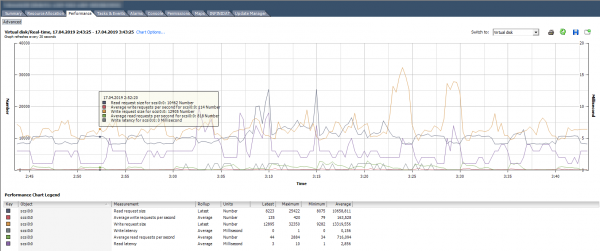
Odjeljak Virtual Disk – najkorisnija informacija za prepoznavanje problema s performansama diskovnog sustava VM-a. Ovdje se može vidjeti performanse svakog virtuelnog diska. Ove informacije su potrebne za razumijevanje postoji li problem na određenoj virtuelnoj mašini. Osim standardnih mjera broja operacija ulaza/izlaza, obima čitanja/pisanja i latencije, u ovom odjeljku su prisutni korisni mjerni podaci koji pokazuju veličinu bloka: Veličina Read/Write zahtjeva.
Na slici ispod je prikaz performansi diska VM-a, gdje se može vidjeti broj IOPS, latencija i veličina bloka.
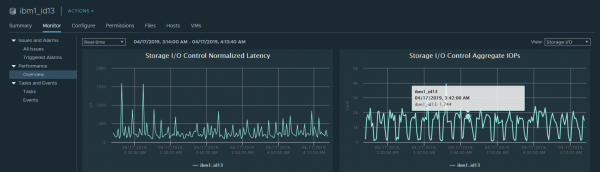
Također, metrike performansi mogu se pogledati za cijeli datastore ako je SIOC uključen. Ovdje su predstavljene osnovne informacije o prosječnoj latenciji i IOPS-ima. Ove informacije su dostupne samo u stvarnom vremenu prema zadanim postavkama.
ESXTOP
U ESXTOP-u postoji nekoliko ekrana na kojima su predstavljene informacije o diskovnom sustavu domaćina, određenim virtuelnim mašinama i njihovim diskovima.
Započet ćemo s informacijama o virtuelnim mašinama. Ekran 'Disk VM' poziva se tipkom 'v':
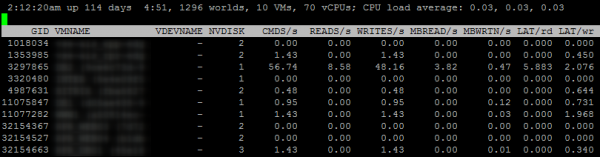
NVDISK – to je broj diskova VM-a. Da biste vidjeli informacije o svakom disku, pritisnite 'e' i unesite GID interesantne VM.
Vrijednost ostalih parametara na ovom ekranu jasna je iz njihovih naziva.
Još jedan koristan ekran za pronalaženje problema je Disk adapter. Poziva se tipkom 'd' (na slici ispod su odabrana polja A, B, C, D, E, G):
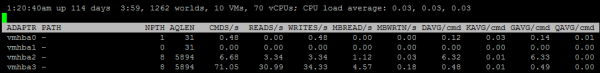
NPTH – broj putanja do lun-a koji su vidljivi s ovog adaptera. Da biste dobili informacije o svakoj putanji na adapteru, pritisnite 'e' i unesite naziv adaptera:
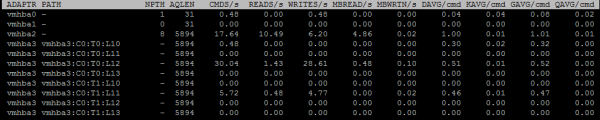
AQLEN – maksimalna veličina reda na adapteru.
Također, na ovom ekranu su prikazani mjerni podaci o latenciji o kojima sam govorio ranije: KAVG/cmd, GAVG/cmd, DAVG/cmd, QAVG/cmd.
Na ekranu Disk device, koji se poziva tipkom 'u', predstavljene su informacije o pojedinačnim blokovnim uređajima – lun-ovima (na slici ispod su odabrana polja A, B, F, G, I). Ovdje možete vidjeti stanje reda za lun-ove.

DQLEN – veličina reda za blok uređaj.
ACTV – broj ulazno/izlaznih komandi u jezgru ESXi.
QUED – broj ulazno/izlaznih komandi u redu.
%USD – ACTV / DQLEN × 100%.
LOAD – (ACTV + QUED) / DQLEN.
Ako je %USD visok, treba razmotriti povećanje reda. Što više komandi u redu, veći je QAVG i, shodno tome, KAVG.
Na ekranu Disk device također možete provjeriti radi li VAAI (vStorage API for Array Integration) na SAN-u. Da biste to učinili, odaberite polja A i O.
Mehanizam VAAI omogućuje premještanje dijela posla iz hipervizora izravno na SAN, na primjer, nulte blokove, kopiranje blokova ili zaključavanje.

Kao što je prikazano na slici iznad, VAAI radi na ovom SAN-u: aktivno se koriste primitivni Zero i ATS.
Savjeti za optimizaciju rada s diskovnim podsustavom na ESXi.
- Obratite pozornost na veličinu bloka.
- Postavite optimalnu veličinu reda na HBA.
- Ne zaboravite uključiti SIOC na datastore-ima.
- Odaberite PSP u skladu s preporukama proizvođača SAN-a.
- Provjerite radi li VAAI.
Korisni članci o temi:
Izvor: habr.com
