

Baza podataka vremenskih serija (TSDB, time series database) u Prometheusu 2 predstavlja izvrstan primjer inženjerskog rješenja koje nudi značajna poboljšanja u odnosu na skladište v2 u Prometheusu 1, posebno u pogledu brzine prikupljanja podataka i izvršavanja upita, kao i učinkovitosti iskorištenja resursa. Implementirali smo Prometheus 2 u Percona Monitoring and Management (PMM), i imao sam priliku istražiti performanse Prometheus 2 TSDB. U ovom članku ću podijeliti rezultate tih uvida.
Prosječno opterećenje Prometheusa
Za one koji su navikli na rad s bazama podataka opće namjene, uobičajeno opterećenje Prometheusa prilično je zanimljivo. Brzina prikupljanja podataka teži stabilnoj vrijednosti: obično usluge koje pratite šalju približno jednake količine metrike, a infrastruktura se mijenja relativno sporo.
Upiti za informacije mogu dolaziti iz različitih izvora. Neki od njih, poput upozorenja, također teže stabilnoj i predvidivoj vrijednosti. Drugi, poput korisničkih upita, mogu izazvati izlete, iako to nije karakteristično za veći dio opterećenja.
Test opterećenja
Tijekom testiranja, fokusirao sam se na sposobnost prikupljanja podataka. Postavio sam Prometheus 2.3.2, kompajliran s Go 1.10.1 (kao dio PMM 1.14) na usluzi Linode, koristeći ovu skriptu: . Za što realističnije generiranje opterećenja, pomoću ovog pokrenuo sam nekoliko MySQL čvorova s stvarnim opterećenjem (Sysbench TPC-C Test), pri čemu je svaki od njih emulirao 10 Linux/MySQL čvorova.
Svi sljedeći testovi provedeni su na Linode serveru s osam virtualnih jezgri i 32 GB memorije, na kojem se pokreće 20 simulacija opterećenja nad dvjesto MySQL instanci. Ili, u terminima Prometheusa, 800 ciljeva (targets), 440 prikupljanja (scrapes) u sekundi, 380 tisuća zapisa (samples) u sekundi i 1,7 milijuna aktivnih vremenskih serija.
Dizajn
Uobičajeni pristup tradicionalnih baza podataka, uključujući onaj koji je koristio Prometheus 1.x, temelji se na . Ako nije dovoljno da izdrži opterećenje, suočit ćete se s velikim kašnjenjima, a neki upiti neće biti izvršeni. Korištenje memorije u Prometheusu 2 konfigurira se putem ključa storage.tsdb.min-block-duration, koji određuje koliko dugo će zapisi biti pohranjeni u memoriji prije nego što se isprazne na disk (zadano je 2 sata). Potrebna količina memorije ovisit će o broju vremenskih serija, oznakama (labels) i intenzitetu prikupljanja podataka (scrapes) zajedno s čistim ulaznim tokom. U pogledu prostora na disku, Prometheus nastoji koristiti 3 bajta po zapisu (sample). S druge strane, zahtjevi za memorijom su mnogo viši.
Iako postoji mogućnost konfiguracije veličine bloka, nije preporučljivo ručno ga podešavati, stoga ste primorani dati Prometheusu onoliko memorije koliko traži za vašu opterećenje.
Ako memorije ne bude dovoljno da podrži ulazni tok metrika, Prometheus će se srušiti zbog nedostatka memorije ili će ga doći OOM killer.
Dodavanje swap-a radi odgađanja trenutka pada kada Prometheusu ponestane memorije ne pomaže previše, jer korištenje ove funkcije izaziva eksplozivnu potrošnju memorije. Mislim da je to zbog Go-a, njegovog sakupljača smeća i načina na koji radi sa swap-om.
Drugi zanimljiv pristup izgleda kao podešavanje ispraznjenja head bloka na disk u određeno vrijeme, umjesto da se odbrojava od trenutka pokretanja procesa.
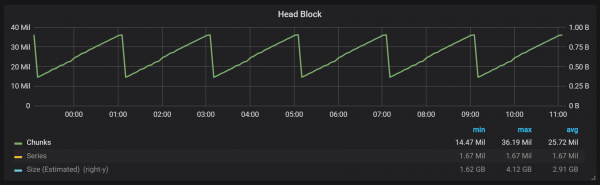
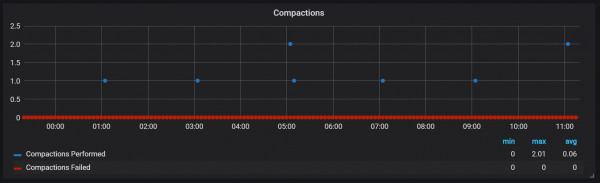
Kao što možete vidjeti iz grafikona, ispraznjenja na disk događaju se svaka dva sata. Ako promijenite parametar min-block-duration na jedan sat, ispraznjenja će se događati svaki sat, počinjući za pola sata.
Ako želite koristiti ovaj i druge grafikone u vašoj instalaciji Prometheus, možete koristiti ovaj . Razvijen je za PMM, ali uz manje izmjene, odgovara svakoj instalaciji Prometheus.
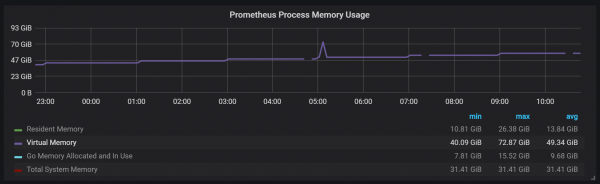
Imamo aktivni blok, nazvan head block, koji se pohranjuje u memoriji; blokovi s starijim podacima dostupni su preko mmap(). To uklanja potrebu za odvojenom konfiguracijom кеша, ali također znači da trebate ostaviti dovoljno prostora za кеш operacijskog sustava ako želite postavljati zahtjeve za podacima starijim od onih koje glavni blok može obraditi.
Također to znači da će potrošnja virtualne memorije od strane Prometheusa izgledati prilično visoko, o čemu ne treba brinuti.
Još jedna zanimljiva stvar u dizajnu je korištenje WAL-a (write ahead log). Kao što se može vidjeti iz dokumentacije o skladištu, Prometheus koristi WAL kako bi izbjegao gubitke prilikom padova. Nažalost, konkretni mehanizmi osiguravanja otpornosti podataka nisu dovoljno dokumentirani. Verzija Prometheus 2.3.2 bilježi WAL na disk svakih 10 sekundi, a ovaj parametar nije konfigurabilan od strane korisnika.
Komplikacije (Compactions)
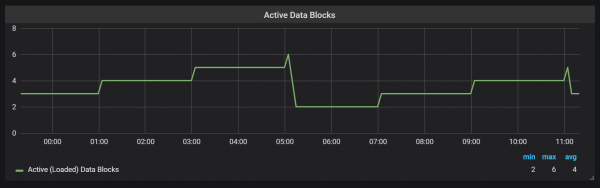
Prometheus TSDB je dizajniran po uzoru na LSM skladište (Log Structured Merge — struktura sa zapisima i spajanjem): head block se periodično snima na disk, dok mehanizam kompliciranja spaja nekoliko blokova zajedno kako bi se izbjeglo pretraživanje prevelikog broja blokova tijekom upita. Ovdje se vidi broj blokova koje sam promatrao na testnom sustavu nakon jednog dana opterećenja.
Ako želite saznati više o skladištu, možete proučiti datoteku meta.json koja sadrži informacije o postojećim blokovima i o tome kako su nastali.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Komplikacije u Prometheus-u vezane su uz vrijeme kada se head block snima na disk. U tom trenutku može se obaviti nekoliko takvih operacija.
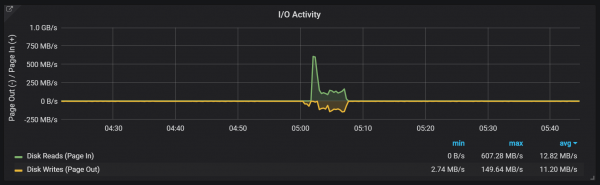
Čini se da kompresije nisu na bilo koji način ograničene i mogu uzrokovati velike skokove diska I/O tijekom izvođenja.
Skokovi opterećenja CPU-a
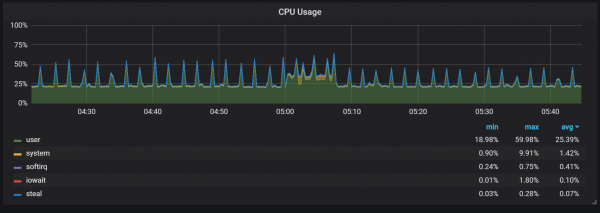
Naravno, to prilično negativno utječe na brzinu rada sustava i predstavlja ozbiljan izazov za LSM skladišta: kako obaviti kompresije kako bi se održala visoka brzina upita, a da se ne izazove preveliki overhead?
Korištenje memorije u procesu kompresija također izgleda prilično zanimljivo.
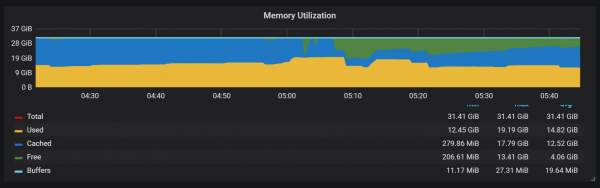
Možemo vidjeti kako nakon kompresije većina memorije mijenja stanje s Cached na Free: to znači da je potencijalno dragocjena informacija uklonjena odatle. Zanimljivo je da li se ovdje fadvice() ili neka druga tehnika minimizacije koristi, ili je to uzrokovano time što je keš ispraznjen od blokova uništenih tijekom kompresije?
Obnova nakon kvara
Obnova nakon neuspjeha traje vrijeme, i to je opravdano. Za ulazni tok od milijun zapisa u sekundi morao sam čekati oko 25 minuta dok se vršila obnova uz SSD disk.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Pokrećem Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Pet Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Počinjem slušati konekcije" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Pokrećem TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="pronađen zdrav blok" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="router prefix" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="pronađen zdrav blok" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="pronađen zdrav blok" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="pronađen zdrav blok" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="pronađen zdrav blok" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="Otkrivena korupcija WAL; skraćujem" err="neočekivana CRC32 kontrolna suma d0465484, želi 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB pokrenut"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Učitavam konfiguracijsku datoteku" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Završeno učitavanje konfiguracijske datoteke" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Server je spreman za primanje web zahtjeva."
Glavni problem procesa oporavka je visoka potrošnja memorije. Iako server može stabilno raditi s istom količinom memorije u normalnim uvjetima, nakon pada ne može se podići zbog OOM-a. Jedino rješenje koje sam pronašao je isključiti prikupljanje podataka, podići server, dopustiti mu da se oporavi i ponovo pokrenuti s uključenim prikupljanjem.
Zagrijavanje
Još jedno ponašanje na koje treba obratiti pažnju tijekom zagrijavanja je omjer niske izvedbe i visoke potrošnje resursa odmah nakon pokretanja. Tijekom nekih, ali ne svih pokretanja primijetio sam ozbiljno opterećenje CPU-a i memorije.
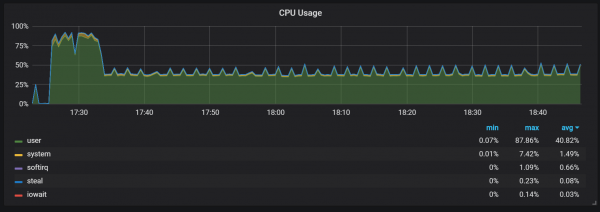
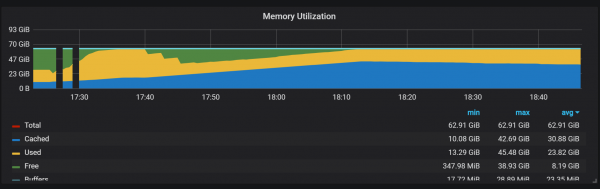
Propusti u potrošnji memorije ukazuju na to da Prometheus ne može odmah konfigurirati sve prikupljače, što dovodi do gubitka neke informacije.
Nisam utvrdio točne uzroke visokog opterećenja na procesor i memoriju. Sumnjam da je to povezano s stvaranjem novih vremenskih serija u glavnom bloku s visokom frekvencijom.
Skakanje opterećenja na CPU
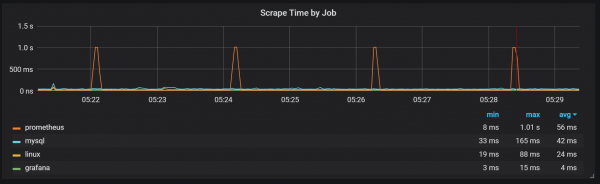
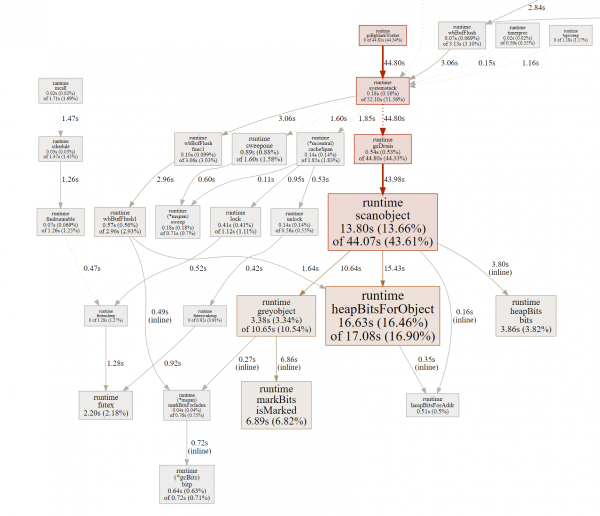
Osim pečata koji stvaraju prilično visoko opterećenje po I/O, primijetio sam ozbiljna skakanja opterećenja na procesor svakih dva minuta. Eksplozije su dulje pri visokom ulaznom toku i čini se da ih uzrokuje GC Go, barem neka jezgra su potpuno opterećena.
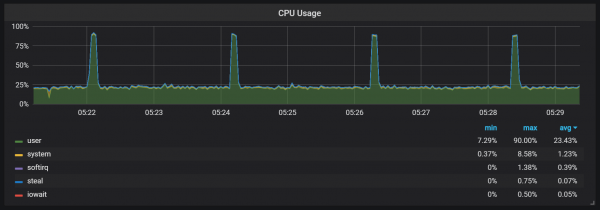
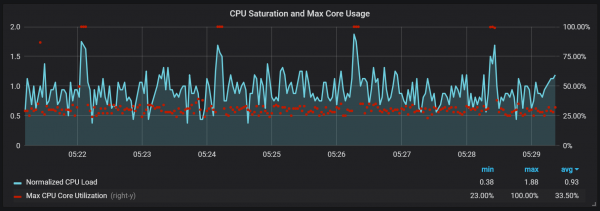
Ta skakanja nisu nimalo nevažna. Čini se da kada se javljaju, unutarnja ulazna točka i Prometheus metrike postaju nedostupne, što uzrokuje gubitke podataka u tim istim vremenskim intervalima.
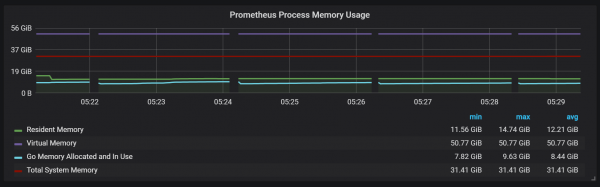
Također se može primijetiti da se Prometheus exporter zaglavi na jednu sekundu.
Možemo primijetiti korelacije s prikupljanjem smeća (GC).
Zaključak
TSDB u Prometheus 2 djeluje brzo, sposobna je obrađivati milijune vremenskih serija i u isto vrijeme tisuće zapisa koji se izvršavaju u sekundi, koristeći prilično skroman hardver. Iskorištenje CPU-a i diska I/O također je impresivno. Moj primjer je pokazao do 200 000 metrika u sekundi na jednom korištenom jezgru.
Za planiranje proširenja treba imati na umu dovoljne količine memorije, a to bi trebala biti prava memorija. Količina RAM-a koju sam promatrao bila je oko 5 GB na 100 000 zapisa u sekundi ulaznog toka, što je sa sistemskim cacheom ukupno dalo oko 8 GB zauzete memorije.
Naravno, još je puno posla pred nama kako bismo ukrotili izlete CPU-a i diska I/O, i to nije iznenađujuće, s obzirom na to koliko je TSDB Prometheus 2 još mlad u usporedbi s InnoDB, TokuDB, RocksDB, WiredTiger, no svi su oni imali slične probleme na početku svog životnog ciklusa.
Izvor: habr.com
