

Dakle, prikupljate metrike. Kao i mi. I mi prikupljamo metrike. Naravno, one potrebne za poslovanje. Danas ćemo govoriti o prvom linku u sustavu našeg nadzora — statsd-kompatibilnom serveru za agregaciju. , zašto smo ga napisali i zašto smo se odrekli brubeck.
Iz naših prethodnih članaka (, ) možete saznati da smo do određenog trenutka oznake prikupljali pomoću . Napisana je u C-u. S aspekta koda — jednostavna poput čepa (to je važno kada želite doprinijeti) i, što je najvažnije, bez problema se nosi s našim volumenima od 2 milijuna metrika u sekundi (MPS) u vrhuncu. Dokumentacija tvrdi podršku od 4 milijuna MPS s zvjezdicom. To znači da ćete dobiti navedeni broj ako pravilno postavite mrežu na Linuxu. (Koliko MPS možete dobiti ako ostavite mrežu kakva jest, nije nam poznato). Unatoč ovim prednostima, imali smo nekoliko ozbiljnih pritužbi na brubeck.
Pritužba 1. Github — programer projekta — prestao je podržavati: objavljivati zakrpe i ispravke, prihvaćati naše i (ne samo naše) PR-ove. U posljednjih nekoliko mjeseci (negdje od veljače-ožujka 2018) aktivnost se obnovila, ali prije toga je bilo gotovo 2 godine potpunog zatišja. Osim toga, projekt se razvija , što može predstavljati ozbiljnu prepreku za uvođenje novih mogućnosti.
Pritužba 2. Točnost izračuna. Brubeck prikuplja samo 65536 vrijednosti za agregaciju. U našem slučaju, za neke metrike u razdoblju agregacije (30 sekundi) može dolaziti mnogo više vrijednosti (1 527 392 u vrhuncu). Kao rezultat takvog uzorkovanja, vrijednosti maksimuma i minimuma izgledaju beskorisno. Na primjer, ovako:
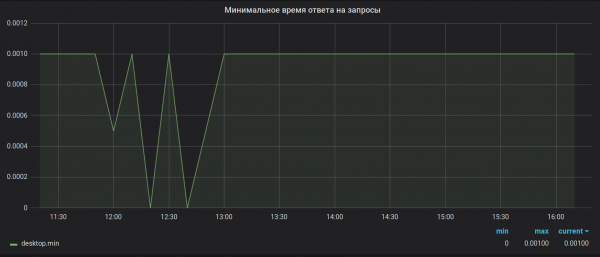
Kako je bilo
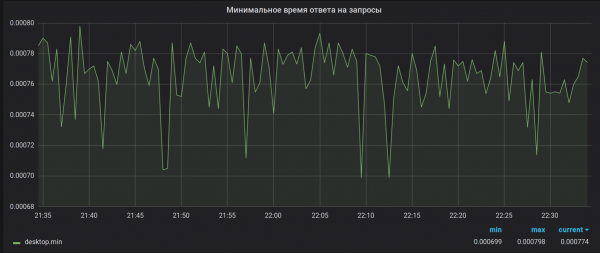
Kako je trebalo biti
Iz istog razloga, sume se uopće smatraju netočnima. Dodajte ovdje grešku s prepunjenjem 32-bitnog float-a, koja zapravo šalje server u segfault prilikom primanja naizgled bezopasne metrike, i postaje sjajno. Greška, usput, do sada nije ispravljena.
I, na kraju, Pritužba X. U trenutku pisanja ovog članka spremni smo predstaviti svima 14 više-manje funkcionalnih implementacija statsd-a koje smo uspjeli pronaći. Zamislimo da je neka pojedinačna infrastruktura porasla do te mjere da primanje 4 milijuna MPS više nije dovoljno. Ili možda još nije porasla, ali su vam metrički podaci već važni toliko da čak i kratke, 2-3 minutne praznine na grafikonima mogu postati kritične i izazvati napade neodoljive depresije kod menadžera. Budući da je liječenje depresije mukotrpan posao, potrebna su tehnička rješenja.
Prvo, otpornost na greške, kako iznenada nastala problem na poslužitelju ne bi izazvao psihijatrijsku zombizaciju u uredu. Drugo, skalabilnost, kako bismo dobili mogućnost primanja više od 4 milijuna MPS, pritom ne kopajući duboko u mrežnom stogu Linuxa i mirno rastući „širine“ do potrebnih dimenzija.
Budući da smo imali prostora za skalabilnost, odlučili smo početi s otpornosti na greške. „O! Otpornost na greške! To je lako, to možemo“, pomislili smo i pokrenuli 2 poslužitelja, podižući na svakom kopiju brubeck-a. Za to smo morali kopirati promet s metrikama na oba poslužitelja i čak napisati za to . Problem otpornosti na greške smo riješili, ali… ne baš dobro. Isprva je sve izgledalo prilično dobro: svaki brubeck prikuplja svoju varijantu agregacije, zapisuje podatke u Graphite svake 30 sekundi, prepisujući stari interval (to se radi na strani Graphite-a). Ako iznenada jedan poslužitelj zakaže, uvijek imamo drugi s vlastitom kopijom agregiranih podataka. Međutim, postoji problem: ako server zakaže, na grafikonima se pojavljuje „pila“. To je povezano s tim što 30-sekundni interesi kod brubeck-a nisu sinkronizirani, i u trenutku pada jedan od njih se ne prepisuje. U trenutku pokretanja drugog poslužitelja događa se isto. Sasvim je podnošljivo, ali želimo bolje! Problem skalabilnosti također nije nestao. Sve metrike i dalje „lete“ na pojedinačni poslužitelj, zbog čega smo ograničeni na istih 2-4 milijuna MPS, ovisno o kapacitetu mreže.
Ako malo razmislite o problemu i istovremeno grabite snijeg lopatom, u glavu vam može doći očigledna ideja: potreban nam je statsd koji može raditi u distribuiranom režimu. To jest, onaj u kojem je implementirana sinhronizacija između nodova prema vremenu i metrikama. "Naravno, takvo rešenje sigurno već postoji", rekli smo i počeli guglati... I ništa nismo pronašli. Pretražujući dokumentaciju za razne statsd ( na dan 11.12.2017), nismo našli ništa. Vidimo da ni developeri ni korisnici tih rešenja sa TOLIKIM brojem metrika još nisu naišli na to, inače bi sigurno nešto smislili.
I tada smo se setili o 'igračke' statsd - bioyino, koji smo pisali na hackathonu iz zabave (naziv projekta generisao je skript na početku hackathona) i shvatili da nam hitno treba vlastiti statsd. Zašto?
- zato što u svetu ima premalo klonova statsd,
- zato što možemo osigurati željenu ili blisku željenoj otpornost na greške i skalabilnost (uključujući sinhronizaciju agregiranih metrika između servera i rešavanje problema sukoba prilikom slanja),
- zato što možemo meriti metrike preciznije nego što to radi brubeck,
- zato što možemo sami prikupljati detaljnije statistike koje nam brubeck gotovo nije pružao,
- zato što se ukazala prilika da programiramo vlastitu hyperperformance distributed scalable aplikaciju, koja neće potpuno ponavljati arhitekturu druge takve hyperfor... nuvoponeli.
Na čemu pisati? Naravno, na Rustu. Zašto?
- zato što je već postojao prototip rešenja,
- zato što je autor članka u tom trenutku već znao Rust i želeo je napisati nešto za produkciju s mogućnošću da to objavi u open-source,
- zato što jezici sa GC nisu pogodni zbog prirode prometa koji dobijamo (praktično u realnom vremenu) i GC pauze su praktično nedopustive,
- zato što je potrebna maksimalna izvedba, uporediva s C-om
- zato što nam Rust pruža fearless concurrency, a kad bismo počeli pisati ovo na C/C++, stekli bismo još više, nego kod brubecka, ranjivosti, preljevanja bafera, race conditions i drugih strašnih reči.
Postojao je i argument protiv Rusta. Tvrtka nije imala iskustva u razvoju projekata na Rustu, a ni sada ne planiramo koristiti ga u glavnom projektu. Stoga su postojale ozbiljne sumnje da neće uspjeti, ali smo odlučili riskirati i isprobali smo.
Vrijeme je prolazilo…
Nap finally, nakon nekoliko neuspješnih pokušaja, prva radna verzija je bila spremna. Što je rezultiralo? Rezultat je bio ovakav.
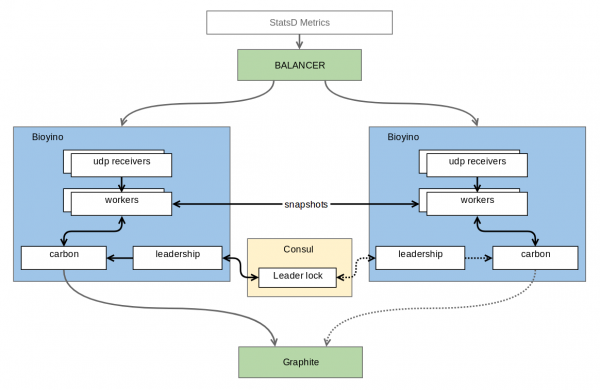
Svaki čvor dobiva svoj vlastiti skup metrika i prikuplja ih na svom mjestu, pri čemu ne agregira metrike za one tipove za koje je potrebna puna skupina za konačnu agregaciju. Čvorovi su međusobno povezani nekim protokolom distribuirane blokade (distributed lock), koji omogućuje odabir među njima onog jednog (tamo smo plakali), koji je dostojan slanja metrika Velikom. Trenutno se ovaj problem rješava sredstvima , ali u budućnosti ambicije autora protežu se do Rafta, gdje će taj dostojni zasigurno biti čvor vođa konsenzusa. Osim konsenzusa, čvorovi dovoljno često (po zadanim postavkama jednom u sekundi) šalju svojim susjedima one dijelove prethodno agregiranih metrika koje su uspjeli prikupiti tijekom te sekunde. Dakle, skalabilnost i otpornost na kvarove ostaju — svaki od čvorova i dalje drži cjelokupan skup metrika, ali metrike se sada šalju već agregirane, putem TCP-a i s kodiranjem u binarni protokol, tako da se troškovi duplikacije u odnosu na UDP značajno smanjuju. Unatoč prilično velikom broju ulaznih metrika, akumulacija zahtijeva vrlo malo memorije i još manje CPU-a. Za naše dobro komprimirane metrike to je svega nekoliko desetaka megabajta podataka. Dodatna prednost je nedostatak suvišnih prepisivanja podataka u Graphite, kao što je to bio slučaj s burbeck.
UDP paketi s metrikama ravnomjerno su raspoređeni između nodova na mrežnoj opremi putem jednostavnog Round Robina. Naravno, mrežna oprema ne analizira sadržaj paketa i stoga može obraditi daleko više od 4M paketa u sekundi, a da ne spominjemo metrike o kojima uopće ne zna. Uzimajući u obzir da metrike dolaze ne u jednom paketu, ne predviđamo probleme s performansama na ovom mjestu. U slučaju pada poslužitelja, mrežno uređaj brzo (u roku od 1-2 sekunde) otkriva taj događaj i uklanja pao poslužitelj iz rotacije. Kao rezultat toga, pasivni (tj. ne vodeći) nodovi mogu se uključivati i isključivati, gotovo neprimjetno na grafikama. Najviše što gubimo je dio metrika koje su stigle u posljednjoj sekundi. Iznenadni gubitak/isključivanje/prebacivanje vođe i dalje će pokazati malu anomalu (30-sekundni interval ostaje nesinkroniziran), ali uz prisutnost veze između nodova, može se minimizirati i te probleme, na primjer, slanjem sinkronizacijskih paketa.
Malo o unutarnjoj strukturi. Aplikacija je, naravno, višedretvena, ali arhitektura niti drugačija je od one koja se koristi u brubecku. Niti u brubecku su iste — svaka od njih odgovara istodobno za prikupljanje informacija i za agregaciju. U bioyinu, radne niti (workers) podijeljene su u dvije grupe: one odgovorne za mrežu i one odgovorne za agregaciju. Ova podjela omogućuje fleksibilnije upravljanje aplikacijom ovisno o tipu metrika: tamo gdje je potrebna intenzivna agregacija, može se dodati više agregatora, a gdje ima puno mrežnog prometa — može se povećati broj mrežnih niti. Trenutno na našim poslužiteljima radimo sa 8 mrežnih i 4 agregirajuće niti.
Dio za računanje (odgovoran za agregaciju) prilično je dosadan. Buffers ispunjeni mrežnim nitima raspoređuju se između računskih niti, gdje se kasnije parsiraju i agregiraju. Na zahtjev, metrike se isporučuju za slanje na druge nodove. Sve to, uključujući prijenos podataka između nodova i rad s Consulom, izvodi se asinkrono, radi na okviru .
Mnogo veći problemi pri razvoju nastali su s komponentom mreže odgovornom za primanje metrika. Glavni cilj izdvajanja mrežnih tokova u zasebne entitete bio je smanjiti vreme koje tok troši ne na čitanje podataka iz soketa. Opcije sa asinhronim UDP-om i običnim recvmsg brzo su odbačene: prvi troši previše CPU-a u user-space-u na obradu događaja, drugi — previše kontekstualnih prebacivanja. Stoga se sada koristi s velikim baferima (a baferi, gospodo oficer, to nije nešto beznačajno!). Podrška za običan UDP ostavljena je za nenaporan slučajeve, kada u recvmmsg nema potrebe. U multimessage režimu uspijevamo postići glavni cilj: velika većina vremena mrežni tok rješava red u OS-u — čita podatke iz soketa i prebacuje ih u bafer u korisničkom prostoru, samo ponekad se prebacujući kako bi predali ispunjeni bafer agregatorima. Red u soketu praktično se ne nagomilava, a broj odbačenih paketa gotovo da ne raste.
Napomena
U podrazumevanju, veličina bafera postavljena je dovoljno velika. Ako odlučite isprobati server samostalno, možda ćete se susresti s tim da, nakon slanja malog broja metrika, iste ne dolaze u Graphite, ostajući u baferu mrežnog toka. Za rad s malim brojem metrika potrebno je postaviti u konfiguraciju manje vrednosti za bufsize i task-queue-size.
Na kraju — malo grafova za ljubitelje grafova.
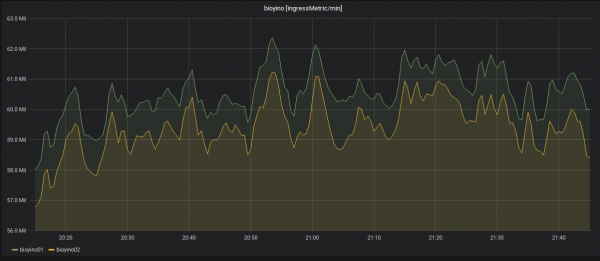
Statistika broja dolaznih metrika po svakom serveru: više od 2 milijuna MPS.
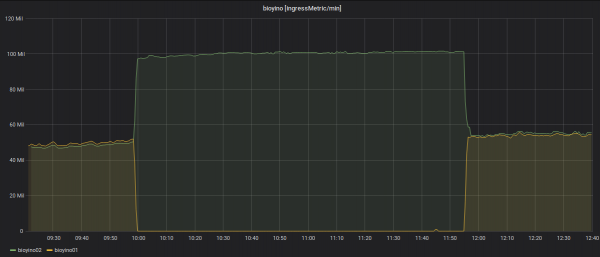
Isključivanje jedne od nodova i redistribucija dolaznih metrika.
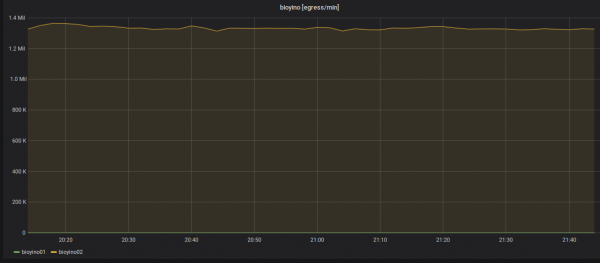
Statistika izlaznih metrika: samo jedna nod uvijek šalje — raidboss.
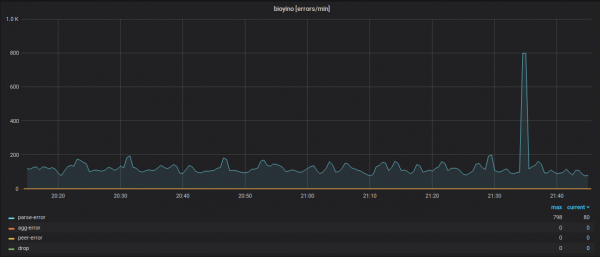
Statistika rada svake nodi uzimajući u obzir greške u različitim modulima sistema.
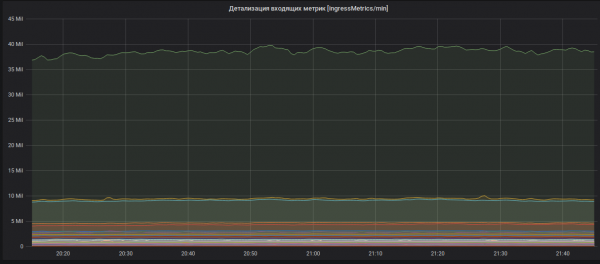
Detaljizacija dolaznih metrika (imena metrika su skrivena).
Što planiramo s ovim svim dalje? Naravno, napisati kod, huh…! Projekat je prvotno planiran kao open-source i ostat će takav tokom cijelog svog života. U bliskim planovima — prelazak na vlastitu verziju Raft, promena peer-protokola na prenosiviji, dodavanje dodatne unutarnje statistike, novih tipova metrika, ispravka grešaka i druga poboljšanja.
Naravno, svi koji žele pomoći u razvoju projekta su dobrodošli: kreirajte PR, Issues, a mi ćemo, koliko god možemo, odgovarati i doraditi, itd.
Na tome, kako kažu, to je sve, kupujte naše slonove!
Izvor: habr.com
