

Često ljudi koji ulaze u područje Data Science imaju ne baš realna očekivanja o tome što ih čeka. Mnogi misle da će sada moći savršeno pisati neuronske mreže, kreirati glasovne asistente poput Iron Mana ili nadmašiti sve na financijskim tržištima.
No, posao Data Scientista vezan je uz podatke, a jedan od najvažnijih i najvremenskih zahvata je obrada podataka prije nego što ih predamo neuronskoj mreži ili analiziramo na određeni način.
U ovom članku naš tim opisuje kako se podaci mogu lako i brzo obraditi kroz korak-po-korak upute i kod. Pokušali smo osigurati da kod bude prilično fleksibilan i da se može primjenjivati na razne skupove podataka.
Mnogi profesionalci možda neće pronaći ništa izvanredno u ovom članku, ali početnici će moći naučiti nešto novo, a također i svi oni koji su dugo sanjali o tome da si naprave poseban notebook za brzu i strukturiranu obradu podataka mogu kopirati kod i prilagoditi ga sebi, ili
Imamo skup podataka. Što dalje?
Dakle, standard: treba razumjeti s čim imamo posla, ukupnu sliku. Za to koristimo pandas kako bismo jednostavno odredili različite tipove podataka.
import pandas as pd #uvozimo pandas
import numpy as np  #uvozimo numpy
df = pd.read_csv("AB_NYC_2019.csv") #čitamo skup podataka i spremamo u varijablu df
df.head(3) #gledamo prvih 3 retka kako bismo razumjeli kako izgledaju vrijednosti 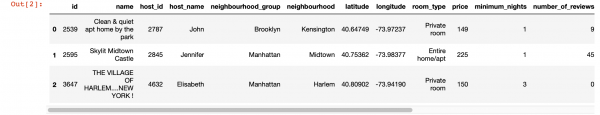
df.info() #prikazujemo informacije o kolonama 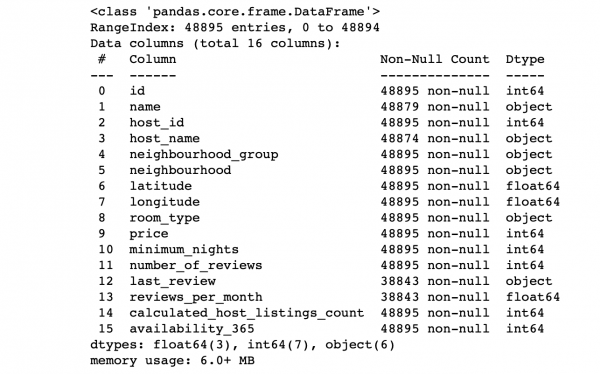
Gledamo vrijednosti kolona:
- Da li se broj redaka svake kolone poklapa s ukupnim brojem redaka?
- Koja je suština podataka u svakoj koloni?
- Koju kolonu želimo postaviti kao cilj kako bismo napravili predikcije za nju?
Odgovori na ova pitanja omogućit će analizu skupa podataka i približno izradu plana sljedećih koraka.
Također, za dublji uvid u vrijednosti u svakoj koloni, možemo koristiti funkciju pandas describe(). Istina, mana ove funkcije je što ne daje informacije o kolonama sa string vrijednostima. S time ćemo se pozabaviti kasnije.
df.describe() 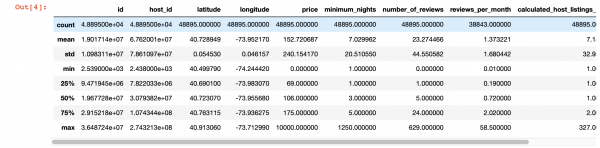
Čarobna vizualizacija
Pogledajmo gdje nam uopće nedostaju vrijednosti:
import seaborn as sns
sns.heatmap(df.isnull(),yticklabels=False,cbar=False,cmap='viridis') 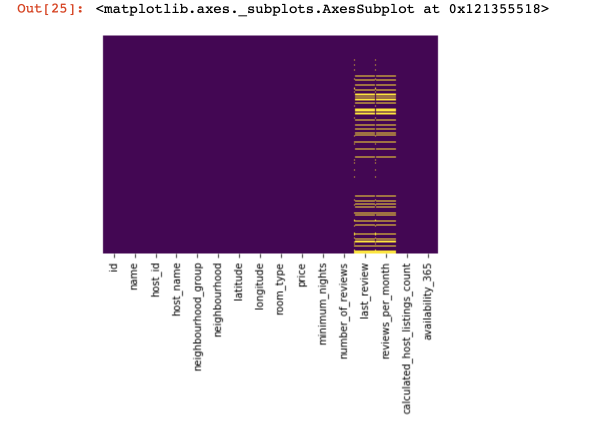
To je bio mali pregled iz ptičje perspektive, sada se upuštamo u zanimljivije stvari.
Pokušajmo pronaći i, ako je moguće, ukloniti stupce koji sadrže samo jednu vrijednost u svim redovima (oni neće utjecati na rezultate):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] #Prepisujemo dataset, ostavljajući samo one stupce u kojima ima više od jedne jedinstvene vrijednosti
Sada se štitimo i osiguravamo uspjeh našeg projekta od dupliciranih redova (redovi koji sadrže iste informacije u istom redoslijedu kao već postojeći redovi):
df.drop_duplicates(inplace=True) #Radimo to ako smatramo potrebnim.
                                 #U nekim projektima nije potrebno odmah ukloniti te podatke.
Dijelimo dataset na dva: jedan sa kvalitativnim vrijednostima i drugi — s kvantitativnim.
Ovdje treba napraviti malo pojašnjenje: ako redovi s propuštenim podacima u kvalitativnim i kvantitativnim podacima nisu jako povezani, tada ćemo morati odlučiti čega se odričemo — svih redova s propuštenim podacima, samo dijela ili određenih stupaca. Ako su redovi međusobno povezani, imamo pravo razdvojiti dataset na dva. Inače, prvo moramo riješiti redove koji nemaju povezane propuštene podatke u kvalitativnim i kvantitativnim podacima, a tek onda razdvojiti dataset na dva.
df_numerical = df.select_dtypes(include=[np.number])
df_categorical = df.select_dtypes(exclude=[np.number])
Radimo to kako bismo olakšali obradu ova dva različita tipa podataka — kasnije ćemo shvatiti koliko nam to pojednostavljuje život.
Radimo s kvantitativnim podacima
Prvo što trebamo učiniti je odrediti ima li „špijunskih stupaca“ u kvantitativnim podacima. Tim zovemo te stupce jer se predstavljaju kao kvantitativni podaci, a zapravo djeluju kao kvalitativni.
Kako ih možemo odrediti? Naravno, sve ovisi o prirodi podataka koje analizirate, ali uglavnom takvi stupci mogu imati malo jedinstvenih podataka (oko 3-10 jedinstvenih vrijednosti).
print(df_numerical.nunique())Nakon što identificiramo špijunske stupce, premjestit ćemo ih iz kvantitativnih podataka u kvalitativne:
spy_columns = df_numerical[['stupac1', 'stupac2', 'stupac3']]#izdvajamo špijunske stupce i zapisujemo u zasebni dataframe
df_numerical.drop(labels=['stupac1', 'stupac2', 'stupac3'], axis=1, inplace = True)#izrezujemo te stupce iz kvantitativnih podataka
df_categorical.insert(1, 'stupac1', spy_columns['stupac1']) #dodajemo prvi špijunski stupac u kvalitativne podatke
df_categorical.insert(1, 'stupac2', spy_columns['stupac2']) #dodajemo drugi špijunski stupac u kvalitativne podatke
df_categorical.insert(1, 'stupac3', spy_columns['stupac3']) #dodajemo treći špijunski stupac u kvalitativne podatke
Napokon smo potpuno odvojili kvantitativne podatke od kvalitativnih i sada možemo s njima ozbiljno raditi. Prvo — trebamo razumjeti gdje imamo prazne vrijednosti (NaN, a u nekim slučajevima i 0 će se smatrati praznim vrijednostima).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
U ovoj fazi važno je razumjeti u kojim stupcima nula može značiti nedostajuće vrijednosti: je li to povezano s načinom prikupljanja podataka? Ili može biti povezano s vrijednostima podataka? Na ta pitanja treba odgovoriti u svakom pojedinom slučaju.
Dakle, ako smo ipak odlučili da podaci mogu nedostajati tamo gdje su nule, trebali bismo zamijeniti nule s NaN, kako bismo kasnije lakše radili s tim izgubljenim podacima:
df_numerical[["stupac 1", "stupac 2"]] = df_numerical[["stupac 1", "stupac 2"]].replace(0, nan)Sada ćemo vidjeti gdje nam nedostaju podaci:
sns.heatmap(df_numerical.isnull(),yticklabels=False,cbar=False,cmap='viridis') # Također se može koristiti df_numerical.info() 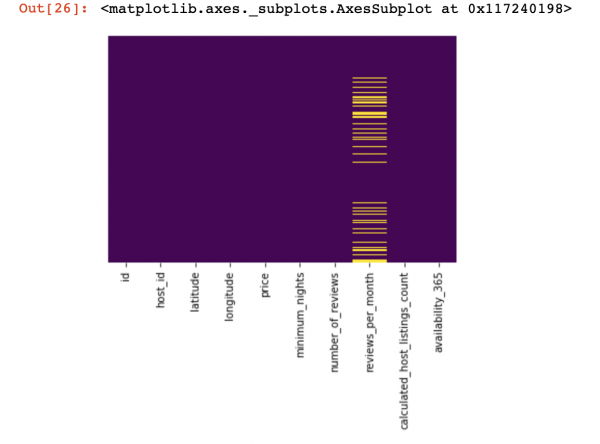
Ovdje bi trebala biti označena žutom bojom ona vrijednost u stupcima koja nedostaje. I sada dolazi najzanimljiviji dio — kako postupiti s tim vrijednostima? Izbrisati redke s tim vrijednostima ili stupce? Ili napuniti te prazne vrijednosti nekim drugim?
Evo približne sheme koja vam može pomoći da odlučite što se može zasad učiniti s praznim vrijednostima:
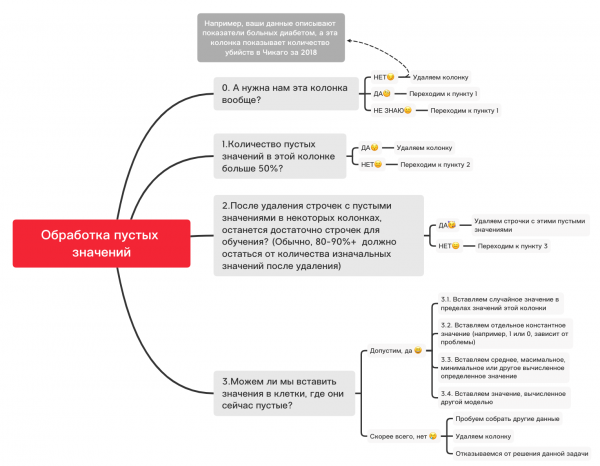
0. Brišemo nepotrebne stupce
df_numerical.drop(labels=["stupac1","stupac2"], axis=1, inplace=True)1. Je li broj praznih vrijednosti u ovom stupcu veći od 50%?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["stupac1","stupac2"], axis=1, inplace=True)#Brišemo ako neki stupac ima više od 50 praznih vrijednosti2. Brišemo redove s praznim vrijednostima
df_numerical.dropna(inplace=True)#Uklonite redove s praznim vrijednostima, ako ostane dovoljno podataka za učenje3.1. Umetnite slučajnu vrijednost
import random #uvozimo random
df_numerical["kolona"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolona"]), inplace=True) #umetnite slučajne vrijednosti u prazne ćelije tablice
3.2. Umetnite konstantnu vrijednost
from sklearn.impute import SimpleImputer #uvozimo SimpleImputer koji pomaže pri umetanjima
imputer = SimpleImputer(strategy='constant', fill_value="") #umetnite određenu vrijednost pomoću SimpleImputer
df_numerical[["nova_kolona1",'nova_kolona2','nova_kolona3']] = imputer.fit_transform(df_numerical[['kolona1', 'kolona2', 'kolona3']]) #Primijenite to na našu tablicu
df_numerical.drop(labels = ["kolona1","kolona2","kolona3"], axis = 1, inplace = True) #Uklonite kolone sa starim vrijednostima
3.3. Umetnite srednju ili najčešće vrijednost
from sklearn.impute import SimpleImputer #uvozimo SimpleImputer koji pomaže pri umetanjima
imputer = SimpleImputer(strategy='mean', missing_values = np.nan) #umjesto mean također možete koristiti most_frequent
df_numerical[["nova_kolona1",'nova_kolona2','nova_kolona3']] = imputer.fit_transform(df_numerical[['kolona1', 'kolona2', 'kolona3']]) #Primijenite to na našu tablicu
df_numerical.drop(labels = ["kolona1","kolona2","kolona3"], axis = 1, inplace = True) #Uklonite kolone sa starim vrijednostima
3.4. Umetnite vrijednost izračunatu drugom modelu
Ponekad se vrijednosti mogu izračunati pomoću regresijskih modela, koristeći modele iz biblioteke sklearn ili drugih sličnih biblioteka. Naš tim će posvetiti poseban članak o tome kako to možete učiniti u bliskoj budućnosti.
Dakle, dok se naracija o kvantitativnim podacima prekida, postoji mnogo drugih nijansi o tome kako najbolje raditi pripremu podataka i preprocessing za različite zadatke, a osnovne stvari za kvantitativne podatke su obuhvaćene u ovom članku, sada je vrijeme da se vratimo kvalitativnim podacima, koje smo odvojili nekoliko koraka unazad od kvantitativnih. Možete prilagoditi ovaj notebook onako kako želite, prilagođavajući ga različitim zadacima kako bi priprema podataka prolazila vrlo brzo!
Kvalitativni podaci
Za kvalitativne podatke najčešće se koristi metoda One-hot-encoding kako bi se formatirali iz string (ili objekta) u broj. Prije nego što pređemo na ovu temu, koristićemo shemu i kôd iznad kako bismo se pozabavili praznim vrijednostima.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 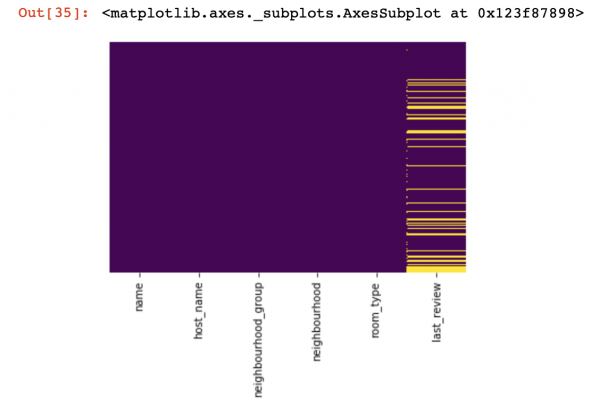
0. Brišemo nepotrebne stupce
df_categorical.drop(labels=["kolona1", "kolona2"], axis=1, inplace=True)1. Je li broj praznih vrijednosti u ovom stupcu veći od 50%?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["kolona1", "kolona2"], axis=1, inplace=True) # Uklanjamo ako neka kolona
# ima više od 50% praznih vrijednosti2. Brišemo redove s praznim vrijednostima
df_categorical.dropna(inplace=True) # Uklanjamo redove s praznim vrijednostima,
                                   # ako će kasnije ostati dovoljno podataka za obuku
3.1. Umetnite slučajnu vrijednost
import random
df_categorical["kolona"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolona"]), inplace=True)
3.2. Umetnite konstantnu vrijednost
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["nova_kolona1", 'nova_kolona2', 'nova_kolona3']] = imputer.fit_transform(df_categorical[['kolona1', 'kolona2', 'kolona3']])
df_categorical.drop(labels=["kolona1", "kolona2", "kolona3"], axis=1, inplace=True)
Dakle, napokon smo se pozabavili praznim vrijednostima u kvalitativnim podacima. Sada je vrijeme za izvođenje one-hot-encoding za vrijednosti koje imate u vašoj bazi podataka. Ova metoda se često koristi kako bi vaš algoritam mogao učiti uzimajući u obzir kvalitativne podatke.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["kolona1", "kolona2", "kolona3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Dakle, napokon smo završili s obradom kvalitativnih i kvantitativnih podataka - vrijeme je da ih ponovo spojimo.
new_df = pd.concat([df_numerical, df_categorical], axis=1)Nakon što smo spojili datasete u jedan, na kraju možemo koristiti transformaciju podataka pomoću MinMaxScaler iz biblioteke sklearn. To će naše vrijednosti postaviti u opseg od 0 do 1, što će pomoći pri obuci modela u budućnosti.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Ovi podaci su sada spremni za sve - neuronske mreže, standardne ML algoritme itd!
U ovom članku nismo obradili rad s podacima koji se odnose na vremenske serije, budući da za takve podatke treba koristiti malo drugačije tehnike obrade, zavisno o vašem zadatku. U budućnosti će naš tim posvetiti ovu temu posebnom članku, i nadamo se da će to donijeti nešto zanimljivo, novo i korisno u vaš život, kao i ovaj.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish