

Pozdrav svima! Zovem se Dmitrij Samsonov i radim kao vodeći sistemski administrator u «Odnoklassnikama». Imamo više od 7 tisuća fizičkih servera, 11 tisuća kontejnera u našem oblaku i 200 aplikacija koje u različitim konfiguracijama čine 700 različitih klastera. Pretežna većina servera radi na sustavu CentOS 7.
Dana 14. kolovoza 2018. objavljene su informacije o ranjivosti FragmentSmack
() i SegmentSmack (). Ovo su ranjivosti s mrežnim vektorom napada i prilično visokim ocjenama (7.5), koje prijete uslugama zbog iscrpljivanja resursa (CPU). Ispravka u jezgru za FragmentSmack tada nije bila ponuđena, više od toga, izašla je značajno kasnije nakon objave informacija o ranjivosti. Za otklanjanje problema sa SegmentSmackom predlagalo se ažuriranje jezgra. Sam paket s ažuriranjem bio je izdan istog dana, ostajalo je samo da ga se instalira.
Ne, nismo protiv ažuriranja jezgra! Međutim, postoji nekoliko nijansi…
Kako ažuriramo jezgro na produkciji
U suštini, nema ništa komplicirano:
- Preuzmite pakete;
- Instalirajte ih na određeni broj servera (uključujući servere koji hostiraju naš oblak);
- Provjerite da li ništa nije pokvareno;
- Uvjerite se da su sve standardne postavke jezgra primijenjene bez grešaka;
- Sačekajte nekoliko dana;
- Provjerite pokazatelje servera;
- Prebacite implementaciju novih servera na novo jezgro;
- Ažurirajte sve servere po Data centrima (jedan Data centar u isto vrijeme, kako bismo minimizirali efekte za korisnike u slučaju problema);
- Ponovo pokrenite sve servere.
Ponovite za sve grane koje imamo. Trenutno to uključuje:
- Standardni CentOS 7 3.10 – za većinu običnih servera;
- Vanilijas 4.19 – za naš , jer nam trebaju BFQ, BBR itd.;
- Elrepo kernel-ml 5.2 – za , jer se 4.19 ranije ponašao nestabilno, a potrebne su nam iste značajke.
Kao što ste mogli pogoditi, najviše vremena troši se na ponovni pokretanje tisuća servera. Budući da nisu sve ranjivosti kritične za sve servere, ponovno pokrećemo samo one koji su direktno dostupni s interneta. U oblaku, kako bismo zadržali fleksibilnost, ne vezujemo dostupne kontejnere za pojedinačne servere s novim kernelom, već ponovo pokrećemo sve hostove bez iznimke. Srećom, tamo je procedura jednostavnija nego s običnim serverima. Na primjer, stateless kontejneri mogu se jednostavno premjestiti na drugi server tijekom reboota.
Ipak, posla ima mnogo, i može trajati nekoliko tjedana, a u slučaju bilo kakvih problema s novom verzijom — i do nekoliko mjeseci. Napadači to dobro razumiju, pa je potreban plan "B".
FragmentSmack/SegmentSmack. Rješenje
Srećom, za neke ranjivosti takav plan "B" postoji, a zove se Rješenje. Najčešće se radi o promjenama postavki kernela/aplikacija koje omogućuju minimiziranje mogućih učinaka ili potpuno isključivanje eksploatacije ranjivosti.
U slučaju FragmentSmack/SegmentSmack takav Rješenje:
«Možete promijeniti zadane vrijednosti 4MB i 3MB u net.ipv4.ipfrag_high_thresh i net.ipv4.ipfrag_low_thresh (i njihove analoge za ipv6 net.ipv6.ipfrag_high_thresh i net.ipv6.ipfrag_low_thresh) na 256 kB i 192 kB respektivno ili niže. Testovi pokazuju mali do značajan pad korištenja CPU-a tijekom napada, ovisno o opremi, postavkama i uvjetima. Međutim, može biti nečega utjecaja na performanse zbog ipfrag_high_thresh=262144 bajta, jer samo dva 64K fragmenta mogu istovremeno stati u redoslijed za rekonstruiranje. Na primjer, postoji rizik da će aplikacije koje rade s velikim UDP paketima biti pogođene.».
Same postavke opisane su ovako:
ipfrag_high_thresh - DUGI DIO CJELOBA
     Maksimalna memorija koja se koristi za ponovno sastavljanje IP fragmenata.
ipfrag_low_thresh - DUGI CIJELI BROJ
     Maksimalna memorija korištena za ponovno sastavljanje IP fragmenta prije nego što kernel
     započne uklanjanje nepotpunih redova fragmenata kako bi oslobodio resurse.
     Kernel i dalje prihvaća nove fragmente za defragmentaciju.
Na produkcijskim servisima nemamo velike UDP. U LAN-u fragmentirani promet ne postoji, u WAN-u postoji, ali nije značajan. Ništa ne predviđa — možemo primijeniti Rješenje!
FragmentSmack/SegmentSmack. Prva krv
Prvi problem na koji smo naišli bio je taj da su oblačni kontejneri ponekad primjenjivali nove postavke samo djelomično (samo ipfrag_low_thresh), a ponekad ih uopće nisu primenjivali — jednostavno su se rušili pri pokretanju. Nije bilo moguće stabilno reproducirati problem (sve postavke su se ručno primjenjivale bez ikakvih poteškoća). Razumjeti zašto se kontejner ruši pri pokretanju također nije bilo tako jednostavno: nije otkrivena nijedna greška. Jedna stvar je bila sigurna: povratak na prethodne postavke rješava problem s padovima kontejnera.
Zašto nije dovoljno primijeniti Sysctl na hostu? Kontejner živi u svom izoliranom mrežnom Namespace-u, pa barem u kontejneru može se razlikovati od hosta.
Kako se točno primjenjuju postavke Sysctl u kontejneru? Pošto su kontejneri kod nas nepovlašteni, ne možemo promijeniti nijednu Sysctl postavku ulaskom u sam kontejner — jednostavno nemamo dovoljno prava. Za pokretanje kontejnera naša oblak je u to vrijeme koristila Docker (sada već ). Dockeru su putem API-a proslijeđeni parametri novog kontejnera, uključujući potrebne Sysctl postavke.
Tijekom pregledavanja verzija otkriveno je da API Docker nije vraćao sve greške (barem, u verziji 1.10). Kada smo pokušali pokrenuti kontejner putem “docker run”, napokon smo vidjeli nešto:
write /proc/sys/net/ipv4/ipfrag_high_thresh: invalid argument docker: Error response from daemon: Cannot start container : [9] System error: could not synchronise with container process.
Vrijednost parametra nije valjana. Ali zašto? I zašto nije valjana samo ponekad? Utvrđeno je da Docker ne jamči redoslijed primjene Sysctl parametara (najnovija provjerena verzija — 1.13.1), zbog čega je ponekad ipfrag_high_thresh pokušavao postaviti na 256K, dok je ipfrag_low_thresh još bio 3M, što znači da je gornja granica bila niža od donje, što je dovelo do greške.
U to vrijeme već smo koristili vlastiti mehanizam za doku konfiguraciju kontejnera nakon pokretanja (zamrzavanje kontejnera putem i izvođenje naredbi u namespaceu kontejnera putem ), i u tu smo se komponentu također dodali unos Sysctl parametara. Problem je bio rešen.
FragmentSmack/SegmentSmack. Prva krv 2
Nismo uspjeli shvatiti primjenu Workaround-a u oblaku, kada su počeli stizati prvi rijetki prigovori korisnika. U to vrijeme prošlo je nekoliko tjedana od početka primjene Workaround-a na prvim poslužiteljima. Početna istraga pokazala je da su prigovori dolazili na pojedine usluge, a ne na sve poslužitelje tih usluga. Problem je ponovno postao izrazito neodređen.
Prije svega, naravno, pokušali smo vratiti postavke Sysctl, ali to nije imalo nikakvog učinka. Različite manipulacije s postavkama poslužitelja i aplikacije također nisu pomogle. Pomoglo je ponovno pokretanje. Ponovno pokretanje za Linux je isto tako neprirodno, koliko je nekad bilo normalno za rad s Windows-om. Ipak, pomoglo je, i sve smo pripisali 'grešci u kernelu' pri primjeni novih postavki u Sysctl. Kako je to bilo neodgovorno...
Nakon tri tjedna problem se ponovio. Konfiguracija ovih poslužitelja bila je prilično jednostavna: Nginx u proxy/load balancing modu. Promet je bio mali. Nova informacija: kod klijenata s vremenom se povećao broj 504 grešaka (). Na grafu je prikazan broj 504 grešaka po danu za ovu uslugu:
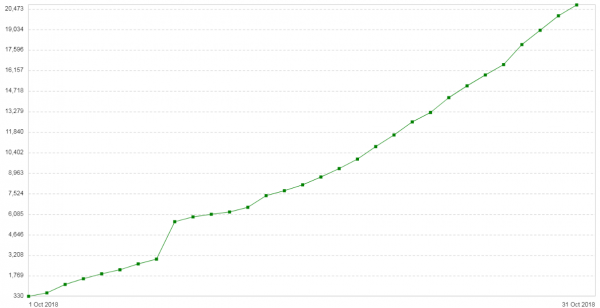
Sve greške odnose se na isti backend — onaj koji se nalazi u oblaku. Graf potrošnje memorije za pakete na ovom backendu izgledao je ovako:
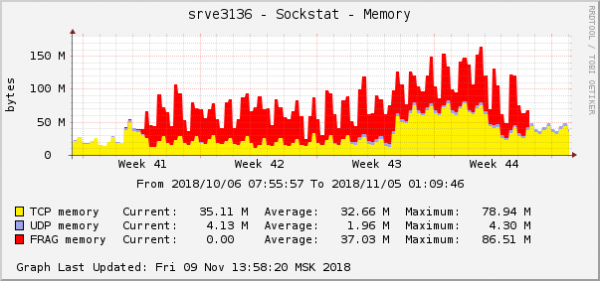
To je jedan od najsvjetlijih prikaza problema na grafikonima operativnog sustava. U oblaku je u to vrijeme bila ispravljena druga mrežna problema s QoS postavkama (Traffic Control). Na grafikonu potrošnje memorije za pakete izgledalo je točno ovako:
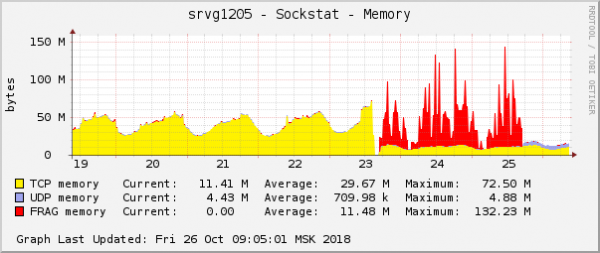
Pretpostavka je bila jednostavna: ako na grafikonima izgledaju identično, onda je i uzrok isti. Tim više što su problemi s ovim tipom memorije izuzetno rijetki.
Bit ispravljene probleme sastojala se u tome što smo u QoS koristili planificator paketa fq s zadanim postavkama. Po zadanom, za jednu vezu omogućava dodavanje 100 paketa u red, a neka su povezivanja u situacijama nedostatka propusnosti počela puniti red do punjenja. U tom slučaju paketi se odbacuju. U statistici tc (tc -s qdisc) to se vidi ovako:
qdisc fq 2c6c: roditelj 1:2c6c limit 10000p flow_limit 100p buckets 1024 orphan_mask 1023 quantum 3028 initial_quantum 15140 refill_delay 40.0ms
  Poslano 454701676345 bajtova 491683359 pkt (odbačeno 464545, prekoračenja 0 ponovna-evaluacija 0)
  backlog 0b 0p ponovna-evaluacija 0
   1024 tokova (1021 neaktivnih, 0 ograničenih)
   0 gc, 0 visoki prioritet, 0 ograničeno, 464545 flows_plimit
«464545 flows_plimit» su paketi koji su odbačeni zbog prekoračenja limita reda jednog konekcije, dok je «dropped 464545» suma svih odbijenih paketa ovog raspoređivača. Nakon povećanja dužine reda na 1.000 i restartanja kontejnera, problem se prestao javljati. Možete se opustiti u stolici i popiti smoothie.
FragmentSmack/SegmentSmack. Posljednja krv
Prvo, nakon nekoliko mjeseci od najave ranjivosti u jezgri, konačno je stigla ispravka za FragmentSmack (podsjetimo, s najavom u kolovozu objavljena je ispravka samo za SegmentSmack), što nam je dalo priliku da se riješimo workaround-a koji nam je zadavao prilično puno neugodnosti. Djelomično, već smo prešli neke poslužitelje na novu jezgru, a sada smo morali početi ispočetka. Zašto smo ažurirali jezgru, ne čekajući ispravku za FragmentSmack? Riječ je o tome da je proces zaštite od tih ranjivosti bio povezan s ažuriranjem samog CentOS-a (koje traje još dulje od ažuriranja same jezgre). Uz to, SegmentSmack je opasnija ranjivost, a ispravka za nju pojavila se odmah, tako da je imalo smisla u svakom slučaju. Međutim, jednostavno nismo mogli ažurirati jezgru na CentOS-u, jer je ranjivost FragmentSmack, koja se pojavila u doba CentOS 7.5, ispravljena tek u verziji 7.6, pa smo morali zaustaviti ažuriranje na 7.5 i započeti sve ispočetka s ažuriranjem na 7.6. I to se događa.
Drugo, ponovo su se pojavile rijetke pritužbe korisnika o problemima. Sada već znamo da su svi oni povezani s uploadanjem datoteka od klijenata na neke naše poslužitelje. Uz to, kroz te poslužitelje prolazilo je vrlo malo upload-ova od ukupnog broja.
Kao što se sjećamo iz prethodnog izlaganja, vraćanje Sysctl nije pomoglo. Restart je pomogao, ali privremeno.
Sumnja u Sysctl nije je uklonjena, ali ovaj put bilo je potrebno prikupiti što više informacija. Također je bilo izuzetno važno imati mogućnost reproducirati problem s upload-om na strani klijenta, kako bismo preciznije proučili što se događa.
Analiza svih dostupnih statističkih podataka i logova nas nije približila razumevanju situacije. Oštro nam je nedostajala mogućnost da reprodukujemo problem kako bismo 'osjetili' konkretne veze. Napokon, developerima na specijalnoj verziji aplikacije uspelo je da postignu stabilnu reprodukciju problema na testnom uređaju pri povezivanju preko Wi-Fi. Ovo je postalo proboj u istrazi. Klijent se povezivao na Nginx, koji je proksirao na backend, a to je bila naša aplikacija na Javi.
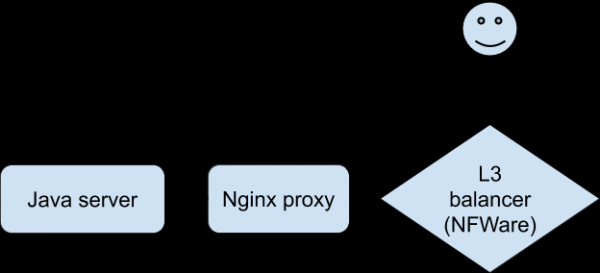
Dijalog u slučaju problema bio je ovakav (zabeležen na strani Nginx-proksija):
- Klijent: zahtev za informacije o preuzimanju datoteke.
- Java-server: odgovor.
- Klijent: POST sa datotekom.
- Java-server: greška.
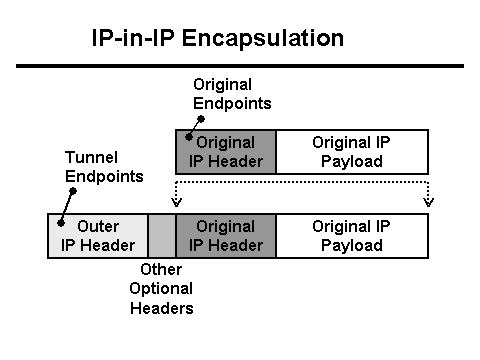
Java-server pritom piše u log da je primio 0 bajtova podataka od klijenta, a Nginx-proksija beleži da je zahtev trajao više od 30 sekundi (30 sekundi je vreme isteka kod klijentske aplikacije). Zašto je došlo do isteka i zašto 0 bajtova? Iz perspektive HTTP-a sve funkcioniše kako treba, ali POST sa datotekom kao da nestaje iz mreže. I to nestaje između klijenta i Nginx-a. Došlo je vreme da se opremimo Tcpdump-om! No prvo moramo razumeti konfiguraciju mreže. Nginx-proksija se nalazi iza L3-balansirača. . Koristi se tunelovanje za dostavu paketa od L3-balansirača do servera, što dodaje svoje hedere u pakete:
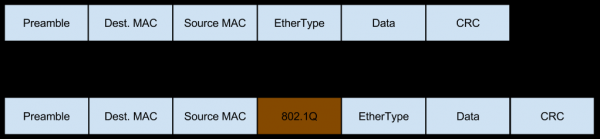
Pri tome, mreža na ovaj server dolazi u obliku Vlan-tagiranog saobraćaja, što takođe dodaje svoja polja u pakete:
A taj saobraćaj može biti fragmentiran (onaj mali postotak ulaznog fragmentiranog saobraćaja o kojem smo govorili prilikom procene rizika od Workaround), što takođe menja sadržaj hedera:
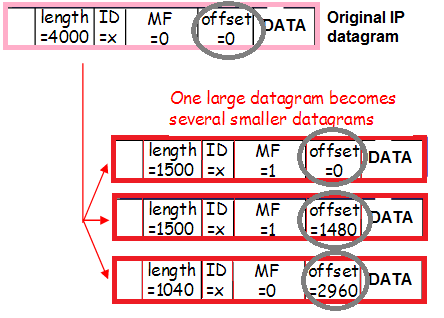
Još jednom: paketi su enkapsulirani Vlan-tagom, enkapsulirani tunelom, fragmentirani. Kako bismo tačno razumeli kako to funkcioniše, pratimo put paketa od klijenta do Nginx-proksija.
- Paket dolazi na L3-balansirač. Za pravilno usmeravanje unutar data-centra, paket se enkapsulira u tunel i šalje na mrežnu karticu.
- Budući da paket + hederi tunela ne staju u MTU, paket se deli na fragmente i šalje u mrežu.
- Switc nakon L3-balansirača prilikom primanja paketa dodaje mu Vlan-tag i šalje dalje.
- Switch ispred Nginx proxyja vidi (prema postavkama porta) da server očekuje Vlan-inkapsulirani paket, stoga ga šalje onakvog kakav jest, ne uklanjajući Vlan oznaku.
- Linux prima fragmente pojedinačnih paketa i sastavlja ih u jedan veliki paket.
- Zatim paket dolazi na Vlan sučelje, gdje mu se uklanja prvi sloj — Vlan-inkapsuliranje.
- Nakon toga, Linux ga šalje na Tunnel sučelje, gdje mu se uklanja još jedan sloj — Tunnel-inkapsuliranje.
Teškoća leži u prijenosu svega ovoga kao parametara u tcpdump.
Počet ćemo s kraja: postoje li čisti (bez suvišnih zaglavlja) IP paketi od klijenata, s uklonjenim vlan- i tunnel-inkapsuliranjem?
tcpdump host
Ne, takvih paketa na serveru nije bilo. Tako da problem mora biti ranije. Ima li paketa s uklonjenim samo Vlan-inkapsuliranjem?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx - to je IP adresa klijenta u heksadecimalnom formatu.
32:4 — adresa i duljina polja u kojem je zapisana SCR IP u Tunnel paketu.
Adresu polja trebalo je odabrati metodom pokušaja i pogreške, jer na internetu pišu o 40, 44, 50, 54, ali tamo nije bilo IP adresa. Također, možete pogledati jedan od paketa u hex (parametar -xx ili -XX u tcpdump) i izračunati na kojoj adresi se nalazi poznati IP.
Ima li fragmenata paketa bez uklonjenog Vlan- i Tunnel-inkapsuliranja?
tcpdump ((ip[6:2] > 0) and (not ip[6] = 64))
Ova magija će nam pokazati sve fragmente, uključujući posljednji. Vjerojatno se to može filtrirati prema IP-u, ali nisam pokušavao, budući da nije bilo mnogo takvih paketa, a među općim tokom lako sam pronašao ono što mi je trebalo. Evo ih:
14:02:58.471063 U 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), duljina 1516: (tos 0x0, ttl 63, id 53652, pomak 0, zastavice [+], protokol IPIP (4), duljina 1500)
     11.11.11.11 > 22.22.22.22: skraćeni-ip - 20 bajtova nedostaje! (tos 0x0, ttl 50, id 57750, pomak 0, zastavice [DF], protokol TCP (6), duljina 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Zastavice [.], seq 0:1448, ack 1, win 343, opcije [nop,nop,TS val 11660691 ecr 2998165860], duljina 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 if..MM.*........
14:02:58.471103 U 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), duljina 62: (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), duljina 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
To su dva fragmenta jednog paketa (isti ID 53652) s fotografijom (vidi se riječ Exif u prvom paketu). Obzirom na to da paketi postoje na ovoj razini, a u sastavljenom obliku u dumpovima - ne, problem je očito u sastavljanju. Napokon imamo dokumentarno očitovanje o tome!
Dekoder paketa nije otkrio nikakve probleme koji bi spriječili sastavljanje. Pokušao sam ovdje: Prvo, prilikom pokušaja umetanja nečega, dekoder nije odobravao format paketa. Ispostavilo se da su postojala neka suvišna dva okteta između Srcmac i Ethertype (koji se ne odnose na informacije o fragmentima). Nakon njihovog uklanjanja, dekoder je počeo raditi. Ipak, nije prijavio nikakve probleme.
Bez obzira na sve, osim onih Sysctl-a nije pronađeno ništa drugo. Ostalo je pronaći način za identifikaciju problematičnih servera kako bismo razumjeli opseg i donijeli odluku o daljnjim koracima. Relativno brzo je pronađen potrebni brojčanik:
netstat -s | grep "packet reassembles failed"
Ovaj brojčanik postoji i u snmpd pod OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
«Broj neuspjeha koje je detektirao IP algoritam ponovne sastavljanja (iz raznih razloga: isteka vremena, greške, itd.).»
Među grupom servera na kojima je istraživan problem, na dva je ovaj brojčanik brže rastao, na dva sporije, a na još dva se uopće nije povećavao. Usporedba dinamike ovog brojčanika s dinamikom HTTP grešaka na Java serveru otkrila je korelaciju. Drugim riječima, brojčanik bi mogao biti stavljen na nadzor.
Široko pouzdanje na indikator problema izuzetno je važno da bismo mogli točno odrediti pomaže li povratak Sysctl, jer iz prethodne priče znamo da se to odmah ne može shvatiti iz aplikacije. Ovaj indikator bi omogućio otkrivanje svih problematičnih mjesta u produkciji prije nego što ih primijete korisnici.
Nakon povratka Sysctl-a, greške u nadzoru su prestale, tako da je uzrok problema potvrđen, kao i to da povratak pomaže.
Povukli smo postavke fragmentacije na drugim serverima gdje je pokrenut novi nadzor, a negdje smo za fragmente čak dodijelili više memorije nego što je ranije bilo prema zadanim postavkama (ovo je bila udp statistika, č parcialni gubitak koje nije bio primjetan na općem nivou).
Najvažnija pitanja
Zašto se na našem L3 balansoru paketi fragmentiraju? Većina paketa koji dolaze od korisnika na balansore su SYN i ACK. Veličine ovih paketa su male. No, s obzirom na to da je udio takvih paketa vrlo visok, nismo primijetili prisutnost velikih paketa koji su počeli fragmentirati.
Uzrok je bio pokvareni konfiguracijski skript na poslužiteljima s Vlan sučeljima (poslužitelja s označenim prometom u to vrijeme bilo je vrlo malo). Advmss omogućuje prenošenje informacija klijentima da paketi u našu stranu trebaju biti manje veličine kako ne bi došlo do fragmentacije nakon pridruživanja zaglavlja tunela.
Zašto povratak Sysctla nije pomogao, a ponovno pokretanje jeste? Povratak Sysctla mijenjao je količinu memorije dostupne za spajanje paketa. U međuvremenu, očito sam čin preopterećenja memorije za fragmente uzrokovao je usporavanje veza, što je dovelo do toga da su fragmenti dugo zadržavani u redu. Drugim riječima, proces se ponavljao.
Ponovno pokretanje resetira memoriju i sve se vraća u red.
Je li se moglo obaviti bez zaobilaznog rješenja? Da, ali rizik od ostavljanja korisnika bez usluge u slučaju napada bio bi velik. Naravno, primjena zaobilaznog rješenja dovela je do različitih problema, uključujući usporavanje jednog od servisa za korisnike, ali smatramo da su akcije bile opravdane.
Veliko hvala Andreyu Timofejevu () za pomoć u provođenju istrage, kao i Alekseju Krenjovu () — za titanski rad na ažuriranju Centosa i kernela na poslužiteljima. Proces koji je u ovom slučaju nekoliko puta morao početi ispočetka, zbog čega je trajao mnogo mjeseci.
Izvor: habr.com
