

Pozdrav kolege! Danas bih želeo raspraviti vrlo važnu temu za mnoge administratore Check Pointa: "Optimizacija CPU i RAM-a". Nije neuobičajeno da gateway i/ili menadžerski server iznenada troše mnogo ovih resursa, i želeo bih da razumem kuda oni "curi" i kako ih bolje iskoristiti.
1. Analiza
Za analizu opterećenja procesora korisno je koristiti sledeće komande koje se unose u ekspertskom režimu:
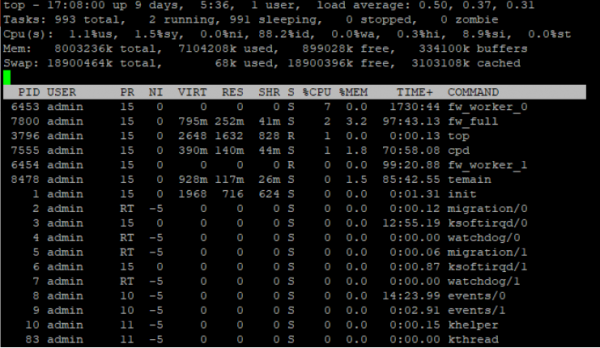
top prikazuje sve procese, količinu resursa koje CPU i RAM troše u procentima, uptime, prioritet procesa i u realnom vremenui
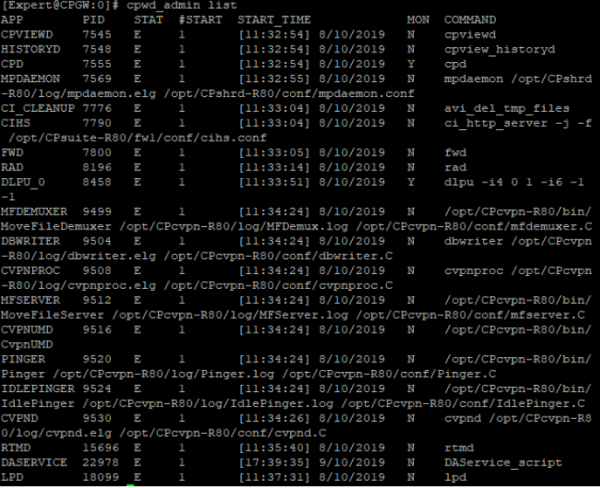
cpwd_admin list Check Point WatchDog Daemon, koji prikazuje sve module uređaja, njihov PID, stanje i broj pokretanja
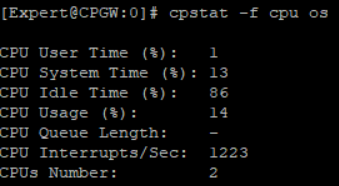
cpstat -f cpu os korisnost CPU-a, njihovu količinu i raspodelu procesorskog vremena u procentima
cpstat -f memory os korisnost virtuelne RAM, koliko je ukupno aktivnog, slobodnog RAM-a i drugo
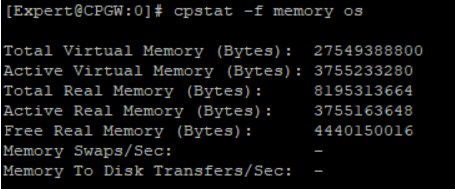
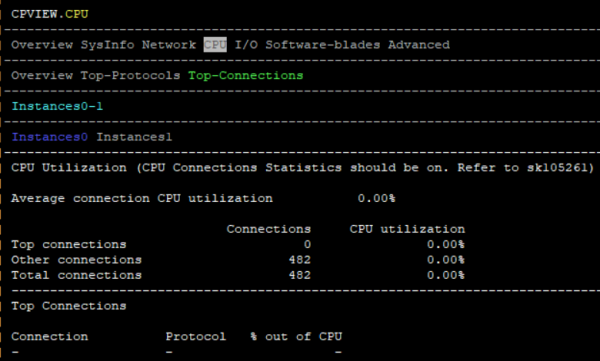
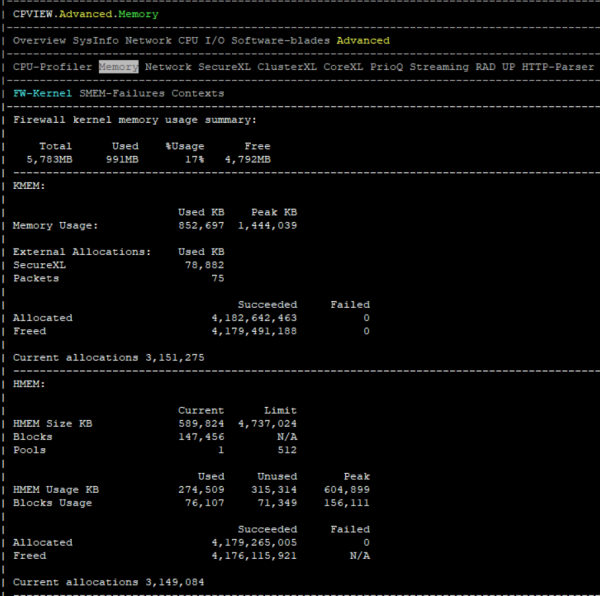
Prvo pravilo je da sve komande cpstat možete pogledati pomoću alata cpview. Da biste to uradili, jednostavno unesite komandu cpview iz bilo kog režima u SSH sesiji.
ps auxwf dugi spisak svih procesa, njihovih ID, zauzetu virtuelnu memoriju i memoriju u RAM-u, CPU
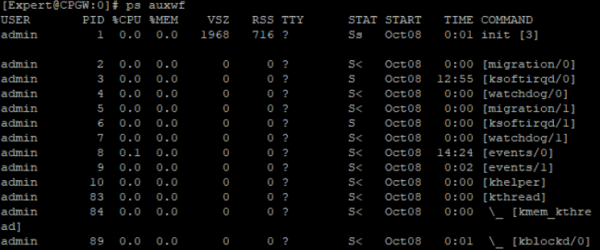
Druga varijacija komande:
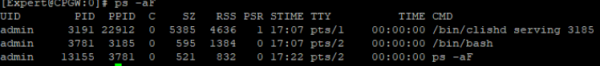
ps -aF prikazuje najviše resursa trošeći proces
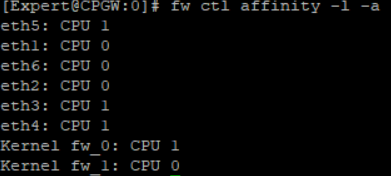
fw ctl affinity -l -a distribucija jezgara pod različite instance vatrozida, odnosno tehnologija CoreXL
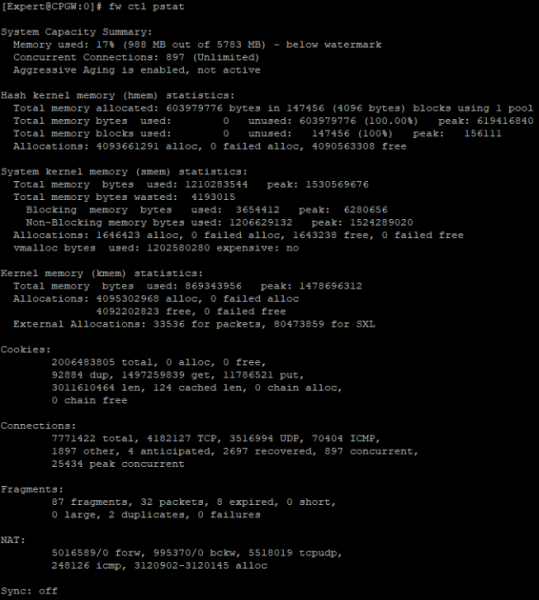
fw ctl pstat analiza RAM-a i opšti pokazatelji konekcija, kolačića, NAT
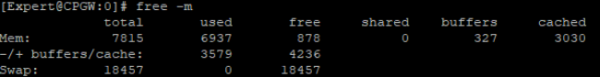
free -m RAM baferi
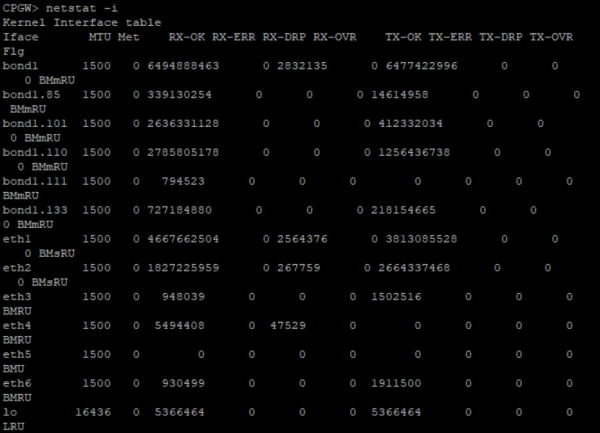
Posebnu pažnju zaslužuje komanda netsat i njene varijacije. Na primer, netstat -i može pomoći u rešavanju zadatka nadzora bafera. Parametar RX dropped packets (RX-DRP) u izlazu ove komande obično raste sam od sebe zbog gubitaka nelegitimnih protokola (IPv6, loši/nenamerni VLAN tagovi i drugi). Međutim, ako se gubici dešavaju iz drugog razloga, treba koristiti ovu , da biste započeli istragu i shvatili zašto ovaj mrežni interfes gubi pakete. Kada saznate razlog, rad uređaja se može optimizovati.
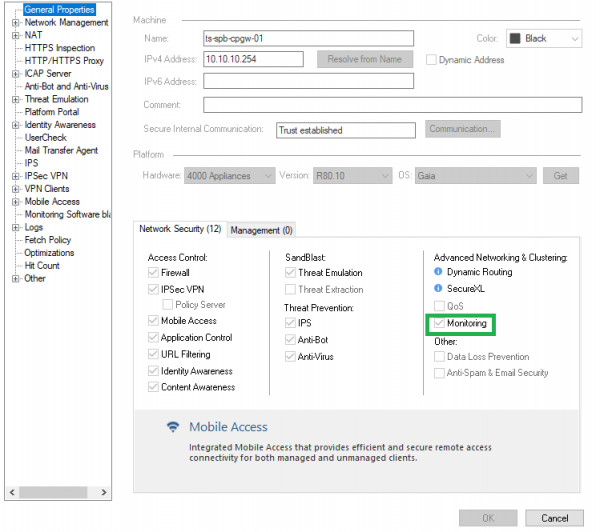
Ako je uključen monitoring blade, možete grafički pratiti ove podatke u SmartConsole-u, klikom na objekat i odabirom opcije "Device & License Information".
Preporučuje se da se blade Monitoring ne uključuje trajno, ali na dan za testiranje je sasvim u redu.
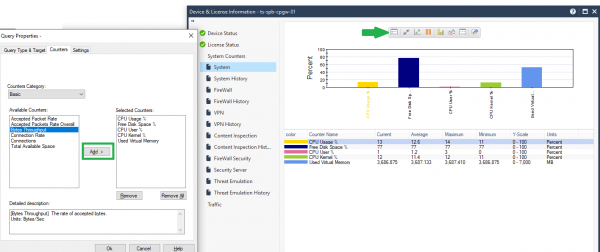
Štaviše, možete dodavati još parametara za monitoring, jedan od njih je veoma koristan — Bytes Throughput (propusnost uređaja).
Ako postoji neki drugi sustav za praćenje, na primjer, besplatan , temeljen na SNMP-u, također će poslužiti za otkrivanje tih problema.
2. "Curjenje" RAM-a tijekom vremena
Često se postavlja pitanje zašto s vremenom pristupna ili menadžerska server sve više i više koristi RAM. Želim vas umiriti: ovo je normalna pojava za Linux slične sustave.
Pogledom na izlaz naredbi free -m i cpstat -f memory os na uređaju iz stručnog načina rada, možete izračunati i pogledati sve parametre povezane s RAM-om.
Trenutna dostupna memorija na uređaju Slobodno pamćenje + Memorija u baferima + Keširana memorija = +-1.5 GB, obično.
Kao što kaže tehnička podrška, s vremenom pristupni/menadžerski server se optimizira i koristi sve više memorije, dosegnuvši otprilike 80% upotrebe, i tada se zaustavlja. Možete ponovno pokrenuti uređaj, i tada će se ovaj indikator resetirati. 1.5 GB slobodne RAM-a je sasvim dovoljno za obavljanje svih zadataka, a menadžment rijetko doseže takve granične vrijednosti.
Također, izlazi spomenutih naredbi će pokazati koliko imate Niska memorija (operativna memorija u korisničkom prostoru) i Visoka memorija (operativna memorija u kernel prostoru) korišteno.
Kernel procesi (uključujući aktivne module, poput Check Point kernel modula) koriste samo nisku memoriju. Međutim, korisnički procesi mogu koristiti i nisku i visoku memoriju. Štoviše, niska memorija je otprilike jednaka Ukupna memorija.
Treba se brinuti samo ako u logovima budu padale greške "modules reboot or processes being killed to reclaim memory due to OOM (Out of memory)". Tada je potrebno ponovno pokrenuti uređaj i obratiti se podršci ako ponovni pokret ne pomogne.
Puno objašnjenje možete pronaći u i .
3. Optimizacija
U nastavku su pitanja i odgovori o optimizaciji CPU-a i RAM-a. Na njih treba iskreno odgovoriti samom sebi i poslušati preporuke.
3.1. Je li uređaj pravilno odabran? Je li projekt bio pilot projekt?
Unatoč dobrom dimenzioniranju, mreža je mogla jednostavno rasti, a ova oprema se jednostavno ne može nositi s opterećenjem. Druga mogućnost je da dimenzioniranje kao takvo nije bilo.
3.2. Je li uključena HTTPS inspekcija? Ako jest, je li tehnologija postavljena prema najboljim praksama?
Obratite se , ako ste naš klijent, ili .
Redosljed pravila u politici HTTPS inspekcije igra značajnu ulogu u optimizaciji otvaranja HTTPS stranica.
Preporučeni redosljed pravila:
- Pravila za izuzeće s kategorijama/URL-ovima
- Pravila inspekcije s kategorijama/URL-ovima
- Pravila inspekcije za sve ostale kategorije
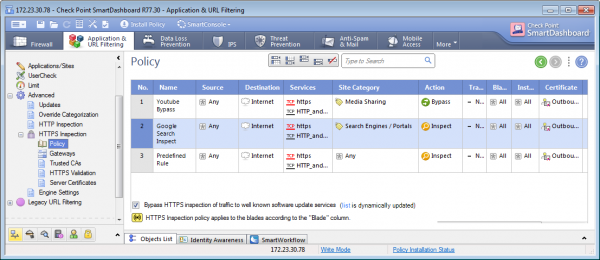
Na sličan način kao kod pravila vatrozida, Check Point traži podudaranja paketa odozgo prema dolje, stoga je bolje smjestiti bypass pravila na vrh, jer će propusni sustav uštedjeti resurse ne prolazeći kroz sva pravila ako je paket potrebno preskočiti.
3.3 Koriste li se objekti raspona adresa?
Objekti s rasponom adresa, na primjer, mreža 192.168.0.0-192.168.5.0, oduzimaju znatno više RAM-a od 5 objekata mreže. Općenito se smatra dobrom praksom ukloniti neiskorištene objekte u SmartConsole, jer svaki put prilikom postavljanja politike uređaj i upravljački poslužitelj troše resurse i, što je najvažnije, vrijeme na verifikaciju i primjenu politike.
3.4. Kako je postavljena politika prevencije prijetnji?
Prije svega, Check Point preporučuje izdvajanje IPS-a u poseban profil i stvaranje posebnih pravila za ovu blade.
Na primjer, administrator smatra da je segment DMZ potrebno zaštititi samo pomoću IPS-a. Stoga, kako uređaj ne bi trošio resurse na obradu paketa drugim blade, potrebno je stvoriti pravilo posebno za taj segment s profilom u kojem je uključen samo IPS.
Što se tiče postavki profila, preporučuje se da ga konfigurirate prema najboljim praksama u ovom (stranice 17-20).
3.5. Koliko signatura u IPS postavkama radi u načinu detekcije?
Preporučuje se temeljito obraditi signaturen, tako da treba onemogućiti neiskorištene (na primjer, signatur na iskorištavanje proizvoda Adobe zahtijevaju mnogo računalnih resursa, i ako klijent nema takve proizvode, ima smisla onemogućiti te signatur). Zatim postaviti Prevent umjesto Detect gdje god je to moguće, jer uređaj troši resurse na obradu cijele veze u načinu Detect, a u načinu Prevent odmah odbacuje vezu i ne troši resurse na punu obradu paketa.
3.6. Koje se datoteke obrađuju blade-ovima za emulaciju prijetnji, ekstrakciju prijetnji, antivirus?
Nema smisla emulirati i analizirati datoteke s ekstenzijama koje vaši korisnici ne preuzimaju ili koje smatrate nepotrebnima u vašoj mreži (na primjer, bat, exe datoteke se lako mogu blokirati pomoću Blade Content Awareness na razini vatrozida, stoga će resursi gatewaya biti manje trošeni). Štoviše, u postavkama Emulacije prijetnji možete birati Okruženje (operacijski sustav) za emulaciju prijetnji u sandboxu, a postavljanje Okruženja Windows 7 kada svi korisnici rade s 10. verzijom također nema smisla.
3.7. Jesu li pravila vatrozida i pravila razine aplikacije postavljena u skladu s najboljim praksama?
Ako pravilo ima puno hitova (podudarnosti), preporučuje se postaviti ga na vrh, dok se pravila s malim brojem hitova trebaju staviti na dno. Glavno je osigurati da se ne preklapaju i ne ometaju jedno drugo. Preporučena arhitektura politike vatrozida:
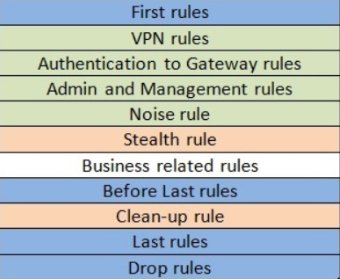
Objašnjenja:
Prva pravila — ovdje se stavljaju pravila s najvećim brojem podudarnosti
Pravilo šuma — pravilo za odbacivanje parazitskog prometa, poput NetBIOS-a
Pravilo skrivenosti — zabrana pristupa gatewayima i upraviteljima svima, osim onim izvorima koji su navedeni u pravilima autentifikacije za pravila gatewaya
Clean-Up, Last i Drop pravila obično se kombiniraju u jedno pravilo za zabranu svega što nije prethodno dopušteno
Ovi najbolji postupci opisani su u .
3.8. Koje su postavke usluga koje su kreirali administratori?
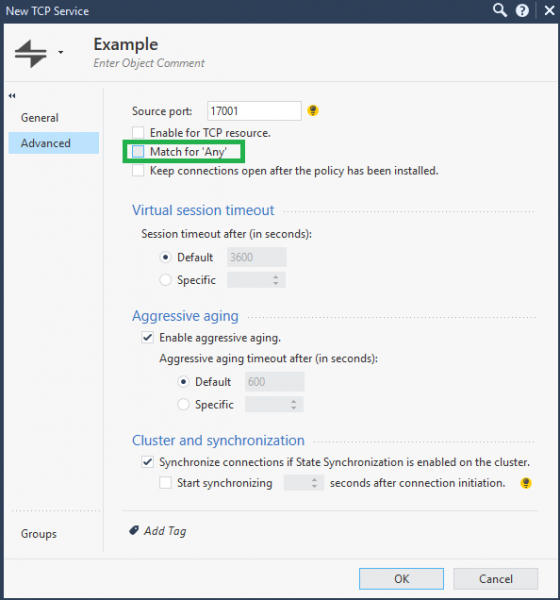
Na primjer, kreira se neka TCP usluga na određenoj portu, i ima smisla u naprednim postavkama usluge ukloniti oznaku „Match for Any“. U tom slučaju će ta usluga biti točno pod pravilom u kojem sudjeluje i neće sudjelovati u pravilima gdje u koloni Usluge piše Any.
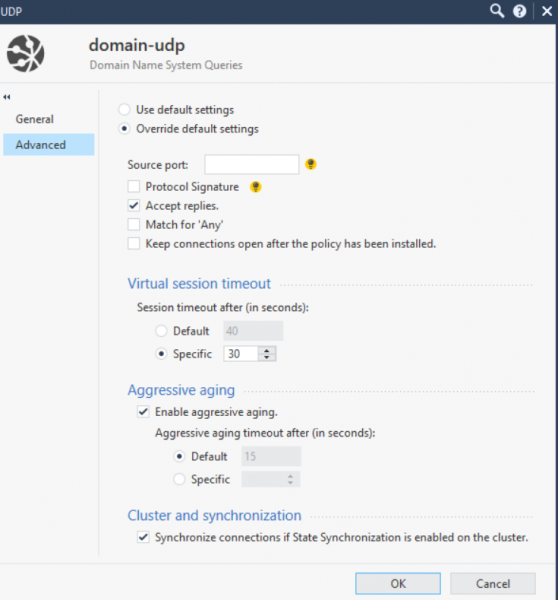
Govoreći o uslugama, treba spomenuti da ponekad može biti potrebno fino podesiti vrijeme čekanja. Ova postavka omogućit će bolje korištenje resursa gatewaya, kako ne bi zadržavala TCP/UDP sesije protokola koje ne trebaju dugo vrijeme čekanja. Na primjer, na slici ispod, premjestio sam vrijeme čekanja usluge domain-udp s 40 sekundi na 30 sekundi.
3.9. Se koristi li SecureXL i koliki je postotak ubrzanja?
Kvalitetu rada SecureXL možete provjeriti osnovnim naredbama u ekspertnom načinu rada na gatewayu fwaccel stat i fw accel stats -s. Zatim treba istražiti koji se promet ubrzava, koje se predloške (templates) može još stvoriti.
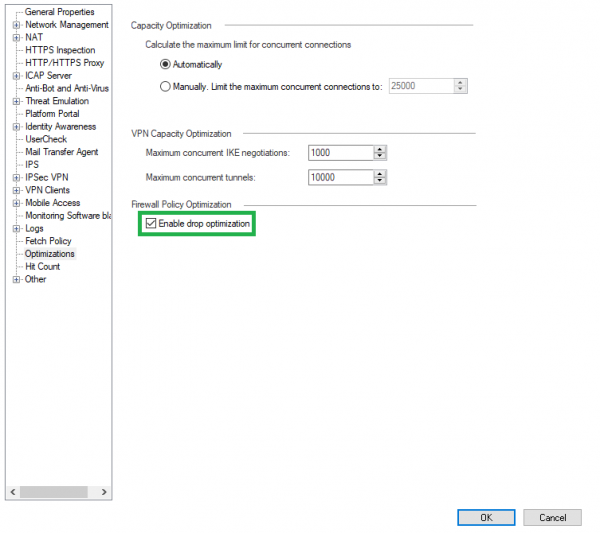
Po defaultu, Drop Templates nisu uključeni; njihovo uključivanje pozitivno će utjecati na rad SecureXL-a. Da biste to učinili, idite na postavke gateway-a i na karticu Optimizations:
Također, pri radu s klasterom, radi optimizacije CPU-a, možete isključiti sinkronizaciju nekritičnih servisa, kao što su UDP DNS, ICMP i drugi. Da biste to učinili, trebate otići na postavke servisa → Advanced → Synchronize connections of State Synchronization is enabled on the cluster.
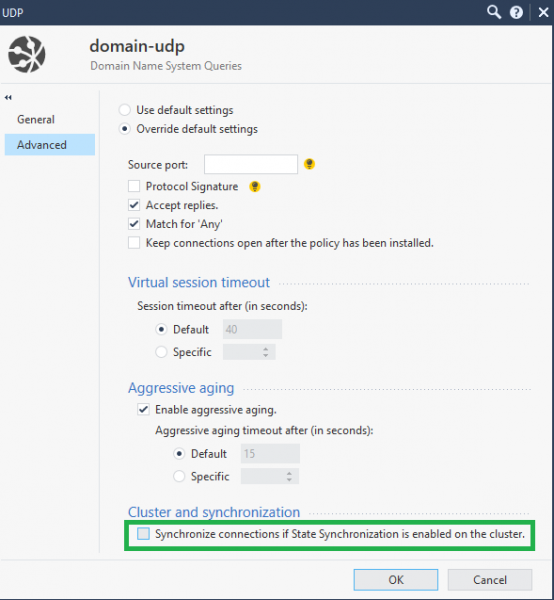
Sve Best Practice su opisane u .
3.10. Kako se koristi CoreXl?
Tehnologija CoreXL, koja omogućava korištenje više CPU-a za firewall instance (moduli vatrozida), jednoznačno pomaže optimizirati rad uređaja. Prvo, komanda fw ctl affinity -l -a pokazat će korištene firewall instance i procesore dodijeljene potrebama SND (modula koji distribuira promet na vatrozidne entitete). Ako nisu uključeni svi procesori, možete ih dodati komandom cpconfig na gatewayu.
Također, dobra opcija je instalirati za uključivanje Multi-Queue. Multi-Queue rješava problem kada se procesor sa SND koristi po visokom postotku, dok firewall instance na drugim procesorima miruju. Tada bi SND imao mogućnost stvaranja više redova za jednu NIC i postavljanje različitih prioriteta za različiti promet na razini jezgre. Kao rezultat, jezgre CPU-a će se koristiti učinkovitije. Metodologije su također opisane u .
Na kraju, želio bih reći da ovo nije sve Best Practices za optimizaciju rada Check Point-a, već samo najpopularnije. Ako želite zatražiti reviziju vaše sigurnosne politike ili riješiti problem vezan uz Check Point, slobodno se obratite na sales@tssolution.ru.
Hvala na pažnji!
Izvor: habr.com
