

Kapacitetni Tier (ili kako ga mi zovemo internu — kapitir) pojavio se još u vrijeme Veeam Backup and Replication 9.5 Update 4 pod imenom Archive Tier. Ideja koja stoji iza njega je omogućiti premještanje sigurnosnih kopija koje su ispale iz takozvanog operativnog prozora vraćanja na objektna spremišta. Ovo je pomagalo u oslobađanju prostor na disku korisnicima kojima je to bilo potrebno. Ova opcija nazivala se Move Mode.
Za izvršenje ove jednostavne (kako se čini) radnje bilo je dovoljno ispuniti dva uvjeta: sve točke iz premještane sigurnosne kopije moraju biti izvan prethodno spomenutog operativnog prozora vraćanja, koji se uočava u korisničkom sučelju. I drugo: lanac mora biti u takozvanom „zapečaćenom obliku“ (sealed backup chain ili Inactive Backup Chain). Odnosno, s vremenom u ovom lancu ne dolazi do promjena.
Međutim, u VBR v10 koncept je obogaćen novim funkcijama — uvedeni su Copy Mode, Sealed Mode i stvar s teško izgovorivim imenom Immutability.
O ovim zanimljivim stvarima danas ćemo razgovarati. Prvo o tome kako je to funkcioniralo u VBR9.5u4, a zatim o promjenama u desetoj verziji.
I neka mi oproste ljubitelji čistog jezika, ali previše termina jednostavno nije moguće prevesti.
Tako da će ovdje biti mnogo anglicizama.
I mnogo GIF-ova.
I slika.
- Bez ikakvih žaljenja. Autor članka.
Kako je bilo
Pa, započnimo s obradom operativnog prozora vraćanja i zapečaćene sigurnosne kopije (ili kako ih nazivaju u dokumentaciji Inactive Backup Chain). Bez njihovog razumijevanja daljnje objašnjenje neće biti moguće.
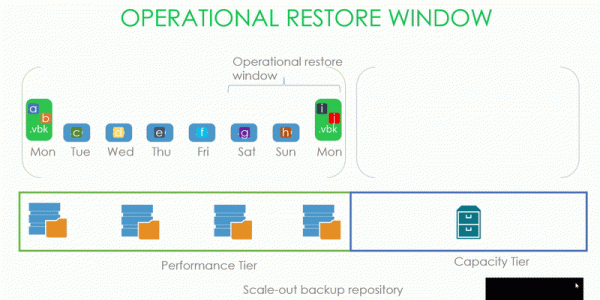
Kao što možemo vidjeti na slici, imamo neku sigurnosnu kopiju s blokovima podataka, koja je smještena na Performance tier SOBR repozitoriju, na koji je povezan Capacity Tier. Naše operativno prozor vraćanja je tri dana.
Prema tome, .vbk stvoren u ponedjeljak pečati prethodni lanac, čije je prozračje postavljeno na tri dana. I, stoga, možemo mirno početi premještati u kapacitetni tier sve što je starije od tri dana.
Ali što se zapravo podrazumijevalo pod zapečaćenim lancem i što se moglo slati u kapacitetni tier u update 4?
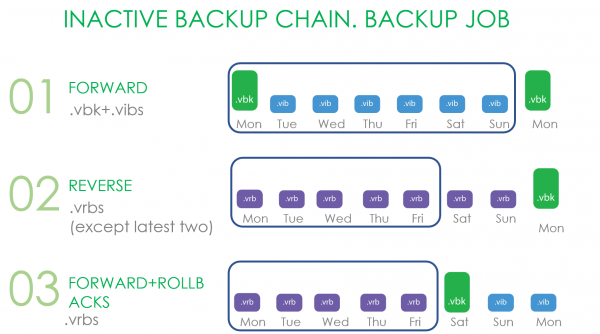
Za Forward Incremental oznaka zapečaćenja lanca je stvaranje nove pune sigurnosne kopije. I nije važno kako ta puna sigurnosna kopija nastaje: uzimaju se u obzir i synthetic full, i active full sigurnosne kopije.
U slučaju Reverse, to su svi datoteke koje ne ulaze u operativni prozor.
U slučaju Forward increment s rollback-ovima, to su svi rollback-ovi i .vbk, ako na performance extentu postoji još jedan .vbk.
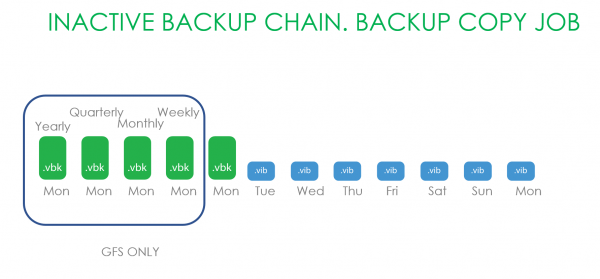
Sada razmotrimo varijantu rada s Backup Copy lancima. Ovdje se prevozilo samo ono što spada pod GFS retention. Jer sve što se nalazi u novijim backup copy lancima može biti na bilo koji način promijenjeno.
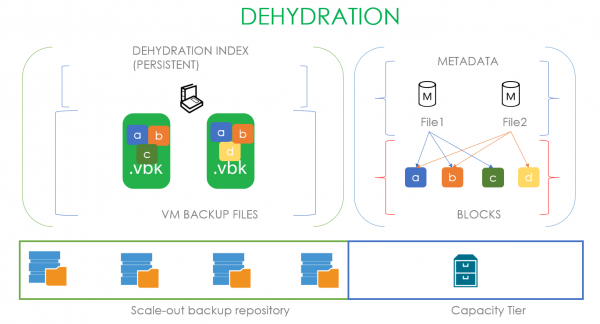
Sada zavirimo ispod haube. Tamo se odvija proces koji se naziva dehidratacija — ostavljanje praznih backup datoteka na extentu i prebacivanje blokova iz tih datoteka na capacity tier. Za optimizaciju ovog procesa koristi se takozvani indeks dehidratacije koji omogućuje ne kopiranje blokova koji su već bili kopirani u capacity tier.
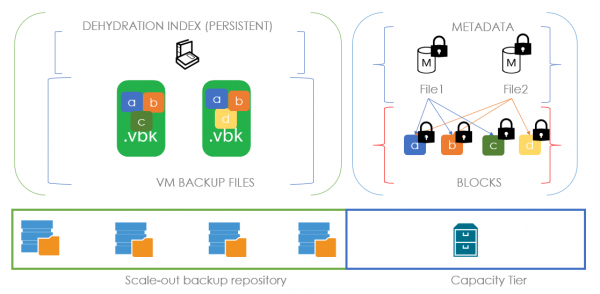
Pogledajmo kako to izgleda na primjeru: pretpostavimo da imamo .vbk koji je izašao iz operativnog prozora i pripada zapečaćenoj lancu. To znači da imamo potpuno pravo premjestiti ga u capacity tier. U trenutku premještanja stvara se metadatna datoteka u capacity tieru i blokovi datoteke koja se premješta. U metadatnoj datoteci na razini referenci opisuje se od kojih blokova se sastoji naša datoteka. U slučaju na slici, naša prva datoteka sastoji se od blokova a, b, c, a u metadatama su sadržane reference na te blokove. Kada se pojavi druga .vbk datoteka, spremna za premještanje i sastavljena od blokova a, b i d, analizirajući indeks dehidratacije, shvaćamo da treba premjestiti samo blok d. A njezina metadatna datoteka će sadržavati reference na dva prethodna bloka i jedan novi.
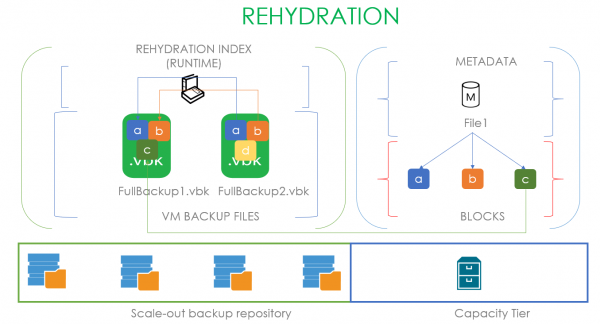
Prema tome, proces vraćanja tih praznih blokova podacima naziva se rehidratacija. Ovdje se koristi vlastiti indeks rehidratacije, oslanjajući se na najstariju .vbk datoteku na lokalnom performance extentu. Dakle, ako korisnik želi vratiti datoteku iz capacity tiera, prvo stvaramo indeks blokova najstarijeg potpunog backup-a i premještamo iz capacity tiera samo nedostajuće blokove. U slučaju prikazanom na slici, kako bismo rehidratirali FullBackup1.vbk prema indeksu rehidratacije, nedostaje nam samo blok C, koji uzimamo iz capacity tiera. Ako kao capacity tier služi oblakni objektni storage, to omogućuje uštedu ogromnih količina novca.
Ovdje se može činiti da je ova tehnologija identična onoj koja se koristi u WAN akceleratorima, ali to je samo privid. U akceleratorima se vrši globalna deduplikacija, dok se ovdje koristi lokalna unutar svakog datoteke na određenoj offsetu. To se događa zbog razlike u zadacima: ovdje trebamo kopirati velike datoteke punih sigurnosnih kopija, i prema našim istraživanjima, čak i ako između njih prođe duži vremenski period, takav algoritam deduplikacije daje najbolje rezultate.
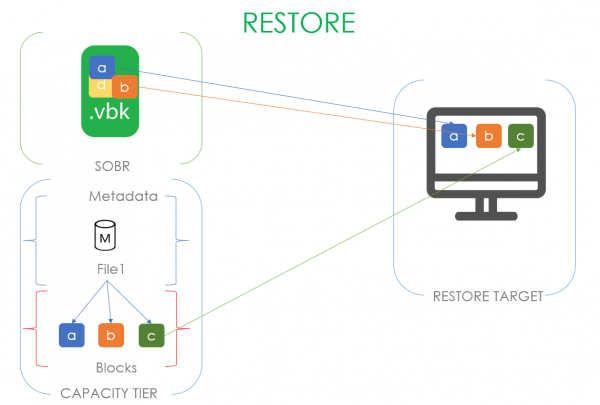
Ali više indeksa bogu indeksa! Tu je i indeks za vraćanje podataka! Kada pokrenemo vraćanje stroja smještenog u kapacitetu, čitat ćemo samo jedinstvene blokove podataka koji nisu u performansama.
Kako je postalo
S ovim smo završili uvodni dio. On je prilično detaljan, ali, kao što je rečeno, bez tih detalja ne može se objasniti kako nove funkcije funkcioniraju. Stoga bez dodatnih uvoda prelazimo na prvo.
Copy mode
U velikoj mjeri temelji se na postojećim tehnologijama, međutim nosi sa sobom potpuno drugačiju logiku korištenja.
Cilj ovog načina rada je osigurati da svi podaci smješteni na lokalnom ekstentu imaju kopiju u kapacitetu.
Ako usporedimo direktno Move i Copy načine rada, ispada ovako:
- Može se premještati samo zaključena niz. U slučaju načina rada kopiranja prevozi se apsolutno sve, bez obzira na to što se događa u sigurnosnoj kopiji.
- Premještanje se aktivira kada datoteke izađu iz okvira operativne sigurnosne kopije, dok se kopiranje aktivira odmah, čim se pojavi datoteka sigurnosne kopije.
- Praćenje novih podataka za kopiranje događa se stalno, dok se premještanje aktivira svaka 4 sata.
U razmatranju novog načina rada predlažem da idemo od jednostavnih primjera do složenih.
U najjednostavnijem slučaju jednostavno se pojavljuju nove datoteke s inkrementima, i jednostavno ih kopiramo u kapacitet. Bez obzira na to koji način se koristi u sigurnosnoj kopiji, bez obzira na to pripada li zatvorenoj seriji ili ne, bez obzira na to je li isteklo naše operativno okno. Samo smo uzeli i kopirali.
Proces koji stoji iza ovoga i dalje je dehidratacija na način koji je gore opisan. U režimu kopiranja također se prati kako ne bismo kopirali blokove koji već postoje u našem objektu. Jedina razlika je što, dok smo u režimu premještanja zamjenjivali stvarne datoteke datotekama praznim datotekama, ovdje ih ne diramo i ostavljamo sve kakvo jest. U ostalom, ovo je posve isti indeks dehidratacije koji pomno nastoji uštedjeti vaš novac i vrijeme.
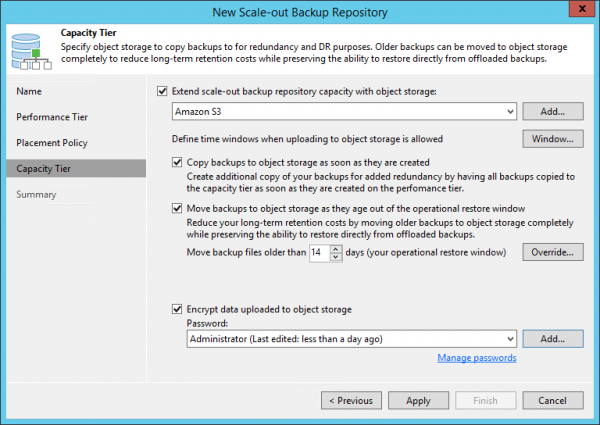
Postavlja se pitanje — ako pogledamo u korisničko sučelje, postoji mogućnost odabira obje opcije istovremeno. Kako će raditi ovaj kombinirani način?
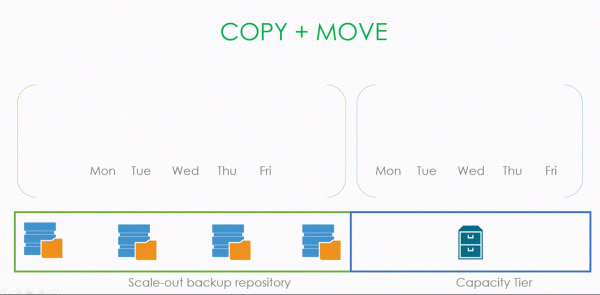
Hajde da istražimo.
Početak je standardan: stvara se datoteka sigurnosne kopije i odmah se kopira. Uz nju se stvara inkrement i također se kopira. To se događa sve dok ne shvatimo da su datoteke izašle iz našeg operativnog prozora i da je nastala zapečaćena poveznica. U tom trenutku radimo operaciju dehidratacije i zamjenjujemo te datoteke praznim datotekama. Naravno, ponovo na kapacitetu ništa ne kopiramo.
Za svu ovu zanimljivu logiku odgovara samo jedna oznaka u sučelju: Copy backups to object storage as soon as they are created.
A zašto nam je potreban ovaj Copy režim?
Čak je bolje preformulirati pitanje — od kojih rizika se štitimo pomoću njega? Koji problem nam pomaže riješiti?
Odgovor je očit: naravno, to je obnova podataka. Ako imamo potpunu kopiju lokalnih podataka u objektu, nije važno što se dogodi s našim proizvodom, uvijek možemo obnoviti podatke iz datoteka koje se nalaze u uvjetnoj Amazon.
Stoga, hajde da prođemo kroz moguće scenarije, od najjednostavnijeg do složenijeg.
Najjednostavnija nepogoda koja može pasti na naše glave — to je nedostupnost jedne od datoteka u sigurnosnoj kopiji.
Tužnija priča — jedan od ekstenta našeg SOBR repozitorija je pao.
Još gore postaje kada cijeli SOBR repozitorij postane nedostupan, ali radi kapacitet.
A najgore od svega — to je kada umre server za sigurnosnu kopiju i vaša prva želja je pokušati dotrčati do kanadske granice za deset minuta.
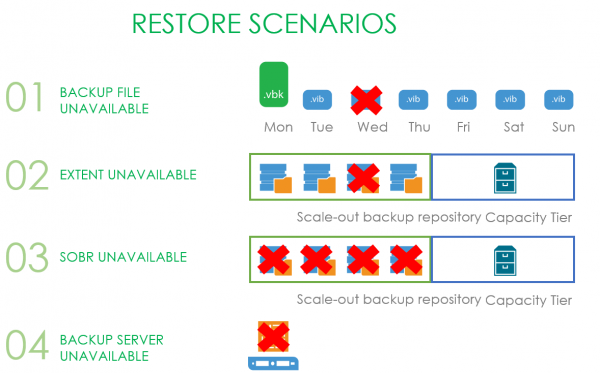
A sada hajde da razradimo svaku situaciju zasebno.
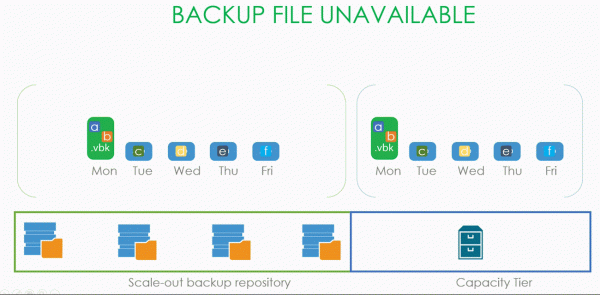
Kada izgubi jedan (ili, da, čak nekoliko) backup datoteka, samo treba pokrenuti proces skeniranja repozitorija, a izgubljena datoteka će biti zamijenjena datotekom prazninom. A uz pomoć procesa rehidratacije (o kojem je bilo riječi na početku članka) korisnik može preuzeti podatke iz kapacitetnog tira u lokalnu pohranu.
Sada je situacija složenija. Pretpostavimo da naš SOBR sastoji od dva ekstenziona koja rade u Performance modu, što znači da su naši .vbk i .vib nerazmjerno raspoređeni po njima. I u nekom trenutku jedan od ekstenziona postaje nedostupan, a korisnik mora hitno obnoviti mašinu, čiji dio podataka se nalazi baš na tom ekstenziju.
Korisnik pokreće čarobnjaka za oporavak, bira točku na koju želi obnoviti, a čarobnjak u procesu rada shvata da svi potrebni podaci za oporavak nisu lokalno dostupni i da ih treba preuzeti iz kapacitetnog tira. Pri tome, blokovi koji su ostali na lokalnoj pohrani neće se preuzimati iz oblaka. Hvala indekсу povratka (da, o njemu je također bilo riječi na početku članka).
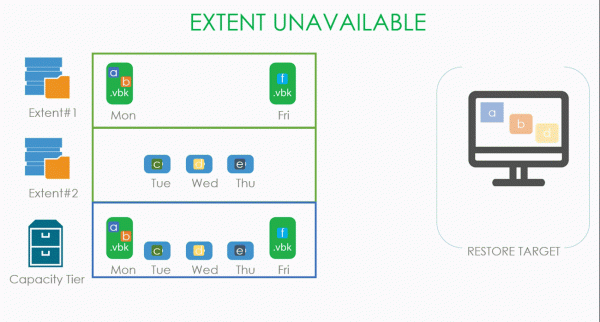
Podvrsta ovog slučaja — cijeli SOBR repozitorij postaje nedostupan. U tom slučaju nemamo što kopirati s lokalnih pohrana, i svi blokovi se preuzimaju iz oblaka.
I najzanimljivija situacija — backup server je umro. Ovdje postoje dvije opcije: admin je pametan i radio je konfiguracijske backup-e, ili je admin sam sebi zlobni Buratino i nije napravio konfiguracijski backup.
U prvom slučaju, bit će dovoljno samo negdje postaviti čistu instalaciju VBR-a i obnoviti njegovu bazu iz backupa standardnim sredstvima. Na kraju ovog procesa sve će se vratiti na svoje mjesto. Ili će se obnova izvršiti prema jednom od scenarija iznad.
No, ako je administrator ili sebi neprijatelj, ili je sigurnosna kopija konfiguracije također doživjela mitološku nesreću, tada ga ovdje nećemo prepustiti samom sebi. Za ovaj slučaj uveli smo novu proceduru koja se zove Import Object Storage. Ona omogućava preskočiti ručni proces ponovne izrade SOBR repozitorija i njegovog povezivanja s kapacitetom tira, a jednostavno dodati objektno skladište u sučelje Veeam i pokrenuti Import Storage Repository proceduru. Jedina prepreka koja može stati između vas i vaših sigurnosnih kopija jest zahtjev za unosom lozinke ako su vaše sigurnosne kopije bile šifrirane.
Što se tiče Copy Mode-a, mislim da je to sve, a prelazimo na
Sealed Mode
Glavna ideja je da se na odabranom ekstentu SOBR repozitorija ne mogu pojaviti nove sigurnosne kopije. Do verzije 10 imali smo samo Maintenance Mode, kada je potpuno zabranjen bilo kakav rad s repozitorijem. To je bio pravi hardcore način isključenja skladišta iz rada, gdje je dostupna samo tipka Evacuate koja je jednokratno premještala sigurnosne kopije na drugi ekstent.
A Sealed mode je svojevrstan „meki“ oblik: zabranjujemo stvaranje novih sigurnosnih kopija i postepeno uklanjamo stare prema odabranom retentionu, ali u tom procesu ne gubimo mogućnost oporavka iz spremljenih točaka. Vrlo korisna stvar kada nam se približava kraj vijeka trajanja opreme i treba ju zamijeniti, ili je jednostavno potrebno osloboditi za nešto važnije, a ne možemo jednostavno sve prenijeti. Ili nije moguće izbrisati.
Prema tome, princip rada je prilično jednostavan: treba zabraniti sve write operacije (pojavljuje se novih podataka), ostavljajući read (restoracije) i delete (retention).
Oba moda se mogu koristiti istovremeno, samo treba uzeti u obzir da Maintenance ima viši prioritet.
Kao primjer razmotrit ćemo SOBR sastavljen od dva ekstenta. Pretpostavimo da su prvih četvrt dana sigurnosne kopije kreirane u načinu Forward Forever Incremental, a zatim zapsealed ekstent. To dovodi do toga da započinjemo stvaranje novog aktivnog full-a na drugom dostupnom ekstentu. Ako je naš retention četiri, kada cijeli lanac smješten na zapelom ekstentu premaši njegovu granicu, on se s mirnom savješću može izbrisati.
Postoje situacije kada se brisanje odvija ranije. Na primjer, to su Forward incremental s periodičnim punim backupima. Ako su prva dva dana rađeni puni backupovi, a u četvrtak odlučimo zapečatiti repozitorij, onda će u petak, kada se stvori novi puni backup, datoteka iz ponedjeljka biti obrisana jer do tog trenutka nema zavisnosti. I sama ta točka ne ovisi ni o čemu. Nakon toga čekamo da se stvore četiri točke na dostupnom ekstenziju i brišemo preostale tri koje ne mogu biti neovisno obrisane.
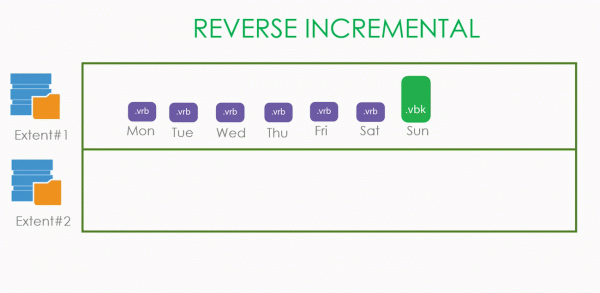
S obzirom na Reverse Incremental, situacija je jednostavnija. U njemu najstarije točke ne ovise ni o čemu i mogu se slobodno brisati. Stoga, čim se stvori novi .vbk na novom ekstenziju, stare .vrb bit će brisane jednu po jednu.
Usput, zašto svaki put stvaramo novi .vbk: ako ga ne bismo stvarali, a nastavili bismo staru lanac inkrementa, stari .vbk bi se vječno visio u bilo kojem režimu, onemogućavajući njegovo brisanje. Stoga je donesena odluka da čim se ekstenzija zapečati, stvaramo puni backup na slobodnom ekstenziju.
Situacija je složenija s kapacitetom tira.
Prvo razmotrite copy mode. Pretpostavimo da su se četiri dana aktivno stvarali backupovi, a zatim je kapacitet tir zapečatiran. Ne brišemo ništa, već strpljivo dočekujemo reteniciju, nakon čega brišemo podatke s kapacitetnog tira.
Otprilike isto se događa u move mode — čekamo reteniciju, brišemo stare u lokalnom skladištu, brišemo pohranjeno u objektnoj pohrani.
Zanimljiv primjer s Forever forward incremental. Postavljamo reteniciju na tri točke i počinjemo s izradom backupova u ponedjeljak, koji se redovito kopiraju u oblak. Nakon pečatenja pohrane, backupovi se nastavljaju stvarati, držeći tri točke, ali podaci pohranjeni u kapacitetnom tiru ostaju zavisni i ne mogu se obrisati. Stoga čekamo četvrtak, kada naš .vbk izlazi iz okvira retenicije, i tek tada mirno brišemo čitav spremljeni lanac.
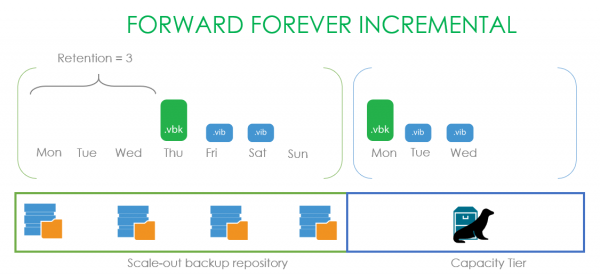
I mala napomena: svi primjeri ovdje prikazani su s jednim strojem. Ako imate više strojeva u backupu, njihova će retenicija biti različita ovisno o tome je li napravljen Active Full ili ne.
Na tome, u principu, završavamo. Tako da prelazimo na najhardkor značaj —
Imutabilnost
Kao i s prethodnim stavkama, prvo ćemo objasniti koju problematiku ova funkcija rješava. Kada sačuvamo naše backupove negdje na skladištenje, javlja se snažna potreba za njihovim očuvanjem, tj. fizički zabraniti njihovo brisanje i bilo kakve modifikacije tokom zadanog retentiona. To uključuje i administratore, čak i pod njihovim root računima. To omogućava zaštitu od slučajnog ili namjernog oštećenja. Oni koji rade s AWS-om, mogli su se susresti s ovom funkcijom pod nazivom Object Lock.
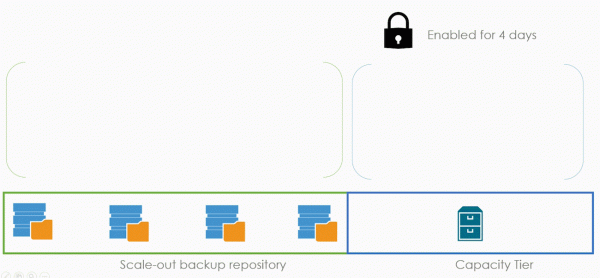
Sada ćemo razmotriti način rada u općim crtama, a kasnije ćemo se posvetiti detaljima. U našem primjeru, Immutability će biti uključen za naš capacity tier s retention periodom od četiri dana. A u backupu je uključen način rada Copy.
Immutability ne utječe na opći retention. Na primjer, ne dodaje dodatne točke ili nešto slično. Samo tokom četiri dana osoba ne može izbrisati datoteke backupova. Ako se u ponedjeljak napravi backup, datoteku će moći izbrisati tek u petak.
Svi ranije objašnjeni koncepti dehidratacije, indeksa i metapodataka nastavljaju funkcionirati na isti način. Ali s jednim uvjetom — blok se postavlja ne samo za podatke, već i za metapodatke. To je učinjeno u slučaju da zloćudni napadač odluči obrisati našu bazu metapodataka, kako bi blokovi s podacima ostali korisni i ne pretvorili se u beskorisnu binarnu kašu.
I sada je došlo sjajno vrijeme za objašnjenje naše tehnologije generiranja blokova. Ili block generation. Za ovo razmotrite situaciju koja je dovela do njenog pojavljivanja.
Uzmimo vremensku liniju od šest dana i zabilježimo vrijeme očekivanog isteka immutability na dnu. Prvog dana stvaramo datoteku koja se sastoji od bloka a i njegovih metapodataka. Ako je immutability postavljen na tri dana, logično je pretpostaviti da će podaci biti otključani i izbrisani četvrtog dana. Drugog dana dodajemo novu datoteku file2, koja se sastoji od bloka b s istim postavkama. Blok a još uvijek treba biti izbrisan četvrtog dana. No trećeg dana događa se strašna stvar - stvara se datoteka File3, koja se sastoji od novog bloka d i poveznice na stari blok a. To znači da bi za blok a njegov immutability flag trebao biti ponovno postavljen na novi rok, koji se pomiče na šesti dan. I tu nastaje problem - u stvarnim backupovima takvih blokova nastaje ogromna količina. A da bismo produžili njihov immutability period, potrebno je svaki put izvršiti ogromnu količinu zahtjeva. I zapravo, to će biti gotovo beskrajan dnevni proces, jer s velikom vjerojatnošću pri svakom kopiranju nalazimo velike količine dedupliciranih blokova. A što to znači za veliki broj zahtjeva kod pružatelja usluga objektnog pohranjivanja? Točno! Ogroman račun na kraju mjeseca.
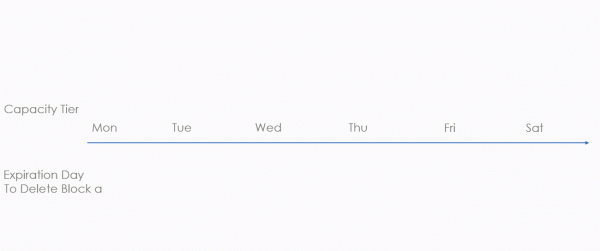
I kako ne bismo svoje omiljene klijente na ravnom mjestu izložili velikim troškovima, izmišljen je mehanizam generiranja blokova. To je dodatno razdoblje koje dodajemo na postavljen period immutability. U donjem primjeru to razdoblje iznosi dva dana. No to je samo za primjer. U stvarnosti se koristi vlastita formula koja daje otprilike deset dodatnih dana uz mjesečni lok.
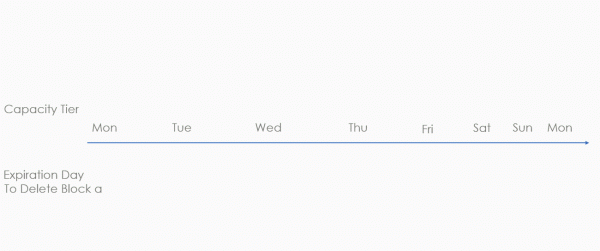
Nastavimo razmatrati istu situaciju, ali sada s generacijom blokova. U prvom danu kreiramo file1 iz bloka a i metapodataka. Skupljamo razdoblje generacije i nepromjenjivost — to znači da će mogućnost brisanja datoteke biti na šesti dan. Ako drugog dana stvorimo File2, koji se sastoji od bloka b i reference na blok a, tada se očekivani datum brisanja ne mijenja. On ostaje na šestom danu. Pri tome nastojimo uštedjeti novac na broju upita. Jedina situacija kada rok može biti pomaknut je ako je razdoblje generacije isteklo. Drugim riječima, ako trećeg dana novi File3 sadrži referencu na blok a, tada će biti dodana generacija 2 jer je Gen1 već istekao. Očekivani datum brisanja bloka a pomaknut će se na osmi dan. To nam omogućuje drastično smanjenje broja upita za produženje vremena života dedupliranih blokova, što štedi puno novca klijentima.
Sama tehnologija dostupna je korisnicima S3 i S3-kompatibilnog hardvera, čiji proizvođači jamče da se njihova implementacija ne razlikuje od Amazonove. O отсудно, odgovor na legitimno pitanje zašto Azure nije podržan — oni imaju sličnu funkciju, ali ona radi na razini kontejnera, a ne pojedinačnih objekata. Usput, u samom Amazonu objekt lock ima dva načina rada: compliance i governance. U drugom slučaju ostaje mogućnost da najmoćniji administrator ili root korisnik, unatoč objekt lock-u, ipak izbriše podatke. U slučaju compliance, sve je čvrsto učvršćeno i nitko, čak ni administratori Amazona (prema njihovim službenim izjavama), ne mogu izbrisati sigurnosne kopije. Mi podržavamo upravo ovaj način.
I, tradicionalno, malo korisnih linkova:
- O u svim detaljima.
- Sve informacije o u najboljem svjetlu
- o u detaljima
Izvor: habr.com
