

U ovom postu bismo željeli podijeliti zanimljiv način rješavanja konfiguracije distribuiranog sustava.
Konfiguracija je izravno predstavljena u Scala jeziku na siguran način. Primjer implementacije je detaljno opisan. Raspravlja se o raznim aspektima prijedloga, uključujući utjecaj na cjelokupni razvojni proces.
()
Uvod
Izgradnja robusnih distribuiranih sustava zahtijeva korištenje ispravne i koherentne konfiguracije na svim čvorovima. Uobičajeno rješenje je korištenje tekstualnog opisa implementacije (terraform, ansible ili nešto slično) i automatski generiranih konfiguracijskih datoteka (često — namjenskih za svaki čvor/ulogu). Također bismo željeli koristiti iste protokole istih verzija na svakom komunikacijskom čvoru (inače bismo se susreli s problemima nekompatibilnosti). U JVM svijetu to znači da knjižnica za razmjenu poruka mora biti iste verzije na svim komunikacijskim čvorovima.
Što je s testiranjem sustava? Naravno, trebali bismo imati jedinične testove za sve komponente prije nego što pređemo na integracijske testove. Kako bismo mogli extrapolirati rezultate testiranja na radno vrijeme, trebali bismo osigurati da su verzije svih knjižnica identične u radnom i testnom okruženju.
Prilikom izvođenja integracijskih testova, često je mnogo lakše imati istu classpath na svim čvorovima. Samo trebamo osigurati da se ista classpath koristi prilikom implementacije. (Moguće je koristiti različite classpath na različitim čvorovima, ali teže je predstaviti ovu konfiguraciju i ispravno je implementirati.) Dakle, kako bismo pojednostavili stvari, razmatrat ćemo samo identične classpath na svim čvorovima.
Konfiguracija obično evoluira zajedno s softverom. Obično koristimo verzije za identifikaciju raznih
faza evolucije softvera. Čini se razumnim obuhvatiti konfiguraciju pod upravljanjem verzijama i identificirati različite konfiguracije s nekim oznakama. Ako postoji samo jedna konfiguracija u proizvodnji, možemo koristiti jednu verziju kao identifikator. Ponekad možemo imati više proizvodnih okruženja. I za svako okruženje možda će nam trebati zasebna grana konfiguracije. Tako konfiguracije mogu biti označene granom i verzijom za jedinstveno prepoznavanje različitih konfiguracija. Svaka oznaka grane i verzija odgovara jedinstvenoj kombinaciji distribuiranih čvorova, portova, vanjskih resursa, verzija knjižnica classpath na svakom čvoru. Ovdje ćemo pokriti samo jednu granu i identificirati konfiguracije pomoću trokomponentne decimalne verzije (1.2.3), na isti način kao i druge artefakte.
U modernim okruženjima konfiguracijske datoteke više se ne mijenjaju ručno. Obično generiramo
konfiguracijske datoteke u vrijeme implementacije i kasnije. Dakle, neki bi se mogli zapitati zašto još uvijek koristimo tekstualni format za konfiguracijske datoteke? Održivija opcija je smjestiti konfiguraciju unutar jedinice kompilacije i iskoristiti validaciju konfiguracije u vrijeme kompilacije.
U ovom postu ćemo istražiti ideju zadržavanja konfiguracije u kompajliranom artefaktu.
Kompajlabilna konfiguracija
U ovom će se odjeljku raspraviti primjer statičke konfiguracije. Dvije jednostavne usluge — echo servis i klijent usluge echo se konfiguriraju i implementiraju. Zatim se instanciraju dva različita distribuirana sustava s oba servisa. Jedan je za konfiguraciju jednog čvora, a drugi za konfiguraciju dva čvora.
Tipični distribuirani sustav sastoji se od nekoliko čvorova. Čvorovi se mogu identificirati koristeći neki tip:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
ili jednostavno
case class NodeId(hostName: String)ili čak
object Singleton
type NodeId = Singleton.type
Ovi čvorovi obavljaju različite uloge, pokreću različite usluge i trebali bi biti u mogućnosti komunicirati s drugim čvorovima putem TCP/HTTP veza.
Za TCP vezu potreban je barem broj porta. Također želimo osigurati da klijent i poslužitelj koriste isti protokol. Kako bismo modelirali vezu između čvorova, proglasimo sljedeću klasu:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])where Port je samo Int unutar dopuštenog raspona:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Pročišćene vrste
Pogledajte knjižnicu. Ukratko, omogućuje dodavanje ograničenja u vrijeme kompilacije drugim vrstama. U ovom slučaju Int može imati samo 16-bitne vrijednosti koje mogu predstavljati broj porta. Nema obaveze koristiti ovu biblioteku za ovaj pristup konfiguraciji. Čini se da se vrlo dobro uklapa.
Za HTTP (REST) možda ćemo također trebati putanju servisa:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Phantom tip
Kako bismo identificirali protokol tijekom kompilacije, koristimo značajku Scalе koja omogućuje deklaraciju tipnog argumenta Protokol koji se ne koristi u klasi. To je tako zvani phantom tip. Tijekom izvođenja rijetko trebamo instancu identifikatora protokola, zato ga ne pohranjujemo. Tijekom kompilacije ovaj phantom tip pruža dodatnu tipnu sigurnost. Ne možemo proslijediti port s neispravnim protokolom.
Jedan od najšire korištenih protokola je REST API s Json serijalizacijom:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]where RequestMessage je osnovni tip poruka koje klijent može poslati poslužitelju i ResponseMessage je poruka odgovora od poslužitelja. Of course, možemo stvoriti druge opise protokola koji preciziraju komunikacijski protokol s potrebnom preciznošću.
Za svrhe ovog posta koristit ćemo jednostavniju verziju protokola:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]U ovom protokolu poruka zahtjeva se dodaje u url, a poruka odgovora se vraća kao običan string.
Konfiguracija servisa mogla bi biti opisana imenom servisa, kolekcijom portova i nekim ovisnostima. Postoji nekoliko mogućih načina na koji se svi ti elementi mogu prikazati u Scalе (na primjer, HList, algebarski podatkovni tipovi). Za svrhe ovog posta koristit ćemo Cake Pattern i predstavljati kombinabilne komade (module) kao traitove. (Cake Pattern nije zahtjev za ovaj kompilabilni pristup konfiguraciji. To je samo moguća implementacija ideje.)
Ovisnosti se mogu predstavljati pomoću Cake Pattern kao krajnje točke drugih čvorova:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Echo servis samo treba konfigurirati port. I izjavljujemo da ovaj port podržava echo protokol. Napominjemo da u ovom trenutku ne trebamo specificirati određeni port, jer traitovi omogućuju deklariranje apstraktnih metoda. Ako koristimo apstraktne metode, kompajler će zahtijevati implementaciju u instanci konfiguracije. Ovdje smo pružili implementaciju (8081) i ona će se koristiti kao zadana vrijednost ako je preskočimo u konkretnoj konfiguraciji.
Možemo deklarirati ovisnost u konfiguraciji klijenta echo servisa:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Ovisnost ima isti tip kao echoService. Konkretno, zahtijeva isti protokol. Stoga možemo biti sigurni da će, ako povežemo ove dvije ovisnosti, ispravno raditi.
Implementacija servisa
Servis treba funkciju za pokretanje i uredno isključivanje. (Sposobnost za isključivanje servisa je kritična za testiranje.) Opet postoji nekoliko opcija za specificiranje takve funkcije za dati config (na primjer, mogli bismo koristiti tipne klase). Za ovaj post opet ćemo koristiti Cake Pattern. Možemo predstaviti servis koristeći cats.Resource koji već osigurava bracketing i otpuštanje resursa. Da bismo stekli resurs, trebamo osigurati konfiguraciju i neki runtime kontekst. Tako da funkcija pokretanja servisa može izgledati:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
where
Postavke— tip konfiguracije koji je potreban ovom starteru servisaAddressResolver— runtime objekt koji ima sposobnost dobivanja stvarnih adresa drugih čvorova (nastavite čitati za detalje).
ostali tipovi dolaze iz cats:
F[_]— tip efekte (U najjednostavnijem slučajuF[A]može biti samo() => A. U ovom postu koristit ćemocats.IO.)Reader[A,B]— je više ili manje sinonim za funkcijuA => Bcats.Resource— ima načine za stjecanje i otpuštanjeTajmer— omogućuje spavanje/mjerenje vremenaContextShift— analogExecutionContextApplicative— omotač funkcija u efekte (gotovo monad) (možda ćemo to na kraju zamijeniti nečim drugim)
Koristeći ovo sučelje možemo implementirati nekoliko servisa. Na primjer, servis koji ne radi ništa:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Pogledajte za druge implementacije servisa — ,
i .)
Čvor je jedan objekt koji pokreće nekoliko servisa (pokretanje lanca resursa omogućeno je Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Napominjemo da u čvoru specificiramo točan tip konfiguracije koji je potreban ovom čvoru. Kompajler nam neće dopustiti da izgradimo objekt (Cake) s nedovoljnim tipom, jer svaki trait servisa deklarira ograničenje na Postavke vrsta. Također, nećemo moći pokrenuti čvor bez pružanja potpune konfiguracije.
RazResolucija adrese čvora
Kako bismo uspostavili vezu, potrebna nam je prava adresa domaćina za svaki čvor. Ona bi mogla biti poznata kasnije od drugih dijelova konfiguracije. Stoga, trebamo način za opskrbu mapiranjem između id čvora i njegove stvarne adrese. Ovo mapiranje je funkcija:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Postoji nekoliko mogućih načina za implementaciju takve funkcije.
- Ako znamo stvarne adrese prije implementacije, tijekom instanciranja čvornika domaćina, tada možemo generirati Scala kod s stvarnim adresama i nakon toga pokrenuti izgradnju (što izvršava provjere u vrijeme kompajliranja i zatim pokreće integracijski testni skup). U ovom slučaju, naša funkcija mapiranja se poznaje statički i može se pojednostaviti na nešto poput
Map[NodeId, NodeAddress]. - Ponekad dobivamo stvarne adrese tek kasnije kada se čvor zapravo pokrene ili nemamo adrese čvorova koji još nisu pokrenuti. U ovom slučaju mogli bismo imati uslugu otkrivanja koja se pokreće prije svih drugih čvorova, a svaki čvor bi mogao oglašavati svoju adresu u toj usluzi i pretplatiti se na ovisnosti.
- Ako možemo modificirati
/etc/hosts, možemo koristiti unaprijed definirane nazive domaćina (kao što sumy-project-main-nodeiecho-backend) i jednostavno povezati ovo ime s IP adresom tijekom vremena implementacije.
U ovom postu ne pokrivamo ove slučajeve detaljnije. U stvari, u našem primjeru svi čvorovi će imati istu IP adresu — 127.0.0.1.
U ovom postu razmatramo dva rasporeda distribuiranog sustava:
- Jednostruki raspored čvora, gdje su sve usluge smještene na jednom čvoru.
- Dvoslojni raspored, gdje su usluga i klijent na različitim čvorovima.
Konfiguracija za raspored je sljedeća:
Konfiguracija jednostrukog čvora
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifikator jedinog čvora
  \/\/ konfiguracija servera
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Tip sigurna specifikacija porta usluge. *\/
  override def portNumber: PortNumber = 8088

  \/\/ konfiguracija klijenta

  \/** Koristit ćemo uslugu koju pruža isti host. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ konfiguracija kontrolera životnog ciklusa
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ dodatnih 0.5 sekundi tako da bude 10 zahtjeva, a ne 9.
}
Ovdje kreiramo jedinstvenu konfiguraciju koja proširuje konfiguraciju poslužitelja i klijenta. Također, konfiguriramo kontroler životnog ciklusa koji će obično prekinuti klijent i poslužitelj nakon lifetime prolazi interval.
Isti set implementacija usluga i konfiguracija može se koristiti za stvaranje rasporeda sustava s dva odvojena čvora. Samo trebamo stvoriti s odgovarajućim uslugama:
Konfiguracija dva čvora
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! specifikacija ovisnosti
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ dodatnih 0.5 sekundi tako da bude 10 zahtjeva, a ne 9.

    def testMessage: String = "dolly"
  }
Pogledajte kako specificiramo ovisnost. Spominjemo uslugu koju drugi čvor pruža kao ovisnost trenutnog čvora. Tip ovisnosti se provjerava jer sadrži fantomski tip koji opisuje protokol. A u vrijeme izvođenja ćemo imati ispravni id čvora. Ovo je jedan od važnih aspekata predloženog pristupa konfiguraciji. Pruža nam mogućnost da postavimo port samo jednom i osiguramo da referenciramo ispravni port.
Implementacija dva čvora
Za ovu konfiguraciju koristimo točno iste implementacije usluga. Nema promjena. Međutim, kreiramo dvije različite implementacije čvora koje sadrže različiti set usluga:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Prvi čvor implementira poslužitelj i treba mu samo konfiguraciju s poslužiteljskom stranom. Drugi čvor implementira klijent i treba drugu polovicu konfiguracije. Obojici čvorova je potrebna neka specifikacija trajanja života. Za potrebe ovog posta usluga čvor ima neograničeno trajanje života koje se može prekinuti upotrebom SIGTERM, dok će echo klijent prekinuti nakon postavljene konačne trajanje. Pogledajte za detalje.
Sveukupni proces razvoja
Pogledajmo kako ovaj pristup mijenja način na koji radimo s konfiguracijom.
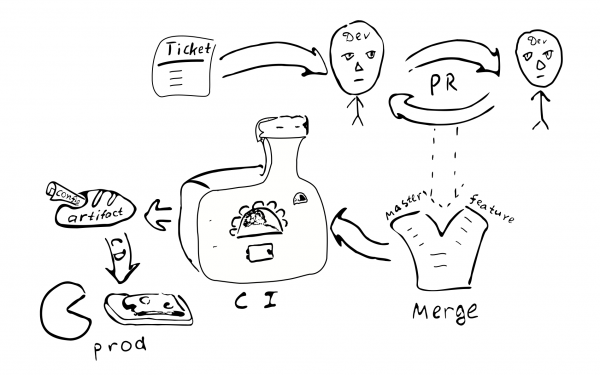
Konfiguracija kao kod će biti kompajlirana i proizvoditi artefakt. Čini se razumnim odvojiti artefakt konfiguracije od drugih artefakata koda. Često možemo imati mnoštvo konfiguracija na istom kodu. I naravno, možemo imati više verzija različitih grana konfiguracije. U konfiguraciji možemo odabrati određene verzije biblioteka i ovo će ostati konstantno svaki put kada implementiramo ovu konfiguraciju.
Promjena konfiguracije postaje promjena koda. Dakle, trebala bi biti pokrivena istim procesom osiguranja kvalitete:
Zadatak -> PR -> pregled -> spajanje -> kontinuirana integracija -> kontinuirano implementiranje
Postoje sljedeće posljedice pristupa:
- Konfiguracija je koherentna za konkretnu instancu sustava. Čini se da ne postoji način da dođe do pogrešne veze između nodova.
- Nije lako promijeniti konfiguraciju samo na jednom nodu. Čini se nerazumnim prijaviti se i mijenjati neke tekstualne datoteke. Tako da odlazak od konfiguracije postaje manje vjerojatan.
- Mala podešavanja konfiguracije nisu jednostavna za napraviti.
- Većina promjena konfiguracije slijedit će isti razvojni proces i proći će kroz neku recenziju.
Treba li nam poseban repozitorij za produkcijsku konfiguraciju? Produkcijska konfiguracija može sadržavati osjetljive informacije koje bismo željeli zadržati izvan dohvata mnogih ljudi. Stoga bi možda bilo vrijedno održavati poseban repozitorij s ograničenim pristupom koji će sadržavati produkcijsku konfiguraciju. Možemo podijeliti konfiguraciju na dva dijela — jedan koji sadrži većinu otvorenih parametara produkcije i jedan koji sadrži tajni dio konfiguracije. To bi omogućilo pristup većini programera na većinu parametara, dok bi pristup zaista osjetljivim stvarima bio ograničen. To je lako ostvariti korištenjem međuslojnih svojstava s zadanim vrijednostima parametara.
Varijacije
Pogledajmo prednosti i nedostatke predloženog pristupa u usporedbi s drugim tehnikama upravljanja konfiguracijom.
Prije svega, navest ćemo nekoliko alternativa različitim aspektima predloženog načina rješavanja konfiguracije:
- Tekstualna datoteka na ciljnom stroju.
- Centralizirano skladištenje ključ-vrijednost (poput
etcd/zookeeper). - Podprocesni sastojci koji bi mogli biti rekonfigurirani/restartani bez ponovnog pokretanja procesa.
- Konfiguracija izvan artefakta i kontrolinga verzija.
Tekstualna datoteka daje određenu fleksibilnost u smislu ad-hoc ispravki. Administrator sustava se može prijaviti na ciljni nod, napraviti promjenu i jednostavno restartati uslugu. To možda nije tako dobro za veće sustave. Nema tragova za promjenom. Promjena nije pregledana od strane druge osobe. Možda će biti teško otkriti što je uzrokovalo promjenu. To nije testirano. Iz perspektive distribuiranog sustava, administrator može jednostavno zaboraviti ažurirati konfiguraciju na jednom od drugih nodova.
(Inače, ako se u konačnici pojavi potreba za korištenjem tekstualnih konfiguracijskih datoteka, samo ćemo morati dodati parser + validator koji bi mogao isporučiti isti Postavke tip i to bi bilo dovoljno za početak korištenja tekstualnih konfiguracija. Ovo također pokazuje da je složenost konfiguracije u vrijeme kompilacije malo manja od složenosti tekstualnih konfiguracija, jer u tekstualnoj verziji trebamo dodatni kod.)
Centralizirano skladištenje ključ-vrijednost je dobar mehanizam za distribuiranje meta parametara aplikacije. Ovdje moramo razmisliti o tome što smatramo vrijednostima konfiguracije, a što je samo podatak. Kada imamo funkciju C => A => B obično zovemo rijetko mijenjane vrijednosti C «konfiguracija», dok često mijenjani podaci A — samo ulazni podaci. Konfiguracija bi trebala biti pružena funkciji ranije od podataka. A. Imajte na umu ovu ideju, možemo reći da je očekivana učestalost promjena ono što se može koristiti za razlikovanje konfiguracijskih podataka od samo podataka. Također, podaci obično dolaze iz jednog izvora (korisnik), a konfiguracija dolazi iz drugog izvora (administrator). Rukovanje parametrima koji se mogu mijenjati nakon inicijalizacije procesa dovodi do povećanja složenosti aplikacije. Za takve parametre morat ćemo se pobrinuti za njihov mehanizam isporuke, parsiranje i validaciju, rukovanje neispravnim vrijednostima. Stoga, kako bismo smanjili složenost programa, bolje je smanjiti broj parametara koji se mogu mijenjati u vrijeme izvođenja (ili ih čak potpuno eliminirati).
S gledišta ovog posta trebali bismo napraviti razliku između statičkih i dinamičkih parametara. Ako logika usluge zahtijeva rijetke promjene nekih parametara tijekom izvođenja, tada ih možemo nazvati dinamičkim parametrima. Inače su statički i mogu se konfigurirati korištenjem predloženog pristupa. Za dinamičku rekonfiguraciju mogli bi biti potrebni drugi pristupi. Na primjer, dijelovi sustava mogli bi se ponovo pokrenuti s novim konfiguracijskim parametrima na sličan način kao ponavljanje zasebnih procesa distribuiranog sustava.
(Moje skromno mišljenje je izbjegavati rekonfiguraciju u izvođenju jer povećava složenost sustava.
Možda bi bilo jednostavnije osloniti se na podršku OS-a za ponovno pokretanje procesa. Iako to možda nije uvijek moguće.)
Jedan važan aspekt korištenja statičke konfiguracije koji ponekad tjera ljude da razmišljaju o dinamičkoj konfiguraciji (bez drugih razloga) je downtime usluge tijekom ažuriranja konfiguracije. Naime, ako moramo napraviti promjene u statičkoj konfiguraciji, moramo ponovo pokrenuti sustav kako bi nove vrijednosti postale učinkovite. Zahtjevi za downtime variraju od sustava do sustava, pa možda nije uvijek kritično. Ako je kritično, tada moramo unaprijed planirati svako ponovno pokretanje sustava. Na primjer, mogli bismo implementirati . U ovom scenariju, kad god trebamo ponovo pokrenuti sustav, pokrećemo novu instancu sustava paralelno, a zatim prebacujemo ELB na nju, dok starom sustavu dopuštamo da završi usluživanje postojećih veza.
Što je s održavanjem konfiguracije unutar verzioniranog artefakta ili izvana? Održavanje konfiguracije unutar artefakta u većini slučajeva znači da je ta konfiguracija prošla isti proces kontrole kvalitete kao i ostali artefakti. Tako bi se moglo jamčiti da je konfiguracija kvalitetna i pouzdana. Nasuprot tome, konfiguracija u odvojenoj datoteci znači da nema tragova tko i zašto je napravio promjene u toj datoteci. Je li to važno? Vjerujemo da je za većinu proizvodnih sustava bolje imati stabilnu i visokokvalitetnu konfiguraciju.
Verzija artefakta omogućava saznanje kada je stvorena, koje vrijednosti sadrži, koje su značajke omogućene/isključene, tko je bio odgovoran za svaku promjenu u konfiguraciji. Moguće je da je potrebno malo truda kako bi se konfiguracija održala unutar artefakta i to je dizajnerska odluka.
Prednosti & nedostaci
Ovdje bismo željeli istaknuti neke prednosti i razgovarati o nekim nedostacima predloženog pristupa.
Prednosti
Značajke kompilažne konfiguracije kompletnog distribuiranog sustava:
- Statčka provjera konfiguracije. To daje visok nivo povjerenja da je konfiguracija ispravna s obzirom na tipovne ograničenja.
- Bogati jezik konfiguracije. Tipično su drugi pristupi konfiguraciji ograničeni na najviše zamjenu varijabli.
Korištenjem Scale može se koristiti širok raspon jezičnih značajki za poboljšanje konfiguracije. Na primjer, možemo koristiti traitove za zadane vrijednosti, objekte za postavljanje različitog opsega, možemo se pozivati navals definiranim samo jednom u vanjskom okviru (DRY). Moguće je koristiti literalne sekvence ili instance određenih klasa (Seq,Karta, itd.). - DSL. Scala ima dobru podršku za pisce DSL-a. Ove značajke se mogu koristiti za uspostavljanje jezika konfiguracije koji je praktičniji i korisnički prijateljskiji, tako da je konačna konfiguracija barem čitljiva za korisnike iz područja.
- Integritet i koherentnost među nodovima. Jedna od prednosti postojanja konfiguracije za cijeli distribuirani sustav na jednom mjestu je da su sve vrijednosti definirane strogo jednom i zatim ponovno korištene na svim mjestima gdje su nam potrebne. Također, sigurne deklaracije porta osiguravaju da će u svim mogućim ispravnim konfiguracijama čvorovi sustava govoriti istim jezikom. Postoje eksplicitne ovisnosti između čvorova što otežava zaboraviti pružiti neke usluge.
- Visoka kvaliteta promjena. Opći pristup prosljeđivanja promjena konfiguracije kroz normalni PR proces postavlja visoke standarde kvalitete također i u konfiguraciji.
- Simultano izmjene konfiguracije. Kada napravimo bilo kakve promjene u konfiguraciji, automatsko implementiranje osigurava da se svi čvorovi ažuriraju.
- P pojednostavljenje aplikacija. Aplikacija ne mora analizirati i provjeravati konfiguraciju te se nositi s neispravnim vrijednostima konfiguracije. To pojednostavljuje cjelokupnu aplikaciju. (Neki porast složenosti javlja se u samoj konfiguraciji, ali to je svjesna žrtva prema sigurnosti.) Sasvim je jednostavno vratiti se na običnu konfiguraciju — samo dodajte nedostajuće dijelove. Lakše je početi s kompiliranom konfiguracijom i odgoditi implementaciju dodatnih dijelova za neka kasnija vremena.
- Verzijska konfiguracija. S obzirom na to da promjene konfiguracije slijede isti proces razvoja, kao rezultat toga dobivamo artefakt s jedinstvenom verzijom. To nam omogućuje da se vratimo na prethodnu konfiguraciju ako je potrebno. Možemo čak implementirati konfiguraciju koja je korištena prije godinu dana i ona će raditi potpuno isto. Stabilna konfiguracija poboljšava predvidljivost i pouzdanost distribuiranog sustava. Konfiguracija je fiksna u vrijeme kompilacije i ne može se lako promijeniti u produkcijskom sustavu.
- Modularnost. Predloženi okvir je modularan i moduli se mogu kombinirati na različite načine kako bi
podržali različite konfiguracije (postava). Konkretno, moguće je imati malu, jednostruku postavu i veliku, višestruku postavu. Razumno je imati više produkcijskih postavki. - Testiranje. U svrhe testiranja može se implementirati lažna usluga i koristiti je kao ovisnost na siguran način. Može se održavati nekoliko različitih testnih postava s raznim dijelovima zamijenjenim lažnim dijelovima.
- Integracijsko testiranje. Ponekad je u distribuiranim sustavima teško pokrenuti integracijske testove. Koristeći opisani pristup sigurnom konfiguriranju cjelokupnog distribuiranog sustava, možemo pokrenuti sve distribuirane dijelove na jednom serveru na kontroliran način. Lako je simulirati situaciju
kada jedan od servisa postane nedostupan.
Nedostaci
Pristup kompiliranoj konfiguraciji razlikuje se od „normalne” konfiguracije i možda neće odgovarati svim potrebama. Evo nekoliko nedostataka kompilirane konfiguracije:
- Statička konfiguracija. Možda nije prikladna za sve aplikacije. U nekim slučajevima postoji potreba za brzim ispravljanjem konfiguracije u produkciji bez pridržavanja svih sigurnosnih mjera. Ovaj pristup to otežava. Kompilacija i ponovno implementiranje su potrebni nakon svake promjene u konfiguraciji. Ovo je i značajka i opterećenje.
- Generacija konfiguracije. Kada konfiguraciju generira neki alat za automatizaciju, ovaj pristup zahtijeva naknadnu kompilaciju (koja možda također ne uspije). To može zahtijevati dodatne napore za integraciju ovog dodatnog koraka u sustav izrade.
- Alati. Danas se koristi mnogo alata koji se oslanjaju na konfiguracije temeljene na tekstu. Neki od njih
neće biti primjenjivi kada je konfiguracija kompilirana. - Potrebna je promjena u načinu razmišljanja. Programeri i DevOps su navikli na tekstualne datoteke konfiguracije. Ideja o kompilaciji konfiguracije može im se činiti čudnom.
- Prije uvođenja kompilabilne konfiguracije potrebno je visokokvalitetno postupak razvoja softvera.
Postoje neka ograničenja implementiranog primjera:
- Ako mi pružimo dodatnu konfiguraciju koja nije potrebna od strane implementacije čvora, prevodilac nam neće pomoći da otkrijemo izostavljenu implementaciju. Ovo se može riješiti korištenjem
HListili ADT-a (klasa slučajeva) za konfiguraciju čvora umjesto svojstava i Cake Pattern. - Moramo pružiti dio koda u konfiguracijskoj datoteci: (
paket,uvoz,objektdeklaracije;
override def‘s za parametre koji imaju zadane vrijednosti). Ovo se može djelomično riješiti korištenjem DSL-a. - U ovom postu ne pokrivamo dinamičko ponovo konfiguriranje klastera sličnih čvorova.
Zaključak
U ovom postu raspravljamo o ideji izravnog predstavljanja konfiguracije u izvornom kodu na tipično siguran način. Ovaj pristup mogao bi se koristiti u mnogim aplikacijama kao zamjena za XML i druge tekstualne konfiguracije. Iako je naš primjer implementiran u Scali, može se također prevesti na druge kompajlabilne jezike (poput Kotlin, C#, Swift itd.). Ovaj pristup se može isprobati u novom projektu, a ako ne odgovara, može se preći na staromodni način.
Naravno, kompajlabilna konfiguracija zahtijeva kvalitetan razvojni proces. U zamjenu, obećava da će pružiti jednako kvalitetnu i robusnu konfiguraciju.
Ovaj pristup se može proširiti na razne načine:
- Moguće je koristiti makroe za provjeru valjanosti konfiguracije i neuspjeh u vrijeme kompajliranja u slučaju bilo kakvih pogrešaka u poslovnoj logici.
- Moguće je implementirati DSL za predstavljanje konfiguracije na način koji je prilagođen korisnicima u domeni.
- Dinamičko upravljanje resursima s automatskim prilagodbama konfiguracije. Na primjer, kada prilagodimo broj čvorova u klasteru, možda ćemo htjeti (1) da čvorovi dobiju malo izmijenjenu konfiguraciju; (2) da upravitelj klastera primi nove podatke o čvorovima.
Hvala
Želim zahvaliti Andreyu Saksonovu, Pavlu Popovu, Antonu Nehaevu za inspirirajuće povratne informacije na nacrtu ovog posta koji su mi pomogle da ga učinim jasnijim.
Izvor: habr.com
