

Tematika DevOps je trenutno popularna. Kontejner za kontinuiranu integraciju i isporuku uvode svi kojima se to sviđa. No, većina ne posvećuje uvijek dovoljno pažnje osiguranju pouzdanosti informatičkih sustava na različitim fazama CI/CD Pipelin-a. U ovom članku želim govoriti o svom iskustvu automatizacije provjera kvalitete softvera i implementacije mogućih scenarija za njegovo „samoobnavljanje“.
Radim kao inženjer u odjelu za upravljanje IT uslugama u tvrtki . Moja specijalizacija je implementacija različitih sustava za nadzor performansi i dostupnosti aplikacija. Često komuniciram s IT naručiteljima iz različitih segmenata tržišta o relevantnim pitanjima vezanim uz nadzor kvalitete njihovih IT usluga. Glavni zadatak je minimizirati vrijeme ciklusa objave i povećati učestalost njihovih izdanja. To, naravno, zvuči dobro: više izdanja – više novih funkcija – više zadovoljnih korisnika – više prihoda. No, u praksi ne ide uvijek toliko dobro. Pri vrlo visokim tempovima implementacije odmah se postavlja pitanje o kvaliteti naših izdanja. Čak i uz potpuno automatizirani sustav, jedan od najvećih problema je prijenos usluga iz testiranja u proizvodnju, ne utječući pritom na vrijeme neprekidnog rada i interakciju korisnika s aplikacijom.
Na temelju brojnih razgovora s naručiteljima, mogu reći da su kontrola kvalitete izdanja, problem pouzdanosti aplikacije i mogućnost njenog „samoobnavljanja“ (na primjer, vraćanje na stabilnu verziju) na različitim fazama CI/CD kontejnera – među najzanimljivijim i najaktualnijim temama.
Nedavno sam sam radio na strani naručitelja – u službi podrške aplikativnom softveru online banke. U arhitekturi naše aplikacije korišteno je mnogo samostalno razvijenih mikroslužbi. Najtužnije je to što se nisu svi programeri mogli nositi s visokim tempom razvoja, kvaliteta nekih mikroslužbi je trpjela, što je dovodilo do smiješnih nadimaka za njih i njihove kreatore. Pojavljivale su se priče o tome od kojih su materijala ti proizvodi stvoreni.
«Postavljanje zadatka»
Visoka učestalost izdanja i veliki broj mikroservisa otežava razumijevanje rada aplikacije u cjelini, kako u fazi testiranja, tako i u fazi eksploatacije. Promjene se neprestano događaju i teško ih je kontrolirati bez dobrih alata za praćenje. Često nakon noćnog izdanja, programeri ujutro sjede poput na barutnoj bačvi i čekaju da se ništa ne pokvari, iako su svi testovi u fazi testiranja bili uspješni.
Postoji još jedna stvar. U fazi testiranja provjerava se funkcionalnost softvera: izvršavanje osnovnih funkcija aplikacije i odsutnost grešaka. Kvalitetne procjene performansi ili nedostaju ili ne uzimaju u obzir sve aspekte rada aplikacije i integracijski sloj. Neki metrički podaci se uopće ne provjeravaju. Na kraju, kada dođe do kvara u produkcijskom okruženju, odjel tehničke podrške sazna za to tek kada stvarni korisnici počnu prigovarati. Želi se minimizirati utjecaj nekvalitetnog softvera na krajnje korisnike.
Jedan od načina rješavanja je implementacija procesa provjere kvalitete softvera u različitim fazama CI/CD cjevovoda, dodavanje različitih scenarija za obnavljanje sustava u slučaju kvarova. Također se sjećamo da imamo DevOps. Poslovanje očekuje što bržu isporuku novog proizvoda. Stoga, sve naše provjere i scenariji moraju biti automatizirani.
Zadatak se razdvaja na dvije sastavne dijelove:
- kontrola kvalitete izdanja u fazi testiranja (automatizirati proces otkrivanja neispravnih izdanja);
- kontrola kvalitete softvera u produkcijskom okruženju (mehanizmi automatskog otkrivanja problema i mogući scenariji za njihovo samostalno obnavljanje).
Alat za praćenje i prikupljanje metrika
Kako bismo ostvarili postavljene zadatke, potrebna je sustav praćenja koji može otkriti probleme i proslijediti ih u automatizacijske sustave u različitim fazama CI/CD cjevovoda. Također će biti pozitivno ako ovaj sustav pruži korisne metrike raznim timovima: razvoju, testiranju, eksploataciji. I još bolje ako i za poslovanje.
Za prikupljanje metrika možete koristiti kombinaciju različitih sustava (Prometheus, ELK Stack, Zabbix itd.), ali, po mom mišljenju, za te svrhe najbolje odgovaraju APM rješenja (), koja vam mogu značajno olakšati život.
U okviru mog rada u službi za podršku započeo sam sličan projekt koristeći APM rješenje kompanije Dynatrace. Sada, radeći u integratoru, prilično dobro poznajem tržište sustava monitrona. Moje subjektivno mišljenje: Dynatrace najbolje odgovara za rješavanje ovakvih zadataka.
Dynatrace rješenje omogućava horizontalno prikazivanje svake korisničke operacije s dubokom razinom detaljnosti do razine izvršavanja koda. Možete pratiti cijeli lanac interakcije između različitih informacijskih servisa: od razina front-end web i mobilnih aplikacija, back-end aplikacijskih poslužitelja, integracijske sabirnice do konkretnog poziva u Bazi podataka.
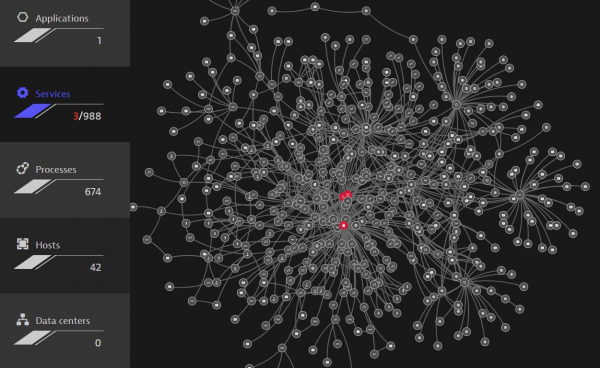 . Automatsko izgradnja svih ovisnosti između komponenti sustava
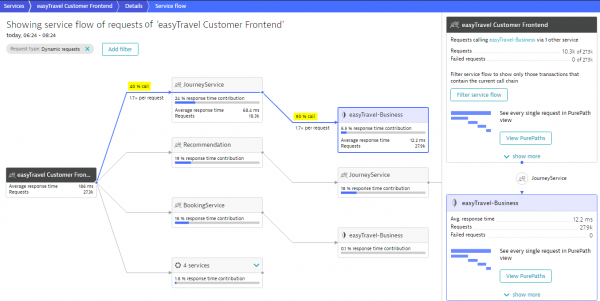 . Automatsko određivanje i izgradnja puta prolaska operacije servisa
Također se sjećamo da se moramo integrirati s različitim alatima za automatizaciju. Ovdje rješenje ima ugodan API koji omogućava slanje i primanje raznih metrika i događaja.
Dalje ćemo preći na detaljnije razmatranje kako riješiti postavljene zadatke pomoću sustava Dynatrace.
Zadatak 1. Automatizacija kontrole kvalitete izrada na fazi testiranja
Prvi zadatak je otkriti probleme što je prije moguće u fazama uspostavljanja aplikacije. Samo 'dobri' kodovi trebaju napredovati u produkcijsko okruženje. Za to, u vašem pipelineu na fazi testiranja trebaju biti uključeni dodatni monitori za provjeru kvalitete vaših servisa.
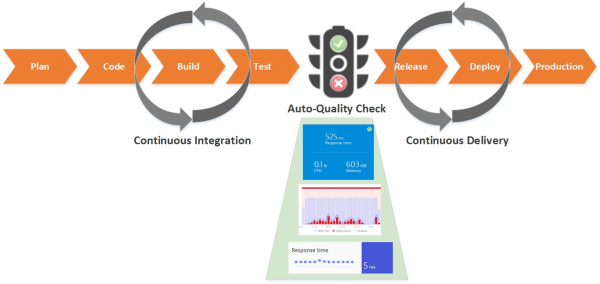
Pogledajmo korak po korak kako to realizirati i automatizirati ovaj proces:
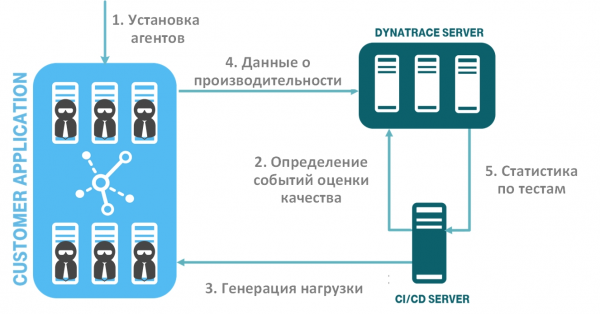
Na slici je prikazan protok automatiziranih koraka provjere kvalitete softvera:
- postavljanje sustava monitrona (instalacija agenata);
- određivanje događaja za ocjenu kvalitete vašeg softvera (metrike i pragovi) i prijenos u sustav monitrona;
- generiranje opterećenja i testova performansi;
- prikupljanje podataka o performansama i dostupnosti u sustavu monitrona;
- prijenos podataka o testovima temeljenim na događajima procjene kvalitete softvera iz sustava za nadzor u CI/CD sustav. Automatska analiza gradnji.
Korak 1. Postavljanje sustava za nadzor
Prvo je potrebno instalirati agente u vaše testno okruženje. Rješenje Dynatrace ima privlačnu značajku – koristi univerzalnog agenta OneAgent, koji se instalira na OS instancu (Windows, Linux, AIX), automatski otkriva vaše usluge i počinje prikupljati podatke o nadzoru. Nema potrebe za posebnim postavljanjem agenta za svaki proces. Slična situacija vrijedi za oblačne i kontejnerske platforme. Proces instalacije agenata također možete automatizirati. Dynatrace se savršeno uklapa u koncept „infrastruktura kao kod“ (): već postoje gotovi skripti i upute za sve popularne platforme. Ugrađujete agenta u konfiguraciju svoje usluge, i prilikom njenog postavljanja odmah dobivate novu uslugu s već funkcionalnim agentom.
Korak 2. Definiranje događaja procjene kvalitete vašeg softvera
Sada je potrebno odabrati popis usluga i poslovnih operacija. Važno je uzeti u obzir baš one korisničke operacije koje su poslovno kritične za vašu uslugu. Ovdje preporučam konzultaciju s poslovnim i sustavnim analitičarima.
Nakon toga potrebno je odrediti koje metrike želite uključiti u provjeru za svaku razinu. Na primjer, to mogu biti vrijeme izvođenja (s razdvajanjem na prosjek, medijan, percentile i dr.), greške (logičke, servisne, infrastrukturne i dr.) i različite infrastrukturne metrike (memory heap, garbage collector, thread count i dr.).
Za automatizaciju i olakšanje korištenja od strane DevOps tima pojavljuje se koncept „Nadzor kao kod“. Što pod tim podrazumijevam – programer/tester može napisati jednostavnu JSON datoteku koja definira pokazatelje provjere kvalitete softvera.
Pogledajmo primjer takve JSON datoteke. Kao par ključ/vrijednost koriste se objekti iz Dynatrace API-ja (opis API-ja možete vidjeti ovdje ).
{
   "timeseries": [
   {
     "timeseriesId": "service.ResponseTime",
     "aggregation": "avg",
     "tags": "Frontend",
     "severe": 250000,
     "warning": 1000000
   },
   {
     "timeseriesId": "service.ResponseTime ",
     "aggregation": "avg",
     "tags": "Backend",
     "severe": 4000000,
     "warning": 8000000
   },
   {
     "timeseriesId": "docker.Container.Cpu",
     "aggregation": "avg",
     "severe": 50,
     "warning": 70
   }
 ]
}
Datoteka predstavlja niz definicija vremenskih serija (timeseries):
- timeseriesId – metrika koja se provjerava, na primjer, Vrijeme odgovora, Broj grešaka, Iskorištena memorija itd.;
- aggregation — razina agregacije metrika, u našem slučaju avg, ali možete koristiti bilo koju potrebnu (avg, min, max, sum, count, percentile);
- tags – oznaka objekta u sustavu nadzora, ili možete navesti konkretni identifikator objekta;
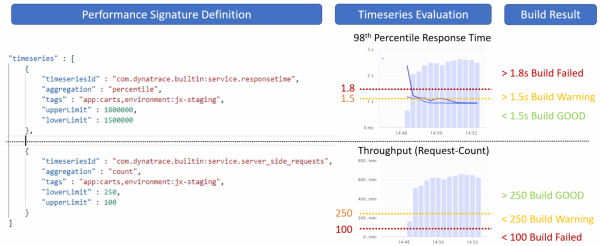
- severe i warning – ovi pokazatelji reguliraju pragove naših metrika; ako vrednost testova premaši prag severe, naš test se označava kao neuspješan.
Na sljedećem prikazu predstavljen je primjer korištenja takvih pragova.
Korak 3. Generiranje opterećenja
Nakon što utvrdimo razine kvalitete naših usluga, potrebno je generirati testno opterećenje. Možete koristiti bilo koji od alata za testiranje koji vam odgovara, poput Jmeter, Selenium, Neotys, Gatling itd.
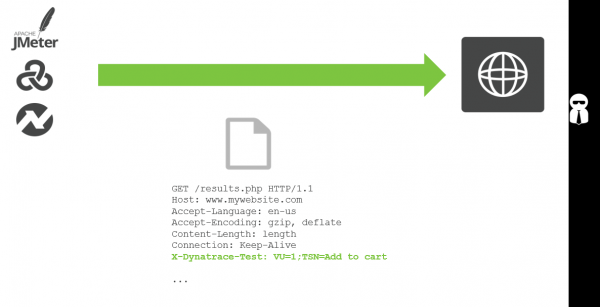
Sustav nadzora Dynatrace omogućuje prikupljanje različitih metapodataka iz vaših testova i prepoznavanje koji testovi pripadaju kojem ciklusu izdanja i kojoj usluzi. Preporučuje se dodavanje dodatnih zaglavlja u HTTP zahtjeve testa.
Na sljedećem prikazu prikazan je primjer, gdje dodatnim zaglavljem X-Dynatrace-Test označavamo da ovaj test pripada ispitivanju operacije dodavanja proizvoda u košaricu.
Prilikom pokretanja svakog testiranja opterećenja šaljete dodatne kontekstualne informacije u Dynatrace putem API događaja s CI/CD servera. Tako sustav može razlikovati različite testove jedne od drugih.
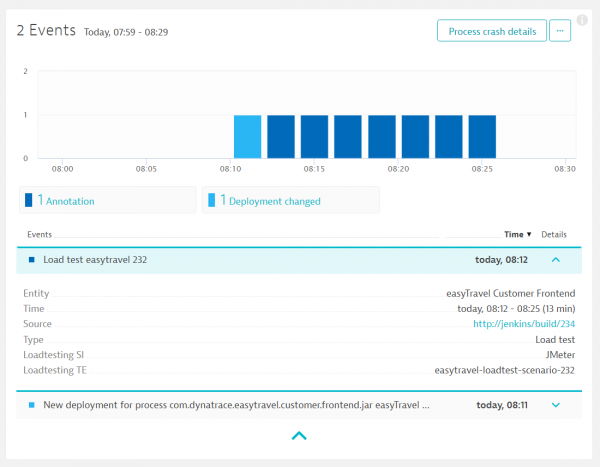 . Događaj u sustavu nadzora o pokretanju testiranja opterećenja
Korak 4-5. Prikupljanje podataka o performansama i prijenos podataka u CI/CD sustav
Zajedno s generiranim testom u sustav nadzora se šalje događaj o potrebi prikupljanja podataka o provjeri pokazatelja kvalitete usluge. Također se navodi naš JSON datoteka u kojoj su definirane ključne metrike.
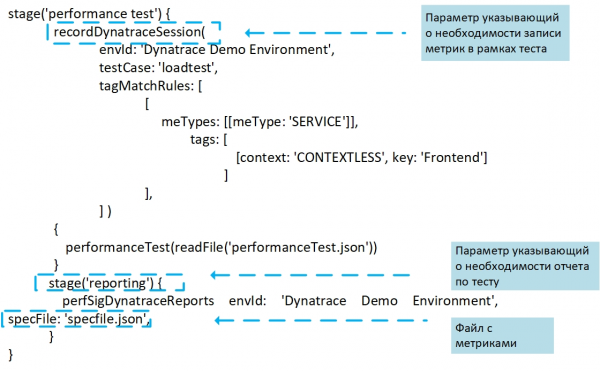 Događaj potrebne provjere kvalitete softvera otvara se na CI/CD poslužitelju za slanje u sustav praćenja
U našem primjeru događaj provjere kvalitete naziva se perfSigDynatraceReport (Performance_Signature) – to je gotovi za integraciju s Jenkinsom, koji su razvili tim iz T-Systems Multimedia Solutions. U svakom događaju pokretanja provjere nalazi se informacija o usluzi, broju izrade, vremenu testiranja. Plugin prikuplja vrijednosti performansi tijekom izrade, procjenjuje ih i uspoređuje rezultate s prethodnim izradama i nefunkcionalnim zahtjevima.
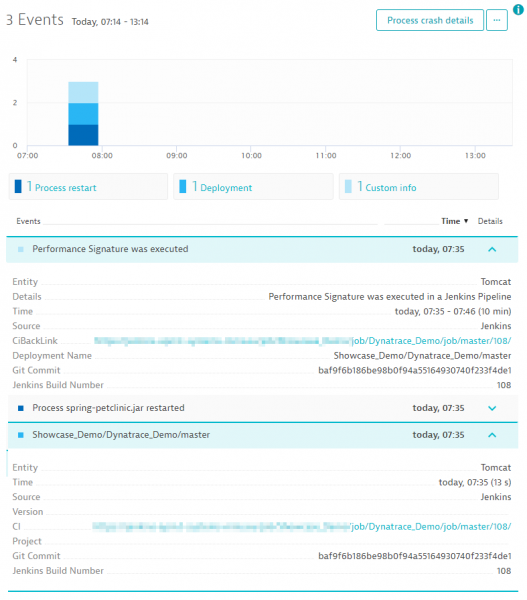 Događaj u sustavu praćenja o pokretanju provjere kvalitete izrade.
Nakon završetka testa sve metrike za procjenu kvalitete softvera vraćaju se u sustav kontinuirane integracije, na primjer, Jenkins, koji generira izvještaj o rezultatima.
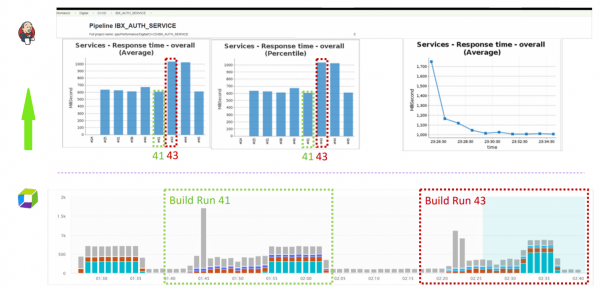 Rezultat statistike o izradama na CI/CD poslužitelju.
Za svaku pojedinačnu izradu vidimo statistiku za svaku od definiranih metrika tijekom izvođenja cijelog testa. Također vidimo ako su bilo kakva odstupanja prema određenim pragovima (warning i severe-thresholds) bila zabilježena. Na temelju skupnih pokazatelja daje se oznaka cijeloj izradi kao stabilnoj, nestabilnoj ili neuspješnoj. Također, radi udobnosti, možete dodati u izvještaj usporedne pokazatelje trenutne izrade s prethodnom.
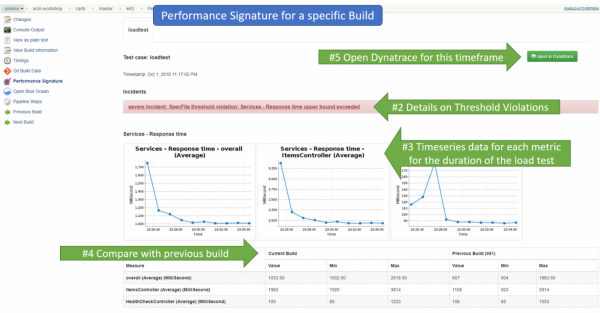 Pregled detaljnih statističkih podataka o izradama na CI/CD poslužitelju.
Detaljna usporedba dviju izrada
Ako je potrebno, možete preći u sučelje Dynatrace i tu detaljnije pregledati statistiku za svaku vašu izradu i usporediti ih međusobno.
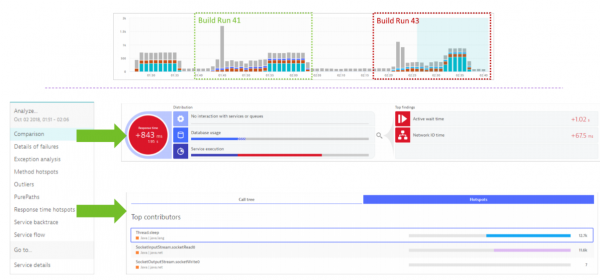 Usporedba statistike o izradama u Dynatrace.
Zaključci
Kao rezultat dobivamo uslugu „monitoring kao uslugu“, automatiziranu u kontejneru kontinuirane integracije. Razvijatelju ili testeru potrebno je samo definirati popis metrika u JSON datoteci, a sve ostalo se događa automatski. Dobivamo transparentnu kontrolu kvalitete izdanja: sve obavijesti o performansama, potrošnji resursa ili arhitektonskim regresijama.
Zadatak 2. Automatizacija kontrole kvalitete softvera u produkcijskom okruženju
Dakle, riješili smo zadatak kako automatizirati proces praćenja u fazi testiranja u Pipelineu. Na taj način minimiziramo postotak nekvalitetnih izrada koje dolaze do produkcijskog okruženja.
Ali što učiniti ako loš softver ipak stigne u produkciju, ili jednostavno nešto ne funkcionira. U idealnom scenariju željeli bismo imati mehanizme za automatsko otkrivanje problema i, kada je god moguće, sustav bi se trebao sam obnavljati, barem noću.
Za to trebamo, slično prethodnom dijelu, predvidjeti automatske provjere kvalitete softvera u produkcijskom okruženju i ugraditi scenarije za samoodržavanje sustava.
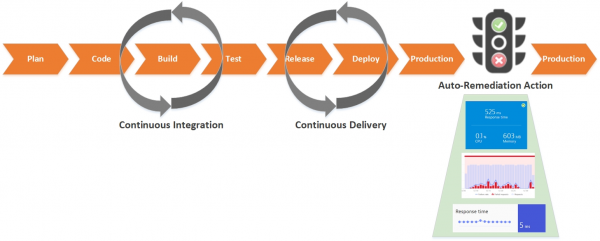
Automatska ispravka kao kod
U većini tvrtki postoji akumulirana baza znanja o raznim tipovima uobičajenih problema i popis akcija za njihovo rješavanje, na primjer, ponovno pokretanje procesa, čišćenje resursa, povrat verzija, obnova pogrešnih izmjena u konfiguraciji, povećanje ili smanjenje broja komponenti u klasteru, prebacivanje između plavog ili zelenog okvira i slično.
Iako su ove koristne opcije poznate već godinama mnogim timovima s kojima razgovaram, samo su rijetki razmišljali i investirali u njihovu automatizaciju.
Ako razmislite, u implementaciji procesa samoodržanja aplikacije nema ništa pretjerano složeno; potrebno je samo poznate radne scenarije vaših administratora predstaviti u obliku scenarija koda (koncept „automatska ispravka kao kod”), koje ste unaprijed napisali za svaki konkretni slučaj. Scenariji automatske ispravke trebaju biti usmjereni na rješavanje osnovnog uzroka problema. Vi postavljate odgovarajuće reakcije na incident.
Kao okidač za pokretanje scenarija može poslužiti bilo koja metrika iz vašeg sustava nadzora; važno je da te metrike točno odrede kada nešto nije u redu, jer ne bismo željeli dobiti lažne uzbune u produkcijskom okruženju.
Možete koristiti bilo koji sustav ili skup sustava: Prometheus, ELK Stack, Zabbix i slično. No, dat ću nekoliko primjera na temelju APM rješenja (ponovno ću koristiti Dynatrace kao primjer), koje će također olakšati vaš život.
Prvo, ovdje se nalaze sve informacije o radnoj sposobnosti s aspekta rada aplikacije. Rješenje pruža stotine metrike na različitim razinama, koje možete koristiti kao okidače:
- razina korisnika (pretraživači, mobilne aplikacije, IoT uređaji, ponašanje korisnika, konverzija itd.);
- razina usluge i operacija (performanse, dostupnost, greške itd.);
- razina infrastrukture aplikacije (OS metrike hosta, JMX, MQ, web-server itd.);
- razina platformi (virtualizacija, oblak, kontejner itd.).
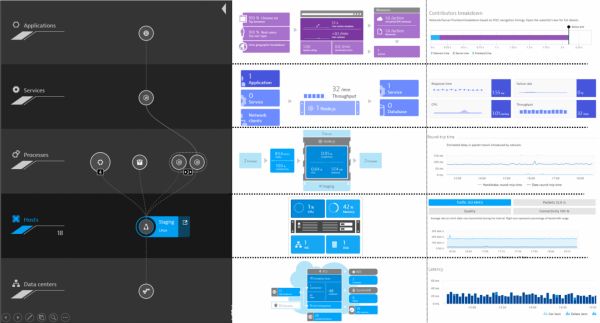 Razine nadzora u Dynatrace.
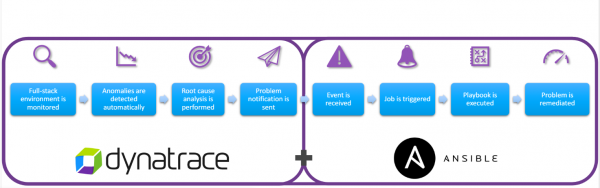
U drugom redu, kao što sam ranije spomenuo, Dynatrace ima otvoreni API koji omogućava vrlo jednostavnu integraciju s raznim vanjskim sustavima. Na primjer, slanje obavijesti u sustav automatizacije kada se prekorače kontrolni parametri.
Ispod je primjer za interakciju s Ansible.
Sljedeće ću navesti nekoliko primjera koje automatizacije se mogu provoditi. Ovo je samo dio slučajeva, njihov popis u vašem okruženju može se ograničiti samo vašom maštom i mogućnostima vaših alata za nadzor.
1. Loše implementiranje – povratak na prethodnu verziju
Čak i ako sve vrlo dobro provjeravamo u testnom okruženju, i dalje postoji šansa da nova verzija može srušiti vašu aplikaciju u produkcijskom okruženju. Ljudski faktor nitko nije ukinuo.
Na sljedećem dijagramu vidimo da se događa nagli skok vremena izvršenja operacija na usluzi. Početak ovog skoka poklapa se s vremenom implementacije aplikacije. Sve te informacije u obliku događaja šaljemo u sustav automatizacije. Ako se funkcionalnost usluge ne normalizira nakon zadanog vremena, automatski se poziva skripta koja vraća verziju na stariju.
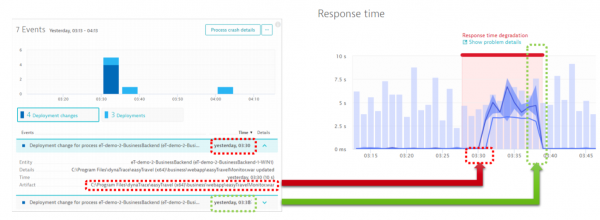 Degradacija performansi operacija nakon implementacije.
2. Opterećenje resursa do 100% — dodavanje čvora u rutiranje
U sljedećem primjeru sustav nadzora utvrđuje da jedan od komponenata ima opterećenje CPU-a od 100%.
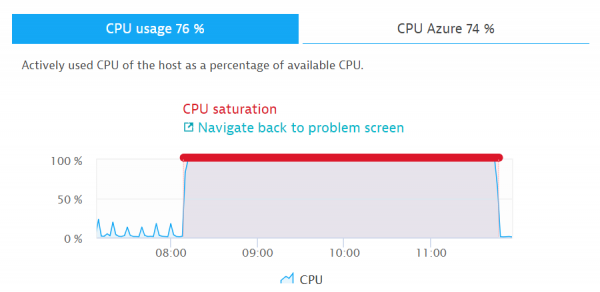 Opterećenje CPU 100%
Za ovaj događaj postoje različiti scenariji. Na primjer, sustav nadzora dodatno provjerava je li nedostatak resursa povezan s povećanjem opterećenja na uslugu. Ako je tako, izvršava se skripta koja automatski dodaje čvor u rutiranje, čime se obnavlja funkcionalnost sustava u cjelini.
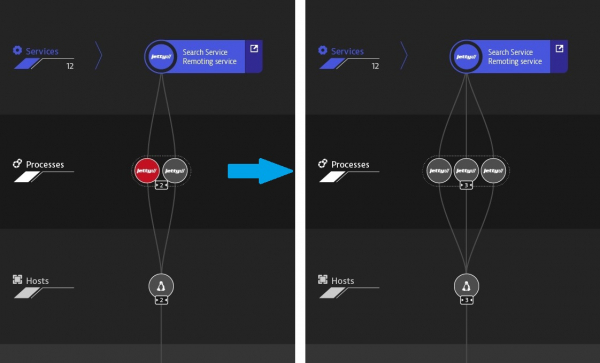 Skaliranje nakon incidenta
3. Nedostatak prostora na tvrdom disku – čišćenje diska
Mislim da su ti procesi već kod mnogih automatizirani. Uz APM također se može pratiti slobodni prostor na diskovnom sustavu. U slučaju nedostatka prostora ili sporog rada diska pokrećemo skriptu za čišćenje ili dodajemo prostor.
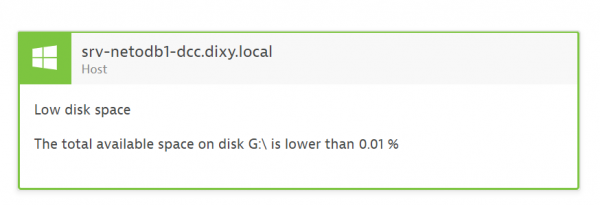
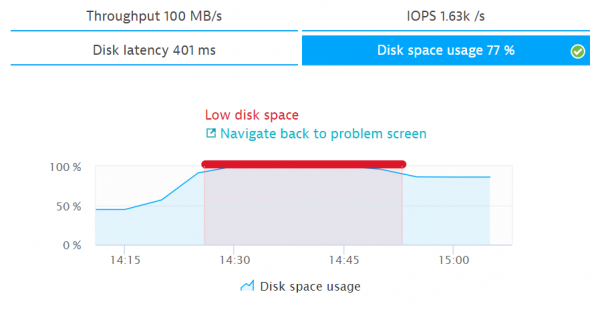 Opterećenje diska 100%
4. Niska aktivnost korisnika ili niska konverzija – prebacivanje između plave i zelene grane
Često srećem klijente koji koriste dva kontura (blue-green deploy) za aplikacije u produkcijskom okruženju. To omogućava brzo prebacivanje između grana prilikom isporuke novih izdanja. Često nakon implementacije mogu se dogoditi radikalne promjene koje nije lako odmah primijetiti. Pri tom degradacija u performansama i dostupnosti možda se neće uočiti. Za brzu reakciju na takve promjene najbolje je koristiti različite metrike koje odražavaju ponašanje korisnika (broj sesija i akcija korisnika, konverzija, bounce rate). Na sljedećem prikazu prikazan je primjer u kojem se prelazi između grana softvera prilikom pada konverzije.
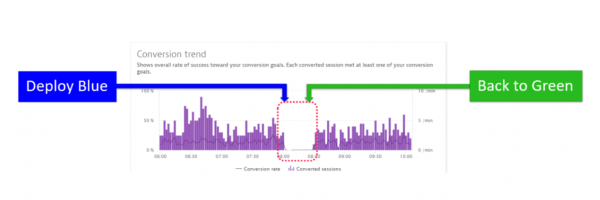 Pad konverzije nakon prebacivanja između grana softvera.
Mehanizmi automatskog prepoznavanja problema
Na kraju ću navesti još jedan primjer zbog kojeg najviše volim Dynatrace.
U dijelu mog izlaganja o automatizaciji provjere kvalitete građevina u testnom okruženju sve pragove smo definirali ručno. Za testno okruženje je to normalno, tester sam određuje pokazatelje prije svake provjere ovisno o opterećenju. U produkcijskom okruženju poželjno je da se problemi otkrivaju automatski uzimajući u obzir različite mehanizme baseline.
Dynatrace ima zanimljive ugrađene alate umjetne inteligencije koji na temelju mehanizama određivanja anomalnih metrika (baselining) i izgradnje karte interakcije između svih komponenti, uspoređujući i korigirajući događaje međusobno, prepoznaju anomalije u radu vaše usluge i pružaju detaljne informacije o svakom problemu i njegovom korijenskom uzroku.
Automatskom analizom ovisnosti između komponenti, Dynatrace određuje ne samo je li problematična usluga osnovni uzrok, već i njezinu ovisnost o drugim uslugama. U donjem primjeru, Dynatrace automatski prati i procjenjuje funkcionalnost svake usluge tijekom izvršavanja transakcija, identificirajući Golang uslugu kao osnovni uzrok.
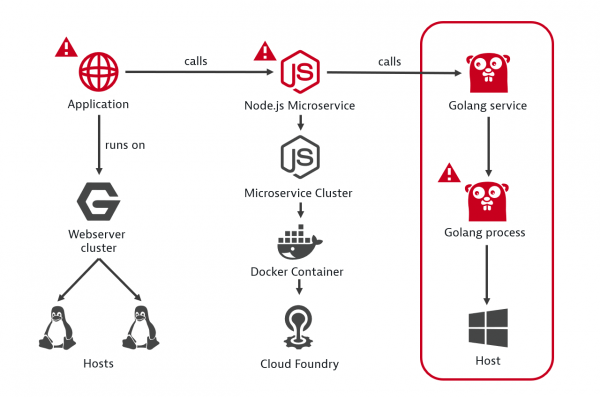 Primjer identifikacije osnovnog uzroka kvara.
Na sljedećoj slici prikazan je proces praćenja problema s vašom aplikacijom od trenutka pokretanja incidenta.
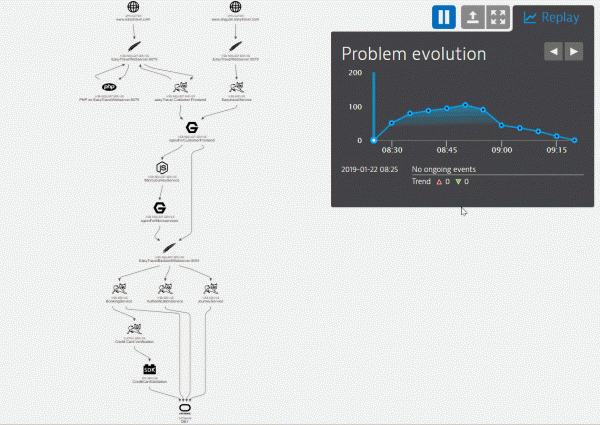 Vizualizacija nastalog problema, uz prikaz svih komponenti i događaja unutar njih.
Sustav praćenja prikupio je potpunu kronologiju događaja vezanih uz nastali problem. U prozoru ispod vremenske osi možemo vidjeti sve ključne događaje na svakoj od komponenti. Na temelju tih događaja možete stvoriti procedure za automatsko ispravljanje u obliku kodnih skripti.
Preporučam integraciju sustava praćenja s Service Desk-om ili alatima za praćenje grešaka. Kada se pojavi problem, developeri brzo dobivaju sve potrebne informacije za analizu na razini koda u produkcijskom okruženju.
Zaključak
Na kraju smo dobili CI/CD cjevovod s ugrađenim automatiziranim provjerama kvalitete softvera u Pipeline-u. Minimaliziramo broj loših gradnji, povećavamo pouzdanost sustava u cjelini i, ako dođe do kvara sustava, pokrećemo mehanizme za njegovo obnavljanje.
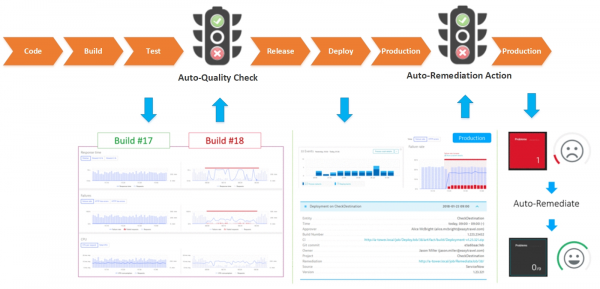
Svakako se isplati ulagati napore u automatizaciju praćenja kvalitete softvera; iako to nije uvijek brz proces, s vremenom će dati svoje rezultate. Preporučam da nakon rješavanja novog incidenta u produkciji odmah razmislite o dodatnim monitorima za provjere u testnom okruženju kako biste izbjegli ulazak loših gradnji u produkciju, te pripremite skriptu za automatsko ispravljanje tih problema.
Nadam se da će moji primjeri pomoći u vašim nastojanjima. Također, zanima me vidjeti vaše primjere korištenih metrika za implementaciju samovraćanja funkcionalnosti sustava.
Izvor: habr.com
